Ornith 1.5 把本地 AI 的一個老問題攤得很清楚:每秒吐出多少 token,和最後有沒有把工作做完,是兩回事,35B-A3B 版本靠 MoE 架構降低每個 token 的運算量,在公開實測中展現速度優勢,也出現思考太久、額度用完卻沒交出程式碼的案例。
如果你想找一顆接在本地程式代理後面的模型,Ornith 1.5 35B 值得列入測試,評估時要一起看量化格式、記憶體餘裕、工具相容性與任務完成率,下面先拆開「自我改進」的意思,再看官方評分、兩組不同硬體的實測,以及實際上手順序。
內容目錄
Ornith 1.5 更新了什麼?先分清楚三種模型
Ornith 1.5 家族包含 9B Dense、35B MoE 與 397B MoE。手機部署的主角是 9B-Mobile 量化版本,與旗艦商用模型比較的宣傳則主要圍繞 397B。本文聚焦中間的 35B-A3B,不能把另外兩款的部署條件或成績直接套過來。版本資訊可從 官方模型集合查看。
如果你看過 Ornith 1.0 的自我拆解任務方式,這次最主要的延伸是把「生成訓練任務」也納入改善流程。
自我改進發生在訓練期間,下載後不會自動改寫權重
依照 Ornith 官方技術說明,模型在訓練中依序扮演三個角色:先根據程式庫與過去解題紀錄出題,再安排工具、指令與拆解方法,最後嘗試解題。結果回饋到強化學習流程,讓題目、執行安排與解法一起改善。
出題也有條件:題目要能驗證、難度合適,而且不能一直重複,官方把目標成功率設在約 20%,讓模型練習有挑戰但仍可能解出的題目。這個百分比是訓練課程的設計目標,不是產品的答題正確率。
可以把它想成練習寫程式時,不只修答案,也回頭調整練習題與測試方式。
下載回來的則是訓練後的模型權重,日常對話、保存記憶或反覆提示,不代表權重正在持續更新。
AlphaLab 對自我改進邊界的分析也提醒,環境與評分規則仍由人設計,分數上升還要確認是否真的學會解題。
35B-A3B 的 A3B,不是記憶體只要放下 3B
MoE 每次只選部分專家參與計算,但其他專家的權重仍要有地方存放。活躍參數主要影響每一步的運算量,總權重與快取才是估算記憶體的起點。官方 35B 模型頁列出約 3B 活躍參數,BF16 權重約 70GB,原生上下文為 262,144 token,模型規格與啟動範例可作為設定依據。
以目前 官方 GGUF 檔案清單為例,Q4_K_M 單一模型檔約 21.71GB,換算約 20.22GiB,這還沒加上推論引擎、上下文快取或視覺投影檔,因此「有 24GB 顯示記憶體」只能作為測試起點,不能直接承諾長上下文與多個並行任務都放得下。
12GB 或 16GB 顯示卡若想跑這個 Q4 檔,通常還得規劃部分權重放在系統記憶體,或改用其他量化版本,能載入模型、能順利對話、能在長任務中維持速度,應分開驗收。Mac 使用統一記憶體,也要預留系統空間,可搭配 本地 AI 的記憶體與頻寬選擇理解這個差別。
官方評分顯示程式能力進步,但要連測試框架一起看
以下是官方模型卡中同尺寸模型的部分成績。
Ornith 1.5 的結果為團隊自報的五次執行平均,並非本文重跑,也不等於所有電腦都會得到相同結果。
| 測試 | Ornith 1.5 35B | Ornith 1.0 35B | Qwen3.6 35B |
|---|---|---|---|
| Terminal-Bench 2.1/Terminus-2 | 67.8 | 64.2 | 52.5 |
| SWE-bench Verified | 79.0 | 75.6 | 73.4 |
| SWE-bench Pro | 59.6 | 50.4 | 49.5 |
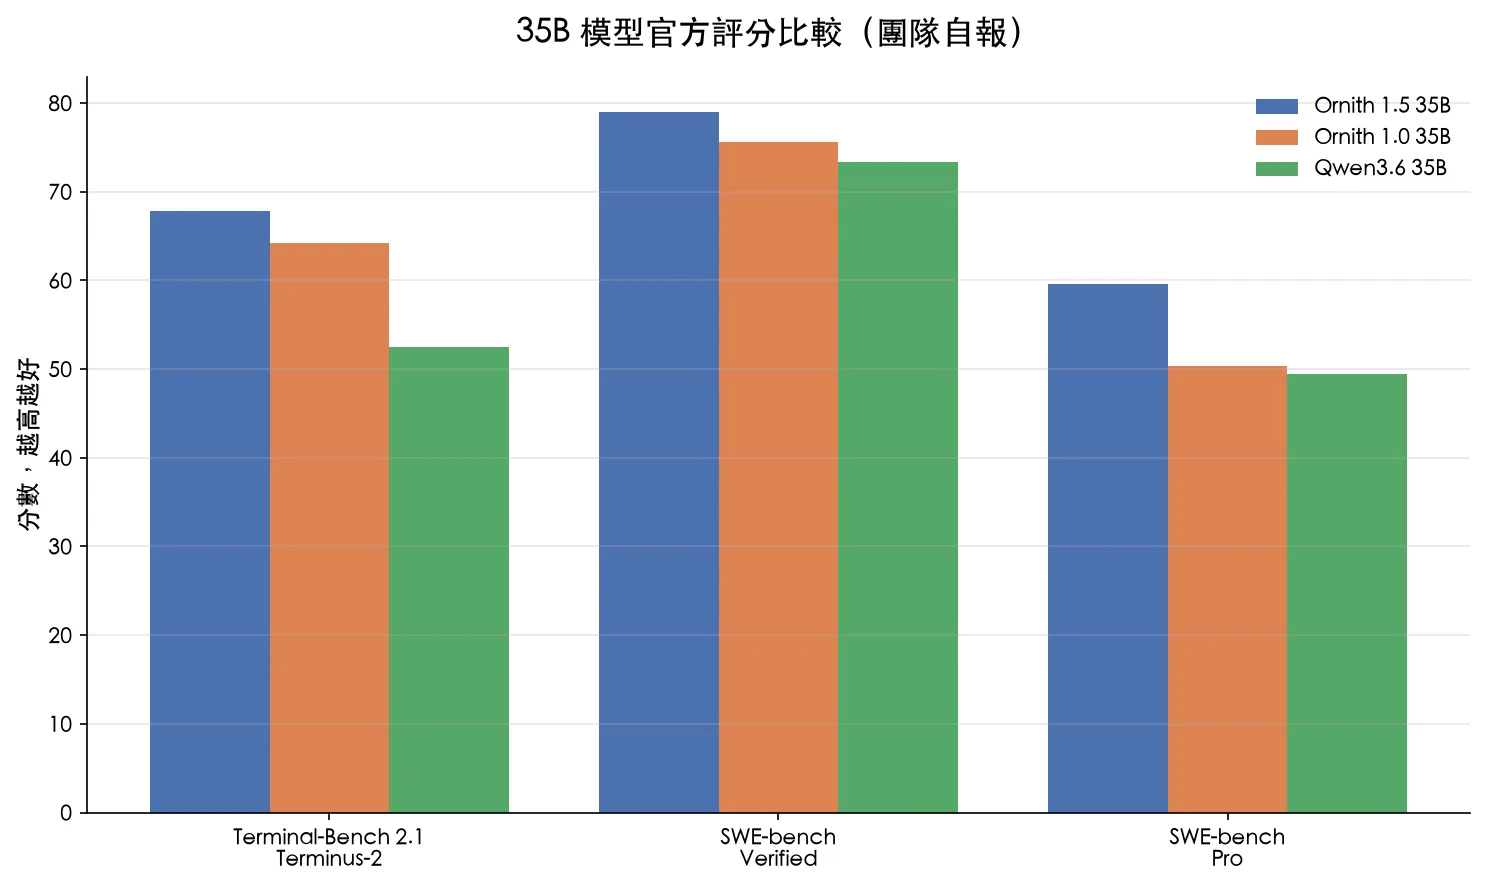
Terminal-Bench 的上述結果使用 Terminus-2,SWE-bench 使用 OpenHands。工具、提示、可用時間與上下文都會影響代理表現。「追平 Claude Opus」應限於官方列出的特定 397B 比較,無法據此宣稱 35B 全面取代商用模型。
對上 Qwen3.8 27B:生成得快,整個任務卻可能更慢
DIY Smart Code 的 Benchy 本地測試使用 RX 7900 XTX 24GB、Ryzen 9、64GB 系統記憶體與 Ollama,比較兩款 Q4 模型。Ornith 測試標示 32K 上下文。這是作者自建測試集的一組案例,量化檔案與測試工具的細節限制了外部重現,不能當成通用排名。
| 同一組 Benchy 案例 | Ornith 1.5 35B | Qwen3.8 27B |
|---|---|---|
| 通過項目 | 18/21 | 20/21 |
| 生成速度 | 約 74 tok/s | 約 58 tok/s |
| 提示處理速度 | 約 850 tok/s | 約 240 tok/s |
| 整組耗時 | 約 26 分鐘 | 約 17 分鐘 |
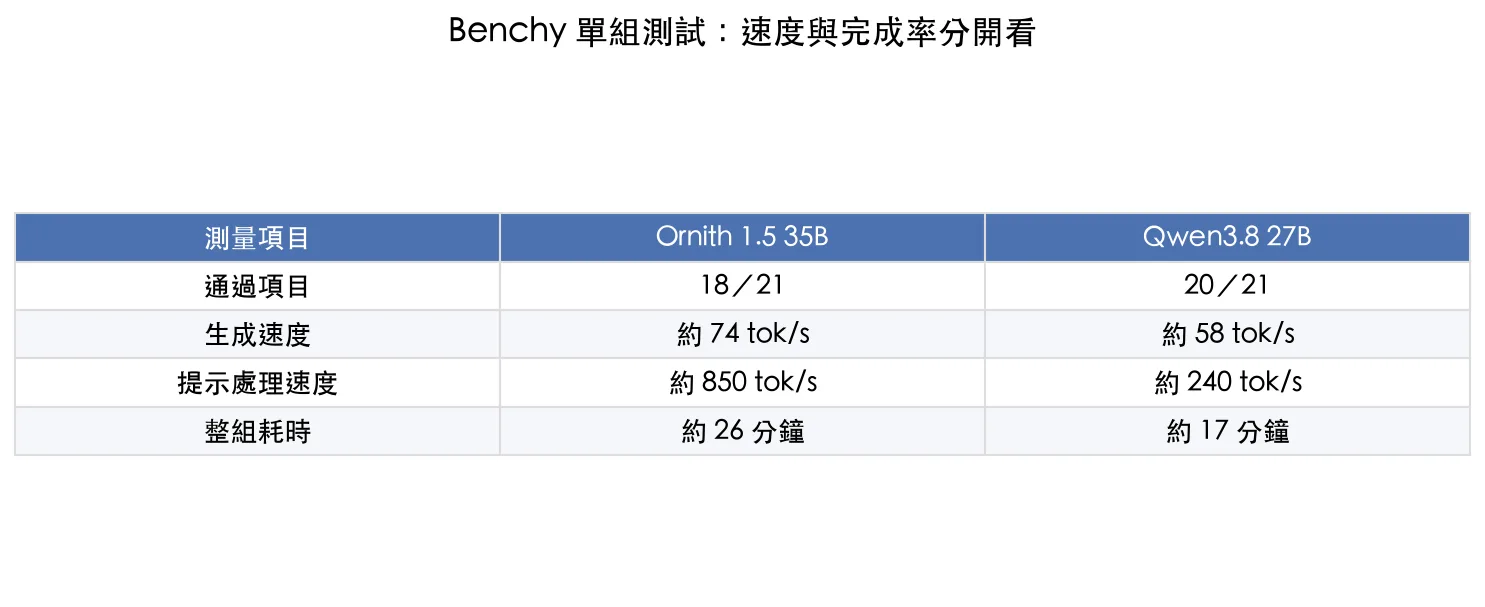
最有參考價值的是 DAG 非同步任務排程題:Ornith 花了約 18,000 個思考 token,耗盡輸出額度後沒有交出最終 Python 程式,Qwen 則完成程式並通過該題檢查。所以每秒輸出較快,仍可能因為思考與重試較多,拖長整個工作的時間。
這也不能反推成所有 MoE 都不擅長推理,或 Qwen 永遠比較穩,模型、量化、引擎與題型都不同,架構本身不能單獨解釋全部差異,要比較自己的程式任務,可參考 Qwen3.8 27B 本地部署教學,固定測試條件再重跑。
雙 GB10 的 NVFP4 實測:減少搬運,也能讓解碼加速
CyberQ 的雙 GB10 實測是在另一套硬體與 vLLM 環境中比較 BF16 與 NVFP4。它固定解碼 800 token,暖機後取三次量測中位數,因此較適合觀察格式差異,不適合直接和前面的 Ollama 成績排高低。
| 雙 GB10/TP=2 | BF16 | NVFP4 |
|---|---|---|
| 解碼吞吐量 | 48.41 tok/s | 101.86 tok/s |
| 12,001 token 提示處理 | 2,767 tok/s | 4,141 tok/s |
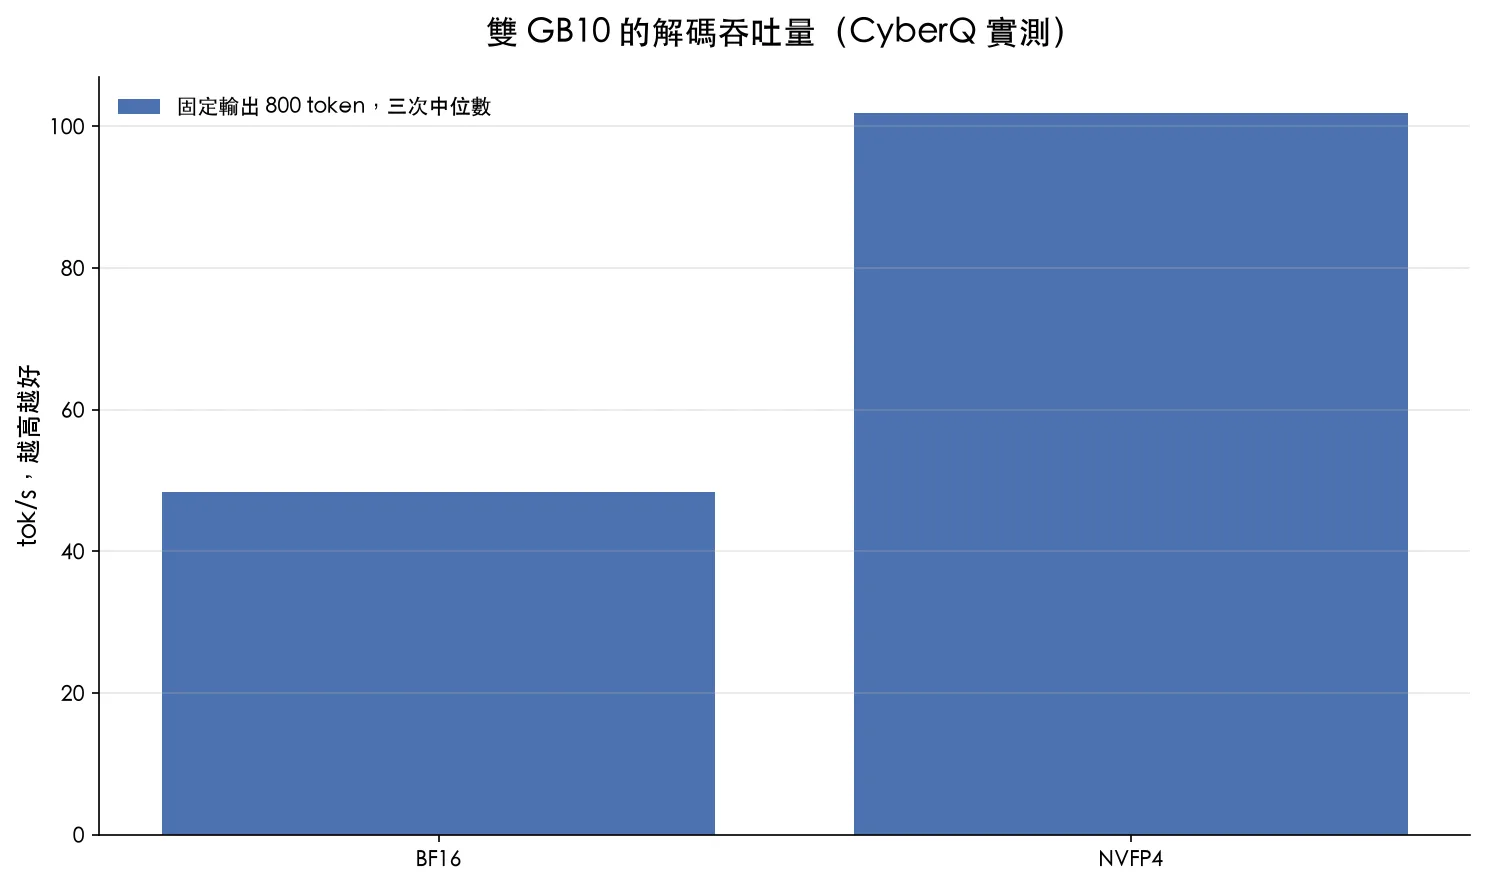
該測試的 NVFP4 路徑先以低位元格式搬運權重,再反量化計算。當瓶頸是記憶體頻寬,減少搬運量就可能抵銷反量化成本。這是推論效率改善,不能解讀成硬體原生算力增加。
品質抽查中,兩種格式在 AIME 2026 都完成並答對 23/30 題,各有 7 題被輸出上限截斷。兩邊共同完成的 22 題答案一致,但答案一致不代表逐 token 的思考過程相同,也不能延伸成量化完全不損失品質。
本地部署怎麼開始?先讓短任務與工具呼叫跑通
先選權重格式與執行工具。桌面試用可從 GGUF 與 Ollama、llama.cpp 相容工具開始,伺服器則參考官方 vLLM 或 SGLang 範例。還不確定差別,可先看 本地大模型推論框架比較。
下載時認明 原始模型庫、官方 GGUF與 官方 NVFP4。另有 AtomicChat 的 GGUF 轉換版本可比較,請記錄實際檔名與量化等級,同樣寫 Q4 不表示所有檔案與執行結果完全相同。
測試時先縮短上下文、一次處理一個請求,確認記憶體與基本輸出正常,再逐步拉長。官方雖提供延伸到約 1M token 的設定,卻也提醒長上下文縮放可能影響一般長度的品質,不必第一次啟動就把視窗開到最大。
接代理前,再測試工具名稱、參數、工具結果回傳,以及模型能否繼續下一步。模型能輸出 tool_calls,只代表這段格式可用,MCP 伺服器還需要由代理程式接上。純聊天成功,不能代替完整工具流程驗收。
最後設定整個任務的時間、輸出與重試上限,並檢查所用引擎是否支援獨立思考額度。只縮小總輸出上限,可能更早截斷最終答案。日常試用可先用幾個有明確驗收條件的小任務,比較完成時間、人工修正量與失敗原因,再決定是否放入長時間自動化工作。
授權與手機部署,哪些說法還要保留?
T客邦的發布報導有助於了解系列定位,但授權敘述與官方 metadata 不一致。
本文以官方模型頁標示的 MIT 為準。
同樣地,9B-Mobile 支援行動裝置的宣稱,不能保證每一款手機都有足夠可用記憶體、支援對應模型格式,或能維持長上下文。先確認使用的 App、量化檔與裝置條件,比直接照搬桌面版的速度數字有用。
常見問題
Ornith 1.5 35B-A3B 是只有 3B 參數嗎?
不是。它是 35B 級 MoE 模型,每個 token 約啟用 3B 參數。儲存與載入仍需考慮完整權重,以及快取和引擎額外用量。
Ornith 1.5 放在本地使用會自己越來越聰明嗎?
官方的自我改進是訓練流程。下載後一般執行推論,不會因為聊天次數增加就自動更新模型權重。
24GB 顯示卡一定能跑 35B 的完整上下文嗎?
不能保證。官方 Q4_K_M 檔約 20.22GiB,還需預留引擎與快取空間。應從短上下文實測,再逐步調整。
Ornith 1.5 和 Qwen3.8 27B 該選哪個?
先用自己的任務比較。公開 Benchy 案例中 Ornith 生成較快,Qwen 通過較多項目。這組結果只適用於該測試條件。
這是美國團隊所推出的模型
Ornith 支援工具呼叫,就能直接連 MCP 嗎?
還需要代理程式與 MCP 連接層。應測試參數格式、工具執行與結果回傳的整個流程。
先看能否完成你的工作,再看分數有多高
Ornith 1.5 值得研究的地方,是它把練習題、工具安排與解法放進同一條訓練流程。而對本地使用者來說,35B-A3B 的實際價值仍要靠任務驗收:能不能在現有記憶體內跑穩、工具是否接得上,以及等待之後有沒有拿到可用成果。
先挑幾個你每週真的會做的工作,讓 Ornith 與現有模型各跑一次。保留設定、耗時與失敗紀錄,往往比看一張總排名更容易做出選擇。若想了解前述測試工具的設計,可再看 Benchy 測試工具建置說明。
近期留言