by Rain Chu | 10 月 8, 2026 | AI, 虛擬人, 語音合成, 語音辨識
AI Girlfriend V2 把語音對話、長期記憶、聲音克隆與數位人口型整合成 Windows 桌面體驗。
你可以先用純語音聊天,再加上角色影像,它最有意思的地方,是把「聽你說話、延續聊天、用指定聲音回答」接在一起,並讓你管理角色記住的內容。
先釐清兩件事,本機啟動不等於完全離線,目前對話模型使用外部 API,8GB 顯示記憶體也不等於數位人一定流暢,純語音與口型生成有不同負載。
AI Girlfriend V2 是什麼?先分清楚三種工具
AI Girlfriend V2 專案是一套語音陪伴整合系統,AIFISHER則是串接圖片、影片、音訊與模型的創作畫布。
作者提供的 RunningHub 體驗頁,實際名稱是「infinitetalk 單人」,發布者為 Aiwood 愛屋研究室,屬於雲端數位人影片工作流。
- AI Girlfriend V2:負責聊天、語音、記憶與可選的人物回話畫面。
- RunningHub 工作流:用來生成或準備人物影片素材,並非完整陪伴 App。
- AIFISHER 畫布:整理素材、模型呼叫與工作流,也可連接本機 ComfyUI。
如果你已經做過 ComfyUI 動態桌布,這次多出的是即時對話與記憶,循環影片的台詞事先決定,語音陪伴系統則會根據當下輸入組織回答。
從麥克風到角色開口,中間發生什麼事
整條流程可以理解成:麥克風收音 → Silero VAD 判斷發言段落 → Whisper 辨識文字 → DSH Bridge 整理會話與記憶 → 外部語言模型回答 → OmniVoice 合成聲音。開啟數位人後,再把音訊交給 WSL2 裡的 Duix/HeyGem 產生口型。
語音辨識、聲音克隆、語意索引與口型預設在本機處理,對話文字送到你配置的模型服務。
若想看懂各層分工,可延伸讀 本地 speech-to-speech 語音 Agent 流程。這也說明為什麼畫面能動,仍可能沒有聲音或回答。
角色訪談:從自我介紹到連續追問
角色先介紹自己的背景,接著回答興趣、其他喜好與感情狀態,再用同一個人設結束對話。
這種短訪談適合觀察回答是否接續前文、口氣是否一致,以及聲音和嘴型能否配合。角色背景是設定內容,不能當作真實人物經歷。
自己驗收時,可以保留相同問題連問幾輪,再故意改變問法。
先核對辨識文字,再看角色有沒有答非所問或把新問題套回固定台詞。外觀自然與理解正確應分開評估。
純語音與數位人,回覆方式也不同
依 專案案例文件,數位人模式採短回答,避免口型任務過長。
純語音可以給較完整的內容,再分段合成與播放,目前這條路徑仍先等待語言模型完成回答,再分段送出,不是模型每產生一個字就立即開口。
「即時語音」適合理解為可來回互動,體感仍包含停頓判斷、辨識、文字生成與語音處理。加入口型還會多一段等待。
驗收時,從你說完到真正聽見回答開始計時,才能比較設定調整是否有幫助。
8GB 顯卡能跑嗎?兩種模式分開看
以下依 Windows 安裝文件整理。這是專案建議,本文未在指定顯卡上重跑測試。兩種模式都面向 Windows 10/11 64 位元,並需要自行準備外部 LLM API Key。
| 項目 | 純語音 | 數位人口型 |
|---|
| NVIDIA 顯示記憶體 | 建議 8GB 以上 | 建議 12GB,8GB 可嘗試 |
| 剩餘磁碟空間 | 約 20GB | 建議 35GB 以上 |
| WSL2/CPU 虛擬化 | 不需要 | 需要 |
| 外部 LLM API Key | 需要 | 需要 |
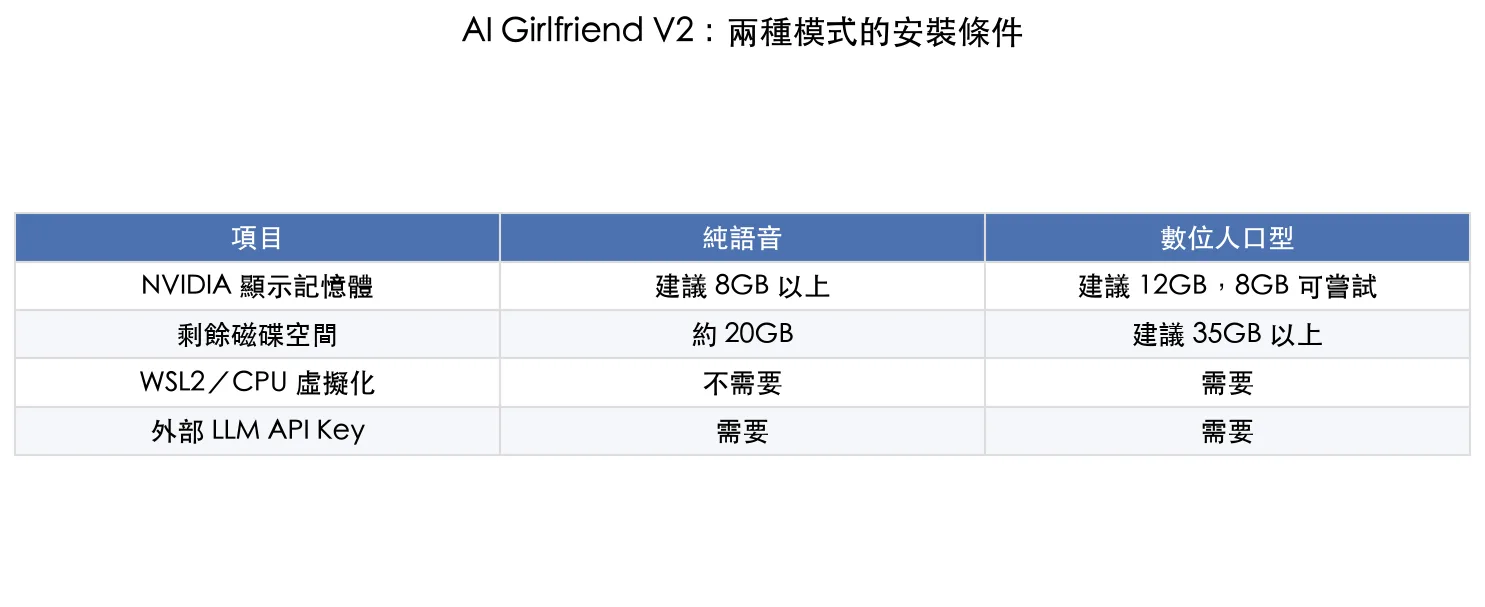 依專案安裝文件整理,核對日期為 2026 年 10 月 5 日。8GB 可嘗試不代表每張顯卡都能流暢運作。
RTX 30 系列不能只用世代判斷是否適用,同系列也有不同容量,還要看驅動、其他程式佔用與實際工作模式,磁碟則要預留解壓、模型與後續輸出空間,不能只按壓縮包大小計算。
安裝前,先確認拿到的是整合包
GitHub 倉庫提供程式碼與文件,不附完整 Python 執行環境、模型、WSL 映像與 DSH 執行元件。
模型與資源文件也明確說明,目前程式碼倉庫不是能獨立從零啟動的一鍵包,下載幾套模型仍不夠。
作者提供的 AI Girlfriend 整合包下載入口與 GitHub 用途不同。
取得包後先核對版本及檔案是否齊全,再按相同版本的安裝文件操作。本文沒有下載或執行網盤整合包,也沒有驗證其完整性。
第一步:先讓純語音聊天成功
- 完整解壓到英文、無空格路徑,例如 D:\AI-Girlfriend。
- 依包內文件執行「一键启动.cmd」,沒有數位人環境時會使用純語音模式。
- 在「設定 → 語言模型」選擇 GLM、Kimi、DeepSeek,或配置支援的相容服務,填入自己的 API Key。
- 允許瀏覽器使用麥克風,先用預設音色測試一段簡單對話。
第一次先不要同時換角色、聲音、人設與模型,先確認辨識文字是否正確、回覆是否答到問題,以及聲音能否完整播放。這三件事過關後,再逐項增加設定。
第二步:需要人物畫面,再啟用 WSL2
數位人口型需要 WSL2 與 CPU 虛擬化,完整包的「首次安装.cmd」會檢查環境並匯入引擎,尚未啟用 WSL2 時可能出現管理員授權與重新啟動要求,依提示完成重啟後,再次執行安裝,等引擎就緒才回到日常啟動流程。
有聲音但沒有人物畫面時,可先關閉數位人繼續聊天,再查 WSL2 與口型服務。網頁、語音、記憶及口型是不同服務,不能靠反覆重整網頁修復缺失的引擎或模型。
角色影像、待機影像與聲音,應該怎麼準備
角色影像是後續口型生成的素材,待機影像則負責等待時的自然動態,先選同一位角色、相近構圖與光線,嘴部保持清楚,避免手或物件遮擋,才容易在等待與說話畫面間切換。
人物素材可先用 AIFISHER 產生參考圖,再到 RunningHub 準備影片,公開的 InfiniteTalk 工作流頁列出圖像載入、音訊載入與 WanVideo 等節點,使用時應按實際工作流要求提供素材。雲端先生成底片,可以減少為了少量素材另建一套本機影片生成環境的時間。
不過,素材在雲端生成與聊天時在本機合成口型,是兩個階段,完成底片不代表對話系統已建立,RunningHub 的排隊、執行費用與可用條件也需另行確認,本次沒有執行付費工作流。
安裝文件建議使用短而清楚的正面影片,以及乾淨的單人參考錄音,聲音克隆還需準備與錄音一致的文字,雜音、背景音樂或錯誤逐字內容,都會增加後續辨識與合成的不確定性,人物與聲音先使用自己製作或有授權的素材。
如果想自己拆開人物服務與聊天模型,可參考 Qwen3 與 LiveTalking 的語音數位人串接方式,那是另一組元件配置,不能把腳本或模型直接當成 AI Girlfriend V2 的替換品。
人設先寫回覆規則,再補背景
角色介紹可以有興趣與說話習慣,但日常體驗更受回覆長度、追問節奏與事實一致性影響
以下是本文設計的起步示例,可依需求調整,並非專案預設提示詞。
你是一位名叫小晴的虛擬聊天夥伴,使用自然的台灣繁體中文口語。先回應我剛說的內容,每次說一兩個重點,再視需要提出一個簡單問題。不確定的事直接說不確定,不要虛構我沒有說過的經歷。需要記住偏好時,保留原話的意思。
長期記憶有什麼用?也要能修正
AI Girlfriend V2 使用 DSH 會話檢查點、SQLite 事實庫與語意索引保存脈絡。
檢查點幫助延續完整對話,事實庫保存稱呼等資訊,語意檢索則讓你換一種問法找回舊話題。
它不等於每次把所有歷史逐字塞進模型,也不保證永遠記得所有細節。
可以先用一段虛構資料驗收:告訴角色一個稱呼,重新啟動後再問一次。
接著用不同說法詢問先前偏好,最後在記憶面板更正資料,檢查新答案是否採用更正結果。專案文件把這些列為合成案例,不能直接視為所有真實對話都已驗證。
「移出記憶」會從長期事實與檢索中抑制內容,但原始 DSH 會話檔案仍可能保留。
它的效果不同於把所有歷史物理刪除。關係進度也只是依聊天規則累積的介面回饋,適合當作互動設計理解。
AIFISHER 畫布怎麼搭配使用
AIFISHER 把圖片、影片、音訊與文字放在同一個創作空間,讓你整理參考素材、呼叫模型與保存結果。製作桌面角色時,可以先固定一張形象,再整理待機與說話影片,避免素材散落在不同資料夾。
目前 官方 README提供本機 ComfyUI、RunningHub 與模型服務接入。
來源工作流匯入後,仍需確認要暴露哪些輸入參數,再保存成畫布中的流程,不能只看節點已載入就判定模型與服務都能執行。
下載可由 版本發布頁或 目前 README 的安裝版入口確認。
本機保存、外部 API 與使用授權
依 AI Girlfriend V2 安全說明,本機服務預設只監聽 127.0.0.1,模型收到的對話文字仍會傳給配置的外部供應商,API Key、對話紀錄、聲音與人物影片是不同資料,備份或分享整合目錄前要分開檢查。
AIFISHER 的專案與素材預設存在本機,但呼叫線上生成會傳出相關提示詞與參考素材,官方服務也可能接收裝置識別與呼叫診斷。因此,「本地畫布」也不能直接推論為完全不連網或資料永不離開電腦。
使用範圍請分別看文件,AI Girlfriend V2 沒有宣告整個倉庫都使用同一授權,第三方元件說明列出的 OmniVoice 預訓練權重有非商業限制,AIFISHER 授權則明確限制非商業用途,並禁止接單、商業製作與倒賣,不能把公開程式碼視為可自由商用。
第一次體驗,我會先確認這幾件事
- 用預設角色與音色,把收音、辨識、回答和播放跑通。
- 用虛構資料測試跨重啟記憶與人工更正。
- 加入短人物影片,確認等待時間、口型與音訊是否可接受。
- 再逐項調整人設、音色與角色素材,保留可以退回的設定。
這套系統的價值在於把多個元件包成可使用的桌面流程,並把記憶管理交回使用者。先讓一段對話穩定完成,比一開始追求高畫質、複雜人設與更大模型更容易得到可長期使用的結果。
常見問題
AI Girlfriend V2 可以完全離線聊天嗎?
目前專案配置的對話 LLM 使用外部 API,語音辨識、聲音克隆與口型等在本機處理。本機啟動不等於整套系統完全離線。
8GB 顯示記憶體可以使用嗎?
安裝文件對純語音建議 8GB 以上,數位人建議 12GB,8GB 可嘗試。實際流暢度仍受顯卡、其他程式與工作模式影響。
從 GitHub 下載程式碼,就能一鍵啟動嗎?
不能。倉庫沒有完整執行環境、模型與數位人映像,初次體驗應確認取得相同版本且檔案齊全的 Windows 整合包。
RunningHub 那個頁面是完整 AI 女友嗎?
該頁是 infinitetalk 單人影片工作流,用來生成數位人素材。即時聊天、語音與記憶仍由另外的桌面系統處理。
AIFISHER 能用來做商業接單嗎?
目前 AIFISHER 授權限制非商業用途,並禁止接單與商業製作。其他元件、模型與素材也需分別核對使用範圍。
by Rain Chu | 10 月 7, 2026 | AI, QWEN
Strata 能把 Qwen3.8-Flash-Next 分散到 GPU、系統記憶體與 SSD,在個人電腦上提供聊天、圖片理解和 Agent 使用的本地模型服務,依 v0.1.13 文件,較實際的起點是 NVIDIA RTX 30/40/50 系列、12GB 以上顯存,以及 64GB 系統記憶體。
這套工具值得研究的地方,是讓既有桌機分工承擔大型模型,而不是把所有成本變不見,安裝前,先確認顯卡支援、可用 RAM、磁碟空間與打算使用的上下文長度,會比追著最高 tokens/s 更有幫助。
本文以指定的 v0.1.13 為核對基準,案例是公開示範的整理,沒有在本文另外重跑硬體實測。
Strata 是什麼?模型、推理引擎與 Agent 要分開看
Qwen3.8-Flash-Next 官方模型卡列出 125B 主模型參數、每次啟用約 6B,另有 n-gram embedding 與 MTP 元件,MoE 每一步只使用部分專家,有利於分工運算,但完整權重仍要有地方保存。
Strata 負責載入與執行模型,並提供網頁介面和 API,Hermes 等 Agent 則負責規劃、操作檔案及呼叫工具。
把兩者接起來,才會從「產生一段程式碼」進入「建立專案、執行、查看錯誤、再修改」的循環。
- GPU 保留常用運算元件與熱門專家,盡量利用顯存中的資料。
- RAM 保存專家權重,CPU 處理未命中 GPU 快取的部分,與 GPU 協同運算。
- SSD 保存大型查找表,依需要讀取相關資料。
- MTP 先提出後續 token 候選,再由主模型驗證,減少逐步解碼的成本。
這是特定引擎配合特定模型的設計,不能推論任何 GGUF 都能直接換上去,想先了解候選 token 與驗證的概念,可以延伸看站內的 MTP 本地推理加速整理,Strata 的分層細節以 固定版本技術文件為準。
8GB 能跑,但有三個條件不能省略
第一,官方路線是 NVIDIA,AMD CPU 不等於 AMD 顯卡
v0.1.13 的 硬體要求寫明 12GB 以上 NVIDIA 顯卡,並註記 8GB 可以執行但較慢。
安裝程式也會透過 nvidia-smi 檢查 GPU,找不到 NVIDIA 顯卡就停止。
CPU 支援 Intel/AMD 的 x86-64 與 AVX2,這與支援 Radeon 顯卡是兩回事。
因此,這份 Windows/Linux 教學不能直接套到 AMD GPU 或 Apple Silicon。
即使底層借用了 llama.cpp 的元件,也不代表它自動繼承所有後端。
官方量測以 RTX 5070 為主,列入支援範圍的其他系列也不等於逐張完成驗證。
第二,大量 RAM 仍然必要,不能只算顯存
模型的專家權重主要留在系統記憶體。大顯卡可以減少 CPU 的工作,卻不會讓這份 RAM 需求消失。
v0.1.13 安裝程式為不同量化設定了記憶體需求值,以下是部署規劃用數字,不是本文測得的即時占用。
| 量化 | 模型下載量 | 專家記憶體約占 | 安裝程式 RAM 需求值 |
|---|
| Q2_0 | 66.4GB | 34.0GB | 48GB |
| IQ2_XS | 68.0GB | 35.5GB | 48GB |
| IQ3_XXS | 75.8GB | 42.9GB | 60GB |
| IQ3_S | 83.6GB | 50.3GB | 62GB |
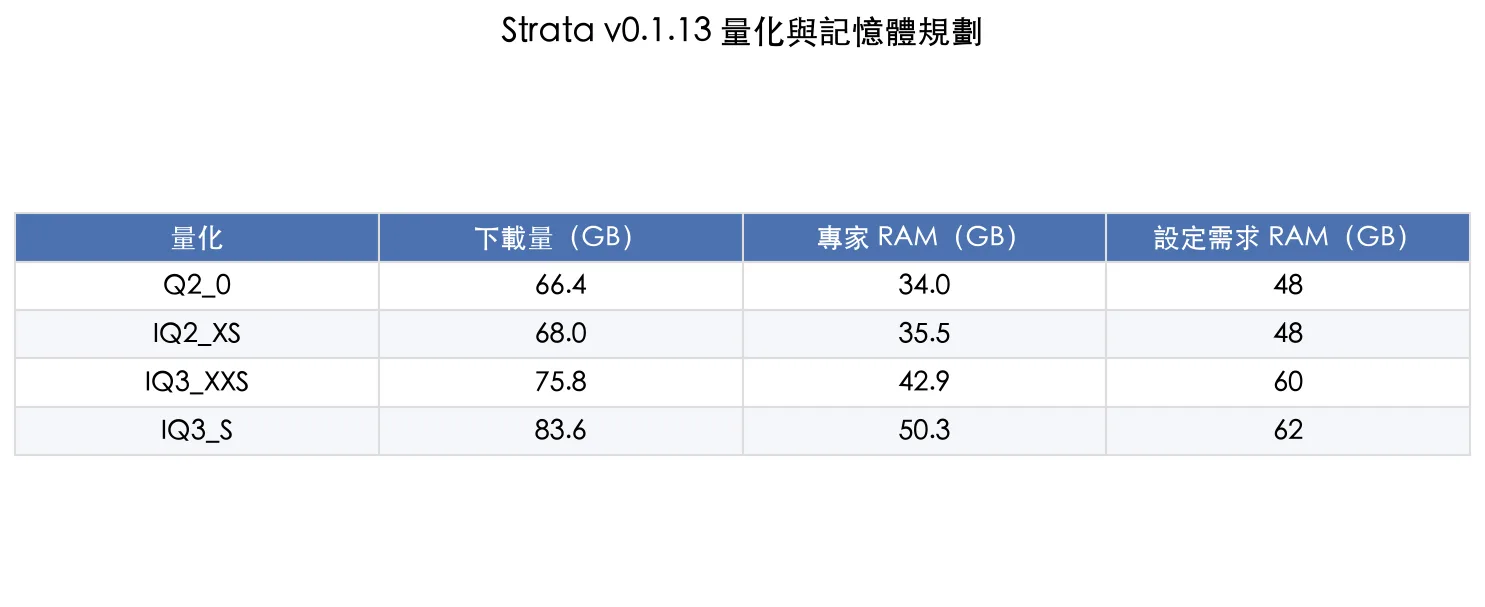 依 v0.1.13 setup.py 整理,GB 沿用原始標示。RAM 需求值不是剩餘記憶體,也不是 GPU 顯存需求。
64GB RAM 是較容易規劃的配置,使用 IQ3_S 時仍要控制背景程式,模型檔之外還有引擎、MTP 與暫存,部分 Q2_0/AVX-512 組合會建立額外的專家資料副本,不能只按下載大小留磁碟。先用較小量化、較短上下文,確認實際餘裕再提高設定。
虛擬記憶體能提供位址空間與換頁機制,但不能當成同容量 RAM 的速度替代。
這個版本也會檢查實體 RAM。若已經不停讀寫磁碟、整機反應很慢,優先關閉其他程式或選較小模型,不要預期把分頁檔加大就能維持同樣吞吐量。
第三,8GB 安裝畫面不能替代 24GB 測試結果
這組公開示範先顯示 8GB 顯存與 64GB RAM 的設定,後續明確切換到 24GB 顯存,才繼續進行程式與 Agent 案例。
因此,後面的遊戲生成表現不能作為「8GB 顯卡同樣快」的證據。
評估自己的電腦時,至少要一起記錄 GPU、RAM、量化、上下文、影像開關與完整任務耗時。
安裝 Strata:先完成文字聊天,再加圖片與 Agent
1. 下載完整專案,分清原始碼與引擎壓縮檔
從 Strata v0.1.13 發行頁進入版本資料。
新手需要包含 START-HERE.bat、setup.py 等檔案的完整專案。
發行附件 strata-windows-x64.zip 是引擎,symbols 壓縮檔供除錯,不要把引擎附件誤認成完整安裝介面。
Windows 更新 NVIDIA 驅動後,解壓完整專案並執行 START-HERE.bat。
Linux 使用 ./setup.sh。
v0.1.13 文件要求驅動 580 或更新版本。安裝器會處理 Python、依賴、引擎與模型下載,沒有現成引擎可用時可能需要編譯。
需要重現版本時,還要查看啟動日誌中的 engine 版本。
v0.1.13 的安裝程式預設下載 latest 發行引擎,所以只下載舊版原始碼,不代表最後執行的一定是同一版引擎。本文沒有把後續 main 分支新增功能混入這份教學。
2. 選原版或 Swift 1.5,再選量化
Swift 1.5是 UkisAI 的微調版本,主要方向是縮短思考內容。
「較快給出答案」可能來自生成的思考 token 變少,不是每一個 token 都跑得更快。效果與授權應分別看模型頁,不能直接當成所有任務都等效的加速開關。
不確定如何選時,可從官方 README 建議的 IQ2_XS 開始。
Swift 1.5 在這個版本沒有 IQ3_S 選項,模型越小越省空間,但程式正確率、長文本與工具使用是否符合需求,仍要用自己的任務驗證。
如果 RAM 不足,Qwen3.8-27B 與 GGUF 部署整理提供另一種較小模型的評估方向,不能把兩者硬體表混用。
3. 上下文與影像功能逐步增加
v0.1.13 安裝程式會依顯存建議上下文,較小顯存通常先選 32K。長上下文會占用更多快取與工作空間,並擠壓 GPU 可保存的專家數量,KV Cache 先用建議的 8-bit,4-bit 是節省空間的選項,不是無條件提升品質與速度。
需要讀圖片時再開啟影像編碼器,官方文件列出的 GPU 影像路線會額外保留約 1.4GB 顯存,這對 8GB 顯卡尤其有感。純文字聊天還沒穩定時,先不要同時開啟最長上下文和影像功能。
4. 確認服務完成啟動
終端機顯示服務就緒後,在同一台電腦開啟 http://127.0.0.1:8080。
Chat 用於聊天,Monitor 查看 GPU、CPU、RAM 與請求狀態。
第一次載入大型權重可能很慢,先看日誌進度。
頁面顯示舊介面時可以強制重新整理,但後端已退出或記憶體不足,需要處理後端原因。
v0.1.13 快在哪裡?讀提示詞與輸出要分開看
v0.1.13 發行說明的重點是 prefill,也就是讀取提示詞的階段。
專案公布的 RTX 5070 12GB、Ryzen 5 7600、64GB DDR5 測試如下。這些是開發者的特定條件測量,不是對任意顯卡的保證。
| 32K-token 提示詞 | v0.1.12 | v0.1.13 |
|---|
| Q2_0 | 572 tokens/s | 1,290 tokens/s |
| IQ3_S | 383 tokens/s | 1,208 tokens/s |
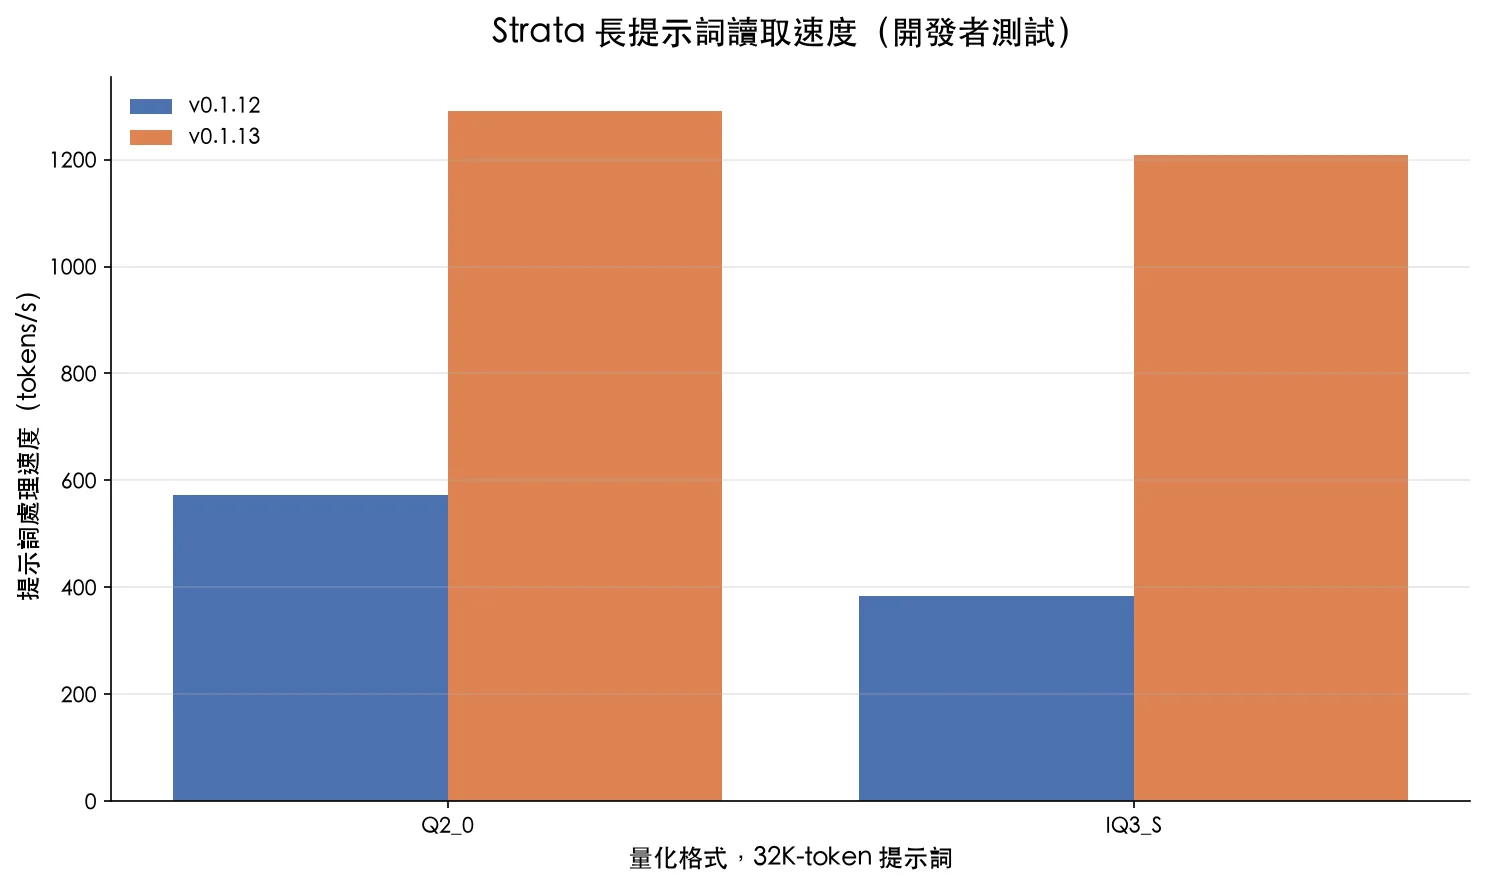 開發者公布的 prefill 測試。RTX 5070 12GB、Ryzen 5 7600、64GB DDR5。數字不是回答生成速度。
新版透過較大提示詞區塊、量化運算核心,以及資料傳輸與運算重疊等方式減少等待。
公開測試紀錄同時寫明:回答輸出路徑未改,生成速度不因此增加,不能把 1,290 tokens/s 當成聊天輸出的速度,也不應把舊 README 的讀取數字與新版測試混成一張排行榜。
實際工作感受由首次等待、思考長度、輸出長度與工具執行時間一起決定,模型每秒輸出很多 token,仍可能花很久生成大型專案。tokens/s 也不能直接換算成固定數量的中文字。
接到 Hermes Agent:先測 API,再交付長任務
在 Agent 中加入 OpenAI 相容提供方,Base URL 使用 http://127.0.0.1:8080/v1。預設本機服務若未啟用驗證,客戶端要求非空 API Key 時可填占位字串。若已設定服務密鑰,就必須使用實際密鑰。模型名稱可依 /v1/models 顯示選擇。
Base URL: http://127.0.0.1:8080/v1
Chat Completions: POST /v1/chat/completions
Model list: GET /v1/models
Health: GET /health
上述 API 路徑可在 Strata API 文件核對。先發送一句短訊息,再測一次小型工具呼叫,最後才做多檔案專案。Agent 若跑在另一台電腦或容器,127.0.0.1 指的是它自己,必須依實際網路環境調整,不能照抄位址。
本地推理可以省去外部模型 API 的逐 token 費用,硬體、電力和維護成本仍然存在。Agent 額外使用的搜尋、語音或其他雲端服務,也要分開確認。先讓工具只操作指定專案資料夾,保留變更紀錄,會比較容易找出長任務失敗的位置。
常見問題
8GB 顯存能跑 Strata 嗎?
v0.1.13 官方細節文件表示可以執行但較慢,建議 12GB 以上 NVIDIA 顯卡。仍需足夠的系統 RAM、相容 CPU 與磁碟空間,不能把 24GB 的示範速度套到 8GB。
AMD 顯卡或 Mac 可以照這篇安裝嗎?
不適用。這份 v0.1.13 安裝流程檢查 NVIDIA GPU 並使用 CUDA。支援 AMD CPU 不代表支援 AMD 顯卡,Apple Silicon 也不在這份流程的支援範圍。
32GB RAM 加大虛擬記憶體就夠嗎?
不要這樣規劃。指定版本的完整模型路線要求大量實體 RAM,最小量化的安裝需求值為 48GB。頻繁換頁會拖慢系統,較小模型通常是更實際的替代選項。
Strata 可以無限長對話嗎?
不行。請求仍受設定的上下文長度與記憶體限制。長任務成功不代表沒有上限,超出時應縮短歷史、開新對話或在硬體允許範圍內調整設定。
我的建議:先驗證日常任務,再追求最大模型
已有足夠 RAM 與相容 NVIDIA 顯卡,可以從較小量化、短上下文、純文字開始,再加入圖片與 Agent。先記錄一次真實工作從送出到完成的時間,確認成品可用,才決定是否值得投入更多硬體。
Strata 的價值是提供個人電腦執行大型模型的新方法。真正要比較的,是你的任務能不能穩定完成,而不只是參數量、瞬間速度,或某一次看起來很漂亮的展示。
資料核對日期:2026 年 9 月 29 日。安裝與量測以 v0.1.13 原始碼、文件及發行說明為基準。更新後請重新確認支援範圍、實際引擎版本與模型授權。
by Rain Chu | 10 月 6, 2026 | 硬體, 程式
核心數增加,程式不一定會等比例變快。真正的限制,可能是工作不能同時做、資料送不進來,或有人早已做完,卻還在等最慢的那一份。
要改善平行運算效能,先找出時間花在哪裡,再決定要加核心、減少資料搬移,還是重新分配工作。
想像一間廚房:增加廚師,只有在食材供應、料理分工和出餐順序都配合時才有用。
如果所有人都擠在同一個冰箱前,爐子再多也救不了。這個觀點同樣適用於 CPU、GPU,以及把工作分到多台電腦的系統。
先看三種「人多卻更慢」的情況
把一疊數字分給兩個人計算,算的部分確實可以縮短,但如果兩人坐在教室兩端,還得走過去交付小計,最後的總時間就包含計算、傳遞與合併。省下的時間,可能全被溝通吃掉。
換成四個人,也不保證改善,如果其中一份特別難,另外三人先完成後只能等待,完成時間仍由最慢的一份決定,再把全班都拉進來數人頭,如果要先搬椅子、換座位、協調隊形,光是準備工作就可能比直接清點更久。
這三種情況,分別對應通訊成本、負載不均,以及拆分工作的額外開銷,Stanford CS149 第一講用課堂活動說明這些限制,實際程式裡則可能表現成資料複製、同步等待、任務建立與排程。
「有變快」和「用得有效率」是兩回事
加速比是原本的執行時間除以新的執行時間。同一件事從一分鐘變成半分鐘,就是兩倍加速。這可能已經有商業價值,但如果用了大量額外硬體,仍要另外看資源利用率與成本。
比較時要固定資料量、演算法、輸出品質與計時範,。拿最佳化過的多核心版本,去對照刻意寫得很慢的單核心版本,得到的漂亮倍數無法說明平行化本身貢獻多少。
加核心有上限:用 Amdahl 定律算一個例子
假設一項固定工作在單核心需要 100 秒,其中 20 秒必須依序做,剩下 80 秒可以完美分工。
即使忽略排程與通訊成本,增加核心也只能縮短那 80 秒。這是本文另外設計的理論示意,不是影片實測,也不是任何 CPU 的跑分。
總時間=20+80 ÷ 核心數。加速比=100 ÷ 總時間。這個簡化模型對應 Amdahl 定律,假設各核心能力相同,工作量固定,而且可平行的部分能均勻分配。
| 核心數 | 理論執行時間 | 相對單核心加速 |
|---|
| 1 | 100.0 秒 | 1.00 倍 |
| 2 | 60.0 秒 | 1.67 倍 |
| 4 | 40.0 秒 | 2.50 倍 |
| 8 | 30.0 秒 | 3.33 倍 |
| 16 | 25.0 秒 | 4.00 倍 |
| 32 | 22.5 秒 | 4.44 倍 |
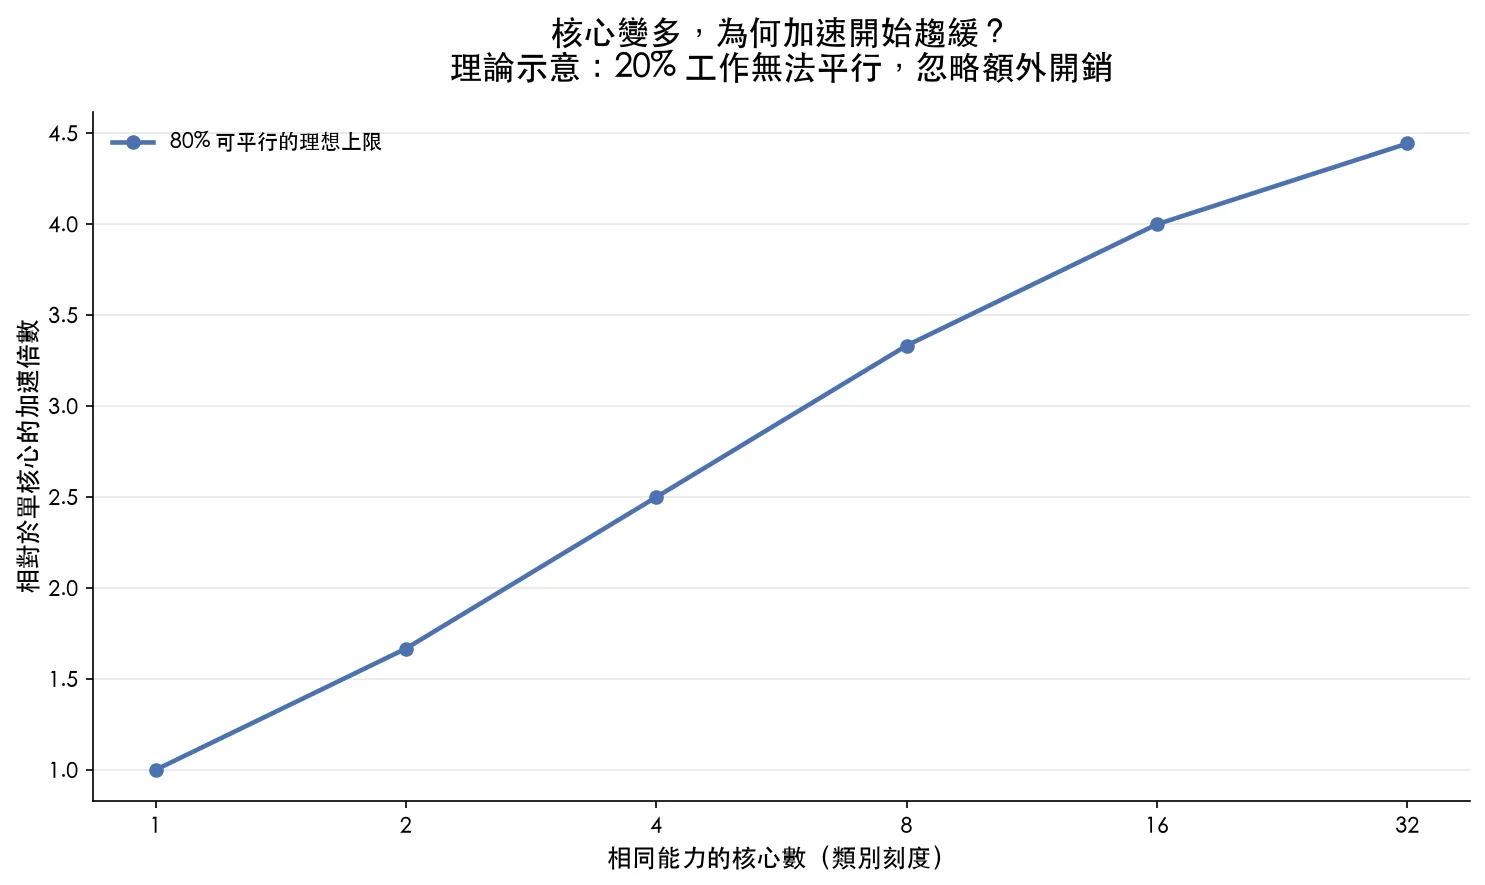 固定工作量、20% 依序執行、忽略額外開銷的理論示意。橫軸採類別刻度,並非硬體實測。
即使核心數持續增加,這個例子的加速也只會逐漸逼近五倍,實際程式還有其他開銷,所以診斷時要同時看「哪些部分不能拆」和「拆開後多付了什麼成本」,如果增加的是工作量而不只是核心數,就要另看吞吐量或弱擴展。
超純量、多核心、SIMD,分別在平行什麼?
處理器早就不只靠提高時脈來加速。功耗、散熱和指令相依關係,限制了單一執行流程的成長。
多放運算資源只是起點,軟體還要提供足夠、可同時執行的工作。
超純量:在同一條指令流裡找出可同時做的事
超純量處理器可以在條件允許時同時發出多道指令,例如兩筆互不依賴的乘法有機會重疊執行,但下一步若要用到前一步的結果,就必須尊重相依關係。硬體能尋找現有的平行性,卻不能憑空消除資料依賴。
多核心:讓不同工作各自前進
多核心讓不同執行緒有機會同時執行,各核心可以處理不同的指令流。
前提是程式、函式庫或執行環境有把工作拆開。只開一條主要計算執行緒,不會因為買到更多核心就自動平均分散。
課程以縮小複雜控制邏輯、換取更多核心來解釋設計取捨,但這是幫助理解的模型
。實際 CPU 常同時具備複雜核心、多核心與向量單元,不應理解成現代多核心都取消了亂序執行,或每個核心必然比較慢。
SIMD:同一個動作,一次處理多筆資料
SIMD 是單一指令、多重資料,例如把一批像素的亮度做相同調整,向量指令能同時處理多個元素,一次能處理幾筆,取決於指令集、向量寬度與資料型別,「一次八筆」只是常見教學例子。
如果不同元素需要走不同分支,部分運算通道可能被遮蔽,等待另一條路完成,這就是分支分歧造成的浪費,多核心的各個核心可以走不同指令流,SIMD 組內則有更強的共同執行限制,兩者不能當成同一回事,參考 CS149 的多核心架構講義。
NumPy 等工具可以把批次運算交給最佳化實作,但一個陣列加號不代表整個陣列只需要一道機器指令。
通常仍有分批載入、向量運算、寫回及邊界處理,是否使用 SIMD 也受資料型別與平台影響,NumPy 官方 SIMD 說明介紹了依 CPU 能力選擇運算核心的機制。
快取解決什麼?讓同一份資料少跑幾趟
記憶體階層可以想成倉庫、車庫與工作桌,空間越靠近操作的人,通常越有限,卻也越方便拿取,快取的價值,就是讓近期或附近會用到的資料留在靠近核心的位置。
- 時間區域性:剛用過的資料,稍後還會再用,保留它能減少重新讀取。
- 空間區域性:這筆資料旁邊的內容很快也會用到,連續存取能更有效利用一次帶回的快取列。
所以同樣數量的運算,不同資料排列方式可能有明顯速度差,連續掃描陣列,和沿著分散的指標到處跳,給記憶體系統的壓力不同。把工作切成適合快取的小區塊,完成區塊內的多個步驟再往下一塊,常比每個步驟都重掃整份資料更值得試。
快取不會保證所有存取都快,工作集合太大、資料重用不足,或不同核心反覆改動同一快取列,都可能增加傳輸,甚至兩個執行緒修改的是不同變數,只要它們碰巧位於同一快取列,也可能產生偽共享,需要用量測確認。
延遲與頻寬不同,多執行緒也不能取代頻寬
延遲是等一份資料需要多久,頻寬是單位時間內能送多少資料。
增加車道可以讓更多車通過,卻不必然縮短每台車從起點到終點的行程,相同地,記憶體頻寬提高,不代表每一次零散讀取都會更快。
硬體多執行緒的想法,是某條執行緒等待時,先安排另一條準備好的執行緒使用運算單元,它可以隱藏部分等待,增加整體吞吐量,但不會讓原本那份資料提早到達,也不等於多出完整的實體核心。
這招需要足夠的獨立工作和可用資源,如果記憶體通道早已滿載,再增加執行緒只是在增加排隊者,把「多執行緒能隱藏延遲」直接說成「多執行緒能解決所有記憶體問題」,就會選錯最佳化方向。
為什麼高階 GPU 也可能吃不滿?
做兩個大陣列的逐元素乘法時,每筆結果只做少量算術,卻要讀取輸入並寫回輸出,這種工作可能先用完記憶體傳輸能力,運算單元仍有餘裕,CS149 第三講以 V100 時代的假設硬體與運算模型說明這件事,低利用率是特定工作負載相對算術峰值的估算,不能解讀成所有 GPU 都只有固定百分比有效能。
這裡的關鍵是算術強度:相對於搬動的資料量,完成了多少運算,若能把資料載入後多用幾次,或避免不必要的中間結果寫回,就可能提高效率,不過增加無意義的計算,只會讓數字好看,並沒有更快完成使用者的工作。
跑本地模型時也要區分「放得下」和「送得快」,容量決定可容納的資料與模型規模,頻寬影響搬運速度,實際瓶頸還會隨批次與階段改變。可以接著看站內的 本地 AI 記憶體容量與頻寬整理,理解為什麼只看 GPU 核心數不夠。
工作怎麼分,決定大家會不會互相等待
靜態分配是在開始前先切好每個工作者負責的範圍。它簡單、開銷低,也容易保留資料區域性,適合每份工作成本接近的情況,若有些影像區塊特別難算,平均分配像素數不等於平均分配計算時間。
動態分配則讓工作者完成一批後,再領下一批,降低有人空等的機會,代價是領取任務、同步與管理佇列都要成本,每批太大,仍可能負載不均。每批太小,則可能忙著領工作而非真正計算。
一個實用折衷,是把大任務切成數量多於工作者的區塊,同時讓每個區塊保有足夠的連續資料,再比較不同區塊大小的總耗時,而不是預設動態排程一定比較快,CS149 的工作分配與排程講義也把負載平衡和管理開銷放在一起討論。
判斷一批整數是否為質數,就是很直觀的例子,使用逐一試除的做法時,不同數字可能花費不同時間,平均分配數字個數不代表負載均衡,如果能事先估計成本,提早安排較大的任務,也可能減少最後只剩一人忙碌的長尾。
ISPC 與 Cilk:表達可平行的工作,交給系統安排
ISPC 讓你用接近逐筆處理的方式描述運算,再以一組 program instances,也就是 gang,執行相同程式。
要特別分清楚:在 CPU 的常見用法中,gang 主要對應向量化,並不代表每個 instance 都是一條作業系統執行緒。
跨核心並行還需要 task 或呼叫端的多執行緒安排,入門可參考 ISPC 官方文件與 CS149 第一份程式作業。
Cilk 則以分支、匯合的方式表達任務相依關係,當一個工作者沒有事做,可以透過 work stealing 從其他工作者取得尚待執行的工作。重點是暴露可平行的任務,再由執行系統排程,而不是為每個小任務都建立一條新執行緒。想動手學習,可以從 OpenCilk 的平行任務教學開始。
快速排序則呈現另一種情況:先把資料按基準值分成兩側,接著左右可以分別排序,可平行的子問題隨遞迴逐步出現,是否能順利利用多核心,還受分區均衡與最小任務大小影響,Cilk 的關鍵字也不是所有標準 C++ 編譯器都直接支援,實作時要使用支援它的工具鏈。
資料搬運也要分:必要交換,還是實作多出的往返?
有些通訊是目前演算法與工作分配必須付出的成本,例如把影像分區後,相鄰區域需要交換邊界資料。
有些則來自實作細節,例如快取容量不足、傳輸粒度太大、重複複製中間結果。CS149 第六講將兩者區分為 inherent communication 與 artifactual communication。
區分的目的,是找到可以改的地方。必要交換不代表完全無法減少,重新選擇分區方式可能縮小邊界,實作造成的往返,也可能透過更好的資料布局、合併步驟和重用快取來降低。
把模型或工作拆到多台機器時,這些原則仍成立,除了各台機器的能力,還要看互連、分片方式與交接資料量,站內的 EXO 與本機 AI 分工整理,可以延伸理解多機合作為什麼不是把規格直接相加。
同樣地,顯存不足時把部分模型卸載到系統記憶體,可能讓工作成功執行,卻增加資料搬移。像 LTX 的低顯存工作流程,就適合用「容量換取可執行性,再付出搬運成本」的角度評估,不能只看是否成功啟動。
遇到程式跑不快,我會按這個順序檢查
- 固定基準:使用同一份輸入、相同輸出品質與完整計時範圍,保留可重現的單核心或原始版本。
- 找出熱點:先確認時間花在計算、I/O、記憶體、同步還是外部服務,別直接從增加執行緒開始。
- 逐步增加並行度:比較少量與較多工作者的總時間,也看各工作者是否平均忙碌。
- 檢查資料路徑:是否反覆複製、跨裝置來回、產生巨大暫存,或無法利用連續存取。
- 一次改一項:調整區塊大小、合併運算或排程策略後,重新檢查正確性與總耗時。
不要只追求 CPU 或 GPU 的使用率數字。忙碌可能代表重複計算,低使用率也可能是合理地等待磁碟或網路。最終要回答的是:在相同品質與限制下,完成同一件事花了多久,用掉多少資源。
平行運算常見問題
核心越多,任何程式都會更快嗎?
不會。程式必須有足夠可同時執行的工作,而且不能被序列部分、記憶體頻寬、同步或負載不均限制。更多核心也可能增加額外開銷。
SIMD 和多核心有什麼不同?
SIMD 讓一個指令同時作用於多筆資料,多核心則讓不同核心執行各自的指令流。兩者可以並用,但工作必須符合各自的執行方式。
快取越大,效能一定越好嗎?
不一定。資料是否會重用、存取是否連續、工作集合大小與其他核心的存取方式,都會影響快取是否真的減少等待與搬運。
多執行緒可以解決記憶體頻寬不足嗎?
多執行緒能在有獨立工作時隱藏部分延遲,但不會增加實際可用頻寬。通道滿載後,增加執行緒可能只增加排隊與競爭。
應該先升級硬體,還是先改程式?
先量測。若主要成本是重複搬移、任務分配或序列熱點,改善程式可能更有效。確認瓶頸確實對應硬體能力後,才有依據選擇升級項目。
先找到等待發生在哪裡,再談加速
平行運算的核心問題,是讓可同時做的工作真正同時進行,同時控制搬資料、分工與等待的成本。多核心提供空間,SIMD 提高相同運算的吞吐,快取減少遠端存取,多執行緒利用等待空檔,排程則避免工作分配失衡。它們各自解決不同問題,沒有哪一招能包辦全部。
如果手上就有一段跑不快的程式,先記錄它在不同工作者數量下的完整耗時,找出哪一步開始不再改善。這個轉折點,往往比硬體規格表更能告訴你下一步該改什麼。
延伸學習:Stanford CS149 前六講
想沿著相同脈絡深入,可以從 Stanford CS149 官方課程播放清單開始,並搭配 課程講義目錄。
by Rain Chu | 10 月 5, 2026 | Agent, AI, OpenAI
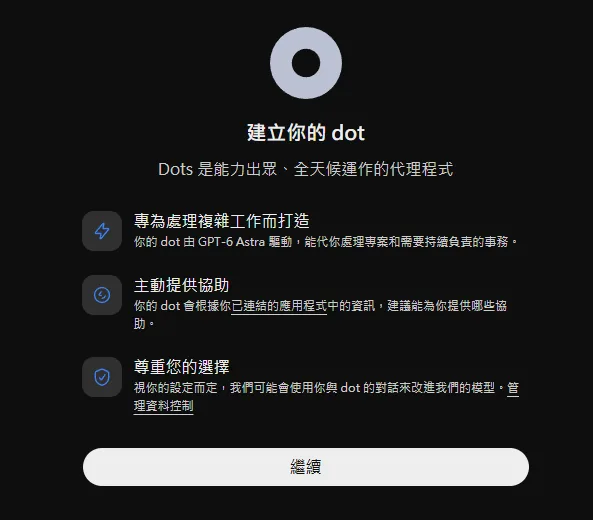
OpenAI Dots 是 ChatGPT 裡能持續追蹤工作、協調工具並交付成果的常駐 AI 代理,跟 hermes agent, openclaw 是一樣的 AI 工具,你可以用文字或語音交代目標,讓它在自己的雲端電腦上研究、整理文件、寫程式,再回來查看結果。
我會把 Dots 看成工作的協調入口。遊戲引擎、建模軟體與筆記工具本身並沒有消失,Dots 把它們接成一條可以持續修改的流程。這篇先整理建立方式與典型案例,再釐清方案、用量和電腦權限。
Dots 是什麼?讓同一個目標跨對話繼續推進
依 OpenAI 官方介紹,Dots 由 GPT-6 Astra 驅動,擁有獨立雲端電腦與瀏覽器,並透過外掛連接工作應用。
官方公布的超過 4,000 個應用,是生態系的涵蓋範圍,實際能用哪些工具仍取決於外掛、帳號、權限和執行環境。
任務與記憶文件說明,它可以分派背景工作並同步推進多個任務,你在同一段對話中補充需求或改變優先順序,Dots 再協調後續步驟,它是統籌工作的一層,不代表所有動作都由同一個對話中的模型直接執行。
若你已經用過 ChatGPT Work 與 Codex 的任務流程,可以把 Dots 理解成持續接收目標、追蹤進度與回收成果的入口,Work 和 Codex 仍負責各自任務中的執行,舊文章中的模型與方案資訊則要以目前官方文件為準。
怎麼建立第一個 Dot
先在 ChatGPT 桌面 App 或電腦網頁建立 Dot,依引導設定名稱與外觀,電子郵件、行事曆和檔案服務可以在設定時連接,也能先跳過,完整步驟可對照 官方入門指南。手機 App 的使用需等支援更新到位,目前不能在手機網頁建立或使用 Dot。
建立後,先交一件範圍小、容易確認結果的工作,例如整理指定筆記頁並回傳摘要。等它能讀到正確資料,再增加寫入或跨工具操作。名稱與動態頭像方便辨識,但實際能力仍要看它取得的資料與工具。
三種連接要分清楚
- 通訊管道:在 ChatGPT、Slack 或 Teams 聯絡同一個 Dot。
- 外掛與應用:提供特定服務的資料與操作能力。
- 本機電腦:讓任務使用該電腦上的檔案、程式與工具。
加入 Slack 並不等於同時連接 Gmail,也不等於允許它讀取你的電腦,依 電腦與應用指南,這些連接各自管理。雲端瀏覽器也有自己的登入狀態,不會自動沿用你個人 Chrome 的所有帳號。
六個工作情境:從說出需求到拿到成品
以下案例整理公開操作流程,並補上本文建議的驗收方法。它們展示的是個別任務的可行性,沒有建立大型專案成功率或長期無人值守的測試結論。
一、語音查論文
依 官方語音說明,可從 Dot 對話的電話按鈕開始通話,通話期間也能打字補充。結束通話後,已交付的工作仍可能繼續。目前不能把它當作已能主動打電話給你的助理。
二、把每日檢查存成定時任務
每日檢查專案倉庫,以及定時查看 OpenAI 是否發布新文章,是把追蹤工作保存成排程的兩種用法。設定成功只是第一步,之後是否準時執行、能否持續取得來源,以及結果是否符合條件,都需要另外確認。
接下來兩週,每個工作日上午九點,以 Asia/Taipei 時區檢查[指定來源]。整理新增或變更項目到[指定位置],沒有變更時保持安靜。遇到[需要決策的條件]才通知我。請確認保存的時間、來源與輸出位置,第一次執行後提供紀錄。
上面的指令是本文示例。排程要包含時區、期間、通知條件與交付位置。依 定時任務指南,連接 Slack 或其他來源不會自動建立監控,應請 Dot 確認已保存的工作,再到 Scheduled 檢查。
三、Blender 建 3D:模型檔和渲染圖一起交付
同一個 Dot 可以協調不同工具任務,讓需求繼續在背景執行。
模型驗收除了看渲染圖,也要打開原始檔,確認物件、材質、相機和燈光都可再修改。若要交給別人,還要檢查外部貼圖與依賴是否一同保存。漂亮圖片只能說明某個視角的效果,不能代替可編輯模型的檢查。
如果要延伸到動畫或產品視覺,可參考 Blender 與開發代理的視覺工作流程,先定義短樣本與代表畫面,再擴充整段作品。工具已經接上,仍需要清楚的設計與交付規格。
哪些方案能用?用量怎麼算
截至 2026 年 10 月 2 日,Dots 正逐步開放給符合地區條件的 Pro、Business Premium 與 Enterprise 使用者,Pro 的推出範圍排除歐洲經濟區、英國及瑞士,Enterprise 需要管理員啟用,符合資格也可能尚未輪到帳號,不能因為一時看不到入口就判定設定有問題。最新條件請查 方案與地區說明,目前不能把 Plus 當成已支援的方案。
第一個 Dot 包含在 Pro 或 Business Premium 方案內,深入工作仍有使用額度。
Dot 對話不計入 ChatGPT 用量,但它啟動或管理的 Work/Codex 任務會照常計入那些產品的限制,首月提高上限不代表永久無限,細節以帳號顯示與 官方用量說明為準。
這也影響值不值得升級的判斷。只偶爾需要一段程式碼,可以先看既有工具是否已足夠。
若你經常需要追蹤研究、跨應用更新、定期整理資料,再比較 Dots 能省下多少來回交代與驗收時間,會比只看一次展示更有用。
如何把任務交代到可以驗收
一個好任務至少要有來源、結果、限制和完成條件。下面是本文設計的起手式,可以替換方括號內容後使用。
請使用我已連接的[資料來源],完成[具體結果]。先確認你讀到的來源,再開始處理。輸出到[位置與格式],保留來源連結與修改紀錄。涉及發送、公開分享或覆蓋原始資料時,先給我確認。完成後提供成果位置與檢查結果,遇到缺少權限或資訊時說明缺少什麼。
這樣的描述方便驗收,也方便續做。若第一版錯了,指出具體段落、檔案或操作步驟,讓它修正同一件工作。單純說「做得更好」通常只會增加猜測。
雲端能繼續工作,本機仍需要連線
Dots 的雲端電腦可在你的裝置關機時持續處理雲端工作,需要你本機檔案或工具的任務,則必須先授權連接該電腦,並保持電腦上線與 ChatGPT App 開啟,目前一次只能連接一台個人電腦。
要查看雲端環境,可從 Dot 個人頁的 Computers 開啟電腦,開啟畫面後仍需選 Take over 才能接管,完成登入或確認步驟後再 Return control。
遇到網站額外驗證或雲端瀏覽器被阻擋,可能需要人工接手,不能承諾每個網站都能全程自動完成。
長期合作前,先理解記憶與權限
Dots 可以使用相關 ChatGPT 記憶,也會保存自己的工作脈絡。
這不等於它永遠保有所有歷史對話,更不等於每個被分派的任務都取得完整歷史。重要文件、決策和來源仍建議明確保存,若想把專案知識做成可維護的資料,可延伸看 Agent 共用知識庫的整理方式。
依 隱私與安全 FAQ,斷開外掛會停止後續存取,已進入 Dot 脈絡的資訊不會因此自動刪除,目前也不能逐條直接修改 Dot 的自有記憶。刪除 Dot 與管理 ChatGPT 記憶是不同操作,刪除前先保存需要的成果。
個人方案的對話與工作是否用於模型改進,依資料控制設定。Business、Enterprise 與 Edu 工作區預設不使用內容訓練。主動研究與筆記不直接拿來訓練,但資訊若被帶入符合條件的對話或任務,仍會依設定處理。
OpenAI 的安全設計包含隔離環境、私密登入與操作審查,主動研究本身使用唯讀工具,不能直接寄信、修改應用或控制電腦。已授權的任務若要採取後續動作,仍受權限與操作規則限制,把工作交給 Dots 後,重要結果一樣要檢查。
怎麼查看進度與停止工作
從個人頁的 Activity 查看進行中與委派任務,再到 Scheduled 檢查定時工作。
依 官方控制說明,暫停 Dot 主任務、停止委派任務和取消排程有不同效果,若要全面停止,必須分別檢查這些位置,關掉通話或暫停主對話不會自動取消所有後續工作。
我的建議:從一條能穩定交付的流程開始
第一次使用,我會先選「讀取指定資料、產出草稿、回傳來源」這種容易確認的工作。
確認資料與輸出都正確,再增加跨工具寫入、排程或程式開發。持續記錄完成率、修正次數與實際用量,才能知道它是否適合你的工作。
Dots 的價值在於持續協調和回收成果,短時間完成一個遊戲或模型值得參考,能否長期減少管理成本才是後續要驗證的事。
資料核對日期:2026 年 10 月 2 日。功能與案例依公開資料整理,本文未另外重跑相同測試。方案、地區與用量會更新,使用前請確認最新官方說明。
OpenAI Dots 常見問題
OpenAI Dots 是什麼?
Dots 是 ChatGPT 裡能持續追蹤目標的 AI 代理。它有自己的雲端電腦,可協調研究、文件、程式與其他工具工作,再回收成果。
ChatGPT Plus 可以使用 Dots 嗎?
截至 2026 年 10 月 2 日,官方列出的開放方案是符合條件的 Pro、Business Premium 與 Enterprise。Plus 尚未列為支援方案,實際資格也受地區、管理員設定與逐步推出影響。
Dots 會消耗 Codex 額度嗎?
Dot 對話不計入 ChatGPT 用量。它啟動或管理的 Work 與 Codex 任務,仍照常計入那些產品的用量限制,不能當成無限工作額度。
電腦關機後,Dots 還會工作嗎?
雲端電腦上的工作可以繼續。需要使用本機檔案或工具的任務,則要保持該電腦上線,並開啟已授權的 ChatGPT App。
結束通話或暫停 Dot,會取消所有排程嗎?
不會。結束通話不會自動取消已交付工作,暫停主對話也不等於停止所有委派任務與排程。請分別檢查 Activity 和 Scheduled。
by Rain Chu | 9 月 30, 2026 | AI, 程式開發
Security Guidance 是 Anthropic 提供的 Claude Code 安全審查外掛,會在 Claude 修改程式的過程中,自動提醒可能的漏洞,並把審查結果送回同一個工作階段處理,安裝後不必每次再打一段「請檢查安全性」,也不需要記住一個專門啟動它的 Skill 指令。
它適合用在 AI 協助開發網站、API、後台與自動化腳本的日常流程,尤其程式已經能跑,卻還沒確認使用者輸入、權限檢查或資料流向是否安全時,這類即時提醒可以讓問題更早被看見。
先釐清:Security Guidance 是 Skill、Hook,還是 Plugin?
正式分類是 Plugin,也就是外掛,Skill 通常是一份描述任務做法的指引,Hook 則是在特定事件發生時自動執行的程式,Security Guidance 把安全檢查程式包成外掛,透過 Hooks 接到 Claude Code 的工作流程。
所以,它的基本用法是「安裝並保持啟用,正常讓 Claude Code 工作」,目前提供的 外掛設定檔與目錄結構以 Hooks 為核心,沒有要求你建立 SKILL.md,也沒有名為 /security-guidance 的獨立操作指令。
版本提醒:截至 2026 年 9 月 28 日,官方市集頁仍以較早的寫入前提醒介紹產品,但本文核對的 GitHub 版本為 2.0.0,實際 Hook 設定已採用寫入後檢查及背景審查。下文依這份原始碼與現行使用文件說明,安裝後也應確認自己的外掛版本。
它如何運作?三個時機,三種檢查深度
第一層:檔案修改後,快速找出危險寫法
當 Claude 透過編輯或寫入工具修改檔案,外掛會比對特定字串、正規表示式與檔案路徑,例如動態執行字串的 eval()、把輸入交給 shell 的 child_process.exec()、直接寫入 HTML,以及不安全的反序列化。
這一層不需要呼叫模型,同一個工作階段裡,同一檔案的同一條規則通常只提醒一次,避免連續修改時反覆洗版,它抓到的是「需要留意的寫法」,未必代表那一行已經構成可利用的漏洞,後續仍要看輸入來源與上下文,規則可以在 內建模式清單中查到。
第二層:一個回合結束後,檢查這回合的差異
你提出一次需求,Claude 修改程式並回覆,構成一個工作回合,外掛會用 Git 狀態整理這回合產生的差異,交給另一個以安全為目標的模型審查,這能補上單純字串比對看不出的問題,例如某個查詢是否漏掉使用者權限限制。
目前 Hook 設定使用背景審查,回覆可能先完成,稍後才把發現送回 Claude,讓它繼續處理,因此不能把「已看到完成回覆」理解成安全檢查已全部結束,依 官方回合審查說明,這一層也有檔案數與連續觸發次數限制,並不是無限檢查整個專案。
第三層:Claude 提交或推送時,追查相關程式
當 Claude 透過 Bash 工具執行符合條件的 git commit 或 git push,外掛可啟動更深入的審查,這個 reviewer 能用 Read、Grep、Glob 查看呼叫端、驗證函式與相關檔案,判斷跨檔案的資料流是否存在問題。
這裡的觸發範圍是 Claude Code 內的工具操作,不是替電腦安裝全域 Git 防線,你從自己的終端機執行 Git,或使用工作階段裡的 ! shell escape,不應假定也會受到這一層審查。
目前這三層都不會阻擋寫入或提交,發現問題後,仍要由 Claude 或開發者修正。如果團隊要求檢查未通過就不能合併,應另外使用 CI 必要檢查與分支保護,不能把背景提醒當成硬性關卡,這也是 設計 AI 工作環境與驗證流程時需要先分清楚的責任。
Security Guidance 安裝方式
本文以本機終端機版 Claude Code 為主,先準備可正常使用的 Claude Code、Git 專案,以及 Python 3.10 以上與可用的 pip。這個 第一次使用時,外掛可能在 ~/.claude/security/ 下準備專用 Python 環境並安裝 Claude Agent SDK,需要網路與套件安裝能力。企業電腦若限制下載,應先核對初始化結果。
在 Claude Code 對話輸入列執行:
/plugin install security-guidance@claude-plugins-official
這是 Claude Code 裡的指令,不是直接貼到一般終端機執行的 shell 指令。
安裝畫面若詢問範圍,User 適用於這台電腦上自己的各個專案,Project 用來分享專案設定,Local 則只套用到自己在目前專案的使用。
第一次體驗,可以選 User,或用 Local 限定在測試專案。
只有在系統明確回報找不到官方 marketplace 時,才先補上:
/plugin marketplace add anthropics/claude-plugins-official
接著重試安裝。若安裝摘要提示需要啟用更新,依畫面執行 /reload-plugins,再透過 /plugin 檢查已安裝與啟用狀態。安裝範圍及重新載入方式可對照 官方外掛安裝文件。
若你使用 Claude 桌面版或 VS Code 擴充套件,外掛管理入口可能不同。
安裝後怎麼用?照常開發,再處理提醒
不必先提出安全審查要求才能觸發。你可以像平常一樣請 Claude 新增功能、修改測試或整理程式,
外掛會依事件自動工作。比較有用的工作要求,是同時讓 Claude 回報做了什麼驗證,以及安全提醒最後如何處理,例如:
請替客服後台新增留言預覽功能。
使用者輸入只需顯示純文字,不需要 HTML 格式。
完成後執行相關測試,並說明 Security Guidance 若提出提醒,你如何修正或確認。
這段提示不是外掛的專用語法,而是本文的工作要求示例。它讓功能需求與驗收方式更清楚,無須故意要求 Claude 寫出危險程式來測試外掛。
範例一:顯示留言時,避開不必要的 HTML 注入
假設功能只是顯示訪客留下的文字,卻把內容直接指定給 innerHTML,外掛的模式規則可能提出 XSS 提醒。問題不在「有 HTML 就一定錯」,而是未受信任的內容會被瀏覽器當作標記處理。
若只需要純文字,較直接的實作是:
previewElement.textContent = commentText
React 中也可以直接把文字放進 JSX 的文字位置,不必為了顯示普通留言使用 dangerouslySetInnerHTML。若功能確實需要富文字,才另外定義允許的標記與清理流程。這是在 使用 Claude Code 製作網站時,很常遇到的需求界線。
範例二:呼叫外部工具時,把參數與 shell 字串分開
假設系統要呼叫一個已知的檔案分析工具,把檔名拼進 shell 指令字串,可能讓特殊字元被當成指令語法。Security Guidance 會對 child_process.exec 這類寫法提醒檢查輸入。
可以考慮用 execFile() 直接呼叫固定程式,將檔名放進參數陣列。例如以下概念片段,前提是程式路徑固定,且已先驗證檔案確實位於允許的目錄:
import { execFile } from 'node:child_process'

execFile('/opt/myapp/bin/file-inspector', [validatedFilePath], callback)
這裡的工具路徑與變數都是示意,不能直接照貼就當成完整程式。參數陣列能避開 shell 字串解析,但目標工具本身怎麼解讀參數、檔案存取範圍與權限,仍然要檢查。外掛的提醒應該促使你看完整條資料流。
範例三:修改 GitHub Actions,先看資料如何進入腳本
編輯 .github/workflows/ 裡的 YAML 檔案時,外掛可依路徑給出提醒。這不表示整份 workflow 已被判定有漏洞,而是這類檔案可能使用儲存庫權限、執行 shell 或接觸機密,值得額外檢查。
例如只想印出 Issue 標題,可以先把事件資料放到環境變數,再於 shell 使用帶引號的變數,而不是把外部文字直接插進腳本原始碼:
env:
  ISSUE_TITLE: ${{ github.event.issue.title }}
run: printf '%s\n' "$ISSUE_TITLE"
這只是 workflow 中的一個步驟片段,用來示範安全處理文字,不代表整份流程已經安全。
還要看 job 權限、第三方 action、事件來源與 secrets 是否使用得當。若尚不熟悉分支與提交,可以先讀 AI 開發時的 GitHub 版本管理,把修改留在可檢查、可回復的範圍。
加入自己的專案規則,讓提醒更貼近實際需求
用 Markdown 說明團隊規範
在專案建立 .claude/claude-security-guidance.md,寫下模型不會自行知道的要求,以下是本文設計的多租戶後台示例,可依自己的函式名稱與資料表調整:
# 本專案安全規則

- 所有 /admin 路由必須先通過 requireAdmin,再讀取業務資料。
- 查詢租戶資料時,tenant_id 必須來自已驗證的工作階段,不可信任請求直接提供的值。
- 日誌不得包含存取權杖、密碼或完整的付款資料。
- 訪客留言預設以純文字顯示,富文字必須使用專案核准的清理函式。
規則應寫出「哪裡需要什麼條件」,比單純要求「遵守最佳安全實務」更容易被檢查,不要把 API key、真實權杖或正式客戶資料放進檔案,因為內容可能被加入模型審查的提示。
也可以把個人通用規則放在 ~/.claude/claude-security-guidance.md,或用 .claude/claude-security-guidance.local.md 保存不打算共用的專案設定,官方目前對不同審查路徑載入規則的說明仍有版本差異,因此至少要確認回合差異審查有載入,不能只因為檔案存在就推定所有路徑都生效。
用 JSON 加入可重現的文字提醒
如果某個舊函式不應再出現在新程式裡,可以建立 .claude/security-patterns.json。以下示例看到 legacyUnsafeRenderer( 就提醒改用專案的新介面:
{
  "patterns": [
    {
      "rule_name": "legacy_renderer",
      "substrings": [
        "legacyUnsafeRenderer("
      ],
      "paths": [
        "**/src/**"
      ],
      "reminder": "這個舊介面不應用於新程式,請改用專案的安全文字顯示函式,並確認輸入來源。"
    }
  ]
}
這裡的函式名稱是示例,不是內建 API。paths 用來限制檔案範圍,比對的是完整路徑,因此專案相對位置前面使用 **/。JSON 不需要額外的 YAML 解析套件,比第一次就加入正規表示式更容易確認設定是否正確。
這類自訂規則是補充提醒,並不會刪除內建規則,也不是程式碼執行權限設定。其格式與載入行為可對照 自訂規則實作。
怎麼確認真的有啟用?用無害的測試標記
最容易誤會的是「沒有出現警告,所以一切正常」。沒有警告,也可能是沒有符合模式、這個工作階段已提醒過、背景審查還沒結束,或環境缺少必要元件。
想確認自訂模式有載入,可以在可丟棄的測試分支中,讓 Claude 用編輯工具新增 src/security-guidance-demo.js,內容只放下面這行註解,然後觀察是否收到 legacy_renderer 的提醒:
// 示範字串 legacyUnsafeRenderer(,僅供規則比對,不執行任何函式
字串規則可能連註解也會匹配,正好可以用來測試,不必真的執行危險程式。
需要排查時,先看 ~/.claude/security/log.txt 的活動與錯誤,再確認專案有 Git、Python 與 SDK 初始化成功,以及所選模型與服務供應商可用。若沒有 Git 儲存庫,仍可能有逐次編輯提醒,但以 Git 差異為基礎的審查無法照常工作。
費用與資料流向:不要把它當成完全離線檢查
模式比對本身不呼叫模型,回合差異與提交審查則會額外使用模型額度,深入審查可能讀取更多檔案、進行多輪判斷,因此不能把外掛安裝後的使用成本視為零。
核對版本的預設審查模型為 Claude Opus 4.7。SECURITY_REVIEW_MODEL 用於差異審查,SG_AGENTIC_MODEL 用於 agentic 審查。若改用 Bedrock、Vertex 或其他端點,模型識別名稱應依供應商設定,不宜直接複製別人的環境變數。
執行模型審查時,變更路徑、差異與相關程式內容會傳到設定的模型端點,深入審查還可能讀取其他相關檔案
。使用公司程式碼時,應沿用組織允許的端點與資料政策。這是此工具的運作條件,不能把「Hook 在本機執行」解讀成程式碼永遠不會離開本機。
它和 /security-review、Claude Security 有什麼不同?
- Security Guidance:跟著 Claude Code 的開發過程自動提醒與審查,適合日常修改。
- /security-review:由使用者主動提出的一次性安全檢查,與自動 Hook 的觸發方式不同。
- Claude Security 外掛:提供更深入的程式庫或差異掃描與修補工作流,是另一個工具,不能只因名稱都有 Security 就視為同一套功能。
如果需求是檢查既有的整個網站,或確認某個版本能否上線,還要搭配人工審查、依賴套件掃描、測試與 CI。Security Guidance 能把部分問題提前到開發當下,但「沒提醒」不是安全認證。
Security Guidance 常見問題
只要把 SKILL.md 放進專案就能用嗎?
不能等同。Security Guidance 是包含 Hook 設定與程式的外掛,應透過官方外掛流程安裝,單獨放一份 Skill 指引不會啟動它的檢查。
它會阻止有漏洞的程式被提交嗎?
目前三層都是提醒或背景審查,不會阻擋寫入與提交。需要強制把關時,應另外設定 CI 必要檢查與分支保護。
所有安全提醒都必須照單全收嗎?
先核對輸入是否可被外部控制、既有驗證是否有效,以及實際影響。若確定是誤報,應保留具體理由,不能只用一句「這是安全的」取代證據。
從小型專案開始,把提醒接到修正與驗證
第一次使用,先選一個可回復修改的 Git 專案,確認外掛啟用,再讓 Claude 完成小功能。看到提醒後檢查原因、修正程式並跑相關測試,最後再決定是否提交。習慣這個流程後,再加入團隊規則,效果會比一開始塞進大量抽象要求更容易評估。
Security Guidance 的實際價值,在於把安全問題放回寫程式的當下,讓你更早知道哪裡需要檢查。它能協助縮短發現問題到修正的距離,最後的驗收仍要回到程式行為與測試結果。
近期留言