by Rain Chu | 9 月 25, 2026 | AI, Stable Diffusion, 圖型處理, 影片製作, 繪圖
Stable Diffusion 的基本做法,是從隨機雜訊開始,在文字條件引導下反覆更新潛在表示,最後解碼成圖片。
輸入「一隻卡通柴犬」,模型便逐步生成符合描述的輪廓、色彩與細節。雜訊裡並沒有藏著一張等待被找回的柴犬照片。
理解這個流程,可以分別看 UNet 怎麼學習預測雜訊、CLIP 怎麼處理文字,以及 VAE 為何能減少運算負擔。負
向提示詞與 CFG,則是在生成過程中調整方向的工具。
本文以經典 SD 1.x 的架構為主,不同版本會更換文字編碼器、預測目標或去噪網路,不能把同一套零件規格套到所有模型。
例如 Stable Diffusion 3 採用 Transformer 架構與 rectified flow,若還沒接觸過這類工具,可先看站內早期的 Stable Diffusion 繪圖示例,其中舊服務的額度與介面以當前官方資訊為準。
UNet 怎麼學畫圖?先學習估計加進去的雜訊
把一張柴犬照片加入高斯雜訊,就能得到模糊、顆粒很多的版本。訓練程式知道原始資料、抽到的雜訊與時間步,因此有明確的答案可以用來評估模型。
- 先用 VAE 把訓練圖片編碼成潛在表示。
- 抽取時間步與高斯雜訊,按照排程把雜訊加進潛在表示。
- 把帶噪潛在表示、時間步與文字條件送進 UNet。
- 比較 UNet 預測的雜訊與實際加入的雜訊,更新模型參數。
這裡採用經典的雜訊預測訓練目標,DDPM 論文 說明了前向加噪與反向生成的關係,而 CompVis 原始實作 將去噪工作放進潛在空間,並以文字條件引導。把訓練過程說成「看帶噪圖片,猜出雜訊」容易理解,但實際送進經典 SD UNet 的資料並非 RGB 像素。
從雜訊生成柴犬,為什麼需要反覆更新?
文字生圖時沒有原圖可還原,起點是一份隨機潛在雜訊,UNet 先估計目前狀態中的雜訊,再由 scheduler/取樣器依排程計算下一個狀態,重複後才得到可以解碼的結果。
所以,UNet 的單次輸出不應直接理解成「完成降噪的新圖片」。
預測與更新是兩個步驟。Hugging Face 的流程解說 將 UNet、取樣器與最後的 VAE 解碼分開呈現,有助於看懂 ComfyUI 的節點分工。
示範若把中途結果依序解碼,可能看到柴犬輪廓逐漸清楚。這不代表每一輪都必須經過 VAE,也不代表所有模型都固定需要相同的步數。
CLIP 的工作:把提示詞轉成可用的文字特徵
「卡通柴犬」和「動畫風格的小黃狗」不是同一句話,卻可能描述相近的畫面。
文字編碼器把提示詞轉成數值特徵,讓去噪網路能利用描述中的資訊,相近語意可能得到相關表示,但不同寫法不保證生成同一張圖片。
CLIP 原始研究 使用圖文配對做對比式學習,讓匹配的影像與文字表示更相近,並區分不匹配的組合,拿柴犬照片與汽車照片,分別和「a Shiba Inu」比較,就是直觀的教學案例。這種相似度是表示之間的相對關係,不能直接當成辨識正確率。
在經典文字生圖流程中,主要使用 CLIP 的文字編碼器,透過 cross-attention 把條件交給 UNet,CLIP 的影像編碼器並不是每個去噪步驟都要使用的零件。這也不表示所有圖像生成應用都不需要影像編碼器,加入參考圖的其他管線可能另有設計。
VAE 的工作:在較小的表示中生成,再還原成圖片
VAE 包含 encoder 與 decoder。前者把圖片編碼成潛在表示,後者把潛在表示重建成可見圖片。訓練與圖生圖會需要影像編碼,從純雜訊開始的標準文字生圖則主要在最後使用解碼器。
Latent Diffusion 原始論文 的關鍵,是把反覆進行的擴散運算移到較低維度的表示中,兼顧運算成本與視覺細節。這是經過學習的表示,和把照片縮成小張的縮圖不同。
1024 × 1024 的影像,為什麼會出現 1/48 和 1/12?
以寬、高各縮小 8 倍、潛在通道數為 4 的經典 VAE 為例,可做以下尺寸計算。這只說明表示大小,不表示 SD 1.x 原生訓練解析度就是 1024 × 1024。
| 表示方式 | 寬 × 高 × 通道 | 數值個數 |
|---|
| RGB 影像 | 1024 × 1024 × 3 | 3,145,728 |
| VAE 潛在表示 | 128 × 128 × 4 | 65,536 |
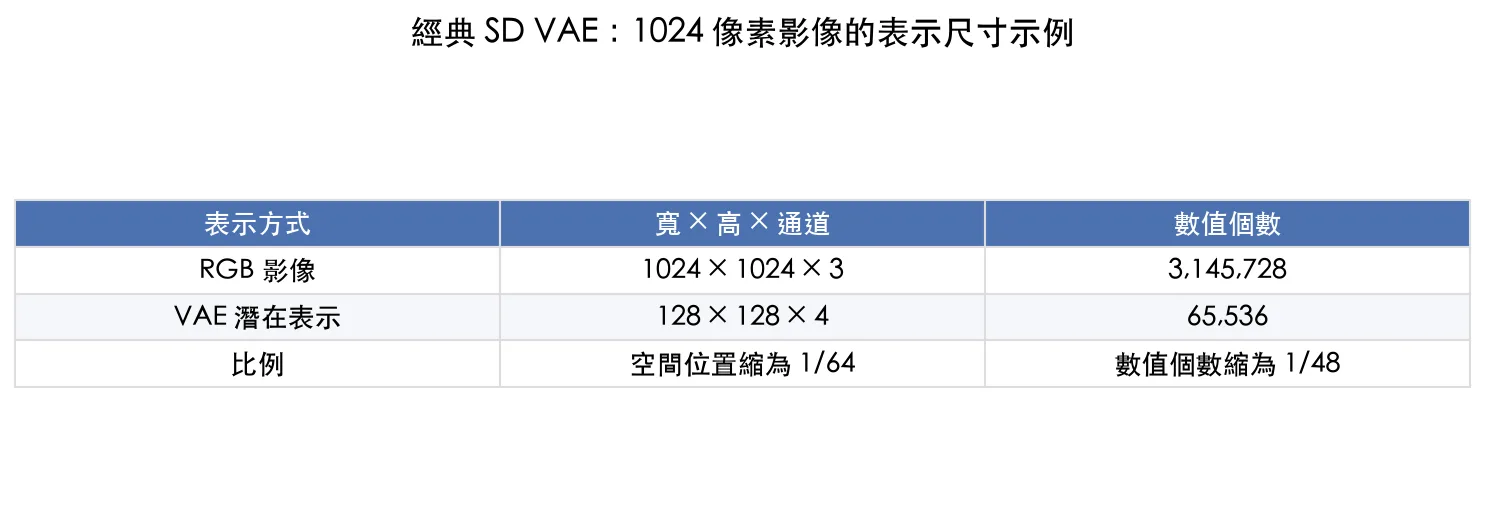 依經典 VAE 的尺寸規則計算,並非生成速度或顯存用量的實測比較。
只比數值個數,比例是 1/48。如果原始 RGB 每個數值用 1 byte,而潛在表示使用每個數值 4 bytes 的 FP32,則是 3 MiB 對 256 KiB,資料儲存量才是 1/12,兩個比例用了不同的比較基準,不能混為一談。實際顯存還包括模型權重、中間運算與其他元件,不會直接照這個比例下降。
反覆重建與旋轉潛在表示,能看出什麼?
把同一張圖重複編碼、解碼,可以觀察有損重建造成的細節變化。但單張示例不能證明每次都會以相同程度劣化,也不能把 VAE 訓練簡化成只有一項逐像素比對。VAE 的原始方法 還包含對潛在分布的約束,實際影像自編碼器也可能使用感知與對抗式目標。
負向提示詞怎麼用?以不戴墨鏡的柴犬為例
想要一隻不戴墨鏡的柴犬,可以先把正向提示詞寫成 a Shiba Inu, clear eyes,負向提示詞填 sunglasses。這是方便測試的起點,不是保證成功的固定配方。
把「不戴墨鏡」整句放在正向提示詞裡,可能無法穩定排除墨鏡。較準確的說法是,這類模型對否定與複雜語意關係的遵循有限,不能推論 CLIP 永遠只懂肯定句,Diffusers 的負向提示詞說明 把它定位為讓生成方向遠離不想要的內容或特徵。
CFG 調整的是兩份預測之間的差異
在支援負向條件的常見 CFG 實作中,模型會估計正向條件與負向條件下的雜訊預測,再依下式組合,沒有填負向詞時,通常使用空文字條件作為基準。
引導後預測 = 負向預測 + CFG ×(正向預測 − 負向預測)
這裡相減的是雜訊預測張量,不是把一張「戴墨鏡的狗」從圖片上剪掉,也不是對文字做算術,基礎概念來自 Classifier-Free Guidance 研究,正負條件的組合方式可對照 Diffusers 管線實作。
CFG 提高會加強兩份預測的差異,但數值過高可能出現失真或不自然的色彩。若負向詞寫得太廣,也可能干擾想保留的元素。先用少量具體詞彙測試,比整串貼上負向詞更容易判斷哪個設定有效。
把完整流程接起來,就能看懂主要設定
- 提示詞先經 tokenizer 與文字編碼器,形成文字條件。
- seed 參與決定初始隨機雜訊,作為生成的起點。
- UNet 接收潛在表示、時間步及文字條件,估計雜訊。
- 依需要使用 CFG,取樣器再更新潛在表示,反覆進行到設定步數。
- 最後以 VAE decoder 轉成 RGB 圖片。
想測提示詞效果,先固定模型、seed、尺寸、取樣器與步數,每次只改一個條件,相同 seed 有助於比較,但跨軟體版本、硬體或不同管線,不保證逐像素重現,步數也不是越高越好,應依所用模型與取樣器的設計調整。
下載模型時,還要分清主模型、文字嵌入與附加權重,站內的 Stable Diffusion 模型類型整理 可用來辨認常見檔案類型,實際相容性仍以各模型說明為準。
LoRA 與蒸餾,和去噪有什麼不同?
LoRA 是調整模型參數的方法。LoRA 論文 以低秩更新減少需要訓練的參數。用在擴散模型時,它可能調整去噪網路或其他部分的行為,但 LoRA 本身不等於一次去噪,也不是另一種取樣器。想觀察權重怎麼影響風格,可延伸看 LoRA 權重與分層設定,留意文中外掛與模型版本的適用範圍。
蒸餾則是利用教師模型的訊號訓練學生。在圖像生成裡,目標之一是讓學生以較少步數完成生成,例如 Adversarial Diffusion Distillation。這需要額外訓練,不能靠把一般模型的步數直接調低就獲得同樣效果,也不一定讓參數量變少。站內 模型蒸餾原理整理 說明了更廣泛的教師與學生關係,圖像模型的具體訓練目標仍要另外看。
Stable Diffusion 原理常見問題
Stable Diffusion 是從雜訊中找回原本的圖片嗎?
標準文字生圖從隨機雜訊開始,沒有一張特定原圖等待還原。模型依文字條件與訓練中學到的規律,逐步生成潛在表示,再解碼成圖片。
UNet、CLIP、VAE 分別做什麼?
在經典 SD 架構中,UNet 預測雜訊,CLIP 的文字編碼器提供文字條件,VAE 負責圖片與潛在表示之間的轉換。取樣器另行決定每一步怎麼更新。
負向提示詞可以保證排除指定物件嗎?
不能保證。它會影響生成方向,但效果取決於模型、正負條件、CFG 與其他設定。應使用具體詞彙逐項測試,而非把它當成物件刪除指令。
VAE 會讓圖片變模糊嗎?
VAE 重建有損,細節與色彩可能改變。是否明顯取決於模型與圖片,反覆編碼解碼也可能累積差異。它不是一般圖片縮放或完全無損壓縮。
生成步數越多,圖片一定越好嗎?
不一定。超過適合的範圍,增加步數可能只有額外耗時。蒸餾模型也可能針對少步數設計,應使用該模型建議的取樣方式與設定。
從一個可比較的小實驗開始
用同一個模型生成柴犬,固定其他設定,依序比較正向描述、負向詞與 CFG 的變化。知道每個元件在做什麼之後,調整設定就能帶著問題進行,不必只靠反覆抽圖。
by Rain Chu | 7 月 12, 2026 | AI, 圖型處理
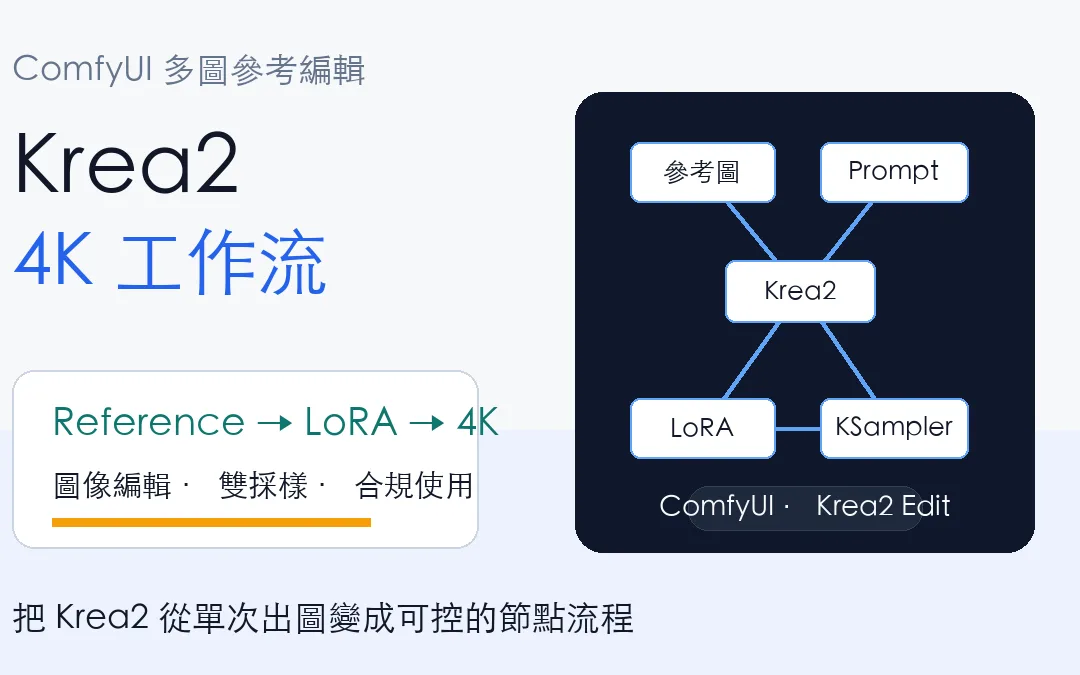
Krea2 開始變得有趣,不只是因為它能做漂亮的圖,而是因為它正在被接進 ComfyUI 的節點工作流。當圖像編輯、多圖參考、LoRA、KSampler 和 4K 出圖放在同一張節點圖裡,Krea2 就不只是單次生成工具,而是可以被拆解、調參、複用的內容生產流程。
我會把這次重點整理成三件事。
第一,Krea2 edit LoRA 的 ComfyUI 節點怎麼理解。
第二,私模與社群模型要怎麼分開看。
第三,4K 工作流不是單純放大,而是先控制訓練尺寸,再用 latent 放大與第二次採樣補細節。
Krea2 圖像編輯的真正重點
Krea2 圖像編輯最吸引人的地方,是它把「參考圖」和「提示詞」放到同一個生成條件裡,這比單純丟一張圖做 img2img 更細,因為參考圖可以被視覺編碼器理解,再和 prompt 一起影響模型輸出。
ComfyUI-Krea2-Ostris-Edit 這個節點包就是關鍵之一,它的 README 說明,這套節點是為了執行用 AI Toolkit 訓練的 Krea 2 edit LoRA,安裝方式是放到 ComfyUI 的 `custom_nodes` 目錄,重新啟動後節點會出現在 `ostris/krea2` 類別。
它不是模型本體,而是讓 ComfyUI 能正確吃進 Krea2 edit LoRA 的橋,這點很重要,因為很多人看到節點就以為模型已經包含在裡面,實際上模型、LoRA、節點和工作流是四個不同層次。
多圖參考不是把圖片塞進去就好
Krea2 Ostris Edit 的文字編碼節點可以接受 prompt,也可以接受 `image1` 到 `image3` 這類參考圖。GitHub 說明裡提到,參考圖會透過 Krea2 的 Qwen3-VL text encoder 編碼,並用 Krea 的 conditioning template 加入 `Picture N:` 這類視覺 placeholder。
換句話說,多圖參考的重點不是「圖片有沒有接上節點」,而是參考圖有沒有被正確轉成 conditioning。若接了 VAE,參考圖也會被 VAE 編碼成 reference latents,再交給 model patch 節點使用。這也是為什麼工作流裡會看到 Text Encode、Model Patch、VAE、KSampler 連在一起。
- Text Encode Krea 2 Ostris Edit 負責把 prompt 與參考圖一起編碼
- Krea 2 Ostris Edit Model Patch 讓模型真的消化 reference latents
- 如果文字編碼 checkpoint 沒有 Qwen3-VL vision weights,參考圖就無法被正確編碼
- 如果 conditioning 沒有 reference latents,patch 後的模型會像原本的 Krea2 一樣運作
這也是我會把它歸類為進階 ComfyUI 工作流,而不是單純的模型推薦,若你對節點式 AI 生產平台還不熟,可以先看我整理過的 RunningHub 與 ComfyUI 工作流平台,會比較容易理解為什麼同一個模型放進工作流後,價值會完全不一樣。
私模、社群模型與合規使用要分清楚
這次素材裡有一個很值得注意的提醒:老白訓練的 Krea2 亞洲女性私模不是開源模型,它是投入大量訓練步數與算力成本做出來的商業模型,這類模型能不能商用、能不能轉售、能不能放到平台上提供他人使用,都要看授權條款。
所以我會把工作流和模型分成兩條線來看。工作流可以學,節點可以研究,參數邏輯也值得整理,但私模本身不是「看到連結就能自由拿來用」的資源。若只是想理解 Krea2 工作流,可以先從社群模型、公開節點和 RunningHub 上的示範流程開始。
另外,Krea2 的圖像編輯能力很容易碰到肖像、換裝、仿真與身份一致性問題。越是接近真人或商業素材,越需要確認素材來源、肖像權、授權和平台規範。技術可以做到,不代表每個場景都適合做。
4K 工作流的核心不是暴力放大
這套 4K 思路有一個實用點:先用接近訓練尺寸的長邊出圖,再在 latent 空間放大,最後用第二次採樣補細節。以這次整理的參數來看,長邊 1536 是一個被反覆提到的基準,因為後面還要做倍率放大。
第一個 KSampler 會用比較高的 denoise,例如 `denoise 1`,步數可以抓 8 到 10 步。這一步不是最後成品,而是建立整體構圖與質感。接著在 latent 空間放大,例如 2.5 倍,再進入第二個 KSampler。第二次採樣通常要更保守,避免把第一輪已經穩定的畫面重新打亂。
| 階段 | 用途 | 重點 |
|---|
| 第一輪採樣 | 建立構圖與主要質感 | 可用較高 denoise,步數約 8 到 10 |
| latent 放大 | 把畫面放到更高解析度 | 倍率要配合原始長邊與顯存 |
| 第二輪採樣 | 補細節與穩定質感 | 採樣器與 denoise 要保守,避免重新洗圖 |
這個思路和傳統 Stable Diffusion 的高解析修復很像,但放到 Krea2 和 LoRA 組合後,更需要注意模型本身的訓練尺寸與美學方向。你如果常玩本機模型部署,也可以對照我之前寫的 ComfyUI 本機部署 AI 繪圖模型,兩者都在處理「模型能力」和「工作流控制」之間的平衡。
LoRA 權重不是越高越好
這次工作流裡多次出現 LoRA 疊加。單獨使用某個風格 LoRA 時,權重可以先從 0.8 附近測。若兩個 LoRA 一起用,總權重抓在 0.9 到 1.0 比較容易控制,例如一個 0.5,另一個 0.4。
這不是死規則,而是避免模型過度偏移的起點。Krea2 本身的細節與光影已經很強,LoRA 的目的應該是加強風格或概念,而不是把底模原本的結構感整個蓋掉。若出現臉部變形、姿勢不穩、材質變髒,第一個要檢查的通常不是 prompt,而是 LoRA 權重和第二輪採樣是否太激進。
Krea2 工作流適合誰
我覺得 Krea2 這類流程比較適合三種人。第一種是已經熟悉 ComfyUI,想要把參考圖、LoRA、放大與後處理串成固定模板的人。第二種是需要穩定產出社群圖像、封面、人像素材或商品視覺的人。第三種是想研究圖像編輯模型訓練方向的人,因為 Krea2 edit LoRA 的節點設計能看出參考圖 conditioning 的實作脈絡。
如果只是偶爾修圖,可能用線上工具會比較快。如果要長期做工作流、批量產圖、測 LoRA 權重,ComfyUI 仍然比較有彈性。也可以用 AIX Studio 這類 AI 繪圖平台 做比較,看看自己需要的是封裝好的產品,還是可拆解的節點流程。
實作前可以先檢查這幾件事
- 確認 Krea2 模型與 LoRA 來源,尤其是授權和商用限制
- 安裝 ComfyUI-Krea2-Ostris-Edit 節點後再重啟 ComfyUI
- 確認 text encoder checkpoint 含有 Qwen3-VL vision weights
- 多圖參考要檢查 VAE reference latent 是否真的接進 conditioning
- 第一輪採樣先穩構圖,第二輪採樣再補細節
- LoRA 疊加時總權重不要一開始就拉太高
- 真人、換裝、仿真、商業圖像要先確認合規與授權
若你想直接在線上試工作流,可以看 RunningHub 的 Krea2 Realism Engineer v2 工作流頁面。若人在海外,RunningHub 也有海外站。這類平台的好處是不用先處理本地顯卡和節點衝突,但缺點是工作流可控性和資料隱私要自己評估。
結論
Krea2 圖像編輯真正值得看的,不只是單張效果圖,而是它如何被拆成 ComfyUI 裡的節點、conditioning、model patch、LoRA 權重和雙採樣流程。這讓它從「好看的模型」變成「可調整的生產系統」。
我的建議是先從公開節點和可取得的工作流開始,把參考圖進 conditioning 的路徑搞懂,再去看私模或商業模型是否值得投入。尤其是人像與商業素材,合規使用要放在技術嘗試前面。能生成不是終點,能穩定、可控、可授權地生成,才是 Krea2 工作流真正能落地的地方。
延伸資源
by Rain Chu | 6 月 6, 2026 | AI, 圖型處理
2026 年最受矚目的 AI 繪圖模型之一,莫過於 Ideogram 團隊正式釋出的:
Ideogram 4
這是 Ideogram 首次公開模型權重(Open Weight),也是目前開源陣營中,在:
- 文字生成(Text Rendering)
- 海報設計
- 品牌廣告
- 排版控制
- JSON 結構化提示詞
官方資料顯示,Ideogram 4 採用 9.3B 參數的單流 Diffusion Transformer(DiT)架構,並支援原生 2K 圖像生成。
本篇將帶你使用 ComfyUI,在本機部署 Ideogram 4。
系統需求
官方模型共有兩個版本:
| 版本 | 量化 |
|---|
| Ideogram 4 FP8 | 品質最佳 |
| Ideogram 4 NF4 | VRAM需求較低 |
目前 ComfyUI 官方整合版本主要使用:
其中 FP8 畫質最佳。
第一步:下載模型
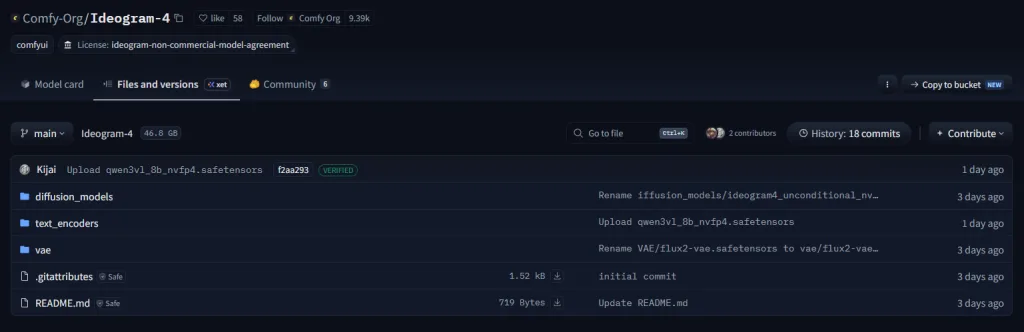
ComfyUI 專用模型
官方:
Comfy-Org Ideogram-4
原始模型:
Ideogram 4 FP8 官方模型
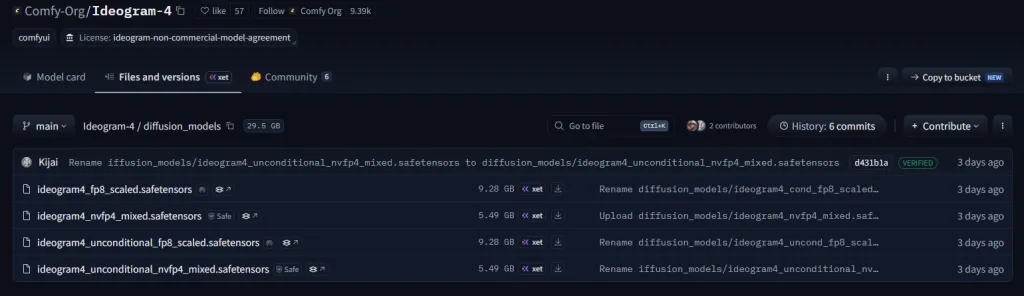
第二步:放置模型檔案
依照官方說明建立目錄。
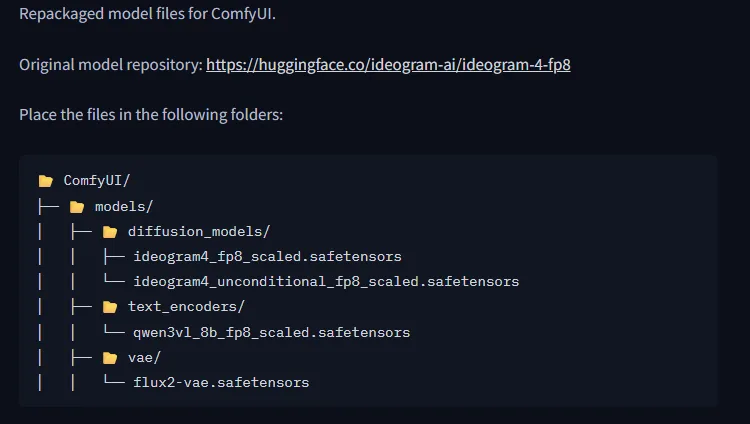
ComfyUI
│
├─ models
│  ├─ diffusion_models
│  │  ├─ ideogram4_fp8_scaled.safetensors
│  │  └─ ideogram4_unconditional_fp8_scaled.safetensors
│  │
│  ├─ text_encoders
│  │  └─ qwen3vl_8b_fp8_scaled.safetensors
│  │
│  └─ vae
│      └─ flux2-vae.safetensors
第三步:了解每個模型用途
ideogram4_fp8_scaled
主模型
負責:
ideogram4_unconditional_fp8_scaled
CFG 引導模型
負責:
- 提升細節
- 強化 Prompt Follow
- 改善品質
官方建議兩個模型一起使用。若只載入主模型雖可運作,但畫質會下降。
qwen3vl_8b_fp8_scaled
文字編碼器
負責:
- Prompt 理解
- JSON 理解
- 空間推理
- 海報版面配置
flux2-vae
VAE 解碼器
負責將 Latent 轉換成圖片。
第四步:更新 ComfyUI
Ideogram 4 需要最新版本的 ComfyUI。
更新方式:
或:
官方於 Day-0 即已原生支援 Ideogram 4。
第五步:載入官方 Workflow
ComfyUI 官方已提供範例工作流。
建議直接從:
Comfy Blog
下載 Workflow。
基礎工作流架構
Prompt
    ↓

Qwen3-VL Encoder
    ↓

Ideogram 4
    ↓

Sampler
    ↓

Flux VAE Decode
    ↓

Save Image
第六步:第一張圖片
測試 Prompt:
A futuristic cyberpunk city at night,
neon signs in Chinese,
cinematic lighting,
ultra detailed,
high contrast,
8k photography
生成尺寸:
推理模式:
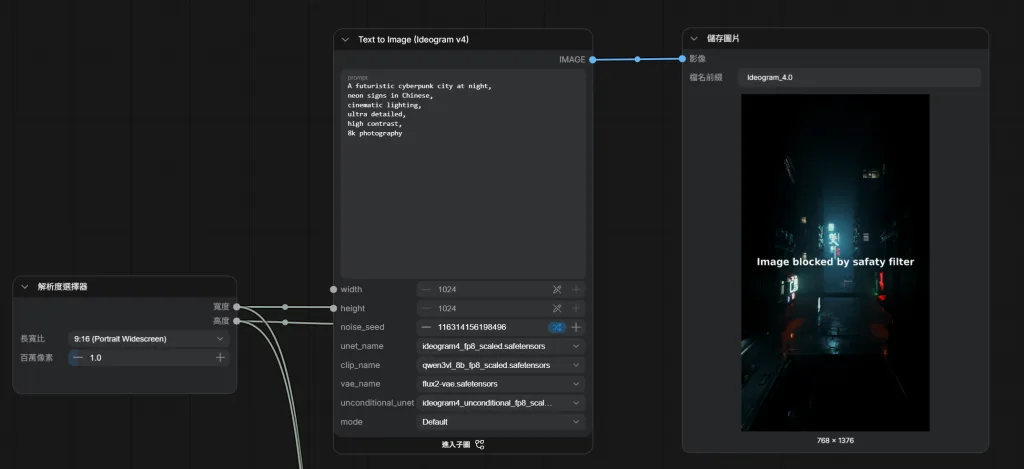
第七步:體驗 JSON Prompt
Ideogram 4 最大特色就是:
Structured JSON Prompt
官方模型訓練時即使用 JSON Caption。
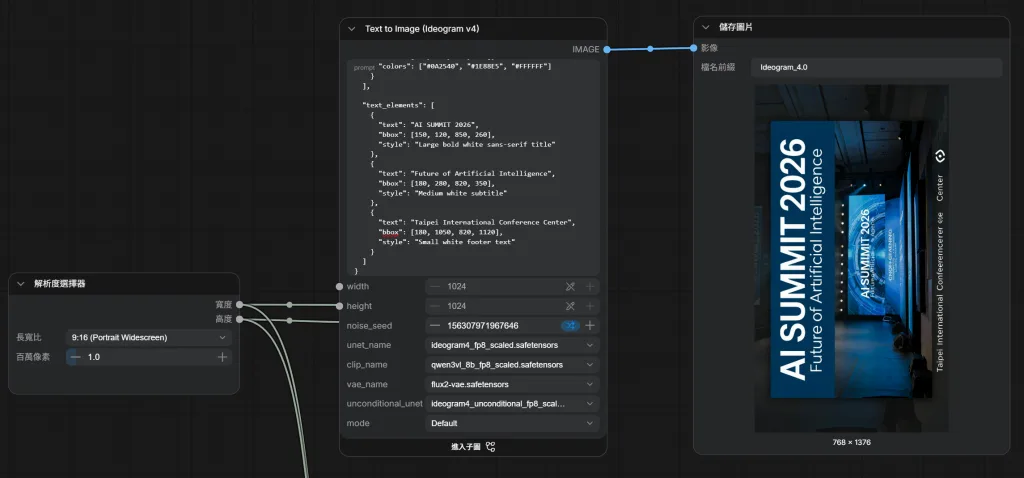
範例:海報設計
{
  "scene_summary": "Professional technology conference poster",

  "background": {
    "description": "Modern convention center stage with blue ambient lighting, large LED screen, clean professional environment"
  },

  "style": {
    "description": "Corporate marketing design, professional conference poster, clean typography, premium branding, modern layout"
  },

  "objects": [
    {
      "description": "Conference stage",
      "bbox": [100, 150, 900, 850],
      "colors": ["#0A2540", "#1E88E5", "#FFFFFF"]
    }
  ],

  "text_elements": [
    {
      "text": "AI SUMMIT 2026",
      "bbox": [150, 120, 850, 260],
      "style": "Large bold white sans-serif title"
    },
    {
      "text": "Future of Artificial Intelligence",
      "bbox": [180, 280, 820, 350],
      "style": "Medium white subtitle"
    },
    {
      "text": "Taipei International Conference Center",
      "bbox": [180, 1050, 820, 1120],
      "style": "Small white footer text"
    }
  ]
}
Bounding Box 控制
可直接指定位置。
{
  "text_elements":[
    {
      "text":"SALE 50%",
      "bbox":[100,100,500,300]
    }
  ]
}
座標範圍:
原點:
這是目前 FLUX 與 Stable Diffusion 所不具備的能力。
色彩盤控制
品牌設計超級好用。
{
  "color_palette":[
    "#FF6600",
    "#FFFFFF",
    "#000000"
  ]
}
官方支援:
與 FLUX 比較
FLUX 強項
Ideogram 4 強項
- Logo
- 海報
- Banner
- 電商素材
- 排版設計
- 中文文字生成
若你是:
Ideogram 4 很可能比 FLUX 更適合。
結論
Ideogram 4 不只是另一個 AI 繪圖模型。
它最大的創新在於:
把 Prompt 從自然語言升級為結構化設計規格。
透過:
- Qwen3-VL
- Diffusion Transformer
- JSON Prompt
- Bounding Box
- Color Palette
使用者終於可以像操作 Figma 一樣控制 AI 生成內容。
對於需要:
- 海報設計
- 品牌素材
- Banner 製作
- AI Agent 自動產圖
的開發者來說,Ideogram 4 是目前最值得研究與部署的開源模型之一。
by Rain Chu | 6 月 6, 2026 | AI, 繪圖
AI 圖像生成正式進入「設計級控制」時代
近兩年 AI 繪圖領域競爭激烈,從 Midjourney、Stable Diffusion、FLUX,到 Google Imagen,各家模型都在追求更好的畫質與更精準的提示詞理解能力。
真正困擾設計師與企業用戶的問題其實不是畫質,而是以下的問題:
- 文字總是生成錯誤
- 排版無法控制
- Logo 與標題位置不準確
- 無法符合品牌色彩規範
- 每次生成結果都像在「抽卡」
2026 年 6 月,Ideogram 正式推出最新開源模型:
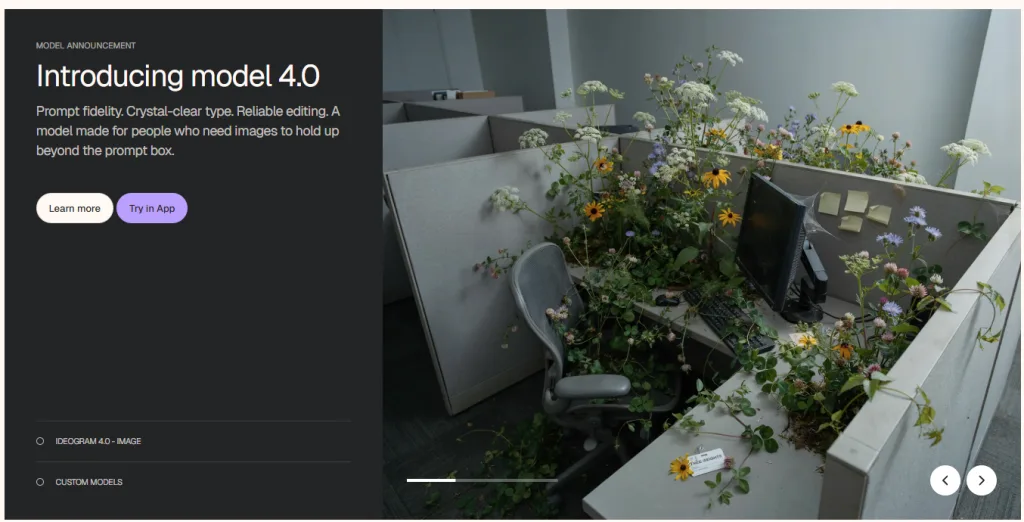
Ideogram 4.0
這不僅是 Ideogram 首次公開權重(Open Weight)模型,更被許多開發者視為目前最接近商業設計工作流程的 AI 圖像生成系統。
什麼是 Ideogram 4.0?
Ideogram 4.0 是一款從零開始訓練的 AI 圖像生成模型,採用最新的:
Diffusion Transformer(DiT)架構
與傳統 Stable Diffusion 不同,Ideogram 4.0 使用:
- 34 層 Transformer
- 93 億參數(9.3B)
- 單流(Single Stream)設計
- 文字 Token 與影像 Token 共用同一套注意力機制
官方稱其為:
Single-Stream Diffusion Transformer(DiT)
這種架構讓模型能更深入理解文字與影像之間的關聯,提高提示詞遵循能力(Prompt Adherence)與版面控制能力。
核心架構解析
1. 文字編碼器(Text Encoder)
Ideogram 4.0 並未使用傳統的 CLIP 或 T5 「文字編碼器(Text Encoder)」。
而是採用了:
Qwen3-VL-8B-Instruct
作為文字理解引擎。
其特色包括:
- 視覺語言模型(Vision Language Model)
- 僅使用文字模式
- 提取 13 個中間層隱藏狀態
- 將多層特徵串接後輸入 DiT
這種設計能同時保留:
讓模型對複雜提示詞有更深層的理解能力。
2. DiT 主幹網路
Ideogram 4.0 採用:
- 34 Layers
- Embedding Dimension:4608
- 18 Attention Heads
- SwiGLU Feed Forward
總參數量達:
9.3 Billion Parameters
目前已是開源 AI 繪圖模型中最頂尖的規模之一。
3. VAE 解碼器
使用凍結(Frozen)的:
KL VAE
特性:
- 8× 空間壓縮
- 128 Latent Channels
負責將潛在空間(Latent Space)轉換為最終圖像。
4. Flow Matching 取樣器
不同於傳統 DDPM。
Ideogram 4.0 採用:
Euler Flow Matching
搭配:
Asymmetric CFG
特色:
- 提升生成效率
- 改善細節品質
- 更穩定的提示詞遵循能力
官方提供三種推理模式:
| 模式 | Steps |
|---|
| V4_TURBO | 12 |
| V4_DEFAULT | 20 |
| V4_QUALITY | 48 |
品質模式會在最後階段降低引導強度,進一步提升真實感。
最大突破:JSON 結構化提示詞
這是 Ideogram 4.0 最具革命性的地方。
過去 AI 繪圖都依賴自然語言:
A beautiful girl standing beside a lake...
Ideogram 4.0 則改為:
{ "background": "...", "objects": [...], "texts": [...], "style": {...}}模型訓練時完全使用 JSON 描述,因此天生理解結構化資訊。
Bounding Box 精準版面控制
支援 Bounding Box:
{ "bbox": [100,100,400,400]}採用:
可直接指定:
這是過去 Midjourney、Stable Diffusion 很難做到的功能。
色彩盤控制(Color Palette)
可直接指定品牌色:
{ "colour_palette": [ "#FF6600", "#FFFFFF", "#000000" ]}限制:
非常適合:
多語言文字生成能力大幅提升
Ideogram 一直以來最強的能力就是:
Text Rendering
也就是圖片內文字生成。
例如:
以往 AI 經常出現亂碼。
但 Ideogram 4.0 已能大幅提升:
等多語系文字品質。
原生支援 2K 輸出
解析度支援:
- 最小:256 × 256
- 最大:2048 × 2048
且:
例如:
- YouTube Banner
- 網站橫幅
- 電商主圖
- 手機桌布
皆可直接生成。
設計工作流功能全面升級
除了模型本身之外,Ideogram 平台也同步推出多項設計工具:
Prompt Edit
直接修改既有圖片中的特定區域。
Magic Fill
局部重繪。
Remix
基於現有圖片重新生成。
Extend / Reframe
擴展畫布與調整比例。
Upscale
提高解析度。
Transparent Background
直接輸出透明背景 PNG。
MCP 整合
可接入 AI Agent 工作流程。
Editable Text Layers
未來將支援真正可編輯的文字圖層功能。
Ideogram 4.0 與 Google Imagen 誰更強?
若比較:
- Google Imagen
- FLUX
- Stable Diffusion
- Ideogram 4.0
目前 Ideogram 最大優勢在於:
✅ 文字生成能力
✅ 排版控制能力
✅ JSON 結構化設計流程
✅ 開源權重
✅ 可自行部署
而 Google Imagen 仍在:
方面維持優勢。
若是企業設計工作流,Ideogram 4.0 已經是極具競爭力的選擇。
官方資源
官方網站
Ideogram 官方網站
模型介紹
Ideogram 4.0 Model Page
技術部落格
Ideogram 4.0 Technical Details
API 文件
Ideogram Developer API
GitHub
Ideogram 4 GitHub Repository
Hugging Face
Ideogram 4 Hugging Face Collection
Ideogram 4.0 不只是另一個 AI 繪圖模型。
它最大的突破在於:
把 AI 繪圖從「描述圖片」提升到「設計圖片」。
透過:
- Diffusion Transformer(DiT)
- Qwen3-VL 編碼器
- JSON Prompt
- Bounding Box 控制
- 色彩盤控制
- 可編輯文字圖層
Ideogram 4.0 正逐步接近 Photoshop、Illustrator 與 Figma 所代表的專業設計工作流程。
對於品牌設計、電商素材、廣告製作與 AI Agent 自動化內容生成來說,Ideogram 4.0 很可能會成為 2026 年最值得關注的開源 AI 圖像生成模型之一
by rainchu | 12 月 18, 2025 | AI, 圖型處理, 影片製作
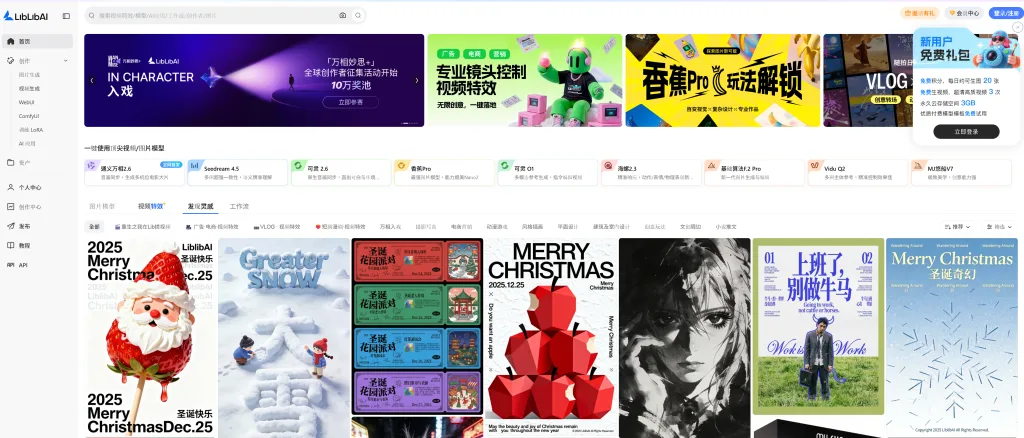
眾多 AI 創作平台之中,Liblib 憑藉其高度整合的功能、生態完整度以及對中文使用者的極致友善設計,迅速成為中國最領先的 AI 創作平台之一。
一站式 AI 影像與視頻創作平台
Liblib 不僅僅是一個圖片生成網站,而是一個超級齊全的 AI 創作平台,涵蓋:
- AI 圖片生成
- AI 視頻特效與動畫
- 模型管理與分享
- 視覺化工作流(Workflow)
- LoRA 訓練與應用
透過雲端化的設計,使用者無需自行架設環境,即可直接在瀏覽器中使用高階 AI 生成能力。
深度整合 WebUI 與 ComfyUI
對於熟悉 Stable Diffusion 生態的使用者而言,Liblib 最大的優勢之一,在於它同時支援:
- WebUI:操作直覺、上手快速,適合大多數創作者
- ComfyUI:節點式工作流,適合進階用戶進行複雜控制與自動化生成
這種雙軌並行的設計,讓初學者與專業用戶都能在同一平台中找到最適合自己的創作方式。
強大的 LoRA 訓練能力
Liblib 在 LoRA 訓練方面表現尤為突出,提供完整且視覺化的訓練流程:
- 上傳資料集即可開始訓練
- 支援多種風格與角色 LoRA
- 訓練完成後可直接套用於生成
- 社群分享與模型市集機制
這讓創作者能快速打造專屬風格模型,大幅降低 AI 模型訓練的門檻。
中文使用者極度友善
相較於許多國外 AI 平台對中文支援不足,Liblib 在以下方面明顯優於同類產品:
- 完整繁體與簡體中文介面
- 中文 Prompt 理解度高
- 中文模型與 LoRA 資源豐富
- 適合華語創作者的社群內容
對中文內容創作者來說,這是一個真正「為中文而生」的 AI 創作平台。
工作流與創作效率全面升級
Liblib 內建的 工作流系統(Workflow),讓使用者可以:
- 將複雜生成流程模組化
- 重複使用高品質生成邏輯
- 快速套用他人分享的創作流程
- 大幅提升商業與批量創作效率
這對於需要大量產出視覺內容的團隊與個人創作者而言,是極具價值的功能。
為什麼 Liblib 是中國最領先的 AI 創作平台?
綜合來看,Liblib 的核心優勢包括:
- ✅ 視頻特效 + 圖片模型完整整合
- ✅ WebUI 與 ComfyUI 同時支援
- ✅ 強大且易用的 LoRA 訓練
- ✅ 中文高度友善,資源豐富
- ✅ 從新手到專業用戶皆適用
這不僅是一個工具,更是一個完整的 AI 創作生態系。
官方網站
👉 Liblib 官方平台
https://www.liblib.art/
近期留言