by Rain Chu | 9 月 25, 2026 | AI, Stable Diffusion, 圖型處理, 影片製作, 繪圖
Stable Diffusion 的基本做法,是從隨機雜訊開始,在文字條件引導下反覆更新潛在表示,最後解碼成圖片。
輸入「一隻卡通柴犬」,模型便逐步生成符合描述的輪廓、色彩與細節。雜訊裡並沒有藏著一張等待被找回的柴犬照片。
理解這個流程,可以分別看 UNet 怎麼學習預測雜訊、CLIP 怎麼處理文字,以及 VAE 為何能減少運算負擔。負
向提示詞與 CFG,則是在生成過程中調整方向的工具。
本文以經典 SD 1.x 的架構為主,不同版本會更換文字編碼器、預測目標或去噪網路,不能把同一套零件規格套到所有模型。
例如 Stable Diffusion 3 採用 Transformer 架構與 rectified flow,若還沒接觸過這類工具,可先看站內早期的 Stable Diffusion 繪圖示例,其中舊服務的額度與介面以當前官方資訊為準。
UNet 怎麼學畫圖?先學習估計加進去的雜訊
把一張柴犬照片加入高斯雜訊,就能得到模糊、顆粒很多的版本。訓練程式知道原始資料、抽到的雜訊與時間步,因此有明確的答案可以用來評估模型。
- 先用 VAE 把訓練圖片編碼成潛在表示。
- 抽取時間步與高斯雜訊,按照排程把雜訊加進潛在表示。
- 把帶噪潛在表示、時間步與文字條件送進 UNet。
- 比較 UNet 預測的雜訊與實際加入的雜訊,更新模型參數。
這裡採用經典的雜訊預測訓練目標,DDPM 論文 說明了前向加噪與反向生成的關係,而 CompVis 原始實作 將去噪工作放進潛在空間,並以文字條件引導。把訓練過程說成「看帶噪圖片,猜出雜訊」容易理解,但實際送進經典 SD UNet 的資料並非 RGB 像素。
從雜訊生成柴犬,為什麼需要反覆更新?
文字生圖時沒有原圖可還原,起點是一份隨機潛在雜訊,UNet 先估計目前狀態中的雜訊,再由 scheduler/取樣器依排程計算下一個狀態,重複後才得到可以解碼的結果。
所以,UNet 的單次輸出不應直接理解成「完成降噪的新圖片」。
預測與更新是兩個步驟。Hugging Face 的流程解說 將 UNet、取樣器與最後的 VAE 解碼分開呈現,有助於看懂 ComfyUI 的節點分工。
示範若把中途結果依序解碼,可能看到柴犬輪廓逐漸清楚。這不代表每一輪都必須經過 VAE,也不代表所有模型都固定需要相同的步數。
CLIP 的工作:把提示詞轉成可用的文字特徵
「卡通柴犬」和「動畫風格的小黃狗」不是同一句話,卻可能描述相近的畫面。
文字編碼器把提示詞轉成數值特徵,讓去噪網路能利用描述中的資訊,相近語意可能得到相關表示,但不同寫法不保證生成同一張圖片。
CLIP 原始研究 使用圖文配對做對比式學習,讓匹配的影像與文字表示更相近,並區分不匹配的組合,拿柴犬照片與汽車照片,分別和「a Shiba Inu」比較,就是直觀的教學案例。這種相似度是表示之間的相對關係,不能直接當成辨識正確率。
在經典文字生圖流程中,主要使用 CLIP 的文字編碼器,透過 cross-attention 把條件交給 UNet,CLIP 的影像編碼器並不是每個去噪步驟都要使用的零件。這也不表示所有圖像生成應用都不需要影像編碼器,加入參考圖的其他管線可能另有設計。
VAE 的工作:在較小的表示中生成,再還原成圖片
VAE 包含 encoder 與 decoder。前者把圖片編碼成潛在表示,後者把潛在表示重建成可見圖片。訓練與圖生圖會需要影像編碼,從純雜訊開始的標準文字生圖則主要在最後使用解碼器。
Latent Diffusion 原始論文 的關鍵,是把反覆進行的擴散運算移到較低維度的表示中,兼顧運算成本與視覺細節。這是經過學習的表示,和把照片縮成小張的縮圖不同。
1024 × 1024 的影像,為什麼會出現 1/48 和 1/12?
以寬、高各縮小 8 倍、潛在通道數為 4 的經典 VAE 為例,可做以下尺寸計算。這只說明表示大小,不表示 SD 1.x 原生訓練解析度就是 1024 × 1024。
| 表示方式 | 寬 × 高 × 通道 | 數值個數 |
|---|
| RGB 影像 | 1024 × 1024 × 3 | 3,145,728 |
| VAE 潛在表示 | 128 × 128 × 4 | 65,536 |
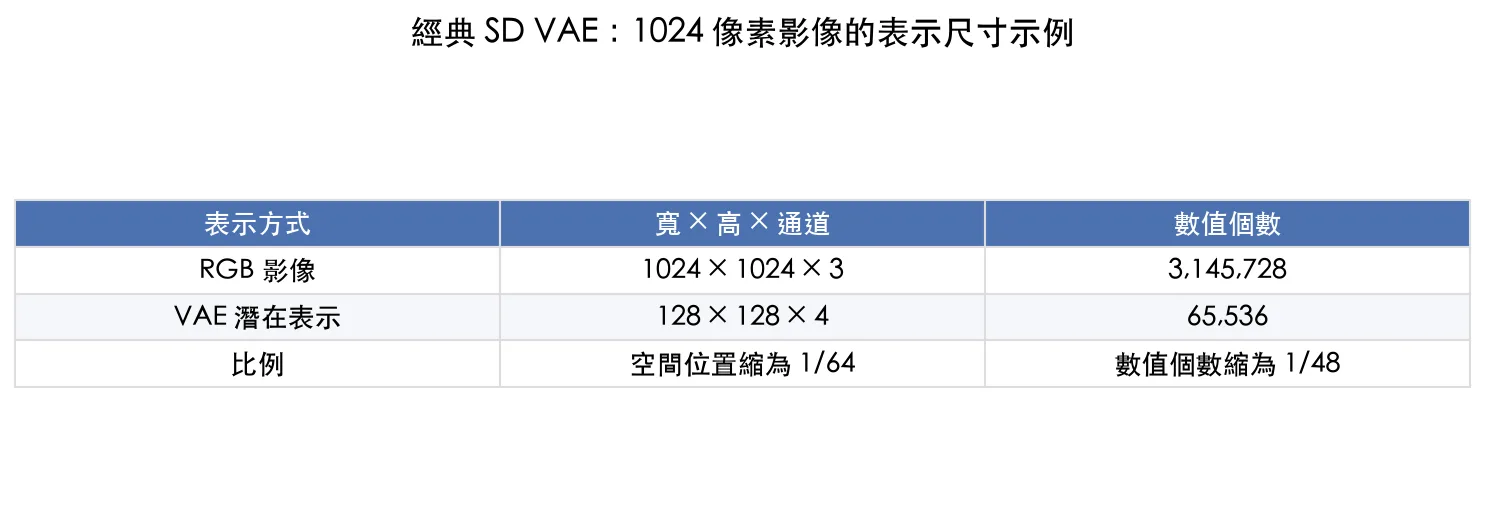 依經典 VAE 的尺寸規則計算,並非生成速度或顯存用量的實測比較。
只比數值個數,比例是 1/48。如果原始 RGB 每個數值用 1 byte,而潛在表示使用每個數值 4 bytes 的 FP32,則是 3 MiB 對 256 KiB,資料儲存量才是 1/12,兩個比例用了不同的比較基準,不能混為一談。實際顯存還包括模型權重、中間運算與其他元件,不會直接照這個比例下降。
反覆重建與旋轉潛在表示,能看出什麼?
把同一張圖重複編碼、解碼,可以觀察有損重建造成的細節變化。但單張示例不能證明每次都會以相同程度劣化,也不能把 VAE 訓練簡化成只有一項逐像素比對。VAE 的原始方法 還包含對潛在分布的約束,實際影像自編碼器也可能使用感知與對抗式目標。
負向提示詞怎麼用?以不戴墨鏡的柴犬為例
想要一隻不戴墨鏡的柴犬,可以先把正向提示詞寫成 a Shiba Inu, clear eyes,負向提示詞填 sunglasses。這是方便測試的起點,不是保證成功的固定配方。
把「不戴墨鏡」整句放在正向提示詞裡,可能無法穩定排除墨鏡。較準確的說法是,這類模型對否定與複雜語意關係的遵循有限,不能推論 CLIP 永遠只懂肯定句,Diffusers 的負向提示詞說明 把它定位為讓生成方向遠離不想要的內容或特徵。
CFG 調整的是兩份預測之間的差異
在支援負向條件的常見 CFG 實作中,模型會估計正向條件與負向條件下的雜訊預測,再依下式組合,沒有填負向詞時,通常使用空文字條件作為基準。
引導後預測 = 負向預測 + CFG ×(正向預測 − 負向預測)
這裡相減的是雜訊預測張量,不是把一張「戴墨鏡的狗」從圖片上剪掉,也不是對文字做算術,基礎概念來自 Classifier-Free Guidance 研究,正負條件的組合方式可對照 Diffusers 管線實作。
CFG 提高會加強兩份預測的差異,但數值過高可能出現失真或不自然的色彩。若負向詞寫得太廣,也可能干擾想保留的元素。先用少量具體詞彙測試,比整串貼上負向詞更容易判斷哪個設定有效。
把完整流程接起來,就能看懂主要設定
- 提示詞先經 tokenizer 與文字編碼器,形成文字條件。
- seed 參與決定初始隨機雜訊,作為生成的起點。
- UNet 接收潛在表示、時間步及文字條件,估計雜訊。
- 依需要使用 CFG,取樣器再更新潛在表示,反覆進行到設定步數。
- 最後以 VAE decoder 轉成 RGB 圖片。
想測提示詞效果,先固定模型、seed、尺寸、取樣器與步數,每次只改一個條件,相同 seed 有助於比較,但跨軟體版本、硬體或不同管線,不保證逐像素重現,步數也不是越高越好,應依所用模型與取樣器的設計調整。
下載模型時,還要分清主模型、文字嵌入與附加權重,站內的 Stable Diffusion 模型類型整理 可用來辨認常見檔案類型,實際相容性仍以各模型說明為準。
LoRA 與蒸餾,和去噪有什麼不同?
LoRA 是調整模型參數的方法。LoRA 論文 以低秩更新減少需要訓練的參數。用在擴散模型時,它可能調整去噪網路或其他部分的行為,但 LoRA 本身不等於一次去噪,也不是另一種取樣器。想觀察權重怎麼影響風格,可延伸看 LoRA 權重與分層設定,留意文中外掛與模型版本的適用範圍。
蒸餾則是利用教師模型的訊號訓練學生。在圖像生成裡,目標之一是讓學生以較少步數完成生成,例如 Adversarial Diffusion Distillation。這需要額外訓練,不能靠把一般模型的步數直接調低就獲得同樣效果,也不一定讓參數量變少。站內 模型蒸餾原理整理 說明了更廣泛的教師與學生關係,圖像模型的具體訓練目標仍要另外看。
Stable Diffusion 原理常見問題
Stable Diffusion 是從雜訊中找回原本的圖片嗎?
標準文字生圖從隨機雜訊開始,沒有一張特定原圖等待還原。模型依文字條件與訓練中學到的規律,逐步生成潛在表示,再解碼成圖片。
UNet、CLIP、VAE 分別做什麼?
在經典 SD 架構中,UNet 預測雜訊,CLIP 的文字編碼器提供文字條件,VAE 負責圖片與潛在表示之間的轉換。取樣器另行決定每一步怎麼更新。
負向提示詞可以保證排除指定物件嗎?
不能保證。它會影響生成方向,但效果取決於模型、正負條件、CFG 與其他設定。應使用具體詞彙逐項測試,而非把它當成物件刪除指令。
VAE 會讓圖片變模糊嗎?
VAE 重建有損,細節與色彩可能改變。是否明顯取決於模型與圖片,反覆編碼解碼也可能累積差異。它不是一般圖片縮放或完全無損壓縮。
生成步數越多,圖片一定越好嗎?
不一定。超過適合的範圍,增加步數可能只有額外耗時。蒸餾模型也可能針對少步數設計,應使用該模型建議的取樣方式與設定。
從一個可比較的小實驗開始
用同一個模型生成柴犬,固定其他設定,依序比較正向描述、負向詞與 CFG 的變化。知道每個元件在做什麼之後,調整設定就能帶著問題進行,不必只靠反覆抽圖。
by Rain Chu | 7 月 12, 2026 | AI, 圖型處理
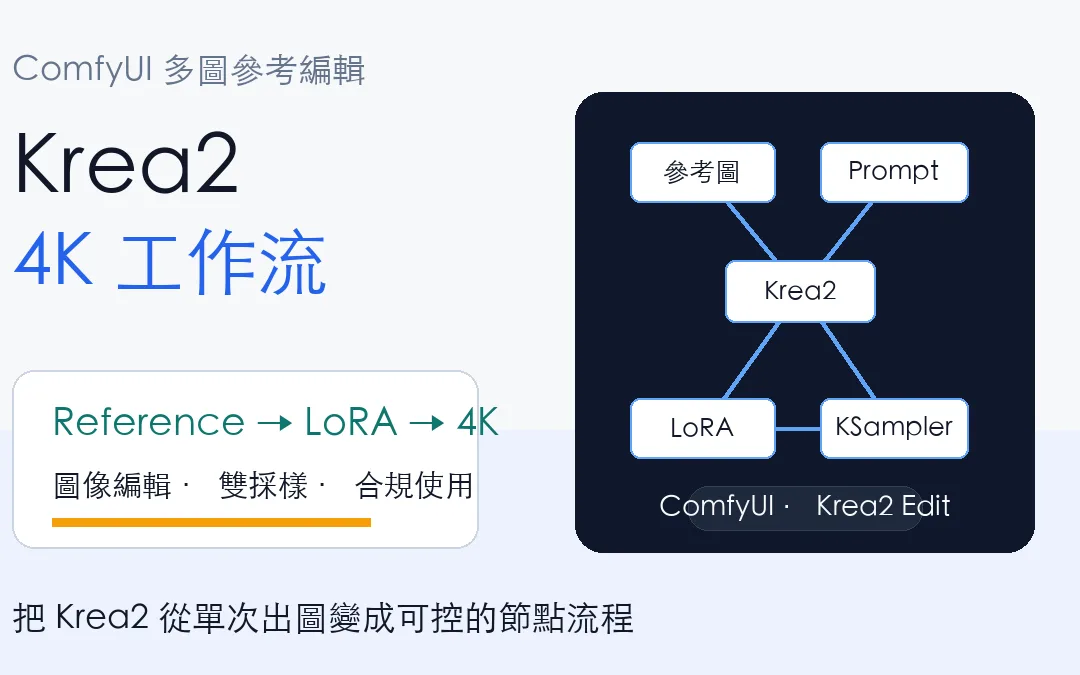
Krea2 開始變得有趣,不只是因為它能做漂亮的圖,而是因為它正在被接進 ComfyUI 的節點工作流。當圖像編輯、多圖參考、LoRA、KSampler 和 4K 出圖放在同一張節點圖裡,Krea2 就不只是單次生成工具,而是可以被拆解、調參、複用的內容生產流程。
我會把這次重點整理成三件事。
第一,Krea2 edit LoRA 的 ComfyUI 節點怎麼理解。
第二,私模與社群模型要怎麼分開看。
第三,4K 工作流不是單純放大,而是先控制訓練尺寸,再用 latent 放大與第二次採樣補細節。
Krea2 圖像編輯的真正重點
Krea2 圖像編輯最吸引人的地方,是它把「參考圖」和「提示詞」放到同一個生成條件裡,這比單純丟一張圖做 img2img 更細,因為參考圖可以被視覺編碼器理解,再和 prompt 一起影響模型輸出。
ComfyUI-Krea2-Ostris-Edit 這個節點包就是關鍵之一,它的 README 說明,這套節點是為了執行用 AI Toolkit 訓練的 Krea 2 edit LoRA,安裝方式是放到 ComfyUI 的 `custom_nodes` 目錄,重新啟動後節點會出現在 `ostris/krea2` 類別。
它不是模型本體,而是讓 ComfyUI 能正確吃進 Krea2 edit LoRA 的橋,這點很重要,因為很多人看到節點就以為模型已經包含在裡面,實際上模型、LoRA、節點和工作流是四個不同層次。
多圖參考不是把圖片塞進去就好
Krea2 Ostris Edit 的文字編碼節點可以接受 prompt,也可以接受 `image1` 到 `image3` 這類參考圖。GitHub 說明裡提到,參考圖會透過 Krea2 的 Qwen3-VL text encoder 編碼,並用 Krea 的 conditioning template 加入 `Picture N:` 這類視覺 placeholder。
換句話說,多圖參考的重點不是「圖片有沒有接上節點」,而是參考圖有沒有被正確轉成 conditioning。若接了 VAE,參考圖也會被 VAE 編碼成 reference latents,再交給 model patch 節點使用。這也是為什麼工作流裡會看到 Text Encode、Model Patch、VAE、KSampler 連在一起。
- Text Encode Krea 2 Ostris Edit 負責把 prompt 與參考圖一起編碼
- Krea 2 Ostris Edit Model Patch 讓模型真的消化 reference latents
- 如果文字編碼 checkpoint 沒有 Qwen3-VL vision weights,參考圖就無法被正確編碼
- 如果 conditioning 沒有 reference latents,patch 後的模型會像原本的 Krea2 一樣運作
這也是我會把它歸類為進階 ComfyUI 工作流,而不是單純的模型推薦,若你對節點式 AI 生產平台還不熟,可以先看我整理過的 RunningHub 與 ComfyUI 工作流平台,會比較容易理解為什麼同一個模型放進工作流後,價值會完全不一樣。
私模、社群模型與合規使用要分清楚
這次素材裡有一個很值得注意的提醒:老白訓練的 Krea2 亞洲女性私模不是開源模型,它是投入大量訓練步數與算力成本做出來的商業模型,這類模型能不能商用、能不能轉售、能不能放到平台上提供他人使用,都要看授權條款。
所以我會把工作流和模型分成兩條線來看。工作流可以學,節點可以研究,參數邏輯也值得整理,但私模本身不是「看到連結就能自由拿來用」的資源。若只是想理解 Krea2 工作流,可以先從社群模型、公開節點和 RunningHub 上的示範流程開始。
另外,Krea2 的圖像編輯能力很容易碰到肖像、換裝、仿真與身份一致性問題。越是接近真人或商業素材,越需要確認素材來源、肖像權、授權和平台規範。技術可以做到,不代表每個場景都適合做。
4K 工作流的核心不是暴力放大
這套 4K 思路有一個實用點:先用接近訓練尺寸的長邊出圖,再在 latent 空間放大,最後用第二次採樣補細節。以這次整理的參數來看,長邊 1536 是一個被反覆提到的基準,因為後面還要做倍率放大。
第一個 KSampler 會用比較高的 denoise,例如 `denoise 1`,步數可以抓 8 到 10 步。這一步不是最後成品,而是建立整體構圖與質感。接著在 latent 空間放大,例如 2.5 倍,再進入第二個 KSampler。第二次採樣通常要更保守,避免把第一輪已經穩定的畫面重新打亂。
| 階段 | 用途 | 重點 |
|---|
| 第一輪採樣 | 建立構圖與主要質感 | 可用較高 denoise,步數約 8 到 10 |
| latent 放大 | 把畫面放到更高解析度 | 倍率要配合原始長邊與顯存 |
| 第二輪採樣 | 補細節與穩定質感 | 採樣器與 denoise 要保守,避免重新洗圖 |
這個思路和傳統 Stable Diffusion 的高解析修復很像,但放到 Krea2 和 LoRA 組合後,更需要注意模型本身的訓練尺寸與美學方向。你如果常玩本機模型部署,也可以對照我之前寫的 ComfyUI 本機部署 AI 繪圖模型,兩者都在處理「模型能力」和「工作流控制」之間的平衡。
LoRA 權重不是越高越好
這次工作流裡多次出現 LoRA 疊加。單獨使用某個風格 LoRA 時,權重可以先從 0.8 附近測。若兩個 LoRA 一起用,總權重抓在 0.9 到 1.0 比較容易控制,例如一個 0.5,另一個 0.4。
這不是死規則,而是避免模型過度偏移的起點。Krea2 本身的細節與光影已經很強,LoRA 的目的應該是加強風格或概念,而不是把底模原本的結構感整個蓋掉。若出現臉部變形、姿勢不穩、材質變髒,第一個要檢查的通常不是 prompt,而是 LoRA 權重和第二輪採樣是否太激進。
Krea2 工作流適合誰
我覺得 Krea2 這類流程比較適合三種人。第一種是已經熟悉 ComfyUI,想要把參考圖、LoRA、放大與後處理串成固定模板的人。第二種是需要穩定產出社群圖像、封面、人像素材或商品視覺的人。第三種是想研究圖像編輯模型訓練方向的人,因為 Krea2 edit LoRA 的節點設計能看出參考圖 conditioning 的實作脈絡。
如果只是偶爾修圖,可能用線上工具會比較快。如果要長期做工作流、批量產圖、測 LoRA 權重,ComfyUI 仍然比較有彈性。也可以用 AIX Studio 這類 AI 繪圖平台 做比較,看看自己需要的是封裝好的產品,還是可拆解的節點流程。
實作前可以先檢查這幾件事
- 確認 Krea2 模型與 LoRA 來源,尤其是授權和商用限制
- 安裝 ComfyUI-Krea2-Ostris-Edit 節點後再重啟 ComfyUI
- 確認 text encoder checkpoint 含有 Qwen3-VL vision weights
- 多圖參考要檢查 VAE reference latent 是否真的接進 conditioning
- 第一輪採樣先穩構圖,第二輪採樣再補細節
- LoRA 疊加時總權重不要一開始就拉太高
- 真人、換裝、仿真、商業圖像要先確認合規與授權
若你想直接在線上試工作流,可以看 RunningHub 的 Krea2 Realism Engineer v2 工作流頁面。若人在海外,RunningHub 也有海外站。這類平台的好處是不用先處理本地顯卡和節點衝突,但缺點是工作流可控性和資料隱私要自己評估。
結論
Krea2 圖像編輯真正值得看的,不只是單張效果圖,而是它如何被拆成 ComfyUI 裡的節點、conditioning、model patch、LoRA 權重和雙採樣流程。這讓它從「好看的模型」變成「可調整的生產系統」。
我的建議是先從公開節點和可取得的工作流開始,把參考圖進 conditioning 的路徑搞懂,再去看私模或商業模型是否值得投入。尤其是人像與商業素材,合規使用要放在技術嘗試前面。能生成不是終點,能穩定、可控、可授權地生成,才是 Krea2 工作流真正能落地的地方。
延伸資源
by Rain Chu | 4 月 10, 2023 | AI, Stable Diffusion, 繪圖
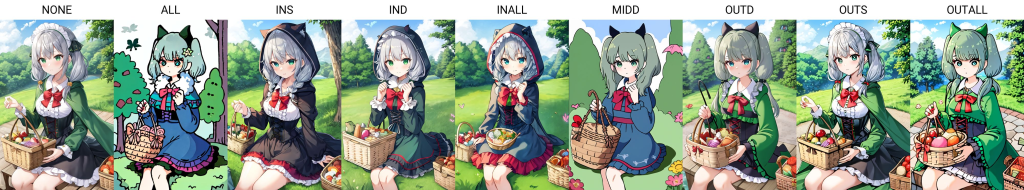
Stable Diffusion Lora 超好用,已經不太需要說明,今天要來介紹一個可以讓 Lora 放開她的束縛,可以完全調整 Lora 在模型中的每一層的權重設定,為何要有分層設定,可以看看原作者的下面這張說明圖,分別在不同層插入 Lora 可以有不同的效果出現,也可以更精準的控制AI
LoRA 權重外掛
hako-mikan/sd-webui-lora-block-weight (github.com)
安裝方法,到擴充功能中,選擇從網址安裝,並且輸入 hako-mikan/sd-webui-lora-block-weight (github.com)
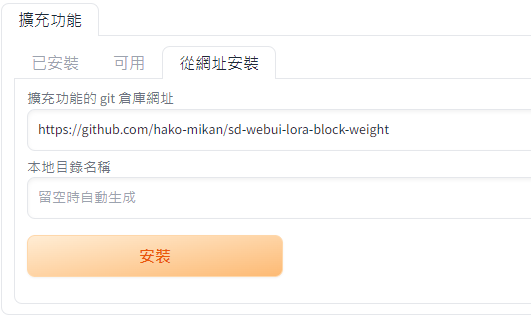
之後重啟系統即可看到多了 LoRA Block Weight 可以用
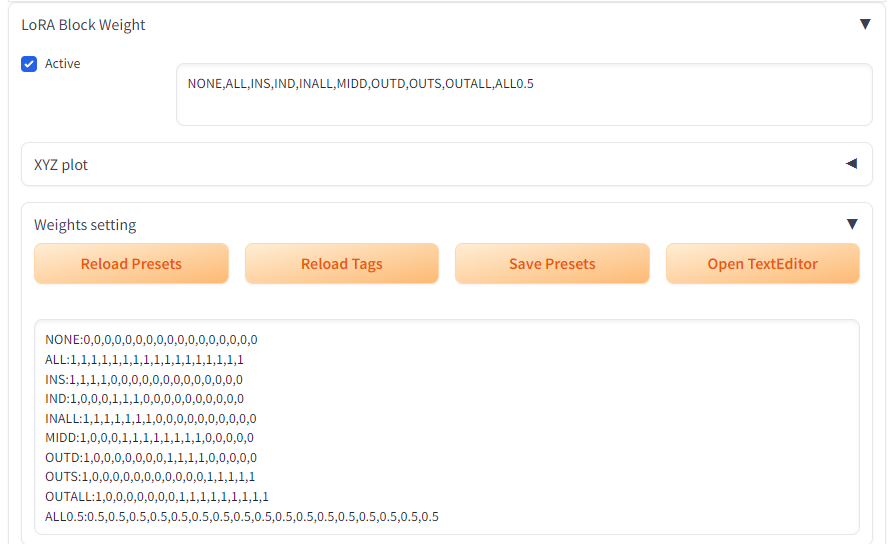
至於使用效果的話,我建議都試試看上面的設定,再去拿捏下手的感覺
LoRA 整合權重外掛的 UI
bbc-mc/sdweb-merge-block-weighted-gui: Merge models with separate rate for each 25 U-Net block (input, middle, output). Extension for Stable Diffusion UI by AUTOMATIC1111 (github.com)
LoRA擁有17個作用層
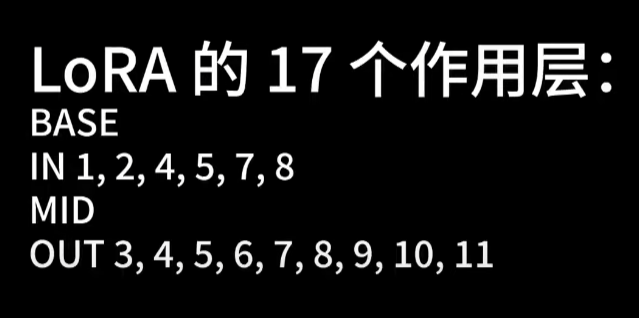
參考資料
by Rain Chu | 4 月 8, 2023 | AI, Stable Diffusion, 繪圖
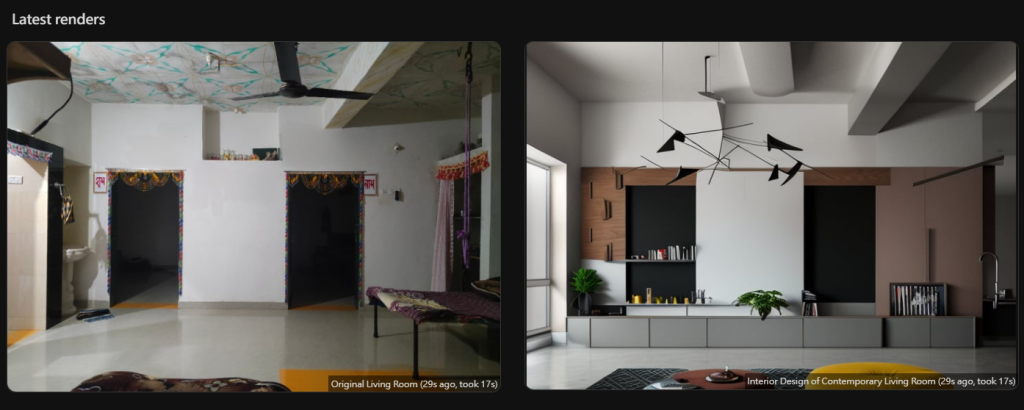
想要裝潢自己的房間,以前要學會CAD、3D、還要有美學基礎,和知道各式各樣的配件,才能完成室內設計的艱難任務,但現在可以用 StableDiffusion + ControlNet 或是 Lora 等方法,也可以用 https://interiorai.com/ 有訓練好且專門針對室內設計用的 AI 網站來創意發想。
一個好的室內設計軟體應該要能夠
- AI空間規劃:這款工具可以根據用戶提供的房間尺寸和設計需求,自動生成合適的家具佈局。它可以幫助室內設計師快速評估不同的空間規劃方案,並找出最佳的解決方案。
- AI颜色搭配:這款工具可以根據用戶提供的颜色樣本,自動生成和推薦搭配方案。它能幫助室內設計師在短時間內找到理想的配色方案,提高設計效率。
- AI材質生成:這款工具可以根據用戶提供的材質樣本,自動生成高質量的材質圖像。它可以為室內設計師提供大量的材質選擇,並支持快速地將材質應用到設計中。
- AI風格轉換:這款工具可以將一種風格的室內設計快速轉換為另一種風格。這可以幫助室內設計師為客戶提供多種風格的設計方案,以滿足不同的品味和需求。
而 interiorai 就可以快速的滿足上述條件
簡單且快速地創造提案
提供圖片檔,選擇場景,選擇創意,馬上就可以得到些提案,之後就可以精修設計圖
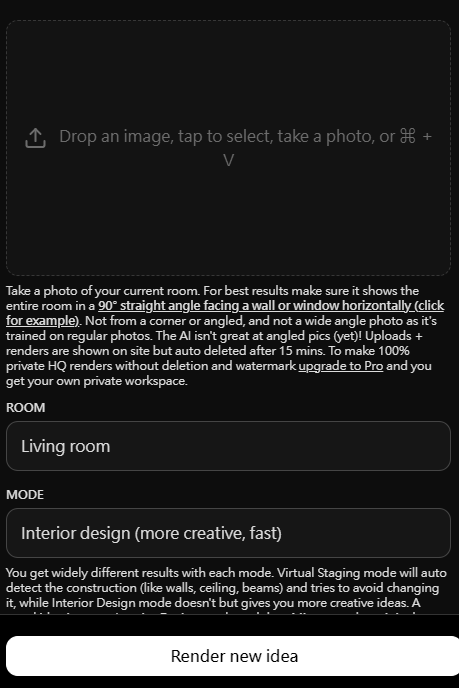
各種風格和功能可以進階調整

費用,專業版本每個月29美元,約900元
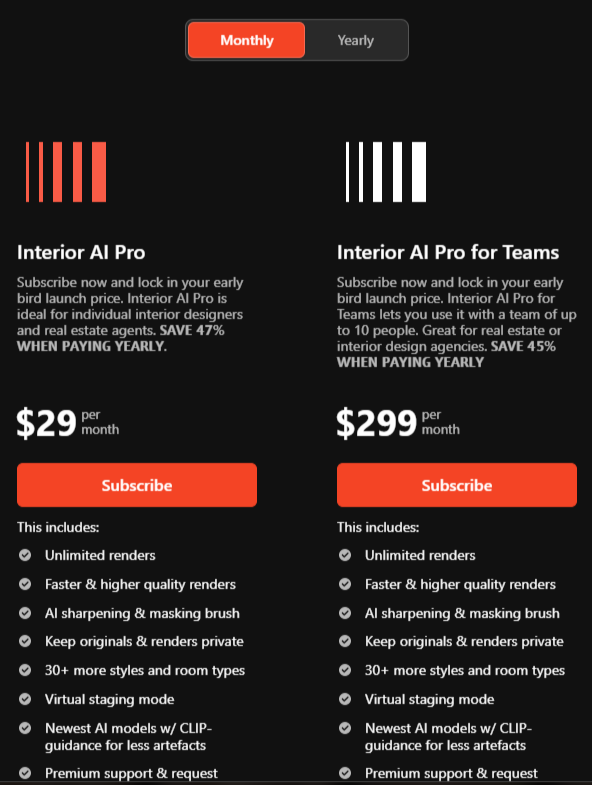
參考資料
AI也會畫室內設計

近期留言