
有人只用 AI 問幾個問題,得到不太可靠的答案。
有人卻讓 AI 修改程式、整理資料,最後交出一個能用的成果。
Karpathy 的 AI 漏斗,是理解這種落差的一個框架。
它提醒我們,評估 AI 之前,要先交代使用條件。對一般人來說,更有用的問題是:我能否把手上的一件真實工作,交給 AI 做到可以驗收?
內容目錄
AI 漏斗的四層,各自看見什麼?
在 Karpathy 的漏斗貼文中,接觸情境從幾乎沒用過大型語言模型,一路縮小到專業 Agent 使用者與實驗室內部系統。
下表的人數是他個人的粗估,沒有附上正式調查方法,不能當成人口統計或市場規模。
| 使用情境 | 原文粗估人數 | 典型接觸方式 |
|---|---|---|
| 幾乎沒有接觸 | 約 60 億 | 很少使用大型語言模型 |
| 偶爾使用 | 約 10~20 億 | 免費聊天、搜尋、改寫 |
| 專業應用 | 約 2,000 萬 | 數學、程式與 Agent 專案 |
| 實驗室內部 | 約 5,000 | 內部前沿系統,外界難以驗證 |
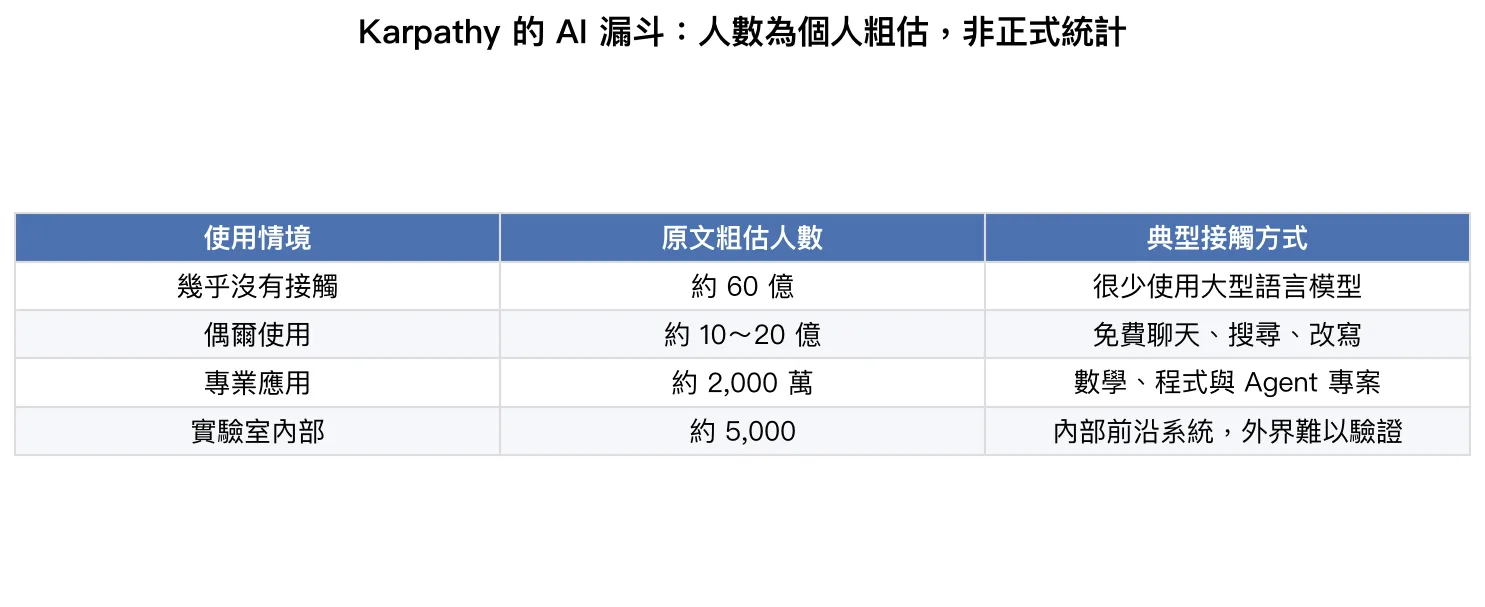
前兩層主要看到的是問答、搜尋與文字輔助,第三層接觸的是能操作工具、持續執行專案的系統,至於第四層的內部能力,外界難以完整驗證。
為什麼同樣叫 AI,使用感受差這麼多?
任務規模不同,看到的價值就不同
Karpathy 把任務的企圖、規模與時間跨度列為原因之一。幾句問答和完整專案,呈現的能力不同。這不代表事情越大越適合一次全交出去。實際使用時,我會先把成果拆成可檢查的小步驟,讓 AI 完成一段,再決定下一段。
能力有高峰,也有低谷
另一個原因是能力分布不均。數學與程式通常比較容易設計可驗證的回饋,但程式能執行、測試通過,仍不等於所有需求都正確。把某項程式任務的表現,直接推論成所有知識工作都能自動完成,很容易高估它。
模型版本與可用工具不同
免費、付費與內部系統的接觸條件也可能不同。Karpathy 較早的貼文已提醒,舊版本的體驗未必能代表後來的系統。不過方案名稱本身也不能保證成果,還要看實際選用的模型、工具與任務。
先做一次能驗收的小專案
想改善使用成果,可以先挑一件你本來就知道怎麼判斷好壞的工作。下面是我建議的練習方式,屬於把漏斗觀點用在日常工作的延伸做法。
- 定義交付物。例如把一份去識別化的支出資料整理成月報,指定輸出欄位、分類規則與檔案格式。
- 給一小份範例。先提供幾筆資料與正確答案,讓分類錯誤能及早被看見。
- 讓 AI 先確認需求。若規則有歧義,先列出問題。可以參考讓 Agent 開工前釐清需求的方法。
- 允許必要的工具。需要算數就實際運算,需要檔案就產生檔案。例如用 Agent 操作 Office 文件,成果才能在原本的工作環境裡檢查。
- 檢查並記下成本。核對總額、抽查分類、確認檔案打得開,也記下修改次數、等待時間與花費。
如果你想用做網站來練習,也可以參考把需求做到可操作網站的工作流。一次只處理一項功能,親自操作驗收,比只看生成的畫面更能判斷它是否完成。
一定要買高階顯卡,或追到內部系統嗎?
不必把這兩件事當成起點。使用雲端服務時,模型通常由服務端執行,本機顯卡不是主要門檻。若目標是本地部署,才需要按模型、記憶體與速度需求評估硬體,可以先用本地模型硬體評估工具檢查可行性。
如果預算有限,先在可用的額度內挑一個小任務,確認整個流程有沒有價值。真的遇到額度或能力限制,再評估是否升級。買了更貴的方案,仍然需要清楚的資料、需求與驗收標準。
至於 Garry Tan 對更多人取得能力的期待,以及 Brett Caughran 對技術擴散的樂觀看法,都可以作為觀察角度。它們是個人判斷,無法保證價格一定下降,也不代表一般人有公開途徑加入那個內部使用群體。
下次討論 AI,先把測試條件說清楚
與其只交換「很好用」或「很笨」的評語,可以一起交代模型與使用日期、任務內容、提供的資料、可用工具,以及最後怎麼驗收。這樣才容易看出,差距究竟出在能力、資訊不足,還是工作流程。
這週就挑一件會重複發生、結果容易核對的小工作,完成一次從輸入到交付的流程。做完後,保留成功條件與失敗案例。你會比單純知道自己在漏斗哪一層,更清楚下一步該改善什麼。
常見問題
Karpathy 的 AI 漏斗是正式統計嗎?
不是。原文把人數稱為個人粗估,沒有提供正式抽樣與調查方法。適合用來理解使用經驗的差異,不適合當成精確的全球採用率。
一般人如何從聊天進步到完成任務?
先選一件小而真實的工作,提供範例與輸出規格,讓 AI 使用必要工具,再親自檢查成果、修改次數與成本。