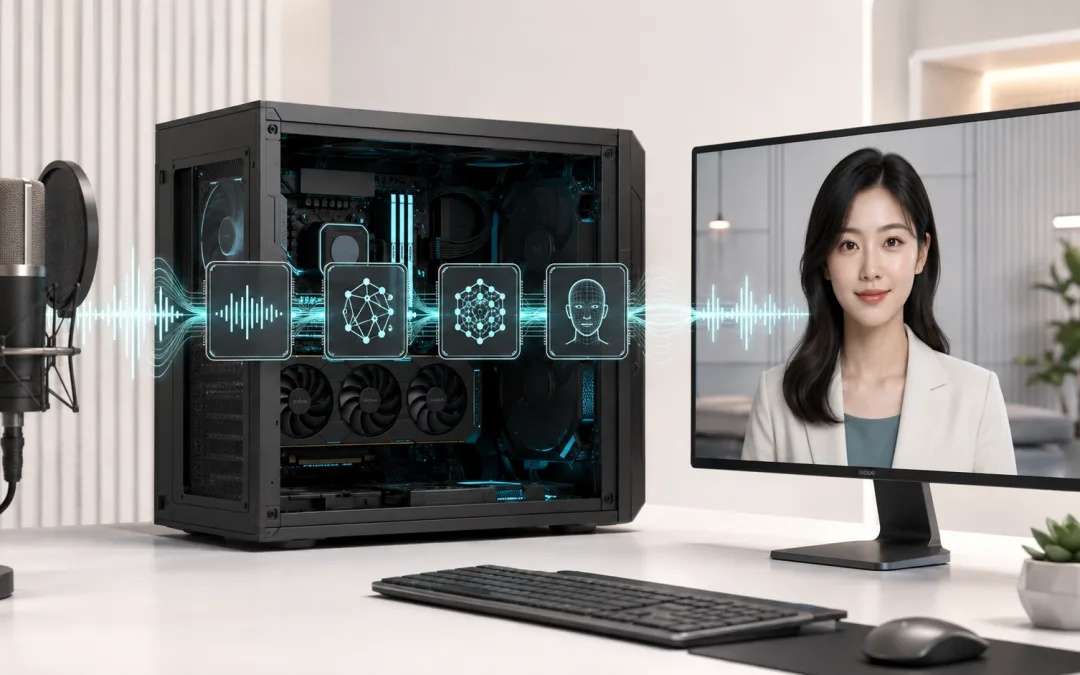
把 AI 對話、即時語音和會動的人像放在同一台電腦上,現在已經可以做出一套不依賴雲端 API 的互動數位人,用 faster-whisper 聽懂麥克風,讓 Qwen3 產生回答,再交給 Qwen3-TTS 合成聲音,最後由 LiveTalking 完成口型同步與 WebRTC 串流。
先講我的結論。這套方案的價值是隱私、角色控制與離線能力,不是安裝後完全沒有成本。模型權重下載完成後確實不需要按次支付 API 費用,但顯卡、記憶體、硬碟、電力與維護時間仍然是成本,所謂 8GB 顯存能跑,也必須以較小的 LLM、量化權重和分階段載入為前提.若想讓 14B LLM、Whisper large-v3、1.7B TTS 與口型模型同時常駐,16GB 顯存仍可能不夠。
內容目錄
整套本地 AI 數位人怎麼運作
這不是單一模型,而是一條由五個服務組成的即時管線。
- VAD 判斷使用者何時開始與停止說話
- faster-whisper 把麥克風聲音轉成文字
- Qwen3 與 llama.cpp 根據角色設定產生回答
- Qwen3-TTS 把回答轉成指定音色的語音
- LiveTalking 接收音訊並驅動嘴型,再透過 WebRTC 顯示互動人像
這種模組化做法和我之前整理的 Hugging Face speech-to-speech 本地即時語音 Agent 是同一條思路。每一層都能替換,但每一層也有自己的模型、連接埠與執行環境。LiveTalking 不會自動知道 Qwen3-TTS 在哪裡,兩者中間仍需要官方支援的 TTS 外掛,或一個把生成音訊送到 /humanaudio 的橋接程式。
先算顯存,不要先相信 8GB 宣傳
| 元件 | RTX 4090 範例占用 | 低顯存調整 |
|---|---|---|
| Qwen3-14B Q4_K_M | 約 9GB | 改用 8B 或 4B 的 Q4_K_M |
| faster-whisper large-v3 | 約 3GB | 改用 medium,準確度會有取捨 |
| Qwen3-TTS 1.7B | 約 4GB | 改用 0.6B 或依序載入服務 |
| Wav2Lip 256 | 約 1.3GB | 降低批次並避免其他 GPU 程式常駐 |
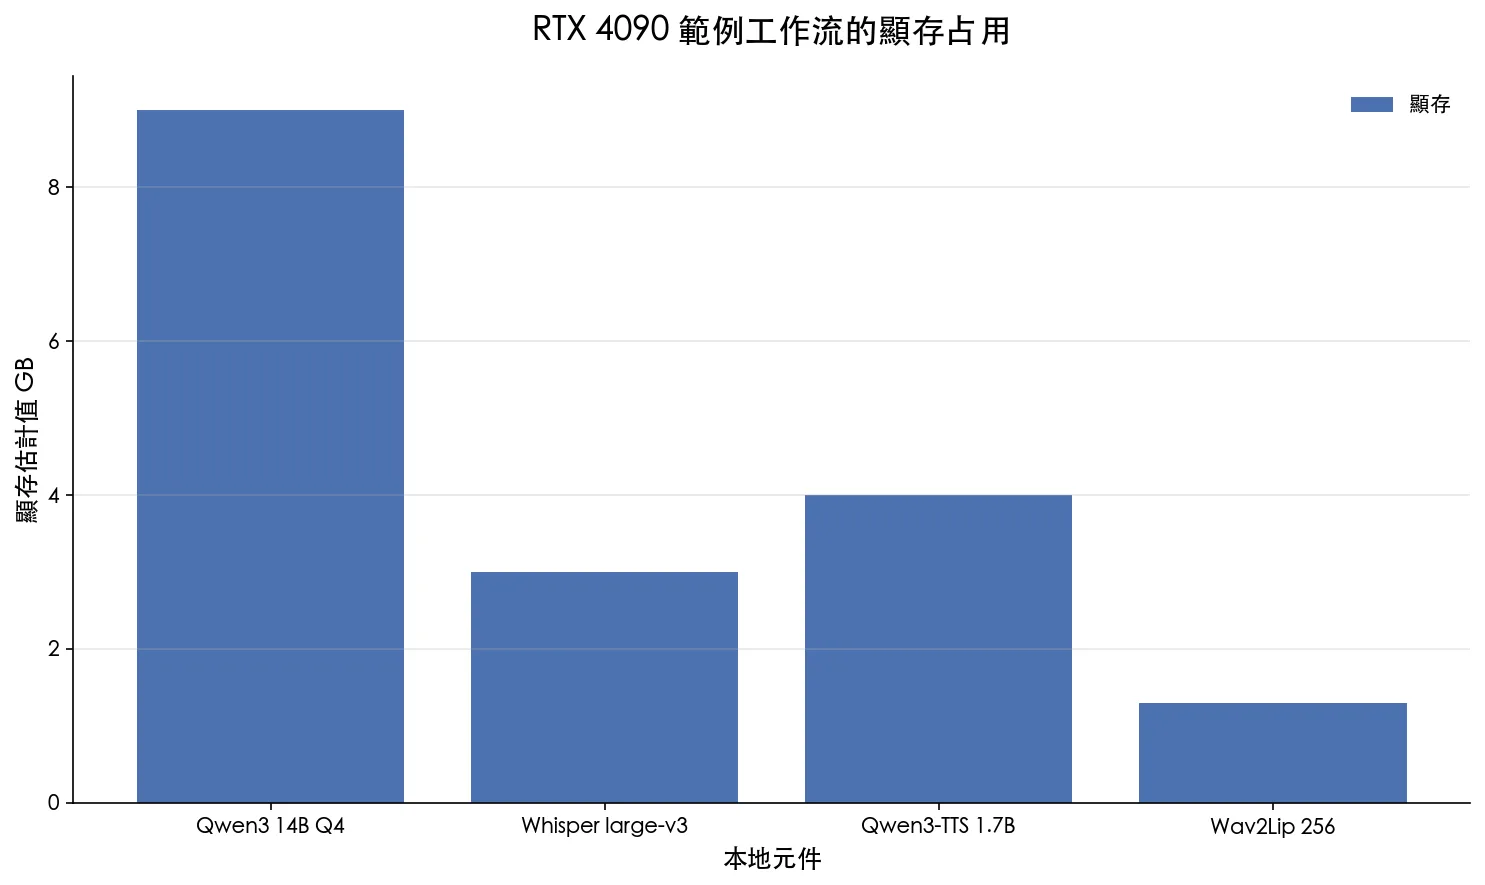
四個元件加起來約 17.3GB,還沒算 CUDA context、瀏覽器與暫存空間。16GB 顯卡跑到 99% 甚至整台機器失去回應,並不意外。6GB 顯存可以先用 Qwen3-4B 的 GGUF 量化版,並把語音辨識改成 medium。8GB 到 12GB 則適合 Qwen3-8B 搭配較小 TTS,或讓部分元件使用 CPU。若想了解 GGUF、llama.cpp 與 Ollama 的取捨,可以先看 本地大模型推理框架比較。
第一步,在 Windows 準備 WSL 2
這套整合方式把 llama.cpp 放在 Windows,語音與數位人服務放在 Ubuntu 24.04 的 WSL 2。先用系統管理員身分開啟 PowerShell。
wsl --update
wsl --install -d Ubuntu-24.04
Windows 使用者目錄的 .wslconfig 可以設定記憶體與鏡像網路。32GB 是範例,請依實際 RAM 調整,不要把主機記憶體全部交給 WSL。
[wsl2]
memory=32GB
networkingMode=mirrored

[experimental]
hostAddressLoopback=true
修改後重啟 WSL。
wsl --shutdown進入 Ubuntu 後先用 nvidia-smi 檢查 GPU。NVIDIA 的 Linux 驅動不要再裝進 WSL,CUDA passthrough 由 Windows 顯示卡驅動提供。AMD 顯卡不能照搬這套 CUDA 整合包,需要改走 ROCm 支援的元件,或把無法使用 ROCm 的部分移到 CPU。
專案最好放在 Linux 家目錄,不要直接在 /mnt/c 執行。這能避開 I/O 速度、權限與換行格式問題。
mkdir -p ~/setup
cp -r "/mnt/c/Users/YOUR_NAME/Desktop/AI/." ~/setup/
cd ~/setup
sudo apt update
sudo apt install -y ffmpeg dos2unix python3-venv
dos2unix *.sh
chmod +x *.sh
第二步,用 llama.cpp 啟動 Qwen3
llama.cpp 提供 OpenAI 相容 HTTP 服務,語音管線不必知道底層跑的是 GGUF。16GB 以上可以從 Qwen3-14B 的 Q4_K_M 開始,8GB 到 12GB 建議改成 8B,4GB 到 6GB 則從 4B 測試。
llama-server -m E:\llama.cpp\models\Qwen3-14B-Instruct-Q4_K_M.gguf ^
  -np 1 -c 8192 -fa on --temp 1.0 --top-p 0.95 ^
  --host 0.0.0.0 --port 8090
新版 llama.cpp 文件也開始使用 llama serve 名稱,實際命令要以下載版本為準。Windows 的 8080 有時落在 Hyper-V 保留範圍,所以範例改用 8090。若服務無法綁定,可以先檢查保留埠。
netsh interface ipv4 show excludedportrange protocol=tcp第三步,安裝即時語音管線
Hugging Face 官方 speech-to-speech 現在以 serve、talk 和 local 為主要命令,舊資料裡的 --mode 已經淘汰。先建立獨立環境,再安裝 faster-whisper 額外依賴。
python3 -m venv ~/venvs/s2s
source ~/venvs/s2s/bin/activate
python -m pip install --upgrade pip
pip install "speech-to-speech[faster-whisper]"
以下範例把 LLM 指向 Windows 上的 llama.cpp。不同版本的 STT 參數名稱可能調整,正式啟動前先執行 speech-to-speech serve --help 對照目前安裝版本。
speech-to-speech serve \
  --stt faster-whisper \
  --stt_model_name large-v3 \
  --language zh \
  --llm_backend responses-api \
  --tts qwen3 \
  --model_name Qwen3-14B-Instruct-Q4_K_M \
  --responses_api_base_url http://127.0.0.1:8090/v1 \
  --responses_api_api_key "" \
  --responses_api_stream \
  --enable_live_transcription
模型全部下載完成後,可以設定 HF_HUB_OFFLINE=1 驗證斷網狀態。這一步比口頭宣稱本地化更可靠,因為只要還有任一個後端指向雲端,就不算完整離線。
第四步,準備 Qwen3-TTS 與參考聲音
Qwen3-TTS 官方最簡單的安裝方式是獨立建立 Python 3.12 環境。它支援聲音克隆、音色設計與串流輸出。更多模型差異和 ComfyUI 節點用法,可以延伸看 Qwen3-TTS 音色設計整理。
conda create -n qwen3-tts python=3.12 -y
conda activate qwen3-tts
pip install -U qwen-tts
參考音訊建議控制在 5 到 15 秒,只留單一說話人,沒有音樂與明顯環境聲。參考文字必須和音訊實際內容完全相同,否則容易出現漏字、錯字與音色漂移。情緒也會一起被模仿,所以不要用過度激動的片段當作一般對話基準。
ffmpeg -i ~/setup/ref.wav -ac 1 -ar 16000 -c:a pcm_s16le ~/s2s/ref.wav
ffprobe -v error -show_entries stream=sample_rate,channels,codec_name \
  -show_entries format=duration -of default=nw=1 ~/s2s/ref.wav
只應克隆自己或已取得明確授權的聲音。把真人聲紋放入公開服務前,也要考慮檔案存取權限、提示注入與未授權冒用。
第五步,製作自然的待機人像
人像素材不適合直接使用張嘴、手擋住嘴巴或劇烈轉頭的畫面。先生成嘴唇閉合、正面或微側面的基準圖,再用 Wan2.2 圖生影片做五秒左右的待機動作。提示詞只描述動作,不要重新描述人物外觀,能減少五官漂移。
電影感 16 比 9 構圖,一位成年東亞女性位於畫面右側三分之一,深色安靜房間,左側保留大量空間,螢幕冷光照亮臉部,輪廓帶柔和暖光,嘴唇自然閉合,雙手不遮擋嘴部,自然皮膚紋理,淺景深,真實攝影質感
負面提示詞
張嘴,說話,露齒,正面平光,明亮背景,過高對比,過度曝光,人物置中,多人,手遮擋嘴部,文字,浮水印,塑膠皮膚,過度修圖,卡通,3D 渲染
待機動畫提示詞
人物保持坐姿,只有細微自然呼吸,緩慢眨眼一次,頭部輕微移動後回到原位,嘴唇全程閉合,鏡頭完全鎖定,沒有縮放,沒有切鏡
關閉自動提示詞增強,輸出比例盡量和原圖相同。Wan2.2 常見原生片段是 81 幀、16 FPS,約五秒。若要二十秒待機,不要期待模型一次生成毫無漂移的長鏡頭,可以在自然停頓點循環短片。其他數位人生成思路可參考 LongCat 數位人工作流。
第六步,安裝 LiveTalking
LiveTalking 官方目前測試的環境是 Ubuntu 24.04、Python 3.12、PyTorch 2.9.1 與 CUDA 12.8。下面命令照官方版本撰寫,但 PyTorch 下載來源仍應配合自己的 CUDA 驅動,不要盲目安裝 cu128。
git clone https://github.com/lipku/LiveTalking.git
cd LiveTalking
conda create -n livetalking python=3.12 -y
conda activate livetalking
pip install torch==2.9.1 torchvision==0.24.1 torchaudio==2.9.1 \
  --index-url https://download.pytorch.org/whl/cu128
pip install -r requirements.txt
下載官方提供的 wav2lip256.pth 後,把它放到 models,並改名成 wav2lip.pth。範例角色資料夾則解壓到 data/avatars。完成後啟動 WebRTC 服務。
python app.py --transport webrtc --model wav2lip \
  --avatar_id wav2lip256_avatar1 \
  --stun 'stun:stun.l.google.com:19302'
瀏覽器開啟 http://localhost:8010/index.html,按下開始連線。正式讓外部裝置使用時,官方提醒需要 TCP 8010 和 WebRTC 使用的 UDP 連接埠。不要直接把整段 UDP 範圍暴露到公網,應優先放在可信任區網、VPN 或經過限制的防火牆環境。
自己製作 Wav2Lip 角色時,可以把短影片轉成 avatar 資料。素材要維持正面可見、光線穩定與嘴部清楚。
python avatars/wav2lip/genavatar.py \
  --video_path data/video/avatar.mp4 \
  --img_size 256 \
  --avatar_id my_avatar
第七步,正確啟動與串接
我會把服務拆成四個終端視窗,照下面順序啟動。每一步都先確認健康狀態,再開下一個服務。
- Windows 啟動 llama.cpp,確認
http://127.0.0.1:8090/v1/models有回應 - WSL 啟動 Qwen3-TTS 或 speech-to-speech,先完成單句語音測試
- WSL 啟動 LiveTalking,確認 8010 網頁能顯示待機角色
- 最後啟動橋接程式,把 TTS 產生的音訊送入 LiveTalking 的
/humanaudio
作者提供的一鍵整合包包含自訂腳本與橋接程式,並不是 Hugging Face、Qwen 或 LiveTalking 的官方發行版。下載前應先檢查檔案來源、雜湊值、啟動腳本和網路連線,不要把未知執行檔直接放進主要工作電腦。想要長期維護,我更建議從官方專案建立環境,再自行補一個最小橋接層。
WebSocket failed 怎麼排查
- 先確認服務真的啟動。7860、8010 與 8090 是不同服務,瀏覽器頁面存在不代表後端 WebSocket 已連線
- 檢查 WSL 網路。修改
.wslconfig後一定要執行wsl --shutdown,鏡像網路與hostAddressLoopback才會重新載入 - 確認 Windows 防火牆。先只開必要 TCP 埠,在同一台電腦測通後再處理區網
- 不要混用 localhost。容器、WSL 與 Windows 各自看到的
127.0.0.1可能不是同一個服務 - 確認瀏覽器麥克風權限。遠端網頁通常需要 HTTPS 或 localhost 才能取得安全的麥克風權限
- 降低 Noise Gate。如果網頁已連線但偵測不到聲音,先關閉門檻測試,再逐步調高
- 調整 VAD 停頓。約 900 到 1200 毫秒比較不容易搶話,但設定越長,回答開始時間也越慢
可以改成真正的 3D 角色嗎
可以,但不是把 Wav2Lip 模型換成一個 3D 檔案就完成。現在這條路線以 2D 影像或待機影片為基礎,口型模型直接修改臉部像素。真正的 3D 角色需要另外加入 Unity、Unreal Engine 或 WebGL renderer,再把 TTS 音訊轉成 viseme、音素或 blendshape 權重,驅動角色的嘴型、表情、眼神與骨架。
保留 VAD、Whisper、Qwen3 與 Qwen3-TTS,替換最後一層即可。新的輸出流程會變成 TTS 音訊、音素時間軸、3D blendshape、即時 renderer。若只是想讓角色有更豐富動作,可以先使用 LiveTalking 的自訂動作設定或多段待機素材,成本會比完整 3D 低很多。
本地不等於沒有風險
角色資料、聲音與對話都留在本機,確實能降低資料送往雲端的風險。但只要把服務開到區網或公網,就要重新考慮驗證、連接埠、惡意音訊、提示注入與檔案上傳。對話記憶也不是安裝完成就會永久存在,長期記憶需要另外接資料庫、摘要或向量檢索,否則聊天變長後仍可能忘記前文或開始胡亂延伸。
LiveTalking 官方也明確要求,使用此專案製作並發布到平台的內容必須包含 LiveTalking 浮水印與標誌。正式商用前要再確認每個模型、角色素材、聲音和整合程式的授權,不要只看程式能不能跑。
官方資源與參考資料
FAQ
8GB 顯存真的可以跑本地 AI 數位人嗎
可以做出可用版本,但不適合讓 14B LLM、large-v3、1.7B TTS 與口型模型全部以高規格同時常駐。建議改用 Qwen3-8B 或 4B 量化版、較小 TTS、較低 batch,必要時把部分模型放到 CPU。
可以完全離線,不使用任何 API 嗎
可以。前提是 STT、LLM、TTS 和數位人全部使用本地後端,而且模型與依賴已下載完成。設定 HF_HUB_OFFLINE=1 並在斷網環境測試,才能確認沒有隱藏的雲端依賴。
可以用英文或其他語言聊天嗎
可以,但 STT、LLM 與 TTS 三層都要支援目標語言。Whisper 與 Qwen3 的多語能力較完整,最終自然度通常由 TTS 音色與參考音訊決定。中英混合時要額外測試專有名詞、數字與語速。
Mac 可以照這篇安裝嗎
不能原封不動照做,因為本文整合路線依賴 Windows、WSL 與 CUDA。llama.cpp、Whisper 和部分 speech-to-speech 元件可以改走 Apple Silicon 的 Metal 或 MLX,但 LiveTalking 口型模型與整合腳本需要另外確認 macOS 支援,不能直接套用 NVIDIA 命令。
最後怎麼選
如果只是想快速聊天,雲端語音助手會更省時間。如果需求是讓私人對話留在本機、建立固定角色、接自己的資料或研究數位人介面,這套模組化管線就很值得做。我的建議是先讓文字對話跑通,再加入 STT 和 TTS,最後才接 LiveTalking。一次啟動所有元件,只會讓錯誤來源變得難以判斷。
真正值得學會的不是某個一鍵包,而是知道聲音在哪裡變成文字,回答在哪裡生成,音色在哪裡被控制,口型又由哪一個服務驅動。把這五層拆清楚後,未來換模型、換角色、換前端,整套系統仍然能繼續使用。
近期留言