
掃描文件最麻煩的地方,常常是字認對了,資料卻還不能用,雙欄報告左右串行、表格欄位錯位,或公式漏了一個上下標,都可能讓後面的搜尋、整理與分析出錯。
Unlimited-OCR-2 值得測試的地方,是把文字、版面與跨頁關係一起處理,尤其繁體直排、模糊掃描與破損表格。
內容目錄
Unlimited-OCR-2 是什麼?
百度於 2026 年 10 月 27 日公開 Unlimited OCR 2,有約 33 億參數的文件解析模型,官方提供模型權重與程式碼,採用 MIT 授權,工作重點包含版面區塊、表格與長文件的連續解析。
第二代引入 SR-SWA,減少長序列中重複的注意力計算,名稱裡的 Unlimited 指向長文件處理的設計方向,不代表沒有顯存、時間與輸出長度限制,也不保證每一頁都正確。
還有一個容易混淆的地方:官方後處理文件說明,模型原始輸出是帶有頁面、區塊類型與座標的結構標記,再由程式轉成 Markdown。表格可能保留 HTML,圖表也可能以圖片區塊呈現,不能把漂亮的預覽畫面直接當成完整的資料擷取結果。
七種文件情境,應該分別看什麼?
這組RTX A6000 公開樣例涵蓋掃描頁、雙欄、表格、公式、模糊掃描、繁體直排與中日韓混排。多數案例呈現可用的辨識結果,但部分材料為合成文件,也沒有提供完整人工標註與正式準確率分數。以下把樣例表現與實際驗收重點一起整理。
一般掃描頁與多頁 PDF
單頁掃描書頁呈現了文字與公式的解析結果,10 頁 PDF 則抽查了前幾頁與末頁,一般橫排書頁適合用來檢查漏字、標點與段落切分,擴大到多頁後,還要檢查頁數有沒有對上、末頁是否完整,以及頁首頁尾是否混進正文。某一頁成功,並不能直接推論整本書都會成功。
雙欄研究報告:先確認閱讀順序
雙欄報告樣例能依欄位提取正文,並呈現表格內容,雙欄最怕同一行的左右文字被接在一起。驗收時要看左欄能否先讀完,再接右欄,並檢查跨欄標題、插圖與頁面底部的接續位置。若後續要接知識庫,這一步會直接影響段落切分與搜尋結果。
複雜表格:文字與結構要分開核對
複雜表格樣例呈現了接近原有結構的輸出,表格上下的正文也有被分開,表格內的數字都出現,仍可能因欄位錯位而失去意義,應該另外檢查多層表頭、合併儲存格、空白欄位、單位,以及表格上下的正文有沒有被誤併進去,跨頁表格還要確認續表是否接對,而不是只看畫面像不像一張表。
數學公式與圖表:能顯示,不等於語義正確
公式與表格混合的樣例呈現了可辨識的公式輸出與流程圖區塊,公式要核對分數、根號、上下標、括號與變數,即使 LaTeX 能渲染,也可能少一個負號,圖表則應區分「找到圖片位置」與「抽出座標軸和數據」兩件事。
模糊掃描:不把合理的補字當成原文
模糊掃描樣例中,末頁的小字仍有被辨識出來。不過低解析度、陰影與斷裂格線,都應拿來做獨立的難例測試。模型可能產生看似合理的內容,但格線破損時是否仍正確還原儲存格,不能靠單一展示判定。若連人眼都無法確認,應留下待核對標記或重掃,避免把推測寫回正式資料。
繁體直排:認字之外,還有欄序
繁體直排樣例出現了明確的順序問題:字詞與標點有被辨識,但原本由右向左排列的欄,被按照由左向右輸出,末句因此跑到前面。後處理若要修正,應依區塊座標調整欄序,保留欄內由上到下的順序,並另外檢查夾註。
繁體直排要分別檢查字形與閱讀方向,即使每個字看起來都對,若欄序或上下順序錯了,文章依然讀不通,古籍還可能混有小字註解、異體字與夾註,適合獨立建立測試集,不與現代橫排文件共用一個結論。
中日韓混排:同頁切換語言也要抽查
中日韓同頁、雙欄排版的樣例呈現了三種語言的提取結果,混排文件應檢查相似字形、標點與段落邊界,尤其中文漢字與日文漢字容易讓人工略讀時忽略錯誤,建議準備少量人工校對的參考文字,再搭配原件確認閱讀順序,才能知道它是否適合你的材料。
RTX A6000 的樣例速度,要怎麼解讀?
公開 A6000 測試提供了兩個時間參考。這些是特定文件與設定下的觀察,部分複雜材料屬於合成樣例,不是固定每頁速度、通用準確率,或其他顯卡的效能保證。
| 測試樣例 | 頁數 | 任務耗時 | 平均每頁(計算值) |
|---|---|---|---|
| 單頁掃描書頁 | 1 | 約 2.6 秒 | 約 2.6 秒 |
| 多頁 PDF | 10 | 約 39.7 秒 | 約 3.97 秒 |
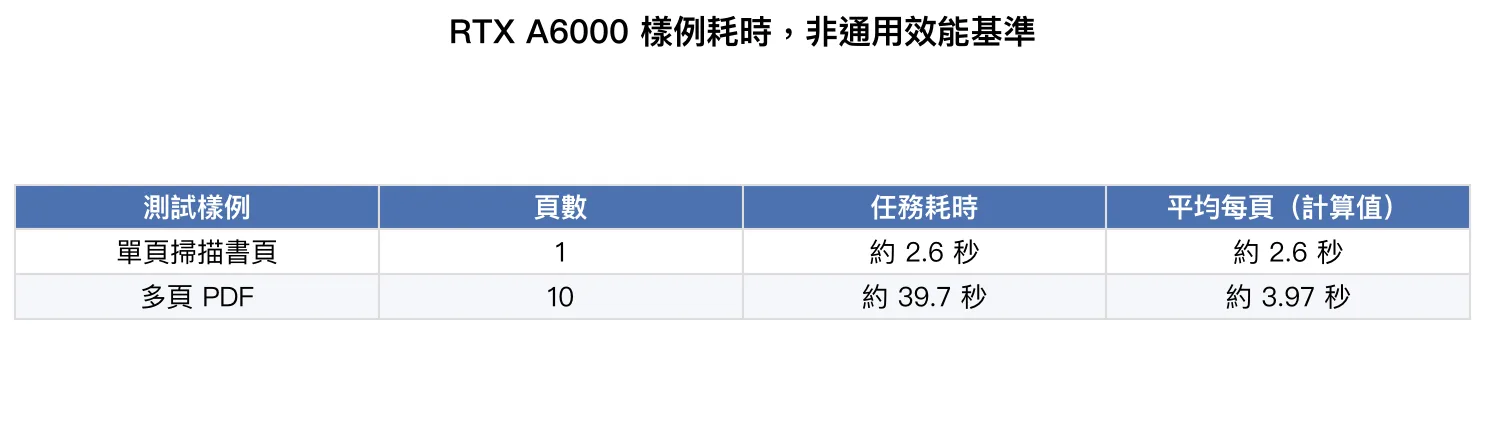
依工作台的測量口徑,上表的任務耗時包含頁面準備與模型請求,不含上傳與排隊,另有一項推理請求耗時,包含模型端排隊、視覺預處理與生成,並非純解碼時間。整卡顯存也包含預留池與其他程序,比較 Base 與 Gundam 時,應固定輸入、DPI、輸出預算與預熱狀態,分開記錄 PDF 轉圖和模型請求時間。
本地部署:先分清楚模型與 Web UI
模型本身提供 Transformers 與定製 SGLang 路徑,若想要在瀏覽器上傳文件、逐頁對照原圖與結果,可以使用作者公開的Unlimited OCR 2 Web UI,它是獨立封裝,並非百度模型內建的完整桌面軟體。
以下依專案部署文件整理 SSH 隧道路徑,原專案驗證環境是 Ubuntu 22.04 x86_64、RTX A6000 48GB、Python 3.11 與 cu130,48GB 是測過的配置,不是最低顯存要求。DGX Spark 的 ARM64 也不在這份部署驗證範圍內,不能直接沿用為已驗證流程。
準備獨立部署目錄與環境
在已具備相容 NVIDIA 驅動與 sudo 權限的專用 Ubuntu 22.04 x86_64 主機上執行。先確認 Git 和 Python 可用,再取得固定版本,避免依賴隨主分支變動。預檢若未通過,先依輸出確認作業系統、GPU 與既有服務,不要略過檢查硬裝。
sudo apt-get update
sudo apt-get install -y git python3
mkdir -p "$HOME/AI"
cd "$HOME/AI"
git clone https://github.com/win4r/unlimited-ocr2-webui.git
cd unlimited-ocr2-webui
git checkout f94c26f89b9dba24d8ae7bc67a7b640f682d4b4f
python3 scripts/preflight.py --strict
export DEPLOY_ROOT="$PWD"
bash scripts/install_system_packages.sh
bash scripts/bootstrap.sh
"$HOME/.local/bin/uv" pip check --python .venv/bin/python
python3 scripts/download_model.py --output models/Unlimited-OCR-2
.venv/bin/python scripts/create_examples.py
這條路徑使用專案的完整依賴鎖與定製 SGLang wheel。不要把它與官方 Transformers 範例的套件版本混裝在同一個環境。下載器固定模型快照並檢查權重,首次啟動還會載入模型與編譯核心,這段等待應與後續正式測速分開。
分別啟動模型與瀏覽器介面
在 GPU 主機開兩個終端,讓兩個服務各自保持執行。第一個啟動模型:
cd "$HOME/AI/unlimited-ocr2-webui"
export DEPLOY_ROOT="$PWD"
bash scripts/start_model.sh
第二個啟動 Web UI:
cd "$HOME/AI/unlimited-ocr2-webui"
export DEPLOY_ROOT="$PWD"
export UOCR_MODEL_URL=http://127.0.0.1:10000
bash scripts/start_web.sh
若瀏覽器在另一台電腦,於那台電腦建立 SSH 隧道。將 GPU_USER 與 GPU_HOST 換成自己的帳號與主機位置:
ssh -N -L 17860:127.0.0.1:7860 GPU_USER@GPU_HOST保持隧道開啟,在瀏覽器開啟 http://127.0.0.1:17860。若瀏覽器就在 GPU 主機,則使用 http://127.0.0.1:7860。這個啟動方式沒有設定開機自動執行,終端結束後服務也會停止。
先跑一份測試文件,再放入自己的樣本
模型就緒且 Web UI 啟動後,在 GPU 主機的第三個終端執行專案的單頁驗收:
cd "$HOME/AI/unlimited-ocr2-webui"
.venv/bin/python scripts/smoke_test.py --example mixed-single.png
這會檢查任務是否完成、頁數、已知文字、Markdown 與警告。通過只代表這份樣例與部署鏈路可用。接著用自己的雙欄、表格與直排樣本逐項核對,再考慮批次處理。介面可選的頁數上限,也不等於專案已在任意相同頁數的文件上驗證成功。
拿到結果後,怎麼判斷能不能用?
- 文字。選幾頁製作人工參考答案,記錄錯字、漏字與多字。若計算 CER,應保留相同的空白與標點處理規則。
- 結構。另外核對欄序、合併儲存格、跨頁接續、公式與圖片位置。CER 不能代替這些檢查。
- 完整性。看頁數、最後一頁、警告與原始輸出,不能只看任務顯示完成。
- 交付。確認匯出的格式能被後續工具讀取,並保留原件與抽查紀錄,方便回查。
如果你原本就在整理 PDF,可以先了解Docling 的文件解析流程。對已有文字層的 Office 或 PDF,則可先檢查是否能用MarkItDown 轉成 Markdown,再把真正需要辨識的頁面交給 OCR,避免每種文件都走同一條路。
若後續要接RAG 與 Agent 工作流,先把解析品質顧好。來源段落若已串行或表格欄位錯位,後面的檢索與回答也可能跟著出錯。
適合什麼工作?先用自己的文件決定
有重複的掃描件、需要批次處理或想掌握本地流程時,Unlimited-OCR-2 是值得評估的選項。偶爾只處理幾頁,也可以比較現成工具與多模態服務的總成本。比較時除了呼叫費用,還應納入安裝、維護、校對時間與錯誤後果。
我的建議是先挑少量、涵蓋實際難點的文件,把原件與結果並排檢查。雙欄要看順序,表格要看結構,公式要看符號,直排要看欄序。確認這一小批可用後,再逐步擴大規模。作者的公開專案首頁與部署資源也可供後續查閱。
常見問題
Unlimited-OCR-2 能直接讀 PDF 嗎?
部署工具可以接收 PDF,再把各頁渲染成圖片交給模型。因此輸入是 PDF,不代表模型只在讀取 PDF 文字層。掃描 PDF 與圖片都可以成為 OCR 的輸入來源。
表格線斷掉,模型會自動補回正確結構嗎?
不能保證。缺失格線可能影響儲存格分割與合併判斷,需要對照原件核對。能產生一張表,不代表每個數字都落在正確欄位。
繁體直排只要字認對,就算成功嗎?
還要檢查閱讀方向、欄序與註解位置。字形正確但順序錯亂,仍會影響正文理解與後續搜尋。
33 億參數代表一般顯卡一定跑得動嗎?
不能只靠參數量判斷。還要考慮推理框架、頁面解析度、視覺切片、輸出預算與顯存預留。A6000 48GB 是公開部署的驗證配置,不是最低需求。
OCR 結果可以直接拿來批改作業嗎?
文字與公式辨識只是前段。批改還需要題意理解、評分規則、解題驗證與人工複核,不能把辨識成功直接視為評分可靠。