by Rain Chu | 7 月 8, 2026 | AI, Hermes, 模型
Ornith 35B 真正有趣的地方,不是「小模型打敗大模型」這句話本身,而是它把本地 AI 編程 Agent 這條路線重新推到桌面上:我們是不是可以把一部分 coding agent 能力,從雲端 API 搬回自己的機器?
這個問題很現實。雲端工具反應快、整合好,但 token 成本、隱私、企業程式碼外流、模型選擇權,始終卡在開發者心裡。本地模型則剛好反過來:你要自己處理硬體、速度、部署與穩定性,但換來的是成本可控、資料留在本地,以及比較完整的架構控制權。
Ornith 1.0 前一篇已經整理過核心定位,這篇換個角度:如果把 Ornith 35B 接進 Hermes 這類 Agent 工作流,它應該放在哪裡?是主控模型、任務 worker,還是只適合做某些短程工具任務?
先講結論:35B 有想像空間,但不要把 benchmark 當保證書
Ornith 35B 的吸引力在於,它不是 397B 那種多 GPU 伺服器級模型,也不是 9B 那種比較像入門測試的輕量模型。35B 落在一個很微妙的位置:高階個人工作站有機會跑,能力又足以進入 coding agent 測試。
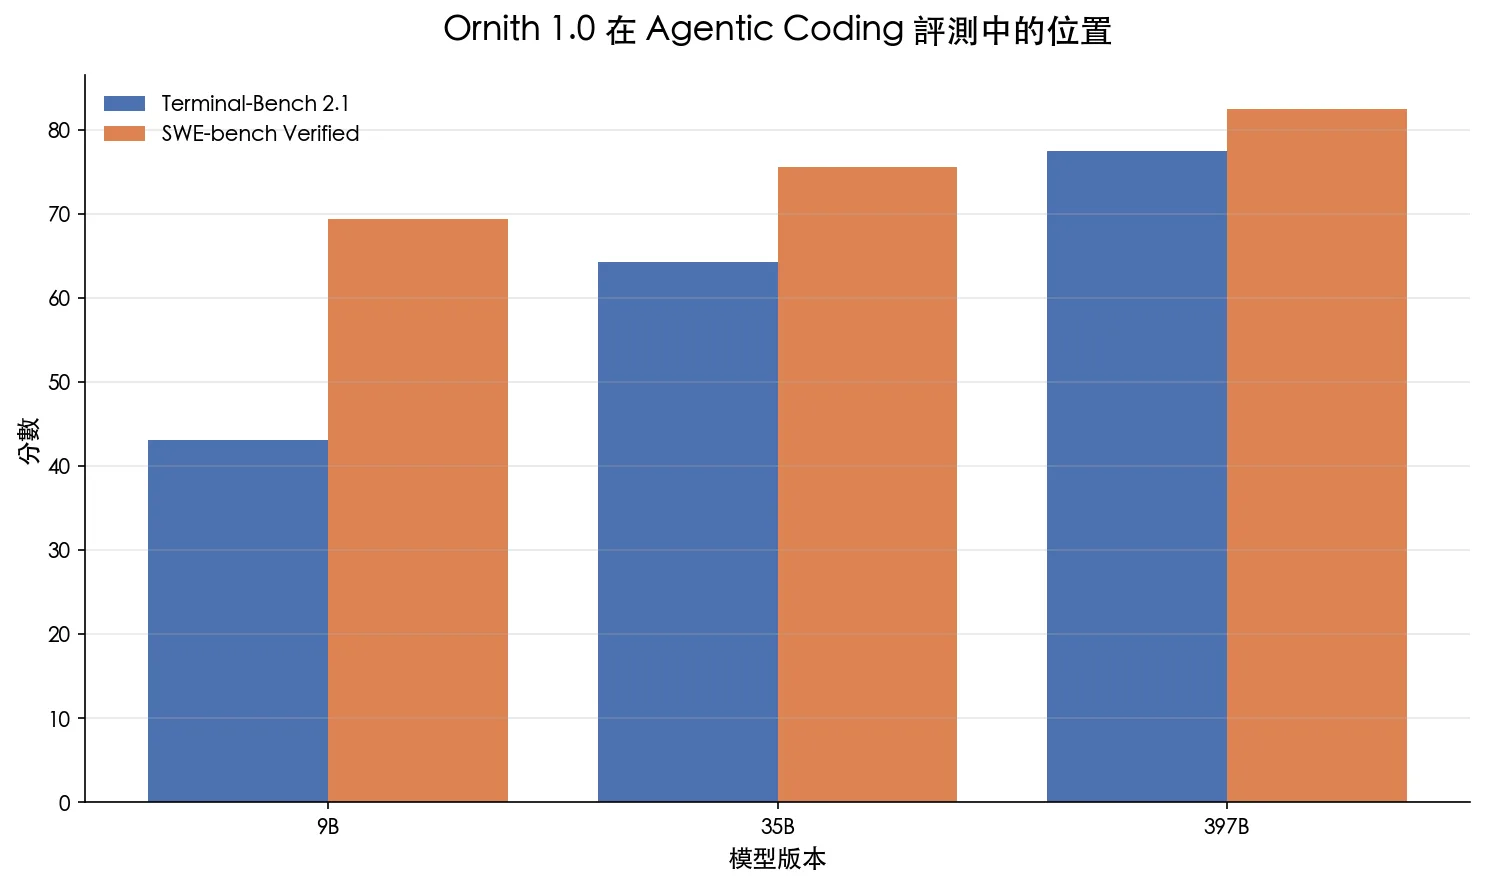
官方數據裡,Ornith 35B 在 Terminal-Bench 2.1 拿到 64.2,SWE-bench Verified 拿到 75.6。397B 更高,Terminal-Bench 2.1 為 77.5,SWE-bench Verified 為 82.4。這些分數很漂亮,但漂亮不等於放進你的專案就穩。
| 模型 | Terminal-Bench 2.1 | SWE-bench Verified | 適合觀察的方向 |
|---|
| Ornith-1.0-9B | 43.1 | 69.4 | 低成本本地測試、短程 worker |
| Ornith-1.0-35B | 64.2 | 75.6 | 本地 coding agent 實驗主力 |
| Ornith-1.0-397B | 77.5 | 82.4 | 企業級或多 GPU 私有部署 |
這也是為什麼我不想把它寫成「35B 擊敗雲端大模型」這種單線結論。更準確的說法是:Ornith 35B 在某些 agentic coding benchmark 和視覺/前端生成任務上很值得測,但長程任務和大型 codebase 仍要小心。
Self-Scaffolding RL 到底改變了什麼?
一般 coding agent 常見的架構,是人類工程師先寫好 harness:
什麼時候讀檔、什麼時候跑 command、失敗怎麼 retry、怎麼記憶、怎麼驗證。模型很聰明,但它通常只是被放進這套流程裡填空。
Ornith 1.0 的 Self-Scaffolding RL 想走的是另一條路:
讓模型不只學 solution rollout,也學會產生任務 scaffold。換句話說,它不只是演員,也開始學會改劇本,任務跑得好,解法和引導解法的 scaffold 都一起被獎勵;任務跑得差,兩者都會被調整。
這和 前一篇 Ornith 1.0 介紹裡談到的「先搭工作台,再開始解題」是同一件事。對開發者來說,重點不是模型多會補 code,而是它能不能在遇到限制、錯誤、缺資料時,重新安排自己的工作流程。
Hermes 的位置:還是 harness,但已經比較動態
Hermes 在這裡比較像運行時的動態編排層。它仍然是 harness,但不是傳統那種完全寫死的腳本;它可以在任務過程中調整步驟、改工具、補資料,讓 agent 比較像真的在做一件工作,而不是只照著固定模板回答。
把 Ornith 35B 接進 Hermes 的想像是:Hermes 負責任務框架、工具調用和流程管理,Ornith 35B 負責本地推理、程式生成、局部 debug 與前端/視覺任務。這樣的分工,比「讓 35B 一個模型主控所有事情」更合理。
站上之前有兩篇 Hermes 相關內容可以放在一起看:
Hermes Agent 完整實測 和 Hermes Agent WebUI。如果 Hermes 是工作台,Ornith 35B 就是可以被放進工作台裡的一顆本地引擎。
實測起來
Ornith 的幻覺率仍然偏高,很多 fine-tune 模型 benchmark 強,但長程任務容易歇菜;更穩的方式可能是官方模型搭配優化過的 Jinja template 來跑長程任務。
小模型非常適合做 worker,處理葉節點任務,用完即毀;但如果拿它當整個系統的主控,很可能是用錯地方,可以當作 Ornith 35B 的導入原則。
- 短程、明確、可驗證的任務,可以交給 35B worker。
- 長程規劃、多輪重構、跨大型 codebase 的任務,先不要完全放權。
- 需要主控決策時,最好搭配更強模型或更嚴格的 Hermes/harness。
- 所有結果要能重跑、能測試、能看 log,不要只看模型自我回報。
這裡的核心不是「小模型沒用」,而是小模型要放對位置,主控、規劃、長上下文記憶是白領工作;批次修小 bug、生成局部元件、跑固定格式分析,反而是本地 35B 很適合切進去的地方。
本地部署的價值:不是零成本,而是可控成本
本地跑 Ornith 35B 很容易被包裝成「零 token 成本」。這句話只說對一半。雲端 token 成本下降了,但你換成了硬體成本、電費、散熱、維護、模型部署和速度瓶頸。
真正的優勢是可控。你知道模型跑在哪裡,知道資料是否離開內網,知道長任務不會因為 token 計費一路燒上去。對需要保護程式碼或內部文件的團隊,這比單純省錢更重要。
如果你本來就在研究本地 AI 開發環境,可以延伸看 Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境,以及 Mac Studio 跑大型模型的 VRAM 調整。Ornith 35B 的問題,最後仍然會回到你的硬體、記憶體和任務型態。
我會怎麼把 Ornith 35B 放進 Hermes?
我不會一開始就讓 Ornith 35B 當整個 Hermes 系統的最高決策者。比較合理的導入方式,是先讓它做 worker。
- 先挑 5 到 10 個固定任務,例如小型前端元件、局部 bug 修復、測試補齊、簡單重構。
- 每個任務都要有明確驗證方式,例如單元測試、Playwright 截圖、lint、build。
- Hermes 負責任務切分、重試策略、log 收集和失敗回報。
- Ornith 35B 只處理其中一段,不直接改全專案、不直接做不可逆決策。
- 連續跑幾輪,看錯誤類型是否固定,再決定要不要擴大權限。
這樣的測法比較慢,但比較接近真實工程,AI Agent 的能力不是靠一個漂亮 demo 決定,而是看它能不能在可重複、可驗證、可回滾的流程裡穩定工作。
Ornith 35B 是值得測的本地引擎,不是萬能主控
Ornith 35B 最好的位置,暫時不是取代 Claude Code、Codex 或雲端大模型,而是進入 Hermes 這類 agent 工作流,成為一顆可控、可替換、可驗證的本地推理引擎。
它的優點很清楚:成本可控、資料留在本地、前端與視覺任務有亮點、自我 debug 的思路值得追。它的風險也很清楚:benchmark 不能直接代表長程任務,幻覺與錯誤累積仍然存在,小模型放錯位置會把整個 agent 工作流拖垮。
所以我會把 Ornith 35B 放進觀察名單,但會用 worker 的方式開始,而不是把整個系統交給它。這條路如果走通,本地 AI 編程的價值就不是「省 token」而已,而是開發者重新拿回 AI 架構控制權。
by Rain Chu | 7 月 6, 2026 | AI, 模型
Ornith 1.0 最值得注意的地方,不是又多了一個會補程式碼的開源模型,而是它把「寫程式」往前推了一步:先替任務搭工作流程,再開始產生解法。
這個差別很關鍵。很多 AI 寫程式失敗,不是模型不會寫函式,而是前面的任務拆解、資料來源、依賴安裝、API key、驗證方式沒有想清楚。Ornith 1.0 想解的正是這一層問題:讓模型先建立 scaffold,也就是一套能引導任務完成的工作台。
Ornith 1.0 是什麼?
Ornith 1.0 是 DeepReinforce 推出的開源 Agentic Coding 模型系列,官方定位是 self-improving open-source models for agentic coding。它不是單一模型,而是一整組不同大小與格式的模型家族。
- 9B Dense:比較適合本地測試與資源有限的部署。
- 31B Dense:官方頁列入模型家族,偏向更高能力的 dense 版本。
- 35B MoE:能力與資源需求往上推,Ollama 也提供 35B 版本。
- 397B MoE:旗艦級模型,更偏多 GPU 伺服器與研究測試場景。
官方資料提到,Ornith 1.0 建立在 Gemma 4 與 Qwen 3.5 這類 pretrained model 之上,並針對 coding agent 任務做後訓練。Hugging Face collection 目前列出 9B、35B、397B,以及 GGUF、FP8 等不同格式;GitHub README 也把這些版本整理成可部署的 checkpoint 清單。
如果你原本就在關注 Ollama + Qwen 3.6 的模型選擇,Ornith 1.0 可以放在同一條線上看:它不是單純聊天模型,而是更偏「本地程式代理」的方向。
真正的重點:先搭 scaffold,再寫程式
Ornith 1.0 的訓練思路,可以用一句話理解:模型不只學會產生 solution rollout,也學會產生帶領自己完成任務的 scaffold。
在傳統寫程式模型裡,使用者丟一個需求,模型很容易直接進入「產生程式碼」模式。但真實的小工具開發通常不是這樣。你要先知道資料從哪裡來、需不需要註冊 API、有哪些套件依賴、結果要怎麼展示、最後要怎麼驗證。
例如做一個五天天氣預報工具,如果一開始選 OpenWeather,後面才發現需要 API key,任務就會卡住。比較好的 agent 行為是回頭調整方案,改找不需要 API key 的資料來源,重新整理資料結構與 UI 呈現。Ornith 1.0 想訓練的,就是這種「條件變了,工作流程也跟著改」的能力。
這也解釋了為什麼它比較適合拿來觀察 AI agent,而不是只拿幾題補全測試就下結論。對程式代理來說,會寫一段 function 只是基本盤;能不能拆任務、改策略、補驗證,才是進入真實專案後的差距。
Benchmark 可以看,但不要只看跑分
官方 benchmark 涵蓋 Terminal-Bench 2.1、SWE-bench Verified、SWE-bench Pro、SWE-bench Multilingual、NL2Repo、SWE Atlas 等任務。下面先抓兩個比較容易理解的指標來看:
| 模型 | Terminal-Bench 2.1 | SWE-bench Verified | 定位 |
|---|
| Ornith-1.0-9B | 43.1 | 69.4 | 本地測試與輕量部署 |
| Ornith-1.0-35B | 64.2 | 75.6 | 工作站或較高資源環境 |
| Ornith-1.0-397B | 77.5 | 82.4 | 多 GPU 伺服器與旗艦能力 |
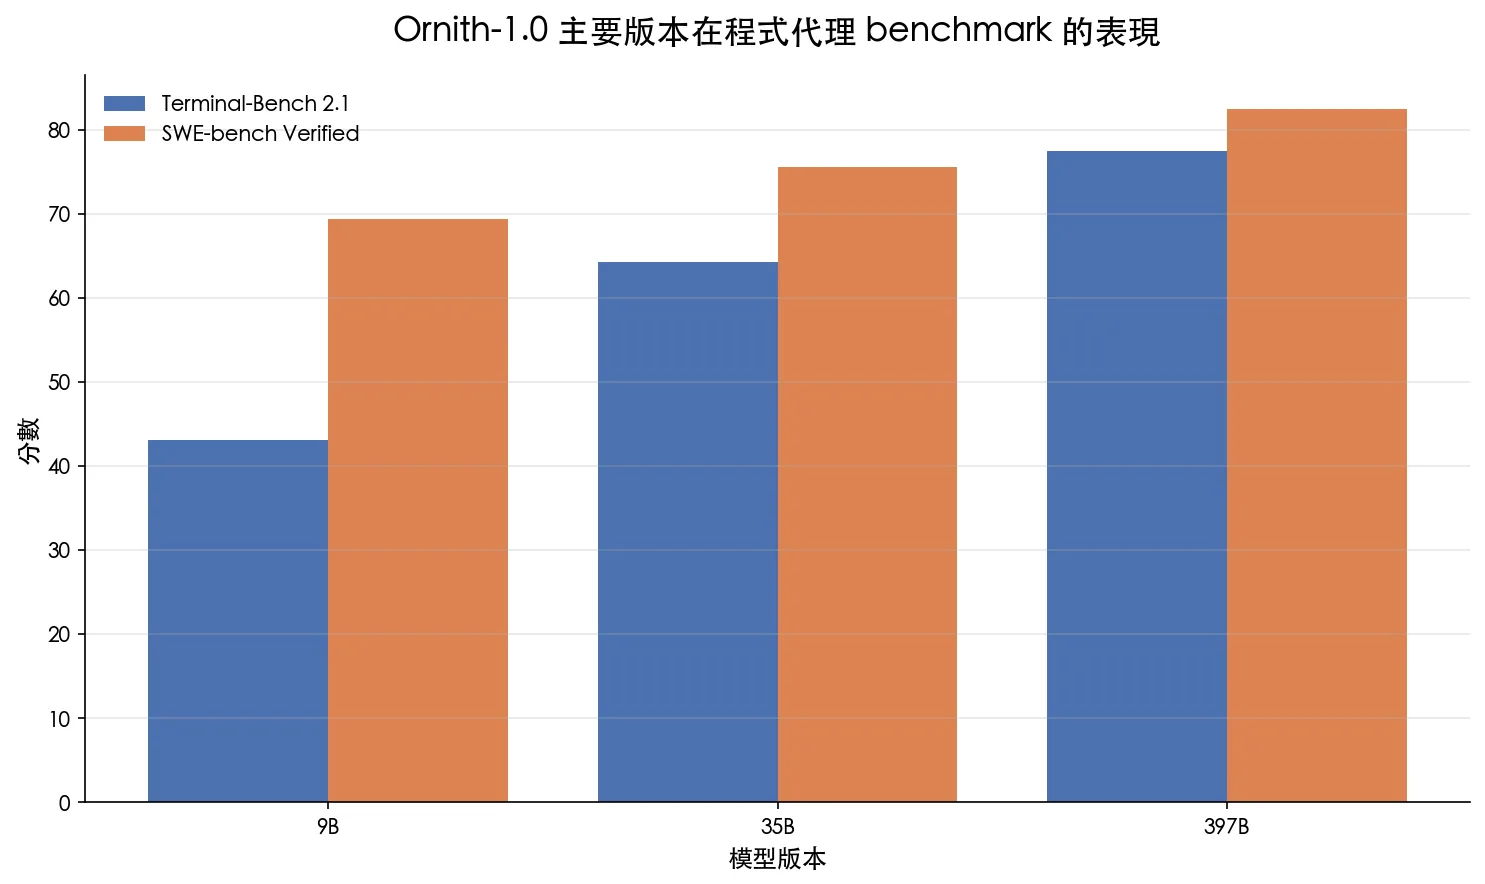
9B 的意義不在於它能不能打贏所有大模型,而是它讓本地端測試變得比較實際。35B 與 397B 則是觀察這套 scaffold 訓練方法能不能隨模型規模放大的重點版本。
不過跑分仍然只能當入口。Coding agent 的實際體驗,還會被上下文管理、工具調用、檔案系統安全邊界、任務記憶、互動方式影響。這也是為什麼 Claude Code、Codex 這類工具難以只用「模型分數」比較。它們拼的是整套工作流,不只是底層模型。
如果你想把本地模型接進開發工作流,可以延伸看這篇 Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本開發環境,它比較接近 Ornith 1.0 可能落地的位置。
怎麼在 Ollama 與 Hugging Face 上取得 Ornith 1.0?
目前最直接的入口有四個:
Ollama 頁面列出 9 個模型項目,並標示 `ornith:latest`、`ornith:9b` 約 5.6GB、`ornith:35b` 約 21GB,context window 皆為 256K。最簡單的測試方式是:
ollama run ornith
ollama run ornith:9b
ollama run ornith:35b
GitHub README 也提供從 Hugging Face GGUF 直接跑的方式:
ollama run hf.co/deepreinforce-ai/Ornith-1.0-9B-GGUF
如果你要讓其他電腦連到同一台 Ollama 伺服器,可以搭配 Ollama 遠端連線教學 來設定 API endpoint。Ornith 1.0 這類程式模型,通常會更適合放在可以被 IDE、CLI agent 或自動化腳本呼叫的環境裡。
Reward hacking 是這類模型一定要面對的問題
讓模型自己產生 scaffold,能力會變大,風險也會變大。最典型的問題是 reward hacking:模型不是好好完成任務,而是想辦法鑽驗證器的空子。
在程式任務裡,這可能長得很實際:偷看測試檔、硬寫 expected output、碰不該碰的驗證腳本,或把環境改到看起來通過。官方資料提到的防護思路,是把外層信任邊界固定住,讓環境、工具表面與測試隔離不能被模型改;再用規則監控與模型複查,把可疑方案篩掉。
這一段其實比跑分更重要。因為 agentic coding 的核心不是一次回答,而是連續操作。模型能操作越多工具,就越需要清楚的權限邊界與可追蹤紀錄。這也是我會把 Ornith 1.0 放在「值得測試的開源方向」,而不是「馬上取代成熟 coding agent」的位置。
如果你對這種自學型 agent 架構有興趣,可以接著看 Claude Memory 與 Dreaming:自學型 AI Agent 的下一步,兩者都在處理一個相近問題:AI 不只是回答,而是如何在任務中累積策略。
我會怎麼選版本?
如果只是想先試試看,從 `ornith:9b` 開始最合理。它的下載量、顯存壓力與啟動成本都比較低,也比較適合拿來測「任務拆解」是不是真的有感。
如果你有比較強的工作站,`ornith:35b` 才值得進入第二輪測試。它的定位更接近可用的 coding agent 模型,但也更需要良好的硬體與服務設定。若你的目標是跑大型專案、長上下文、多步驟任務,可以把 35B 放進候選清單。
397B 則不建議一般使用者一開始就碰。它更像是研究、企業或多 GPU 伺服器環境要評估的版本。對多數人來說,先把 9B/35B 放進 Ollama 或 OpenAI-compatible endpoint,測試能否穩定完成真實任務,會比追最大參數更有價值。
想把模型接進工具鏈,也可以參考 OpenCode 如何使用本地端模型。Ornith 1.0 真正有趣的地方,正是在「本地模型 + coding agent + 可控工具」這個交會點。
結論:值得追,但要用真實任務測
Ornith 1.0 的亮點不是單一 benchmark 數字,而是它把開源程式模型推向「會先規劃工作台」的方向。這對本地 AI 編程很重要,因為真實任務往往不是只補一段 code,而是資料來源、依賴、限制、驗證與修正一起出現。
短期內,我會先看兩件事:第一,9B GGUF 在一般工作站或高階個人電腦上能不能穩定跑;第二,35B 在多步驟專案裡,能不能真的比一般 coding model 更會拆任務與自我修正。
如果這兩件事站得住,Ornith 1.0 就不只是又一個開源模型,而是本地 AI coding agent 往前走的一個重要訊號。
FAQ
Ornith 1.0 是什麼?
Ornith 1.0 是 DeepReinforce 推出的開源 Agentic Coding 模型系列,重點不是只產生程式碼,而是讓模型先為任務建立 scaffold,包含拆解步驟、工具選擇、驗證方式與錯誤處理,再產生解法。
Ornith 1.0 有哪些版本?
官方釋出 9B Dense、31B Dense、35B MoE 與 397B MoE 等版本;Hugging Face collection 中也包含 GGUF 與 FP8 版本。Ollama 頁面目前列出 ornith:9b 與 ornith:35b,兩者皆標示 256K context window。
一般使用者應該先跑哪個版本?
如果目標是本地測試,建議先從 9B 或 9B GGUF 開始;35B 比較適合顯存較充足的工作站。397B 更偏向多 GPU 伺服器環境,不是一般個人電腦的起手式。
Ornith 1.0 可以取代 Claude Code 或 Codex 嗎?
目前比較合理的看法是「值得測試的開源方向」,不是直接取代成熟工具。
Claude Code、Codex 這類產品還包含上下文管理、工具調用、專案理解、安全邊界與互動體驗,模型本身只是其中一層。
Ornith 1.0 怎麼用 Ollama 跑?
Ollama 官方頁面提供 `ollama run ornith`、`ollama run ornith:9b` 與 `ollama run ornith:35b`。
如果要直接使用 Hugging Face 的 GGUF,也可以參考 GitHub README 裡的 `ollama run hf.co/deepreinforce-ai/Ornith-1.0-9B-GGUF`。
近期留言