by Rain Chu 7 月 28, 2026 | AI , 語音合成
VibeVoice 現在不能只理解成一個文字轉語音模型,它已經變成 Microsoft 的開源語音模型家族,包含長音訊語音辨識、即時串流 TTS、長篇多人 TTS,以及最新的 CPU 量化辨識版本,值得注意的地方,不只是能把文字念出來,而是它開始把「聽懂一小時內容」與「收到文字後立刻開口」做成兩條可以獨立部署的路線。
先講我的結論。如果要做會議轉錄、訪談整理或字幕,先看 VibeVoice-ASR。如果只有一般電腦,優先測試 VibeVoice-ASR-BitNet。如果要讓 Agent 邊產生答案邊說話,選 VibeVoice-Realtime-0.5B,至於能合成 90 分鐘、最多四人對話的 VibeVoice-TTS-1.5B,目前官方快速體驗仍標示為停用,不能把社群整合包的功能直接當成官方現況。
VibeVoice 四個版本怎麼選
模型 主要工作 適合場景 部署重點 VibeVoice-ASR-7B 長音訊轉文字 會議、訪談、字幕、多人對話 可一次處理最長 60 分鐘,完整模型需要較多 GPU 記憶體 VibeVoice-ASR-BitNet CPU 語音辨識 桌機、Mac、邊緣設備、離線轉錄 模型約 1.58 GB,不需要 GPU VibeVoice-Realtime-0.5B 即時文字轉語音 語音 Agent、即時旁白、串流回應 單一說話人,英文為主要目標,其他語言仍屬實驗 VibeVoice-TTS-1.5B 長篇多人語音合成 Podcast、有聲內容、多人對話 原始能力可達 90 分鐘與四位說話人,但官方程式與快速體驗目前停用
VibeVoice 的核心不是單純縮小模型
VibeVoice 使用聲學與語意連續語音 tokenizer,運作頻率只有 7.5 Hz,這代表模型不需要把長音訊展開成極密集的離散 token,處理長序列時比較節省,生成端再用 next-token diffusion,把語言模型負責的文字脈絡與對話流程,交給 diffusion head 補上聲學細節。
這個架構帶來兩個很實際的能力。ASR 可以在 64K token 長度內一次接收最長 60 分鐘音訊,輸出誰在什麼時間說了什麼。
Realtime TTS 則採用交錯的視窗設計,一邊接收新增文字,一邊延續前文產生聲音,讓 LLM 不必等完整答案寫完才開始說話。
如果正在組本地語音 Agent,可以把它放進 speech-to-speech 的 VAD、STT、LLM、TTS 管線 。VibeVoice-ASR 負責聽,Realtime 負責說,中間的 LLM 可以換成本地模型。這比把整套功能綁死在單一 App 裡更容易維護。
ASR 不只是逐字稿,還會分辨說話人
一般 Whisper 工作流常要再接一套 speaker diarization,才能把不同說話人分開。VibeVoice-ASR 把語音辨識、說話人分離與時間戳放進同一個輸出,直接得到 Who、When、What 的結構。對會議記錄、Podcast 整理、客服通話和長篇訪談,這比單純吐出一整段文字更有用。
它也支援自訂 hotwords,可以先提供人名、產品名、技術術語與背景資料,減少專有名詞被聽錯的機率。官方 Transformers 版本支援超過 50 種語言,也能處理語句內與語句間的語言切換。這讓 Python 整合不必依賴特定 WebUI。
VibeVoice 真的比 Whisper 快又準嗎
答案不是單純的「是」,Microsoft 公布的 CPU BitNet 測試中,在 AMD EPYC 7V13 上使用三條 CPU 執行緒時,RTF 為 0.77,已經快於即時播放速度,四條執行緒降到 0.63。Apple M4 使用四條執行緒的 RTF 為 0.43。這些結果證明 CPU 即時辨識成立,但不同處理器、音訊長度與編譯方式都會影響速度。
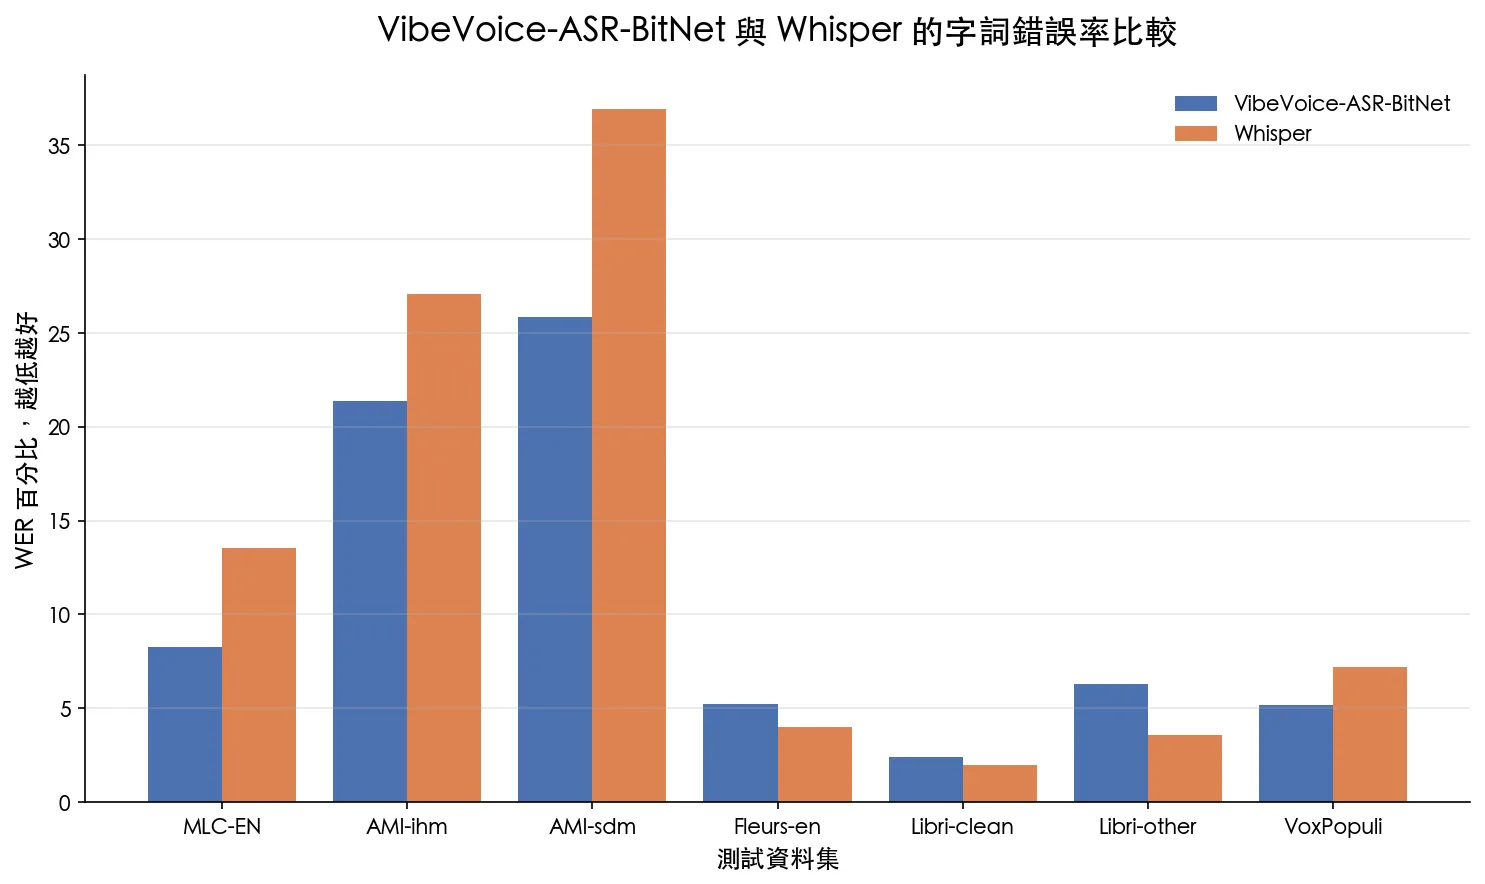
官方 WER 測試顯示兩個模型各有優勢,數值越低越好 準確率也要分資料集看。BitNet 在 MLC-EN、AMI-ihm、AMI-sdm 與 VoxPopuli 的 WER 低於 Whisper,但在 Fleurs-en、Libri-clean 與 Libri-other 則是 Whisper 較低。所以比較正確的說法是,VibeVoice-ASR-BitNet 在多說話人與部分長音訊測試很有競爭力,不能直接延伸成所有語言、所有錄音條件都勝過 Whisper。
如果目前的工作流已經大量使用 Whisper,可以先看我整理的 Whisper 本地語音辨識 ,再拿自己的中文會議、多人訪談與背景噪音資料做同一套測試。真正有意義的是自己的素材,不是只看單一排行榜。
最省硬體的做法,用 VibeASR.cpp 跑 BitNet
只想在 CPU 上完成轉錄,官方的 VibeASR.cpp 是目前最直接的路線。需要 Python 3.9 以上、CMake 3.14 以上,以及 GCC 或 Clang。Windows 需要 MinGW-w64,MSVC 目前不支援。
git clone --recursive https://github.com/microsoft/VibeASR.cpp.git
cd VibeASR.cpp
pip install -r requirements.txt
python setup_env.py
準備一個 WAV 音檔後,用四條 CPU 執行緒開始轉錄。
./build/bin/asr_infer \
  --vae-model models/vibeasr/vibeasr-vae-encoder-i8_s.gguf \
  --lm-model models/vibeasr/vibeasr-lm-i2_s-embed-q6_k.gguf \
  --audio input.wav -t 4
模型頁也提供 Ollama 的啟動方式。這條命令適合先快速取得模型,若要穩定處理音訊檔與調整執行緒,VibeASR.cpp 的 CLI 參數會更清楚。
ollama run hf.co/microsoft/VibeVoice-ASR-BitNet:Q6_K 用 Transformers 在 Python 呼叫 ASR
需要接進自己的 Python 程式時,使用 Transformers 5.3.0 以上的官方模型最乾淨。完整 ASR 權重較大,先確認顯卡記憶體與磁碟空間,不要把 Realtime 0.5B 的硬體需求套過來。
python -m venv .venv
source .venv/bin/activate
pip install transformers==5.3.0 accelerate soundfile
from transformers import AutoProcessor, VibeVoiceAsrForConditionalGeneration
model_id = "microsoft/VibeVoice-ASR-HF"
processor = AutoProcessor.from_pretrained(model_id)
model = VibeVoiceAsrForConditionalGeneration.from_pretrained(
model_id,
device_map="auto"
)
inputs = processor.apply_transcription_request(
audio="input.wav"
).to(model.device, model.dtype)
output_ids = model.generate(**inputs)
generated_ids = output_ids[:, inputs["input_ids"].shape[1]:]
result = processor.decode(generated_ids, return_format="parsed")[0]
for item in result:
print(item)
如果要讓多人共用,官方還提供 vLLM 外掛,對外開出 OpenAI 相容的 /v1/chat/completions 端點,並支援串流、長音訊、hotwords、資料平行與張量平行。這條路比較適合公司內部的集中式轉錄服務。
啟動 Realtime 0.5B 即時 TTS
Realtime 版本的價值是讓 LLM 還在產生文字時就開始發聲。官方資料寫的是約 200 毫秒產生第一段聲音,但實際聽到的時間還會加上網路與播放緩衝。官方測試中 NVIDIA T4 與 Mac M4 Pro 可以達到即時速度,這不代表每一台 Mac 或每張 6GB 顯卡都一定相同。
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
python -m venv .venv
source .venv/bin/activate
pip install -e ".[streamingtts]"
python demo/vibevoice_realtime_demo.py \
  --model_path microsoft/VibeVoice-Realtime-0.5B
Realtime 0.5B 目前只支援單一說話人,英文仍是主要目標。德文、法文、義大利文、日文、韓文、荷蘭文、波蘭文、葡萄牙文與西班牙文屬於實驗音色。中文長篇多人合成若來自社群分支或整合包,應分開標示版本與來源。想比較更偏聲音克隆的方案,可以延伸看 dots.tts 的 3 秒聲音復刻架構 ,若重點是音色設計,則可以看 Qwen3-TTS 的音色控制 。
文字正規化是長篇 TTS 的必做前處理
長篇語音最常見的問題不是音色,而是日期、金額、百分比、網址與特殊符號被念錯。輸入「2026/7/28」與輸入「二零二六年七月二十八日」,模型收到的任務並不相同。正式生成前應先清理 Markdown、程式碼、罕見符號與過度複雜的標點,再把數字轉成預期的口語形式。
from wetext import Normalizer

normalizer = Normalizer(lang="zh", operator="tn")
text = normalizer.normalize("2026年7月28日,版本 1.0")
print(text)
WeText 可以做中文、英文與日文的 TN 和 ITN。它不是萬能修正器,品牌名、縮寫與人名仍要自行建立字典。這一步也適合放在 Voicebox 本地 AI 語音工作室 這類批次工作流前面,避免同一個錯誤被大量生成。
安裝時最容易卡住的地方
PyTorch 裝成 CPU 版 :先用 python -c "print(__import__('torch').cuda.is_available())" 檢查,再依自己的 CUDA 版本重裝官方 PyTorch 套件。把所有版本當成同一套需求 :ASR-7B、Realtime-0.5B 與 BitNet 的模型大小和執行後端完全不同。把社群功能當成官方保證 :自訂音色、中文多人 TTS 與一鍵整合包要確認來源、commit 與安全性。忽略 FFmpeg :Gradio 與長音訊服務通常需要 FFmpeg 解碼,先確認 ffmpeg -version 能正常執行。直接丟進正式產品 :Microsoft 明確把目前版本定位在研究與開發用途,正式商用前要自行測試準確率、延遲、授權與風險。
我會怎麼選
VibeVoice 最有價值的不是某一個模型贏過所有對手,而是它把語音工作拆成幾個明確層級。只有 CPU 就用 BitNet。需要長音訊、說話人與時間戳,就用完整 ASR。需要 Agent 邊想邊說,就用 Realtime。需要中文音色克隆與更強的角色控制,則把 dots.tts、Qwen3-TTS 或其他本地 TTS 放進比較名單。
我特別喜歡 BitNet 這次的方向。它不是叫使用者為了語音辨識再買一張顯卡,而是透過量化與專用 CPU runtime,把模型帶回一般電腦。這種改進比單純把參數做大更接近真正能落地的本地 AI。
官方資源
FAQ
VibeVoice 可以完全離線使用嗎
可以。模型與依賴下載完成後,VibeASR.cpp、Transformers ASR 與 Realtime TTS 都可以在本地執行。第一次安裝與下載權重仍需要網路。
6GB 顯存可以跑所有 VibeVoice 模型嗎
不可以。6GB 是特定 TTS 或 Realtime 組合的實測條件,完整 ASR 權重需要更多資源。只有一般電腦時,CPU 版 BitNet 是更合理的起點。
VibeVoice-Realtime 支援中文嗎
官方目前仍把英文列為主要目標,另提供九種實驗語言,名單不含中文。社群版本可能加入中文或自訂音色,但要分開看待。
by Rain Chu 7 月 23, 2026 | AI , 語音分離 , 語音合成 , 語音辨識
Voicebox 最吸引我的地方,是它不是只做 TTS,也不是只做 Whisper 聽寫,而是把語音輸入、語音輸出、聲音克隆、故事編輯器、REST API 和 MCP server 放在同一個本地優先的工具裡。這讓 AI Agent 不只會回文字,也能用你指定的音色說話。
如果說過去的語音工具常常分成兩邊,ElevenLabs 偏輸出,WisprFlow 偏輸入,那 Voicebox 想做的是完整 voice I/O stack。更重要的是,它預設把模型、聲音資料和錄音留在本機,這對語音克隆和工作資料來說很關鍵。
先講結論
Voicebox 是 Jamie Pine 開源的 AI voice studio,官方定位是 local-first。它可以做文字轉語音、聲音克隆、全域快捷鍵聽寫、Whisper 轉錄、故事多軌編輯,還能透過 REST API 和 MCP server 讓 Claude Code、Cursor、Cline 這類 MCP-aware agent 發聲。
我會把它放在「本地語音 AI 底座」這一類,之前整理過 audio.cpp 本地語音 AI WebUI 和 Hugging Face speech-to-speech 本地語音 Agent ,Voicebox 則更偏向桌面應用和創作者工具,並且把 Agent 整合做得很直接。
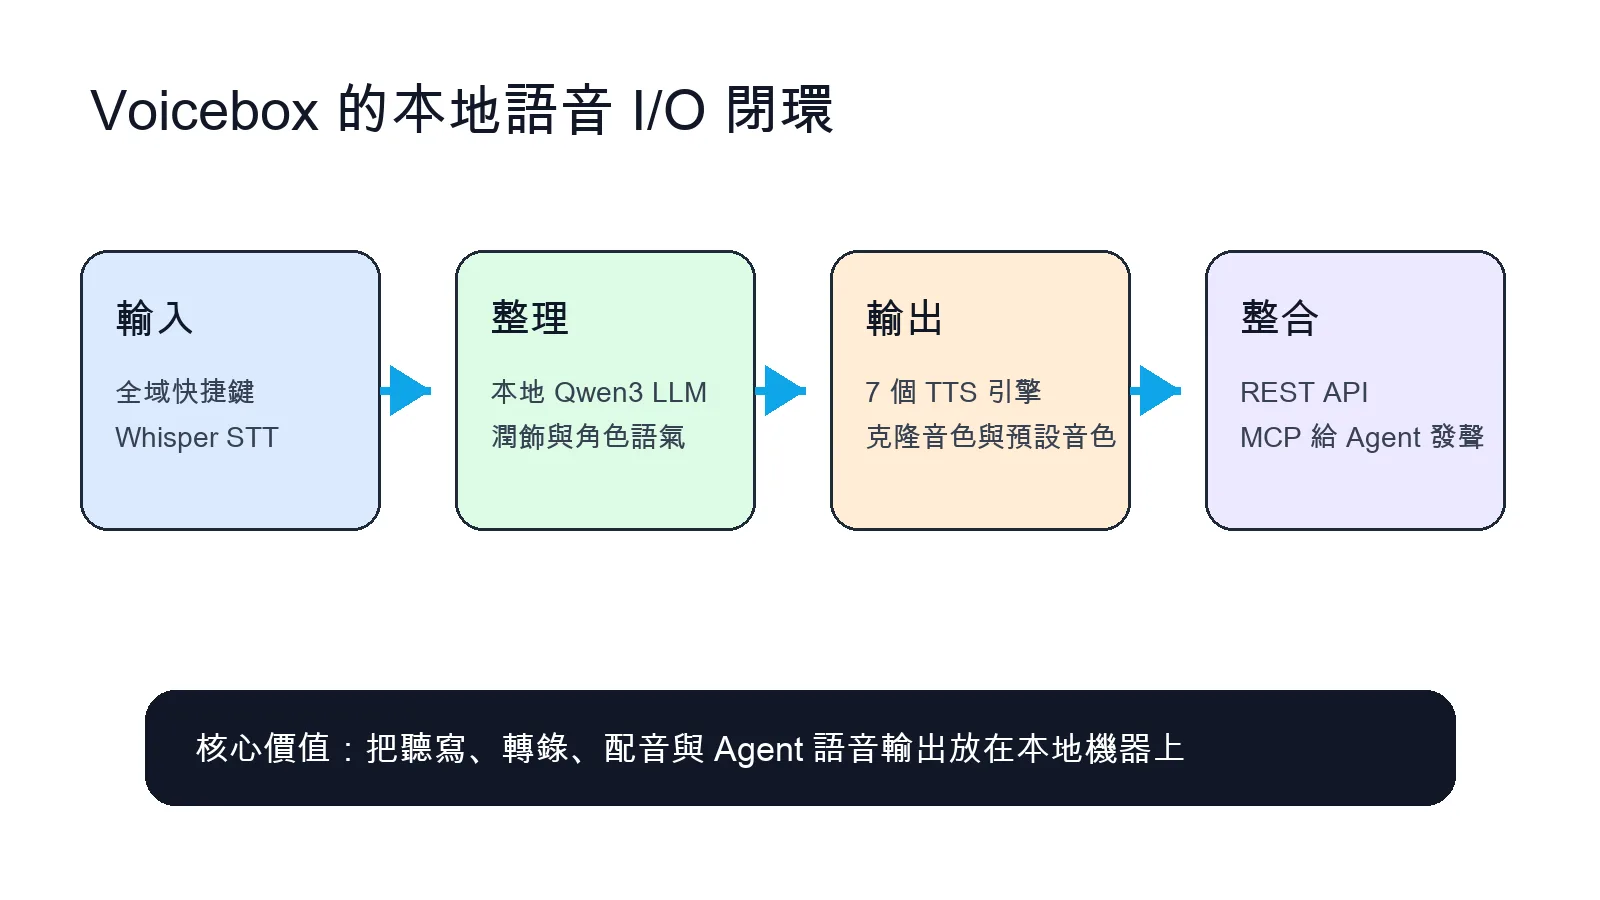
Voicebox 把聽寫、轉錄、配音和 Agent 語音輸出放在同一個本地工具裡。 Voicebox 在補語音 AI 的哪一塊
很多語音工具只有單點能力。TTS 工具能把文字變聲音,但不一定能做聽寫。STT 工具能轉錄,但不一定能配音。聲音克隆工具效果強,但常常依賴雲端 API。Voicebox 的取向比較完整:輸入端用 Whisper,輸出端有多個 TTS 引擎,中間還有本地 Qwen3 LLM 做潤飾、角色語氣和 persona。
這種整合方式很適合兩種人:
第一種是內容創作者,想做旁白、podcast、故事對話、角色音色。
第二種是 AI Agent 使用者,想讓 Claude Code、Cursor 或自己的工具在完成任務後,用指定聲音提醒你,而不是只丟一段文字。
7 個 TTS 引擎和 23 種語言
官方 README 列出 7 個 TTS 引擎:Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro。它們的定位不同,有的適合多語言克隆,有的適合 CPU 快速推理,有的適合加入情緒標籤和語氣控制。
能力 Voicebox 的做法 適合用途 高品質 TTS Qwen3-TTS、Chatterbox、HumeAI TADA 等引擎 旁白、教學、產品介紹 聲音克隆 用參考音訊做 zero-shot cloning 個人聲音、角色聲音、品牌聲線 快速預設音色 Kokoro 和 Qwen CustomVoice 提供 50+ 音色 快速試稿、多角色對話 語音輸入 全域快捷鍵加 Whisper STT 聽寫、轉錄、工作筆記
如果你對開源 TTS 的音色設計有興趣,可以搭配看 Qwen3-TTS 的音色設計整理 和 dots.tts 聲音復刻架構 。Voicebox 比較像把這些能力打包成桌面工作台,而不是單一模型 demo。
聲音克隆和預設音色的差別
聲音克隆適合你有一段參考音訊,想生成相似聲線。預設音色適合你只是要快速找一個可用聲音,不想準備樣本。Voicebox 同時支援兩種路線,這點很實用。創作者可以先用預設音色打草稿,確定文本節奏後,再換成克隆音色做正式版本。
但聲音克隆也有界線。它很適合克隆你自己擁有權利的聲音,或明確授權的角色聲音。不要拿來模仿名人、同事或客戶聲音做未授權內容。語音模型越容易使用,倫理和授權越要先想清楚。
Whisper 聽寫補上輸入端
Voicebox 的另一半是輸入。它用 OpenAI Whisper 做 speech-to-text,支援全域 dictation hotkey、push-to-talk 和 toggle mode。macOS 上可以把轉錄結果直接貼到目前焦點文字欄位,這會讓它接近一個本地版語音輸入法。
Whisper 對長音訊和技術內容一直很適合。如果你常做訪談、會議紀錄、口述筆記,Voicebox 把 captures、replay、re-transcribe、refine 放在同一個介面裡,會比單純命令列轉錄更順。這裡也可以延伸看之前整理的 Whisper 開源語音轉文字 。
MCP 讓 Agent 真的開口說話
Voicebox 最有意思的一點,是內建 MCP server,官方 README 寫到它提供 `voicebox.speak`、`voicebox.transcribe`、`voicebox.list_captures`、`voicebox.list_profiles` 四個工具,這代表 MCP-aware agent 可以呼叫 Voicebox,把文字變成指定音色播放出來,也可以讀取 captures 和 voice profiles。
這不只是好玩。Agent 的語音輸出可以拿來做任務完成提醒、錯誤警告、長任務回報、pair programming 對話。你甚至可以把不同 agent 綁定不同聲音,例如 Claude Code 用一個音色,Cursor 用另一個音色,聽聲音就知道是哪個工具在回報。
{
  "tool": "voicebox.speak",
  "arguments": {
    "text": "任務完成,測試已通過",
    "profile": "Morgan"
  }
}
如果你已經在玩 Playwright CLI 讓 Codex 操作瀏覽器 ,Voicebox 可以補上另一個感官通道。Agent 不只可以操作網頁,也能在完成後直接用語音提醒你。
Stories editor 適合做多角色內容
Voicebox 也有 Stories editor,可以做 conversation、podcast、narrative 這類多段落、多角色內容。這對部落格轉 podcast、教學腳本、角色對話、短劇旁白都很有用。比起一次產生一整段音訊,多軌 timeline 更適合慢慢調整角色、節奏和轉場。
如果你平常會把文章轉成短影片或語音內容,Voicebox 可以放在內容工作流後段。先由 Agent 整理稿件,再用 Voicebox 做角色分配和配音,最後再進剪輯工具。
安裝與使用入口
Voicebox 官方網站是 voicebox.sh ,GitHub repo 是 jamiepine/voicebox 。官方 README 提供 macOS Apple Silicon、macOS Intel 和 Windows 下載入口,也有開發者本地建置方式。
我會怎麼用
我不會只把 Voicebox 當成免費配音工具:
更有價值的用法,是把它接進 AI Agent 工作流,平常寫文章、整理筆記、跑 Codex、跑 Claude Code,最後都可以由 Voicebox 轉成語音摘要。長任務完成時不用一直盯螢幕,讓 Agent 開口提醒就好。
第二個用法是做內容實驗,先用預設音色快速產出版本,再用克隆音色做正式版。
第三個用法是本地聽寫,把口述想法直接丟進任何 app,再交給 Agent 整理。這會比只靠鍵盤更接近自然工作流。
我的判斷
Voicebox 不是單一模型展示,而是把語音 AI 變成桌面工作台。它的亮點不是某個 TTS 引擎本身,而是整合:本地隱私、TTS、STT、故事編輯、聲音 profile、REST API、MCP server。
如果你只需要偶爾產一段聲音,線上 TTS 服務可能更快。但如果你想要長期建立自己的聲音素材庫、做本地聽寫、讓 Agent 用聲音回報任務,Voicebox 會是值得試的工具。
延伸資源
FAQ
Voicebox 是什麼?
Voicebox 是開源的本地優先 AI 語音工作室,可以做 TTS、聲音克隆、Whisper 聽寫轉錄、故事編輯和 MCP Agent 語音輸出。
Voicebox 可以離線使用嗎?
官方定位是 local-first,模型、聲音資料和 captures 會留在本機。實際能否完全離線,取決於你是否已下載需要的模型和使用的引擎。
Voicebox 支援哪些 TTS 引擎?
官方列出 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro。
Voicebox 可以接 Claude Code 或 Cursor 嗎?
可以。Voicebox 內建 MCP server,MCP-aware agent 可以使用 `voicebox.speak`、`voicebox.transcribe`、`voicebox.list_captures` 和 `voicebox.list_profiles`。
by Rain Chu 7 月 8, 2026 | Agent , AI , 語音合成 , 語音辨識
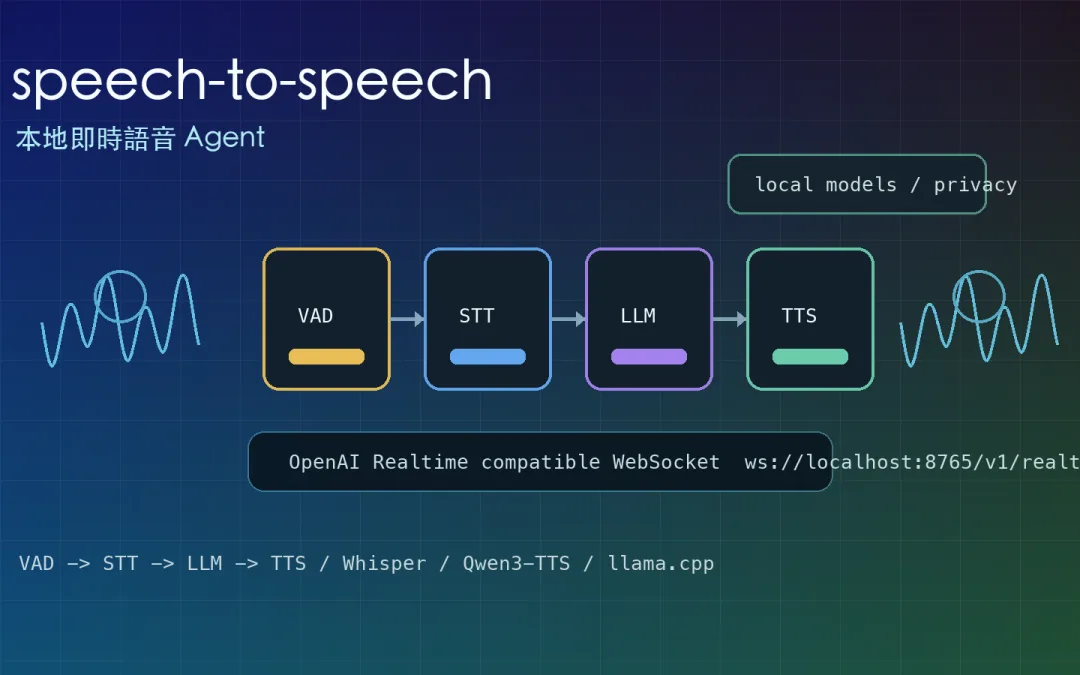
Hugging Face 的 speech-to-speech 真正有趣的地方,不只是「本地 AI 語音聊天」這句話,而是它把即時語音 Agent 拆成一條清楚的工程管線:VAD 偵測你什麼時候開始和結束說話,STT 把語音轉成文字,LLM 產生回應,TTS 再把文字變回聲音。
這條路線的價值很直覺:如果你不想把麥克風聲音、私人對話、公司資料一路送到雲端,那就把語音 Agent 搬回自己的機器。代價也很明顯:你要處理 Python、FFmpeg、CUDA、模型下載、本地 LLM server、TTS 後端、瀏覽器端 WebSocket。這不是「安裝一個 App 就結束」的工具。
如果你之前看過 VoxelCPM 本地 TTS ,這篇可以當成下一步:TTS 只是讓 AI 開口,speech-to-speech 則是把「聽、想、說」接成一個即時循環。
先講結論:它不是語音模型,而是一條可替換的語音 Agent 管線
huggingface/speech-to-speech 的 README 把架構講得很清楚:這是一條低延遲、模組化的 voice-agent pipeline,順序是 VAD → STT → LLM → TTS,並且透過 OpenAI Realtime-compatible WebSocket API 對外提供服務。
也就是說,你可以把支援 OpenAI Realtime 協議的 client 指到本機 server。
這個設計比單純做一個 demo 更有意思,因為每一段都能換。
STT 可以用 Parakeet、Whisper、Faster Whisper、MLX Whisper 或 Paraformer;LLM 可以接 OpenAI-compatible provider,也可以接 vLLM、llama.cpp、llama-server;TTS 可以用 Qwen3-TTS、Kokoro、Pocket TTS、ChatTTS 或 MMS TTS。
換句話說,它的重點不是某個模型最強,而是把語音 Agent 做成可插拔架構。
這和 OpenWork / OpenCode 工作台 的方向有點像:真正可長期使用的 AI 工具,不應該只綁死在單一供應商或單一模型。
Speech-to-speech 和傳統語音翻譯有什麼差別?
Hugging Face Audio Course 裡對 speech-to-speech translation 的說明很適合拿來釐清概念。
傳統機器翻譯是文字到文字,speech-to-speech 則是語音到語音。最常見的做法是串接:先把語音轉成文字,再做翻譯或生成,最後合成語音。
它也提醒一個很重要的問題:管線越長,錯誤越會累積,延遲也越高。
ASR 認錯一個字,後面的 LLM 可能照著錯字理解;LLM 回答太長,TTS 就要等更久;TTS 聲音不自然,最後體驗還是會掉下來。
所以本地即時語音 Agent 的關鍵不是只看「能不能講話」,而是看四件事:
語音辨識是不是準,尤其是中文、口音、背景噪音。
LLM 回應是不是夠快,不要讓人等到出戲。
TTS 聲音是不是自然,長時間聽會不會疲勞。
整條管線的延遲是不是穩定,而不是偶爾順、偶爾卡。
官方預設路線:先跑起 realtime server
官方 quickstart 很短:
pip install speech-to-speech
export OPENAI_API_KEY=...
speech-to-speech ws://localhost:8765/v1/realtime
預設路線會用本地 STT、本地 TTS,再把 LLM 接到 OpenAI-compatible API。你如果想讓 LLM 也留在本機,可以用 llama.cpp 啟動本地模型 server,再把 `responses_api_base_url` 指到本機。
speech-to-speech \
  --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
  --responses_api_base_url "http://127.0.0.1:8080/v1" \
--responses_api_api_key "" Ollama 遠端連線 和本地 OpenAI-compatible server 的設定很重要:語音只是入口,真正回答問題的是後面的 LLM。Windows 實作路線:不是難,是零件很多
核心流程可以簡化成這樣:
裝 Python 3.11、Git、FFmpeg。
建立 `C:\s2s` 之類的資料夾,開 venv。
安裝 `speech-to-speech`。
用 llama.cpp 跑本地 Qwen 模型,開在 `http://127.0.0.1:8080/v1`。
啟動 speech-to-speech,把 STT 指到 Whisper、LLM 指到本地 server、TTS 指到 Qwen3-TTS。
開網頁 client,WebSocket 指到 `localhost:8765`。
這裡最容易踩坑的是 FFmpeg 和 winget。留言裡有人遇到 `winget` 找不到,這通常代表 Windows App Installer / winget 沒裝好,或 PowerShell 環境找不到它。這時候不要卡在同一條命令,可以改成手動下載 FFmpeg,或先修好 winget,再重新開 PowerShell。
架構表:每一段都可以替換,但每一段也都會出事
階段 作用 常見選擇 容易卡住的地方 VAD 判斷使用者何時開始/停止說話 Silero VAD 背景噪音、切句太早或太晚 STT 語音轉文字 Parakeet、Whisper、Faster Whisper 中文辨識、口音、GPU/CPU 速度 LLM 理解問題並產生回應 OpenAI-compatible API、llama.cpp、vLLM、Ollama 類服務 延遲、上下文長度、模型能力 TTS 文字轉語音 Qwen3-TTS、Kokoro、Pocket TTS、ChatTTS 聲音自然度、CUDA wheel、中文品質 Client 麥克風輸入與播放 Realtime WebSocket client、網頁呼吸球介面 瀏覽器權限、WebSocket 位置、服務啟動順序
這張表就是我對本地語音 Agent 的看法:模組化很香,但你不能只看成功 demo 任一段延遲太高、模型太大、依賴裝錯、WebSocket 指錯,都會讓整體體驗掉下來。
4GB 顯存、4090、CPU:期待值要分開看
如果你只是想體驗,本地小模型加 CPU/GPU 混跑可以試;如果你想每天使用,就要認真看顯卡、VRAM、記憶體、模型大小與量化格式。這部分可以搭配 AI 工作站顯卡選購 那篇看,因為語音 Agent 不是只吃一個模型,而是一整條 pipeline。
本地部署值不值得?
安裝太複雜、Python 依賴一直重裝、免費雲端語音也能用、中文場景不一定比微信等現成工具舒服。
我會這樣判斷:
如果你只想偶爾語音聊天 ,雲端 App 更省事。如果你在意隱私、離線、可控模型 ,本地 speech-to-speech 才有意義。如果你要接自己的 Agent 或自動化流程 ,OpenAI Realtime 相容 API 很有價值。如果你不想處理依賴 ,等整合包或 Docker / 一鍵腳本會比較舒服。
有留言建議做整合包,把 Python、虛擬環境、依賴、模型檔都打包好。這個方向很務實。語音 Agent 要走向一般使用者,最重要的可能不是模型再強一點,而是安裝流程少掉一半。
接進 Hermes、OpenWork 或自己的 Agent:語音只是入口
有人問如果部署在 Hermes 裡,是不是就不用打字了。方向是對的,但要分清楚:speech-to-speech 解決的是語音輸入與語音輸出,Agent 真正能不能工作,還要看後面的工具調用、上下文、記憶、權限與任務執行。
也就是說,語音不是 Agent 的全部,只是更自然的控制入口。你可以想像之後用語音叫本地 Agent 幫你查資料、改檔案、跑腳本、操作工作流,但這需要像 OpenWork 或 Hermes Agent 這類工作台或 runtime 來承接任務。
真正有用的組合會是:speech-to-speech 負責「聽和說」,Agent runtime 負責「做事」,本地 LLM / 工具 / MCP 負責「連到你的資料和系統」。語音只是讓人更容易下指令,不能替代完整的任務架構。
資源整理
本地即時語音 Agent 很香,但現在還偏工程師玩具
speech-to-speech 讓本地語音 Agent 的架構變得很清楚:你可以把 VAD、STT、LLM、TTS 串起來,對外提供 OpenAI Realtime 相容 API,再用網頁或其他 client 連進來。這條路很有想像空間,尤其適合隱私敏感、離線使用、機器人、客服、語言練習、自建 AI 助手。
但我不會把它包裝成人人都該裝。現階段它還需要處理太多環境問題,Windows 下尤其明顯。真正適合的人,是願意花時間把本地模型、音訊依賴、GPU、WebSocket 和 Agent runtime 串起來的人。
一句話總結:本地即時語音不是為了取代手機上的語音助手,而是為了把「能聽、能想、能說」這個入口,接到你自己的模型、資料和工作流上。這件事如果跑順,會比單純聊天更有價值。
FAQ
speech-to-speech 是什麼?
speech-to-speech 是 Hugging Face 的開源語音 Agent 管線,透過 VAD、STT、LLM、TTS 四個階段,把使用者語音轉成模型回應,再合成語音輸出。
它可以完全本地運行嗎?
可以,但需要把 STT、LLM、TTS 都換成本地後端,例如 Whisper、llama.cpp 或其他 OpenAI-compatible 本地 LLM server,以及 Qwen3-TTS 等本地語音合成模型。
為什麼不用雲端語音助手就好?
如果只是日常聊天,雲端語音助手更省事。本地方案的價值在於隱私、離線、可控模型、可接自有資料與 Agent 工作流。
by Rain Chu 3 月 24, 2024 | AI , 語音辨識
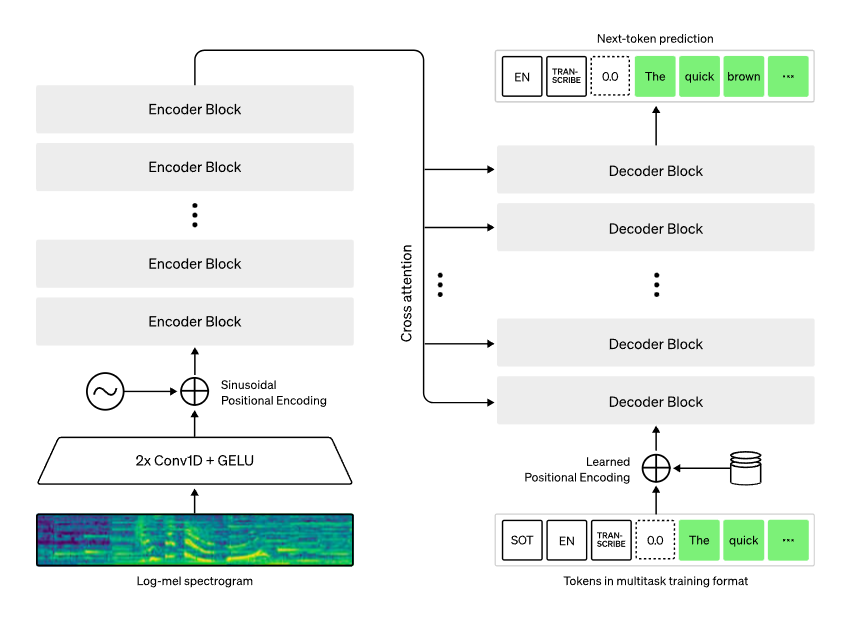
Whisper 是一種由 OpenAI 開發的先進語音識別系統,Whisper 的獨特之處在於其能夠處理多種語言和方言,以及在各種噪音環境下保持高水準的準確率。這一技術的開發代表了語音識別領域的一個重要進步,為多種應用場景提供了強大的支持,從自動字幕生成到語音指令的處理,再到多語言溝通的促進。
2025年更新
在 ubuntu 中直接安裝 Whisper
pip install -U openai-whisper 然後輸入 OpenAI KEY
export OPENAI_API_KEY='sk-XXXX' 接下來就可以直接辨識了,不用特別在寫程式
whisper /test.mp3 --model large-v3 --language zh --task transcribe --output_format txt Large 3 更新
2023年末的更新版本,Large 3 ,來到了3.1GB,測試後,中文的理解能力已經來到了大學生等級,相當的實用,但也相當吃硬體資源
Whisper JAX
https://huggingface.co/spaces/sanchit-gandhi/whisper-jax
如果不想安裝,只想立即使用的話,可以先點選線上版本的,直接可以測試他的效果如何,再來想應用或是考慮是否要在本地端架設一套起來
技術背景
Whisper 基於深度學習模型,特別是利用了大規模語音數據集來訓練其識別算法。這使得 Whisper 不僅能夠識別標準發音的話語,還能識別口音、方言以及非正式或口語化的表達。OpenAI 通過分析大量的語音數據,使 Whisper 能夠理解和處理語速變化、背景噪音干擾以及講話者間的交談。
功能與應用
Whisper 的應用範圍廣泛,從提高輔助聽力設備的性能到增強虛擬助理的理解能力,再到改善自動翻譯系統的質量。在教育領域,它可以幫助創建更加無障礙的學習材料,為聽障學生提供即時字幕。在媒體行業,Whisper 可以用於自動生成新聞報導或視頻內容的字幕,大大提高生產效率並擴大觀眾範圍。
性能與準確性
OpenAI 對 Whisper 的測試表明,其在多種語言和口音的識別上達到了極高的準確性。此外,Whisper 能夠辨識並適當處理專有名詞、術語以及其他複雜的語言結構。這種高水平的準確性不僅對於提供質量高的轉錄服務至關重要,也是使語音交互系統更加可靠和實用的關鍵。
下載資源
OpenAI Whisper
編譯好可以直接使用的程式
CPU版本Whisper ,Buzz 適合沒有GPU的情景使用
文章內整理了編譯版本,可以離線下載使用
by Rain Chu 10 月 9, 2023 | AI , 語音辨識
Good Tape :每位記者的最佳助手
新聞記者同仁,是時候給你的筆記和錄音機進行一次升級了!我們都知道,在報導新聞的過程中,進行深度的訪談以獲得第一手資料是不可或缺的。但是,錄下來的訪談音檔真的有足夠的時間逐字逐句去轉錄嗎?對大多數的記者來說,轉錄不僅是時間消耗的過程,還可能會有遺漏或誤解的風險。
Good Tape 是一個線上工具,能夠將你的錄音文件快速且精確地轉為文字檔,大幅縮短你的工作時間,提高工作效率。不僅如此,其使用 OpenAI 的先進技術,確保每句話的準確性和細節都不會遺失。
不管你是在前線採訪還是在辦公室整理稿件,Good Tape 都能成為你的得力助手。現在,再也不用擔心漏掉訪談中的任何重要細節,只需一鍵,你的訪談內容就能完整地展現在眼前。
1. 🔧 功能強大: Good Tape 是一款線上工具,自動將錄音轉為文字檔的逐字稿。過去,這樣的技術經常受到語言和準確性的限制,但現在不再是問題!Good Tape 運用 OpenAI 的 Whisper 技術,支援包括英文、中文、日文等超過40種語言!
2. ⏰ 省時又精準: 只要簡單上傳錄音,Good Tape 不僅能產生文字檔,還可以提供標記時間的字幕檔(.SRT格式)。還有一個加分點,可以自訂逐字稿的時間間距,讓你的報導更加完善!
3. 🌐 背後的力量: Good Tape 的推出背後,是由丹麥知名數位報紙 Zetland 創建。他們之所以推出這項服務,是因為看見市場上昂貴、且多只專精於英文的轉錄服務。他們選擇使用了 API 方式串接 Whisper,將這項音訊轉文字檔的強大工具帶給我們。
4. 🛡 安全第一: Good Tape 保證了每位使用者資料的安全和隱私。傳輸過程已完全加密,而資料將不會離開受GDPR保護的歐盟範疇。更令人安心的是,若你沒有進行註冊,上傳的檔案僅會保存三天,這減少了任何潛在風險。
5. 💰 關於價格: 當然,如此高效的工具會有成本。Good Tape 計劃在不久的將來推出付費方案,但相信與其提供的價值相比,絕對物超所值!
結語:
各位記者朋友,Good Tape 無疑是我們日常工作的一大革新。從今以後,轉錄錄音再也不是煩惱,我們可以專注於最重要的事情 – 報導新聞!
Good Tape
https://www.mygoodtape.com/
延伸閱讀

近期留言