DeepSeek V4 Flash 0731 實測解析:Agent、GGUF 與本機部署
DeepSeek V4 Flash 0731 最值得注意的,不只是模型跑得更快,而是 Agent 能力明顯補強,它可以在 Agent 框架裡撰寫程式、呼叫工具、修正錯誤,完成遊戲、互動網頁與自動化任務,這是一個 284B 總參數的 MoE 大模型,即使每次只啟用 13B 參數,完整權重仍然很大。
模型權重採 MIT 授權,可以免費下載,但本機部署並不便宜,Unsloth 的 3-bit GGUF 約 103GB,建議至少準備 110GB 可用記憶體,接近無損的 Q4 版本約 155GB,較適合 192GB 記憶體工作站或多卡伺服器,一般 16GB、32GB,甚至 64GB 電腦都不適合硬跑完整模型。
DeepSeek V4 Flash 0731 是什麼
DeepSeek V4 Flash 0731 是 V4 Flash 的正式開源版本,官方模型卡表示,新版延續 Flash DSpark 架構,加入 speculative decoding 模組,並針對 Agent 任務完成新的後訓練。模型總參數為 284B,每次推理啟用約 13B 參數,最大上下文為 1,048,576 tokens。
| 項目 | 規格 | 實際意義 |
|---|---|---|
| 總參數 | 284B | 權重檔案很大,不能用 13B 模型的硬體需求估算 |
| 啟用參數 | 13B | MoE 每次只啟用部分專家,有助降低運算量 |
| 最大上下文 | 1M tokens | 理論上可處理超長任務,但 KV cache 會大量吃記憶體 |
| 授權 | MIT | 可下載、修改與商業使用,仍需遵守授權條款 |
| 主要強項 | Agent 與工具使用 | 適合程式開發、工具呼叫與長流程自動化 |
這裡最容易誤會的是 13B 啟用參數,它代表單次前向運算只會用到部分專家,不代表只需要載入 13B 權重。完整 MoE 權重依然要放進記憶體,所以本機部署需求遠高於一般 13B 模型。
Agent 能力提升多少
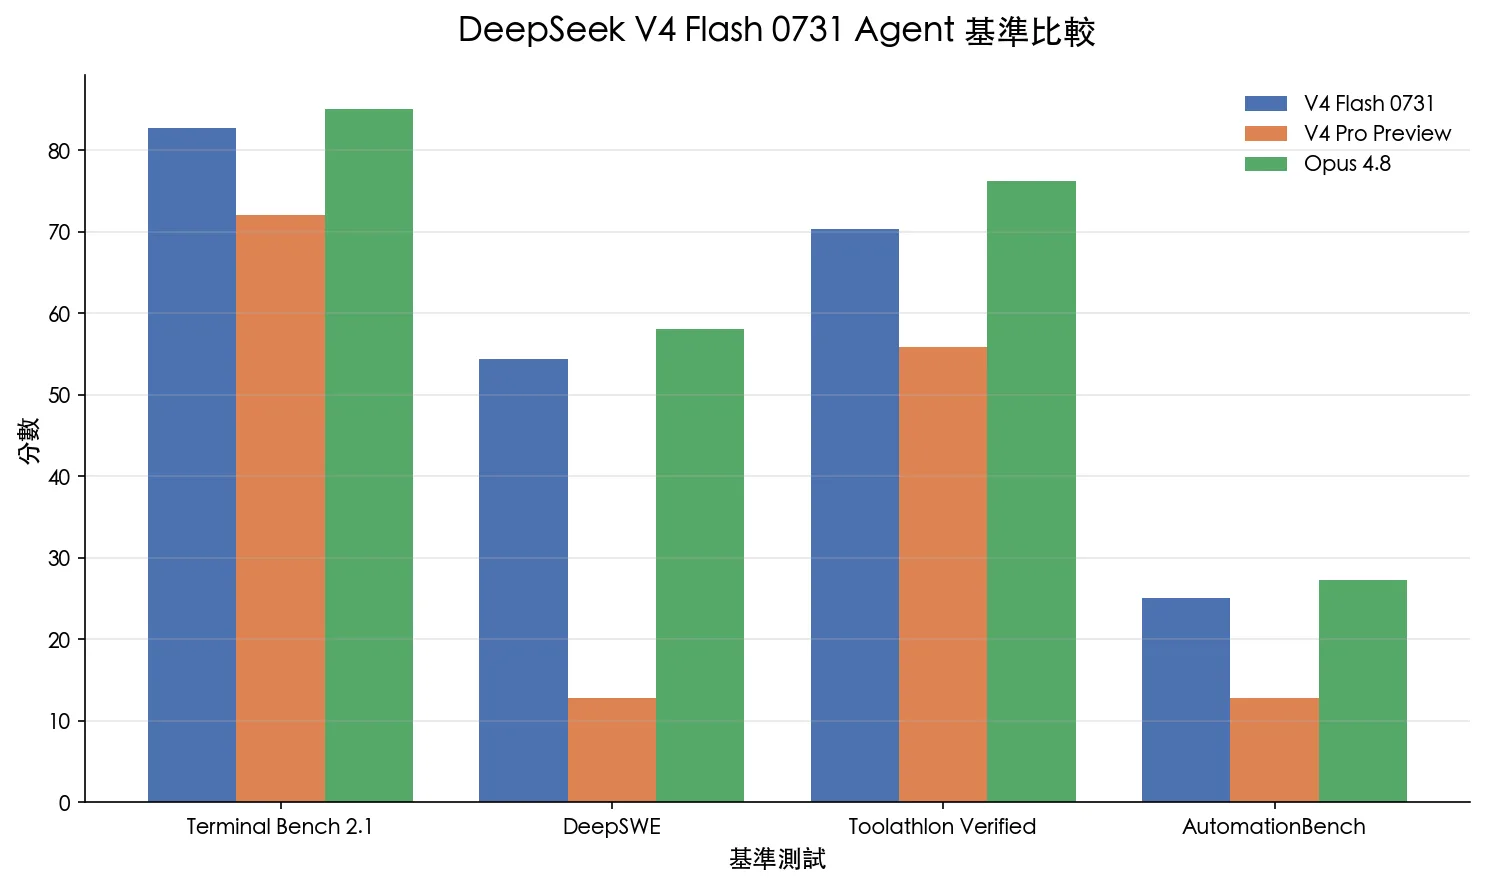
官方模型卡列出的 Agent 評測顯示,0731 版比 V4 Pro Preview 進步很多,Terminal Bench 2.1 從 72.1 提升到 82.7,DeepSWE 從 12.8 提升到 54.4,Toolathlon Verified 從 55.9 提升到 70.3,AutomationBench Public 則從 12.8 提升到 25.1。
| 評測 | V4 Flash 0731 | V4 Pro Preview | Opus 4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 72.1 | 85.0 |
| DeepSWE | 54.4 | 12.8 | 58.0 |
| Toolathlon Verified | 70.3 | 55.9 | 76.2 |
| AutomationBench Public | 25.1 | 12.8 | 27.2 |
這些分數不能直接等同於所有人的使用體驗,但是各大 AI 網紅們都給予極高的肯定,官方的程式 Agent 評測使用 DeepSeek Harness minimal mode,搭配 max reasoning、temperature 1.0 與 top_p 0.95。部分 DSBench 項目也是內部資料集,模型、Agent 框架、提示詞、工具權限和驗證流程都會影響最後結果。
為什麼能做出 2D、3D 遊戲和太陽系
實際展示涵蓋 2D 平台遊戲、3D 闖關遊戲、太陽系模擬、圖片生成與影片生成流程。這些結果證明它很適合放進 Hermes Agent 一類的工具框架,但不能解讀成模型本身具備完整視覺能力。
DeepSeek V4 Flash 0731 的核心仍是文字模型,它會產生 HTML、JavaScript、Three.js 或其他程式碼,再由 Agent 啟動瀏覽器、執行程式與呼叫外部圖片工具,若 Agent 沒有截圖回饋或視覺模型協助,它無法像多模態模型一樣直接看見成果,前端展示看起來很完整,功勞來自模型能力與 Agent 工具鏈的組合。
要評估這類展示,我會看三件事
第一是第一次產出的可用程度.
第二是 Agent 能否自行執行並找出錯誤。
第三是移除人工協助後能否重複成功。
免費到底指什麼
「免費」至少有三種不同意思,最好分開看。
- 開源權重免費:模型採 MIT 授權,可以從 Hugging Face 下載。
- 網頁聊天免費:官方網站可能提供免費額度,但服務規則可能調整。
- API 免費活動:公測或限時額度不代表永久免費,串接正式服務前應重新查價。
截至 2026 年 8 月 1 日,DeepSeek 官方 API 文件已列出 deepseek-v4-flash 的計費資訊,每百萬 input tokens 在 cache hit 時為 0.0028 美元,cache miss 為 0.14 美元,output 為 0.28 美元。價格與活動可能隨時改變,上線前應以官方定價頁為準。
本機執行雖然沒有按 token 付 API 費用,卻要負擔記憶體、GPU、儲存空間、電力與維護成本。對偶爾使用的人來說,API 可能反而比較便宜。對需要大量批次處理、資料不能離開內網,或想研究 Agent 框架的人,本機部署才更有價值。
Q4 為什麼還要約 155GB
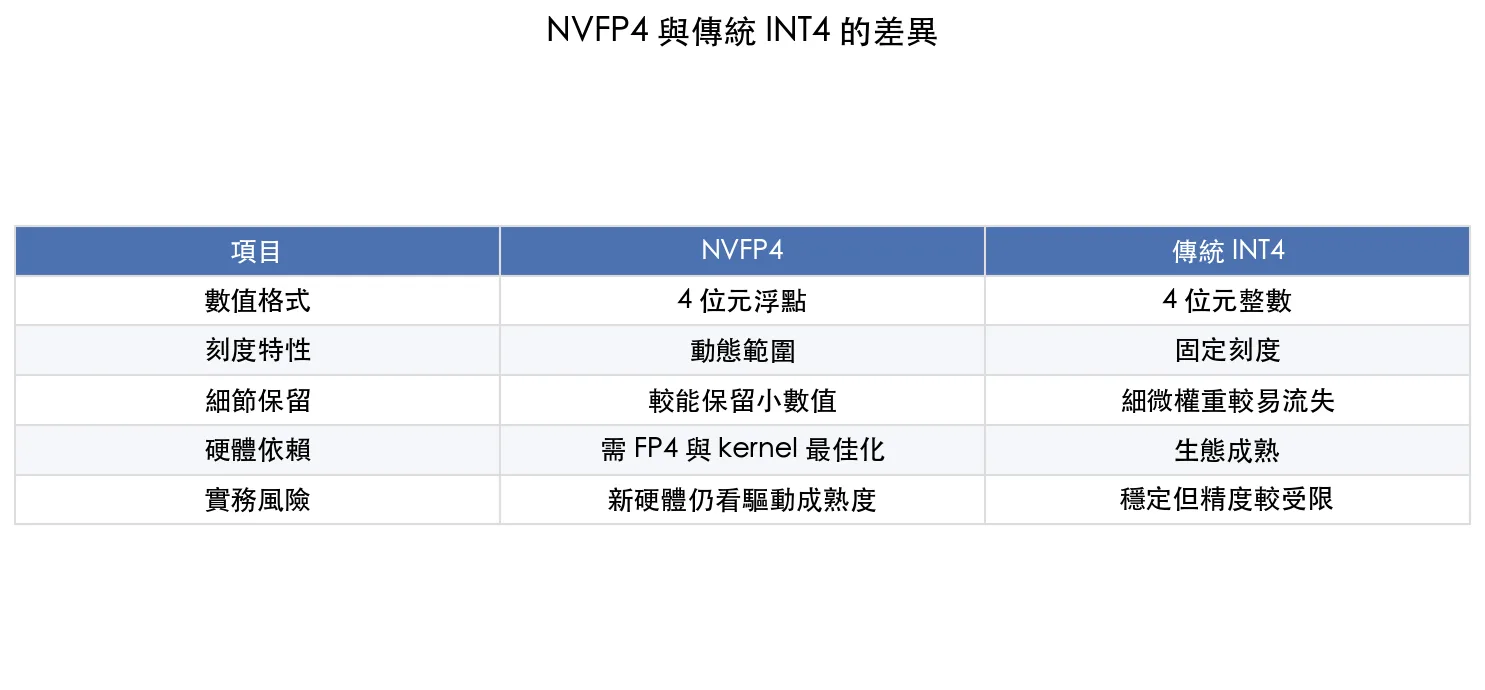
DeepSeek V4 Flash 0731 在訓練時已採用量化感知訓練,約 96% 的 routed experts 原生使用 MXFP4,其餘權重使用 FP8 或 BF16,Q4 並不是把一個完整 BF16 模型全部壓成四分之一,而是保留原本已經是 4-bit 的專家,再量化其他張量。
這也解釋了為什麼 Unsloth 的 UD-Q4_K_XL 仍約 155.1GB,和官方參考權重 156.4GB 很接近,它的重點不是極端縮小檔案,而是在維持原生 MXFP4 專家的前提下,降低非專家張量的空間。UD-Q8_K_XL 約 161.9GB,Unsloth 將它定位為接近位元層級重建的無損版本。
| 量化版本 | 約略大小 | 建議記憶體 | 適合情境 |
|---|---|---|---|
| 1-bit | 約 92GB | 至少 96GB | 以能跑為優先,品質犧牲較大 |
| 2-bit | 約 102GB | 至少 110GB | 記憶體緊張的測試用途 |
| UD-IQ3_XXS | 約 103GB | 110GB 到 128GB | 128GB 裝置的實用起點 |
| UD-Q4_K_XL | 約 155GB | 建議 192GB | 接近無損品質 |
| UD-Q8_K_XL | 約 162GB | 建議 192GB 以上 | 重視精度與重現性 |
表格只算模型權重仍不夠,作業系統、llama.cpp、KV cache 與長上下文都需要額外空間,128GB 機器即使用 103GB 版本,也不應一開始就把 context 設成 1M,先從 32K 或更低開始,確認速度與記憶體餘裕,再逐步增加。
量化概念也可以參考我整理的 MXFP8、NVFP4 與不同量化格式比較,不要只看檔名裡的 Q4,還要看原始權重格式和哪些張量被量化。
用 Unsloth Studio 安裝
想用圖形介面管理模型,可以先裝 Unsloth Studio,macOS、Linux 與 WSL 使用下面的命令。
curl -fsSL https://unsloth.ai/install.sh | shWindows PowerShell 使用下面的命令。
irm https://unsloth.ai/install.ps1 | iex安裝完成後啟動服務。
unsloth studio -H 0.0.0.0 -p 8888如果只在本機使用,建議不要對外開放 8888 連接埠。需要從區域網路操作時,應搭配防火牆、反向代理與登入驗證。
用 llama.cpp 下載與執行 GGUF
Unsloth 官方文件提供 Hugging Face 直接載入方式。以下先以 UD-IQ3_S 為例。記憶體更緊張時,可在模型頁改選 UD-IQ3_XXS。
export LLAMA_CACHE="unsloth/DeepSeek-V4-Flash-0731-GGUF"

./llama.cpp/llama-cli \
  -hf unsloth/DeepSeek-V4-Flash-0731-GGUF:UD-IQ3_S \
  --ctx-size 32768 \
  --temp 1.0 \
  --top-p 1.0 \
  --min-p 0.0
若要先完整下載指定分片,可以使用 Hugging Face CLI。
hf download unsloth/DeepSeek-V4-Flash-0731-GGUF \
  --local-dir unsloth/DeepSeek-V4-Flash-0731-GGUF \
  --include "*UD-IQ3_S*"
大型 GGUF 往往分成多個檔案,下載前先確認磁碟空間與網路穩定度。不同作業系統、CPU、GPU offload 比例與記憶體頻寬都會影響速度,想比較其他引擎,可以看 vLLM、SGLang、llama.cpp、MLX 與 Ollama 推理框架比較,若使用 DGX Spark,也可參考 DGX Spark 搭配 GGUF 與 llama.cpp 的實作方式。
推理參數怎麼設
官方與 Unsloth 建議 temperature 1.0。一般對話可用 top_p 1.0,Agent 任務則可改成 top_p 0.95。Think High 是預設的深度推理模式。Think Max 需要更大的輸出與上下文空間,官方建議至少預留 384K,並不適合記憶體剛好壓線的本機環境。
- 一般對話:temperature 1.0,top_p 1.0
- Agent 任務:temperature 1.0,top_p 0.95
- 本機初次測試:context 從 16K 或 32K 開始
- 長任務:先監看記憶體與輸出速度,再增加 context
本機執行與隱私安全
把開源權重放在自己的機器上,可以降低提示詞和文件傳送到第三方服務的需求,但不代表自動安全,仍要確認模型來源、雜湊值、推理程式、下載腳本與網路連線,處理公司資料時,也要記錄哪些 Agent 工具有檔案、終端和瀏覽器權限。
Agent 會執行模型產生的程式碼,風險比單純聊天高,建議使用容器、虛擬機或權限受限的工作目錄,並在刪除檔案、安裝套件、登入網站、發送資料與付費操作前要求人工確認,模型能完成任務,不代表每個操作都值得信任。
若你希望在本機開發工具裡使用模型,可以延伸閱讀 Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境,再依自己的硬體改用 llama.cpp 或相容 API。
誰適合部署
DeepSeek V4 Flash 0731 適合擁有 128GB 以上統一記憶體工作站、多卡伺服器、DGX Spark 類設備,並且真的需要 Agent、自動化或大量私有資料處理的人,它也適合研究 MoE、推測解碼和量化感知訓練。
如果只是想體驗模型能力,先用官方網頁或 API 更合理。16GB 到 64GB 電腦不必為了完整模型勉強選極低位元量化,你會付出很長的載入時間、很慢的生成速度和明顯品質損失,最後還不一定比雲端便宜。
我的判斷
DeepSeek V4 Flash 0731 真正的進步,是從擅長回答問題,往可以在工具環境中完成工作的方向前進,Agent 評測已經逼近高階閉源模型,開源權重也讓企業有機會把資料和推理留在自己的環境。
它仍不是一般消費級電腦的輕量模型,284B 總參數決定了權重與記憶體成本,13B 啟用參數無法改變這件事,對多數人最務實的路線,是先用 API 驗證工作流,只有在使用量、隱私或客製化需求足夠明確時,再投資 128GB 到 192GB 的本機部署環境。
參考資料
- DeepSeek V4 Flash 官方模型卡
- Unsloth DeepSeek V4 部署文件
- DeepSeek V4 Flash 0731 GGUF 下載
- DeepSeek API 官方文件
- FreeDidi 中文補充資料
FAQ
DeepSeek V4 Flash 0731 可以在 64GB 電腦執行嗎?
不建議。Unsloth 最小的實用量化仍接近 92GB,3-bit 推薦版本約 103GB,還要保留 KV cache 與系統空間。較合理的起點是 110GB 可用記憶體,128GB 裝置會比較實際。
為什麼只有 13B 啟用參數,權重卻超過 100GB?
13B 是每次推理被路由啟用的參數量。模型共有 284B 參數,完整專家權重仍要載入記憶體,因此硬體需求不能用一般 13B 模型估算。
DeepSeek V4 Flash 0731 是多模態模型嗎?
它主要是文字與程式模型。遊戲和視覺成果通常由 Agent 執行程式碼或呼叫外部工具產生。若要讓 Agent 看見並判斷畫面,還需要瀏覽器截圖回饋或另外接入視覺模型。
DeepSeek V4 Flash 0731 完全免費嗎?
模型權重採 MIT 授權,可免費下載。官方網頁可能有免費額度,API 則應依當下定價。自行部署還有硬體、電力、儲存與維護成本。
近期留言