by Rain Chu | 9 月 14, 2026 | AI, QWEN, TTS, 虛擬人, 語音合成, 語音辨識
把 AI 對話、即時語音和會動的人像放在同一台電腦上,現在已經可以做出一套不依賴雲端 API 的互動數位人,用 faster-whisper 聽懂麥克風,讓 Qwen3 產生回答,再交給 Qwen3-TTS 合成聲音,最後由 LiveTalking 完成口型同步與 WebRTC 串流。
先講我的結論。這套方案的價值是隱私、角色控制與離線能力,不是安裝後完全沒有成本。模型權重下載完成後確實不需要按次支付 API 費用,但顯卡、記憶體、硬碟、電力與維護時間仍然是成本,所謂 8GB 顯存能跑,也必須以較小的 LLM、量化權重和分階段載入為前提.若想讓 14B LLM、Whisper large-v3、1.7B TTS 與口型模型同時常駐,16GB 顯存仍可能不夠。
整套本地 AI 數位人怎麼運作
這不是單一模型,而是一條由五個服務組成的即時管線。
- VAD 判斷使用者何時開始與停止說話
- faster-whisper 把麥克風聲音轉成文字
- Qwen3 與 llama.cpp 根據角色設定產生回答
- Qwen3-TTS 把回答轉成指定音色的語音
- LiveTalking 接收音訊並驅動嘴型,再透過 WebRTC 顯示互動人像
這種模組化做法和我之前整理的 Hugging Face speech-to-speech 本地即時語音 Agent 是同一條思路。每一層都能替換,但每一層也有自己的模型、連接埠與執行環境。LiveTalking 不會自動知道 Qwen3-TTS 在哪裡,兩者中間仍需要官方支援的 TTS 外掛,或一個把生成音訊送到 /humanaudio 的橋接程式。
先算顯存,不要先相信 8GB 宣傳
| 元件 | RTX 4090 範例占用 | 低顯存調整 |
|---|
| Qwen3-14B Q4_K_M | 約 9GB | 改用 8B 或 4B 的 Q4_K_M |
| faster-whisper large-v3 | 約 3GB | 改用 medium,準確度會有取捨 |
| Qwen3-TTS 1.7B | 約 4GB | 改用 0.6B 或依序載入服務 |
| Wav2Lip 256 | 約 1.3GB | 降低批次並避免其他 GPU 程式常駐 |
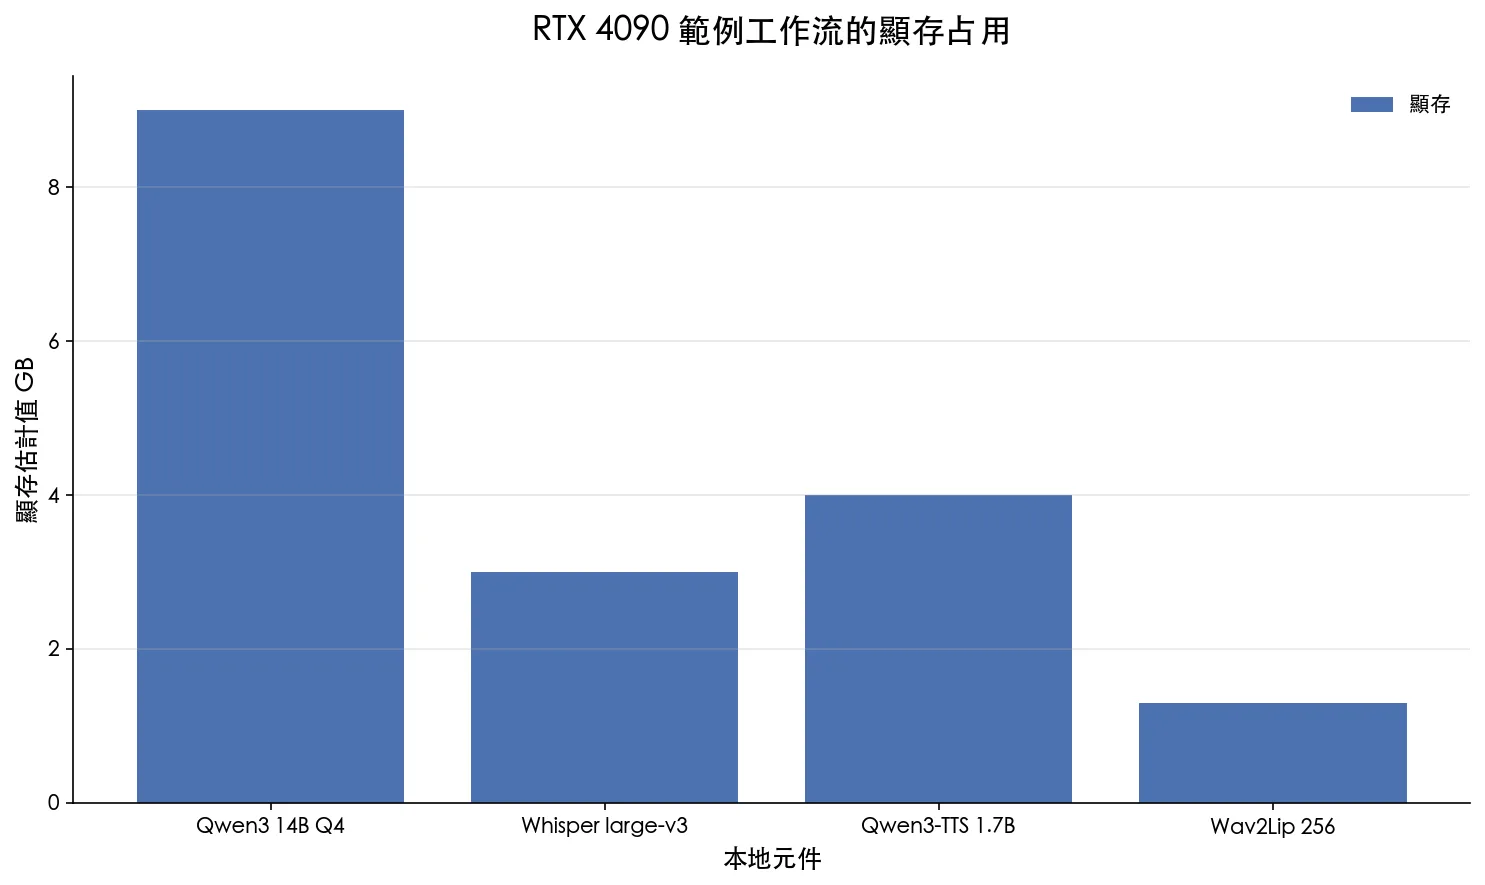 這是 RTX 4090 整合環境的估計值,不同量化、上下文長度與 CUDA 版本都會改變結果
四個元件加起來約 17.3GB,還沒算 CUDA context、瀏覽器與暫存空間。16GB 顯卡跑到 99% 甚至整台機器失去回應,並不意外。6GB 顯存可以先用 Qwen3-4B 的 GGUF 量化版,並把語音辨識改成 medium。8GB 到 12GB 則適合 Qwen3-8B 搭配較小 TTS,或讓部分元件使用 CPU。若想了解 GGUF、llama.cpp 與 Ollama 的取捨,可以先看 本地大模型推理框架比較。
第一步,在 Windows 準備 WSL 2
這套整合方式把 llama.cpp 放在 Windows,語音與數位人服務放在 Ubuntu 24.04 的 WSL 2。先用系統管理員身分開啟 PowerShell。
wsl --update
wsl --install -d Ubuntu-24.04
Windows 使用者目錄的 .wslconfig 可以設定記憶體與鏡像網路。32GB 是範例,請依實際 RAM 調整,不要把主機記憶體全部交給 WSL。
[wsl2]
memory=32GB
networkingMode=mirrored

[experimental]
hostAddressLoopback=true
修改後重啟 WSL。
wsl --shutdown
進入 Ubuntu 後先用 nvidia-smi 檢查 GPU。NVIDIA 的 Linux 驅動不要再裝進 WSL,CUDA passthrough 由 Windows 顯示卡驅動提供。AMD 顯卡不能照搬這套 CUDA 整合包,需要改走 ROCm 支援的元件,或把無法使用 ROCm 的部分移到 CPU。
專案最好放在 Linux 家目錄,不要直接在 /mnt/c 執行。這能避開 I/O 速度、權限與換行格式問題。
mkdir -p ~/setup
cp -r "/mnt/c/Users/YOUR_NAME/Desktop/AI/." ~/setup/
cd ~/setup
sudo apt update
sudo apt install -y ffmpeg dos2unix python3-venv
dos2unix *.sh
chmod +x *.sh
第二步,用 llama.cpp 啟動 Qwen3
llama.cpp 提供 OpenAI 相容 HTTP 服務,語音管線不必知道底層跑的是 GGUF。16GB 以上可以從 Qwen3-14B 的 Q4_K_M 開始,8GB 到 12GB 建議改成 8B,4GB 到 6GB 則從 4B 測試。
llama-server -m E:\llama.cpp\models\Qwen3-14B-Instruct-Q4_K_M.gguf ^
  -np 1 -c 8192 -fa on --temp 1.0 --top-p 0.95 ^
  --host 0.0.0.0 --port 8090
新版 llama.cpp 文件也開始使用 llama serve 名稱,實際命令要以下載版本為準。Windows 的 8080 有時落在 Hyper-V 保留範圍,所以範例改用 8090。若服務無法綁定,可以先檢查保留埠。
netsh interface ipv4 show excludedportrange protocol=tcp
第三步,安裝即時語音管線
Hugging Face 官方 speech-to-speech 現在以 serve、talk 和 local 為主要命令,舊資料裡的 --mode 已經淘汰。先建立獨立環境,再安裝 faster-whisper 額外依賴。
python3 -m venv ~/venvs/s2s
source ~/venvs/s2s/bin/activate
python -m pip install --upgrade pip
pip install "speech-to-speech[faster-whisper]"
以下範例把 LLM 指向 Windows 上的 llama.cpp。不同版本的 STT 參數名稱可能調整,正式啟動前先執行 speech-to-speech serve --help 對照目前安裝版本。
speech-to-speech serve \
  --stt faster-whisper \
  --stt_model_name large-v3 \
  --language zh \
  --llm_backend responses-api \
  --tts qwen3 \
  --model_name Qwen3-14B-Instruct-Q4_K_M \
  --responses_api_base_url http://127.0.0.1:8090/v1 \
  --responses_api_api_key "" \
  --responses_api_stream \
  --enable_live_transcription
模型全部下載完成後,可以設定 HF_HUB_OFFLINE=1 驗證斷網狀態。這一步比口頭宣稱本地化更可靠,因為只要還有任一個後端指向雲端,就不算完整離線。
第四步,準備 Qwen3-TTS 與參考聲音
Qwen3-TTS 官方最簡單的安裝方式是獨立建立 Python 3.12 環境。它支援聲音克隆、音色設計與串流輸出。更多模型差異和 ComfyUI 節點用法,可以延伸看 Qwen3-TTS 音色設計整理。
conda create -n qwen3-tts python=3.12 -y
conda activate qwen3-tts
pip install -U qwen-tts
參考音訊建議控制在 5 到 15 秒,只留單一說話人,沒有音樂與明顯環境聲。參考文字必須和音訊實際內容完全相同,否則容易出現漏字、錯字與音色漂移。情緒也會一起被模仿,所以不要用過度激動的片段當作一般對話基準。
ffmpeg -i ~/setup/ref.wav -ac 1 -ar 16000 -c:a pcm_s16le ~/s2s/ref.wav
ffprobe -v error -show_entries stream=sample_rate,channels,codec_name \
  -show_entries format=duration -of default=nw=1 ~/s2s/ref.wav
只應克隆自己或已取得明確授權的聲音。把真人聲紋放入公開服務前,也要考慮檔案存取權限、提示注入與未授權冒用。
第五步,製作自然的待機人像
人像素材不適合直接使用張嘴、手擋住嘴巴或劇烈轉頭的畫面。先生成嘴唇閉合、正面或微側面的基準圖,再用 Wan2.2 圖生影片做五秒左右的待機動作。提示詞只描述動作,不要重新描述人物外觀,能減少五官漂移。
電影感 16 比 9 構圖,一位成年東亞女性位於畫面右側三分之一,深色安靜房間,左側保留大量空間,螢幕冷光照亮臉部,輪廓帶柔和暖光,嘴唇自然閉合,雙手不遮擋嘴部,自然皮膚紋理,淺景深,真實攝影質感
負面提示詞
張嘴,說話,露齒,正面平光,明亮背景,過高對比,過度曝光,人物置中,多人,手遮擋嘴部,文字,浮水印,塑膠皮膚,過度修圖,卡通,3D 渲染
待機動畫提示詞
人物保持坐姿,只有細微自然呼吸,緩慢眨眼一次,頭部輕微移動後回到原位,嘴唇全程閉合,鏡頭完全鎖定,沒有縮放,沒有切鏡
關閉自動提示詞增強,輸出比例盡量和原圖相同。Wan2.2 常見原生片段是 81 幀、16 FPS,約五秒。若要二十秒待機,不要期待模型一次生成毫無漂移的長鏡頭,可以在自然停頓點循環短片。其他數位人生成思路可參考 LongCat 數位人工作流。
第六步,安裝 LiveTalking
LiveTalking 官方目前測試的環境是 Ubuntu 24.04、Python 3.12、PyTorch 2.9.1 與 CUDA 12.8。下面命令照官方版本撰寫,但 PyTorch 下載來源仍應配合自己的 CUDA 驅動,不要盲目安裝 cu128。
git clone https://github.com/lipku/LiveTalking.git
cd LiveTalking
conda create -n livetalking python=3.12 -y
conda activate livetalking
pip install torch==2.9.1 torchvision==0.24.1 torchaudio==2.9.1 \
  --index-url https://download.pytorch.org/whl/cu128
pip install -r requirements.txt
下載官方提供的 wav2lip256.pth 後,把它放到 models,並改名成 wav2lip.pth。範例角色資料夾則解壓到 data/avatars。完成後啟動 WebRTC 服務。
python app.py --transport webrtc --model wav2lip \
  --avatar_id wav2lip256_avatar1 \
  --stun 'stun:stun.l.google.com:19302'
瀏覽器開啟 http://localhost:8010/index.html,按下開始連線。正式讓外部裝置使用時,官方提醒需要 TCP 8010 和 WebRTC 使用的 UDP 連接埠。不要直接把整段 UDP 範圍暴露到公網,應優先放在可信任區網、VPN 或經過限制的防火牆環境。
自己製作 Wav2Lip 角色時,可以把短影片轉成 avatar 資料。素材要維持正面可見、光線穩定與嘴部清楚。
python avatars/wav2lip/genavatar.py \
  --video_path data/video/avatar.mp4 \
  --img_size 256 \
  --avatar_id my_avatar
第七步,正確啟動與串接
我會把服務拆成四個終端視窗,照下面順序啟動。每一步都先確認健康狀態,再開下一個服務。
- Windows 啟動 llama.cpp,確認
http://127.0.0.1:8090/v1/models 有回應
- WSL 啟動 Qwen3-TTS 或 speech-to-speech,先完成單句語音測試
- WSL 啟動 LiveTalking,確認 8010 網頁能顯示待機角色
- 最後啟動橋接程式,把 TTS 產生的音訊送入 LiveTalking 的
/humanaudio
作者提供的一鍵整合包包含自訂腳本與橋接程式,並不是 Hugging Face、Qwen 或 LiveTalking 的官方發行版。下載前應先檢查檔案來源、雜湊值、啟動腳本和網路連線,不要把未知執行檔直接放進主要工作電腦。想要長期維護,我更建議從官方專案建立環境,再自行補一個最小橋接層。
WebSocket failed 怎麼排查
- 先確認服務真的啟動。7860、8010 與 8090 是不同服務,瀏覽器頁面存在不代表後端 WebSocket 已連線
- 檢查 WSL 網路。修改
.wslconfig 後一定要執行 wsl --shutdown,鏡像網路與 hostAddressLoopback 才會重新載入
- 確認 Windows 防火牆。先只開必要 TCP 埠,在同一台電腦測通後再處理區網
- 不要混用 localhost。容器、WSL 與 Windows 各自看到的
127.0.0.1 可能不是同一個服務
- 確認瀏覽器麥克風權限。遠端網頁通常需要 HTTPS 或 localhost 才能取得安全的麥克風權限
- 降低 Noise Gate。如果網頁已連線但偵測不到聲音,先關閉門檻測試,再逐步調高
- 調整 VAD 停頓。約 900 到 1200 毫秒比較不容易搶話,但設定越長,回答開始時間也越慢
可以改成真正的 3D 角色嗎
可以,但不是把 Wav2Lip 模型換成一個 3D 檔案就完成。現在這條路線以 2D 影像或待機影片為基礎,口型模型直接修改臉部像素。真正的 3D 角色需要另外加入 Unity、Unreal Engine 或 WebGL renderer,再把 TTS 音訊轉成 viseme、音素或 blendshape 權重,驅動角色的嘴型、表情、眼神與骨架。
保留 VAD、Whisper、Qwen3 與 Qwen3-TTS,替換最後一層即可。新的輸出流程會變成 TTS 音訊、音素時間軸、3D blendshape、即時 renderer。若只是想讓角色有更豐富動作,可以先使用 LiveTalking 的自訂動作設定或多段待機素材,成本會比完整 3D 低很多。
本地不等於沒有風險
角色資料、聲音與對話都留在本機,確實能降低資料送往雲端的風險。但只要把服務開到區網或公網,就要重新考慮驗證、連接埠、惡意音訊、提示注入與檔案上傳。對話記憶也不是安裝完成就會永久存在,長期記憶需要另外接資料庫、摘要或向量檢索,否則聊天變長後仍可能忘記前文或開始胡亂延伸。
LiveTalking 官方也明確要求,使用此專案製作並發布到平台的內容必須包含 LiveTalking 浮水印與標誌。正式商用前要再確認每個模型、角色素材、聲音和整合程式的授權,不要只看程式能不能跑。
官方資源與參考資料
FAQ
8GB 顯存真的可以跑本地 AI 數位人嗎
可以做出可用版本,但不適合讓 14B LLM、large-v3、1.7B TTS 與口型模型全部以高規格同時常駐。建議改用 Qwen3-8B 或 4B 量化版、較小 TTS、較低 batch,必要時把部分模型放到 CPU。
可以完全離線,不使用任何 API 嗎
可以。前提是 STT、LLM、TTS 和數位人全部使用本地後端,而且模型與依賴已下載完成。設定 HF_HUB_OFFLINE=1 並在斷網環境測試,才能確認沒有隱藏的雲端依賴。
可以用英文或其他語言聊天嗎
可以,但 STT、LLM 與 TTS 三層都要支援目標語言。Whisper 與 Qwen3 的多語能力較完整,最終自然度通常由 TTS 音色與參考音訊決定。中英混合時要額外測試專有名詞、數字與語速。
Mac 可以照這篇安裝嗎
不能原封不動照做,因為本文整合路線依賴 Windows、WSL 與 CUDA。llama.cpp、Whisper 和部分 speech-to-speech 元件可以改走 Apple Silicon 的 Metal 或 MLX,但 LiveTalking 口型模型與整合腳本需要另外確認 macOS 支援,不能直接套用 NVIDIA 命令。
最後怎麼選
如果只是想快速聊天,雲端語音助手會更省時間。如果需求是讓私人對話留在本機、建立固定角色、接自己的資料或研究數位人介面,這套模組化管線就很值得做。我的建議是先讓文字對話跑通,再加入 STT 和 TTS,最後才接 LiveTalking。一次啟動所有元件,只會讓錯誤來源變得難以判斷。
真正值得學會的不是某個一鍵包,而是知道聲音在哪裡變成文字,回答在哪裡生成,音色在哪裡被控制,口型又由哪一個服務驅動。把這五層拆清楚後,未來換模型、換角色、換前端,整套系統仍然能繼續使用。
by Rain Chu | 8 月 19, 2026 | AI, GGUF, QWEN, 模型
Qwen3.8-27B 把文字、圖片、影片、程式設計與 Agent 工作流放進同一個稠密模型,對想把 AI 留在本機的人來說,這是一個能力和硬體成本相對平衡的新選擇。
16GB 顯卡不要直接選 Q4_K_M,因為 15.9 GiB 只是主模型檔案,還沒有算約 0.86 GiB 的視覺投影模型、KV Cache 與執行環境。比較實際的選擇是 Q3_K_M 或 UD-Q3_K_XL,再從 8K 上下文開始測試。8GB 顯卡雖然可以用極低位元量化搭配系統記憶體卸載,但不等於 27B 多模態模型能完整放進 8GB 顯示記憶體。
Qwen3.8-27B 是什麼
Qwen3.8-27B 官方模型採用 Apache 2.0 授權,是一個 27B 參數的稠密視覺語言模型,它不是只會聊天的純文字模型,而是原生理解圖片與影片,也把程式設計、專業工作、研究和長時間 Agent 任務列為主要能力。
- 27B 稠密模型,64 層,Hidden Dimension 為 5120
- 原生支援圖片與影片理解
- 原生上下文長度 262,144 tokens,可透過 YaRN 延伸到 1,000,000 tokens
- 支援思考與非思考模式,也能用 reasoning_effort 調整推理深度
- 訓練時加入多步 MTP,執行環境支援時可用於推測解碼
如果你正在比較本地模型,建議先看站內的Qwen 3.6 的 27B、35B、MXFP8 與 NVFP4 比較,Qwen3.8-27B 延續 27B 稠密模型的定位,但多模態、Agent 執行和思考控制都更完整。
MTP 和 noMTP 差在哪裡
MTP 是 Multi-Token Prediction,一般自迴歸模型每次產生一個 token,MTP 會另外預測後續多個候選 token,再由主模型驗證,推理框架支援推測解碼時,可以減少逐 token 等待的成本,提升生成速度。
Qwen3.8-27B 的官方架構包含 MTP,Unsloth 的 Qwen3.8 指南也提供 MTP 量化版本,noMTP 通常是社群為了相容性或降低額外負擔而移除 MTP 預測頭的版本,你的 llama.cpp 太舊、載入失敗,或記憶體非常緊時,可以把 noMTP 當作相容性選項。新版推理環境能正常使用 MTP 時,則優先保留。
16GB 顯卡該下載哪一個 GGUF
| 可用記憶體 | 建議量化 | 主模型大小 | 實際建議 |
|---|
| 8GB | UD-IQ2_XXS | 約 8.4 GiB | 仍需系統記憶體卸載,不建議當作完整多模態體驗 |
| 12GB | UD-IQ2_M 或 Q3_K_S | 約 9.6 到 11.7 GiB | 使用短上下文,接受較明顯的量化損失 |
| 16GB | Q3_K_M 或 UD-Q3_K_XL | 約 12.9 或 12.5 GiB | 最實際的平衡,先用 8K 上下文 |
| 24GB | Q4_K_M 或 Q5_K_M | 約 15.9 或 18.5 GiB | 能保留較好的品質,也有空間給視覺與 KV Cache |
| 32GB | Q6_K 或 Q8_0 | 約 21.3 或 27.1 GiB | 適合重視品質與較長上下文的使用者 |
檔案大小依 Unsloth Hugging Face 儲存庫計算,實際記憶體還要加上視覺投影模型、KV Cache 與執行環境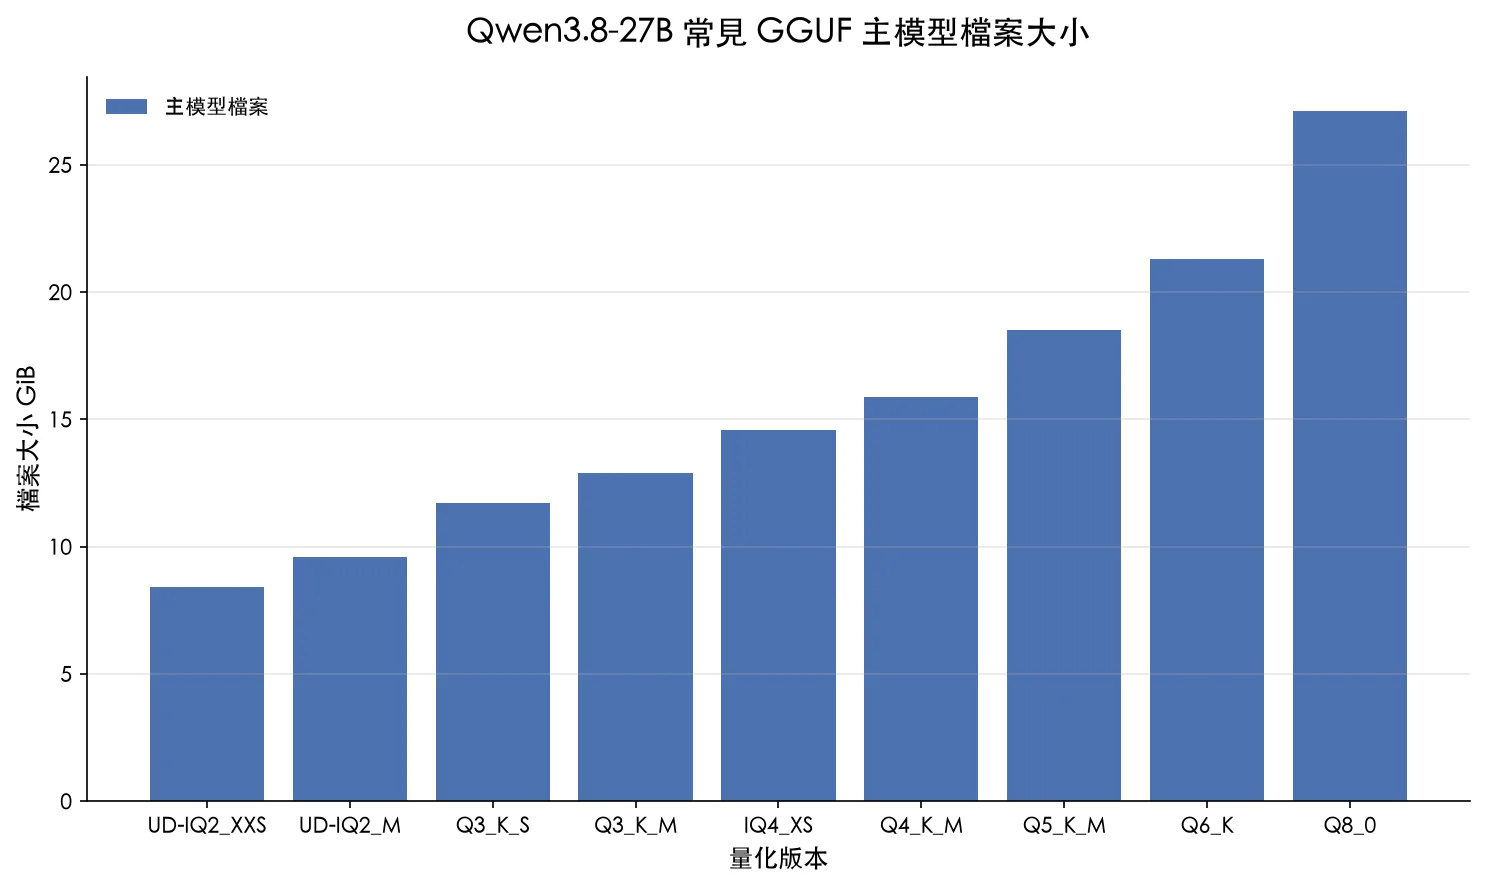 主模型從 8.4 GiB 的 2-bit 到 27.1 GiB 的 Q8_0,數字不包含額外執行記憶體
Q4_K_M 的檔案約 15.9 GiB,看起來很接近 16GB,但視覺功能還需要 mmproj-F16.gguf,檔案約 0.86 GiB,再加上 KV Cache 後,16GB 顯卡通常沒有足夠餘裕。若只跑文字、上下文很短,而且願意部分卸載到系統記憶體,IQ4_XS 可能可以啟動,但這不是我會給一般使用者的預設建議。
量化位元越低,檔案越小,但指令遵循、長文本穩定性、程式正確率和視覺判斷都可能下降。16GB 使用者如果重視穩定性,有時候選較小參數模型的 4-bit 或 8-bit,會比硬塞 27B 的 2-bit 更實用。
用 llama.cpp 在本機啟動
個人電腦要跑 GGUF,llama.cpp 仍然是很直接的底座。Windows 使用者可以從 llama.cpp Releases 下載對應版本,NVIDIA 顯卡選 CUDA,AMD 顯卡可用 Vulkan,沒有獨立顯卡則選 CPU 版本,框架定位和差異可以延伸閱讀vLLM、SGLang、llama.cpp、MLX 與 Ollama 比較。
一 下載主模型與視覺投影模型
pip install -U "huggingface_hub[cli]"

hf download unsloth/Qwen3.8-27B-GGUF \
  Qwen3.8-27B-Q3_K_M.gguf \
  mmproj-F16.gguf \
  --local-dir Qwen3.8-27B-GGUF
24GB 顯卡可以把 Q3_K_M 換成 Q4_K_M。只處理文字時可以先不載入 mmproj,等基本對話穩定後再加入視覺功能。
二 啟動 OpenAI 相容端點
llama-server \
  --model Qwen3.8-27B-GGUF/Qwen3.8-27B-Q3_K_M.gguf \
  --mmproj Qwen3.8-27B-GGUF/mmproj-F16.gguf \
  --host 127.0.0.1 \
  --port 8080 \
  --ctx-size 8192 \
  --n-gpu-layers 99 \
  --jinja \
  --chat-template-kwargs '{"reasoning_effort":"medium"}'
Windows 請把執行檔改成 llama-server.exe。若出現記憶體不足,先把上下文從 8192 降到 4096,再考慮換更小的量化。不要一開始就把 262K 全開,長上下文的 KV Cache 會快速增加記憶體需求。
三 測試 API
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen3.8-27B","messages":[{"role":"user","content":"請用繁體中文列出三個本地部署注意事項"}]}'
能收到 JSON 回應,就代表本地端點已經可以交給其他工具使用,想把開發環境完全留在本機,也可以參考Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境。
接到 Hermes Agent
llama-server 啟動後,可以在 Hermes Agent 的模型提供方加入本地自訂端點,Base URL 填入 http://127.0.0.1:8080/v1,如果介面要求 API Key,可以填一個只供本機識別的非空字串,模型清單出現 Qwen3.8-27B 後,就能把它用在網站製作、檔案處理、程式生成與瀏覽器檢查等 Agent 任務。
本地模型接 Agent 的價值在於資料不用先送到外部 API,也能降低大量反覆呼叫的成本。不過模型一旦拿到終端機、瀏覽器和檔案權限,風險也會跟著放大。Hermes 的代理層與 LINE 整合可以延伸閱讀Hermes Proxy 與 Hermes Agent 支援 LINE。
程式、視覺與 Agent 能力怎麼看
一個單檔 HTML 飛行遊戲可以同時產生畫面、操作、儀表與聲音,代表 27B 模型已經能完成有一定複雜度的前端原型,圖片計數測試也能辨識出 25 根筷子,並區分 6 根彩色與 19 根銀色,接到 Agent 後,還能建立帶搜尋、排序與模型卡片的網站,再開啟瀏覽器檢查介面。
這些結果適合當作能力檢查,不適合直接當成通用 benchmark,單一提示、單一圖片與單一硬體都可能讓結果偏高或偏低。真正要採用前,應該用自己的程式庫、文件、圖片和 Agent 權限做一組固定測試,記錄成功率、速度與記憶體峰值。
無審查版本不是官方安全模式
所謂無審查或 Uncensored 版本通常是社群修改、微調或去除拒答傾向的衍生模型,不是 Qwen 官方提供的安全開關,它比較少拒絕,不代表答案更正確,也不代表可以放心交給有系統權限的 Agent。
- 先在沒有正式帳密與重要檔案的環境測試
- 工具採用允許清單,不要直接給完整終端機與管理員權限
- 寫檔、執行命令、付款與對外發布都要保留人工確認
- 本地 API 預設只綁定 127.0.0.1,不要直接暴露到網際網路
- 保存工具呼叫紀錄,發生異常時能回溯
如果用途只是寫作或私人角色扮演,可以把衍生模型放在沒有工具權限的聊天環境。需要操作檔案、瀏覽器或伺服器時,優先使用官方模型並限制權限,通常會更穩妥。
我的選擇建議
16GB 顯卡從 Q3_K_M、8K 上下文和官方版本開始。24GB 顯卡可選 Q4_K_M,並保留足夠空間給 mmproj 與 KV Cache。50 系列 Blackwell 顯卡如果要做正式服務,可以研究 NVFP4 與 vLLM。一般個人使用者則先用 GGUF 和 llama.cpp,把模型穩定跑起來,再決定是否需要 Hermes Agent、長上下文或 MTP。
Qwen3.8-27B 的重點不是單純追求更大模型,而是把多模態、程式能力和 Agent 執行放進個人可負擔的硬體範圍。選對量化、控制上下文、限制工具權限,才是本地部署真正能長期使用的關鍵。
FAQ
MTP 一定比較快嗎
只有推理框架正確支援推測解碼時才會發揮效果。框架版本、硬體與批次大小都會影響實際速度,不能只看檔名判斷。
可以用 Ollama 或 LM Studio 嗎
可以,只要版本已支援 Qwen3.8 架構與對應 GGUF。想控制 MTP、mmproj、KV Cache 與細部參數時,llama.cpp 通常更透明。
本地模型接 Hermes Agent 安全嗎
模型資料可以留在本機,但工具權限仍然需要管理。使用 127.0.0.1、工具允許清單、人工確認與執行紀錄,可以大幅降低風險。
參考資料

by Rain Chu | 7 月 14, 2026 | AI, QWEN, 模型
NVFP4 和 MTP 最近被放在一起討論,原因很簡單:本地大模型推理開始從「能不能放進顯存」進入「怎麼把記憶體搬運成本壓到最低」的階段,Unsloth 釋出的 Qwen3.6 NVFP4 quants 主打 27B 模型可在 24GB VRAM 上運行,35B-A3B 在 B200 上可達 17,561 tok/s,並宣稱相對 NVIDIA NVFP4 quant 有 2.5 倍速度提升。
這些數字很吸引人,但不能直接翻譯成「買 RTX 5090 就一定變快」。真正該看的,是 NVFP4 和 INT4 的格式差異、MTP 如何降低推理瓶頸,以及消費級 Blackwell 現階段為什麼可能吃不到企業級 B200 的完整紅利。
先講結論
- NVFP4 是 4 位元浮點量化,不是傳統 4 位元整數量化
- INT4 的刻度固定,NVFP4 的浮點表示更適合保留權重動態範圍
- MTP 是多 Token 預測,重點是減少每個 token 都重新搬一次權重的浪費
- 17,561 tok/s 是特定企業級硬體條件下的吞吐量,不是一般 RTX 50 的保證值
- 企業部署時,驅動、CUDA、vLLM、llama.cpp、環境變數和自動更新都可能比模型本身更容易出事
如果你之前看過我整理的 Qwen 3.6、MXFP8、NVFP4 比較,這篇可以當成補充版,前一篇偏選型,這篇偏底層原因和部署風險。
NVFP4 和傳統 INT4 差在哪
INT4 是 4 位元整數量化。你可以把它想成一把固定刻度的尺,每一格距離都一樣。問題是神經網路權重分布通常不是均勻的,很多重要數值會擠在接近零的位置,也會偶爾出現比較大的極端值。固定刻度很省空間,但容易犧牲細微權重差異。
NVFP4 則是 4 位元浮點量化,它仍然只用 4 位元,但用浮點格式表達數值,能用有限 bit 描述更大的動態範圍,小數值區域可以保留比較細的變化,大數值區域則用比較寬的範圍表示,這就是為什麼 NVFP4 在某些模型上可以比傳統 INT4 更接近原始權重的行為。

| 項目 | NVFP4 | 傳統 INT4 |
|---|
| 數值格式 | 4 位元浮點 | 4 位元整數 |
| 刻度特性 | 動態範圍 | 固定刻度 |
| 細節保留 | 較能保留小數值 | 細微權重較易流失 |
| 硬體依賴 | 需要 FP4 支援與 kernel 最佳化 | 生態成熟 |
| 實務風險 | 新硬體仍看驅動成熟度 | 穩定但精度較受限 |
這裡要補一個很重要的判斷:NVFP4 不是自動贏 INT4。若硬體、驅動、kernel、推理框架都沒有最佳化,NVFP4 可能反而更慢。格式更先進,不代表你手上的卡和軟體棧已經準備好了。
MTP 為什麼會讓速度暴衝
MTP 是 Multi-Token Prediction,也就是多 Token 預測。傳統自回歸語言模型通常一次產生一個 token。每產生一個 token,都要讀取大量模型權重,再做一次運算。對大模型來說,很多時間不是花在純計算,而是花在權重從顯存搬到運算核心的路上。
MTP 的核心思路,是在一次權重讀取裡嘗試預測多個後續 token。它不是讓模型魔法般跳過推理,而是把原本每一步都要重複付出的記憶體傳輸成本攤薄。當瓶頸主要在顯存頻寬和權重搬運時,這種方式就能明顯提高吞吐量。
Reddit 原始討論裡也有人問 MTP 是否已加入,Unsloth 相關回覆指出 MTP 已經在裡面,並且有說法提到 MTP tensors 已直接內建到 quants 中。這表示使用者不只是拿到一個 NVFP4 量化權重,而是拿到帶有 MTP 加速路徑的版本。
2.5 倍速度提升要怎麼看
這次最容易被誤讀的是「2.5 倍」。Reddit 討論中有人問這個速度提升是不是相對 Q4,Unsloth 回覆脈絡指出,這個比較是相對 NVIDIA 的 NVFP4 quant,而不是拿所有 Q4 或 INT4 實作一起比較。這一點很重要,因為不同量化格式、不同框架、不同 GPU、不同 batch 和 context 設定,都會影響 token/s。
另外,35B-A3B 達到 17,561 tok/s 的數字是在 B200 這類企業級硬體條件下出現。這可以說明 NVFP4 和 MTP 的上限很高,但不代表一般 RTX 50 系列能直接複製。企業採購或本地部署,最怕把資料中心卡的極限數字誤當成桌機卡的常態表現。
為什麼 RTX 50 可能反而沒有變快
同樣叫 Blackwell,不代表所有 Blackwell 都一樣。B200 屬於資料中心路線,軟體路徑和底層 kernel 通常優先被最佳化。RTX 50 消費級卡雖然也有新架構能力,但 SM120 的軟體支援成熟度可能還沒跟上。
Reddit 討論中有人提到,消費級 Blackwell 的 NVFP4 利用率仍可能不理想,也有人實測 NVIDIA NVFP4 Qwen3.6 27B 對比原本 INT4 時,token 生成速度不但沒有提升,還有下降的案例。這些不是說 NVFP4 沒用,而是說「硬體支援」和「軟體真的最佳化」中間有一段距離。
如果你正在看 RTX 5090、5080 或 5060 Ti 類配置,不要只看 NVFP4 四個字。你要確認推理框架是否真的支援你的 GPU、驅動和 CUDA 是否符合要求、實際模型是否有對應 kernel,還要看你的工作負載是 prompt processing 重,還是 token generation 重。
企業部署最容易踩到的不是模型,而是環境
這類極限加速模型最怕直接上正式環境。逐字稿和社群討論都提到一個共通風險:推理框架和底層格式更新太快,vLLM、CUDA、驅動、模型權重、環境變數任何一層沒對上,都可能變慢甚至崩潰。
我會把部署流程拆成四步。第一步先在單機沙盒測模型能不能正常跑。第二步測固定 prompt、長上下文、工具調用和 agent loop。第三步鎖定版本,關掉正式環境自動更新。第四步再進入內部 PoC。這和我之前整理的 本地大模型推理框架選型 是同一個邏輯,速度只是其中一個指標,穩定性才決定能不能上線。
- 正式環境不要開自動更新
- 先鎖定 CUDA、driver、vLLM 或 llama.cpp 版本
- 不要把 B200 benchmark 直接套到 RTX 50 採購決策
- 工具調用和 agent 流程要單獨壓測
- 用 24GB VRAM 跑 27B 可以測,但不代表企業就一定該選最大模型
為什麼 9B 和 GGUF 反而更實用
當大家看到 27B 可塞進 24GB VRAM,甚至 35B-A3B 跑出極限吞吐量,很容易以為模型越大越好。但真正落地時,很多企業只需要工單分類、客服輔助、內部文件查詢、簡單自動化。這些任務未必需要 27B 或 35B。
9B 模型的價值在於部署門檻更低,可以放進 12GB 或 16GB 顯卡,還能保留更多 VRAM 給上下文和工具調用。GGUF 則讓 llama.cpp 這類本地推理路線更容易接上 CPU 或低階硬體。這也是為什麼社群一邊討論 17,561 tok/s,一邊仍然敲碗 9B 和 GGUF 版本。
對中小企業來說,我會優先問三個問題。你的資料是否需要完全本地化,你的任務是否真的需要大模型,你是否有能力維護最新 GPU kernel 和推理框架。如果答案不明確,小模型加穩定部署,通常比追逐極限跑分更務實。
我的判斷
NVFP4 和 MTP 很重要,因為它們代表本地 AI 推理正在處理真正的瓶頸:顯存容量、權重搬運、吞吐量和模型品質之間的平衡。NVFP4 解決的是低 bit 量化下如何保留更多數值動態範圍,MTP 解決的是一次只吐一個 token 帶來的記憶體傳輸浪費。
但我不會把它解讀成「RTX 玩家立刻起飛」。比較健康的看法是:資料中心硬體已經看到 NVFP4 和 MTP 的上限,消費級硬體還在等軟體棧補齊。現在要採購或部署,應該把 PoC、版本鎖定、框架支援和真實任務測試放在跑分前面。
真正值得期待的是,這些技術成熟後,27B 不再只能放在機房裡,9B 和 GGUF 也能讓更小的團隊取得足夠好用的本地 AI。極限跑分很好看,但真正改變企業日常的,通常是穩定、便宜、好維護的那一條路。
延伸資源
FAQ
NVFP4 是什麼?
NVFP4 是 NVIDIA 4 位元浮點量化格式。它和 INT4 一樣節省記憶體,但用浮點方式表達數值,較適合保留神經網路權重中的動態範圍。
NVFP4 和 INT4 最大差異是什麼?
INT4 是固定刻度的整數量化,NVFP4 是 4 位元浮點量化。前者生態成熟,後者更依賴硬體 FP4 支援和軟體 kernel 最佳化。
MTP 是什麼?
MTP 是 Multi-Token Prediction,多 Token 預測。它讓模型在一次權重讀取中嘗試預測多個後續 token,降低記憶體傳輸瓶頸,提高吞吐量。
近期留言