by Rain Chu | 9 月 27, 2026 | Agent, AI, 程式開發
Pi Agent 非常適合想自己決定 AI 寫程式流程的人,它把讀檔、寫檔、修改與執行命令放在小巧的核心裡,再透過擴充與模型設定增加能力,真正有用的地方,是你可以在同一段工作裡切換模型,回到先前的對話節點,重新探索另一種方案。
但輕量不代表不用設定,也不保證每次都比較省錢,要先分清楚擴充程式、專案規則、對話紀錄與檔案版本各自負責什麼,後續才不會把對話切回去了,卻以為程式碼也自動還原。
Pi Agent 是什麼?先理解它負責哪一層
Pi Agent是一套以終端機為主的 AI Coding Agent,也常被稱為 Agent Harness。
你可以把 Harness 理解成模型的工作環境,負責把請求、上下文、工具呼叫與執行結果串起來。模型決定下一步,Pi 則讓它能接觸專案檔案與工具。
預設核心工具是 read、write、edit 與 bash。計畫模式、子代理與 MCP 整合不是核心預設配備,可以再用擴充或套件補上。因此,適合的起手式是先用基本能力完成小任務,再增加確實需要的功能。
Pi 也提供不同的接入方式,日常操作用互動終端介面,單次自動化可用 print 或 JSON 輸出,需要其他程式控制時可走 RPC,想嵌入自己的應用則使用 SDK。
RPC 文件與SDK 文件適合留到需要整合時再看。
安裝 Pi Agent:使用目前官方套件名稱
截至 2026 年 9 月 12 日,官方快速入門採用的 npm 套件名稱是 @earendil-works/pi-coding-agent。較舊教學可能使用不同命名,請以官網當下的指令為準。
目前套件設定要求 Node.js 22.19.0 以上,安裝前先確認環境。
node --version
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi --version
--ignore-scripts 會停用安裝期間的套件生命週期腳本,官方說明一般 npm 安裝不需要這些腳本。看到版本資訊後,切換到要處理的專案目錄,再啟動 Pi。
cd /path/to/your-project
pi
上面的專案路徑要換成自己的資料夾,第一次練習可使用測試專案,先請它整理目錄、說明啟動方式與現有檢查項目,確認理解正確後再開始改程式。這樣也比較容易看出模型是否能正確使用工具。
模型接入:登入、API Key 與自訂端點分開處理
進入 Pi 後,先用 /login 設定模型服務,再用 /model 選擇模型,服務商文件列有訂閱登入與 API Key 兩種主要方式,可用選項取決於服務商、帳號與目前版本。
常用設定位於 ~/.pi/agent/。auth.json 保存驗證資料,models.json 用來加入自訂模型或端點,settings.json 管理偏好,sessions/ 保存對話。
專案自己的偏好放在 .pi/settings.json,有助於把個人習慣和團隊設定分開。
如果模型服務使用支援的相容 API,可依自訂模型文件填入端點、API 類型與模型 ID。
以下是設定結構範例,網址與模型名稱都是待替換值,不是可直接連線的服務。
{
  "providers": {
    "my-provider": {
      "baseUrl": "https://your-provider.example/v1",
      "api": "openai-completions",
      "apiKey": "$MY_PROVIDER_API_KEY",
      "models": [
        {
          "id": "your-model-id"
        }
      ]
    }
  }
}
將真正的金鑰放進 MY_PROVIDER_API_KEY 環境變數,設定檔保留變數參照即可。修改 models.json 後重新開啟 /model,Pi 會重新讀取。模型沒出現時,依序檢查 JSON 格式、驗證資料、模型 ID 與 API 類型。端點能聊天,也不一定代表工具呼叫完全相容。
Extension、Skill 與 Package 差在哪裡?
Extension 是會執行的擴充程式,通常以 TypeScript 撰寫,可以註冊工具、加入斜線命令、監聽事件、調整終端介面,或改變工具執行方式,例如,替特定命令增加確認流程,就是執行時的能力。
擴充文件提供 API 與範例。
Skill 是可重複使用的工作方法。它把說明與相關資源整理成一個任務單元,適合審稿、部署檢查或特定程式庫的使用流程,Pi 先讓模型知道有哪些技能,需要時再讀取完整內容。,看如何把方法寫成可重用流程,可以延伸閱讀站內的diagram-design 技能教學,再對照Pi 的技能載入規則調整。
Package 是安裝與分享的容器。它可以同時包含 Extension、Skill、提示詞範本與主題,也可以只有其中一種。
Pi Package 文件規定資源可在 package.json 的 pi 欄位宣告,或使用約定目錄。
Extension 和 Package 因此不是二選一的替代品。
安裝前先看套件作者、原始碼與支援版本,pi install 預設寫入個人設定,加上 -l 則用於專案範圍。可以用 pi list 檢查已安裝套件,資源修改後用 /reload 重新載入。
AGENTS.md 怎麼分層?override 只取代同層檔案
Pi 會在啟動時載入全域、父目錄與目前目錄的上下文檔案。全域的 ~/.pi/agent/AGENTS.md 可放常用語言與共通習慣,專案的 AGENTS.md 則放技術選擇、執行方式與驗收條件。
啟動畫面會列出已載入的檔案,可先核對是否符合預期。
依官方使用說明,同一個目錄若有 AGENTS.override.md,Pi 會改讀它,取代該目錄的 AGENTS.md 或 CLAUDE.md。
其他目錄的上下文仍會一起載入。這不能簡化成「有 override 就清空全部規則」,也不宜只靠一句優先級口訣管理互相矛盾的要求。
以賽車遊戲為例,專案規則可以寫得很具體,先限制第一版的範圍,再定義怎樣算完成。
# 專案工作規則

- 使用現有專案的技術,不另換框架
- 第一版先完成操作、碰撞、計時與重新開始
- 相機視角需先確認,再實作渲染方式
- 修改後執行專案既有檢查
- 回報改動、驗證結果與尚未解決的問題
這些是給模型讀取的指示,不是作業系統的權限限制。
若還有跨專案的知識要保存,可參考讓不同 Agent 共用專案知識的方式,避免把所有背景資料塞進每次啟動都載入的檔案。
專案信任不等於沙箱,pi-sandbox 也有適用範圍
Pi 的專案信任機制,決定是否載入專案內的設定、技能、套件與擴充,單純建立空的 .pi 目錄,不一定會出現信任提示,拒絕信任後,受保護的專案資源會略過,但 AGENTS.md 等上下文仍可能載入。
官方安全文件明確說明,這套機制不是沙箱。
Pi 本身會以啟動帳號的權限讀寫檔案與執行命令。若需要執行隔離,應依工作情境選擇容器、虛擬機或作業系統層的沙箱,只在提示詞裡要求「不要碰其他檔案」,不能取代這些限制。
carderne 的 pi-sandbox是一個可選的第三方擴充,為檔案工具加入規則,並透過 sandbox runtime 控制 Bash 的檔案與網路存取。它會在部分被擋下的操作上顯示授權提示。確認作者與套件名稱後,可依其文件安裝。
pi install npm:pi-sandbox
這個套件的 macOS 與 Linux 說明要求環境能找到 rg,設定位置包含全域的 ~/.pi/agent/sandbox.json 與專案的 .pi/sandbox.json。不同同名專案的格式不一定相同,不要混用範例。
Session Tree:保留探索路徑,也要另外保存程式碼
Pi 將對話存成樹狀 JSONL,預設放在 ~/.pi/agent/sessions/,並按工作目錄整理。每筆紀錄透過 ID 與父節點連接,因此可以在同一段對話裡保留不同嘗試。Session 文件對分支與選取行為有完整說明。
pi -c
pi -r
pi --name "racing-game-prototype"
上面三行是不同的啟動方式,依需要擇一。
pi -c 延續最近的對話,pi -r 選擇歷史紀錄,--name 則為啟動的對話設定名稱。進入 Pi 後,也可以用 /session 查看目前紀錄。
/tree 在同一份對話檔案內切換路徑,選取先前的使用者訊息時,原文字會回到編輯區,修改後送出就能展開另一條分支。若想從先前某個問題建立獨立對話,用 /fork,若要複製目前整條使用中的分支,則可用 /clone。
對話樹保存的是討論歷史,不能視為程式碼快照,切回舊節點時,磁碟上的檔案仍可能保留後續修改,要比較兩種實作,應另外使用 Git commit、分支、worktree 或獨立副本保存成果,再確認目前工作目錄和所選對話相符。
切換分支時,Pi 可以摘要離開的路徑,將重要資訊帶到新位置,若是同一需求的改良版,可保留問題與結論。若要獨立比較方案,則要留意摘要是否把原方案的假設帶了過去,長對話也可用 /compact 整理上下文,但摘要會取捨資訊,關鍵規格仍適合寫回專案文件。
用賽車原型練習:先計畫、再審查、最後驗收
一個好練習,是讓 Pi 先規劃俯視賽車原型,再嘗試固定追尾視角。重點不是一次做出完整遊戲,而是讓需求變動時,仍能追溯決策與保留可用版本。
第一步:先把驗收條件講清楚
先要求它列出操作方式、相機位置、碰撞、計時與重新開始等最小功能,暫時不要實作。把「做一個好玩的遊戲」改成可以檢查的條件,例如按鍵方向一致、失敗後能重新開始、相機不因轉彎而失去方向感。
第二步:切換模型審查計畫
用 /model 切到另一個模型,請它檢查計畫中缺少的條件、技術風險與需要確認的選項。這是同一段對話中的模型交接,不是同時啟動多個代理。分工可以是較快的模型整理方案、另一個模型審查關鍵設計,但是否更划算,需要用自己的任務驗證。
第三步:跑起來,檢查可操作性
程式生成後,要實際啟動並檢查操作、碰撞與視角。能開啟頁面,只代表基本流程可執行,不代表遊戲已完成。若俯視版本相機不穩,先保存檔案版本,再用 /tree 回到需求確認點,提出固定追尾視角的新方案。
執行途中想補充方向,可以送出 steering 訊息。想等目前工作完成後再追加任務,則使用 follow-up。預設快捷鍵分別是 Enter 與 Alt+Enter,實際可用 /hotkeys 確認。排隊訊息不是撤銷已執行操作的功能,緊急停止與後續修正仍要分開處理。
Pi 和 Hermes 怎麼選?先看你想完成哪種工作
Pi 適合想掌握本地開發流程、逐步組裝能力,或把 Agent 嵌入自己應用的使用者,Hermes Agent則提供記憶、技能累積、通訊平台接入與排程等較完整的個人助理能力。這是產品方向的差異,不足以直接推論哪一個寫程式一定比較強。
如果需求是從通訊軟體交辦長期工作,可以先看看站內的Hermes 與通訊平台整合,如果主要工作是對著專案反覆改程式,Pi 的對話樹與可擴充介面值得試用,偏好圖形工作台的人,也可比較OpenWork 本地 Agent 工作台的操作方式。
成本方面,不能只比較初始系統提示詞的長度,完整帳單還受模型價格、工具輸出、重試次數、快取與最後是否完成任務影響,Pi 顯示的用量和費用適合追蹤趨勢,自訂模型的價格設定也要正確,結算仍以服務商帳單為準。
常見問題
Pi Agent 是模型嗎?
不是。Pi 是讓模型讀寫檔案、呼叫工具與管理對話的工作環境,需要另外接入可用的模型服務。
Pi Agent 的 Extension 和 Package 有什麼不同?
Extension 是執行時的擴充程式,Package 是安裝與分享資源的容器,可以包含擴充、技能、提示詞與主題。
AGENTS.override.md 會取代所有規則嗎?
不會。它取代同一目錄的 AGENTS.md 或 CLAUDE.md,其他目錄的上下文仍會載入。
Pi 的 /tree 會還原專案檔案嗎?
不能把 /tree 當成檔案還原工具。它切換對話路徑,程式碼版本需要另外用 Git 或其他快照方式保存。
第一次使用,先完成一個能驗收的小任務
先接通一個模型,寫一份精簡的專案規則,請 Pi 完成小修改並說明驗證結果。熟悉之後,再加入真正需要的擴充,練習模型交接與對話分支。當每次嘗試都有清楚的需求、可追溯的討論與獨立保存的檔案版本,這套輕量工具才會成為可靠的開發流程。
by Rain Chu | 8 月 19, 2026 | AI, GGUF, QWEN, 模型
Qwen3.8-27B 把文字、圖片、影片、程式設計與 Agent 工作流放進同一個稠密模型,對想把 AI 留在本機的人來說,這是一個能力和硬體成本相對平衡的新選擇。
16GB 顯卡不要直接選 Q4_K_M,因為 15.9 GiB 只是主模型檔案,還沒有算約 0.86 GiB 的視覺投影模型、KV Cache 與執行環境。比較實際的選擇是 Q3_K_M 或 UD-Q3_K_XL,再從 8K 上下文開始測試。8GB 顯卡雖然可以用極低位元量化搭配系統記憶體卸載,但不等於 27B 多模態模型能完整放進 8GB 顯示記憶體。
Qwen3.8-27B 是什麼
Qwen3.8-27B 官方模型採用 Apache 2.0 授權,是一個 27B 參數的稠密視覺語言模型,它不是只會聊天的純文字模型,而是原生理解圖片與影片,也把程式設計、專業工作、研究和長時間 Agent 任務列為主要能力。
- 27B 稠密模型,64 層,Hidden Dimension 為 5120
- 原生支援圖片與影片理解
- 原生上下文長度 262,144 tokens,可透過 YaRN 延伸到 1,000,000 tokens
- 支援思考與非思考模式,也能用 reasoning_effort 調整推理深度
- 訓練時加入多步 MTP,執行環境支援時可用於推測解碼
如果你正在比較本地模型,建議先看站內的Qwen 3.6 的 27B、35B、MXFP8 與 NVFP4 比較,Qwen3.8-27B 延續 27B 稠密模型的定位,但多模態、Agent 執行和思考控制都更完整。
MTP 和 noMTP 差在哪裡
MTP 是 Multi-Token Prediction,一般自迴歸模型每次產生一個 token,MTP 會另外預測後續多個候選 token,再由主模型驗證,推理框架支援推測解碼時,可以減少逐 token 等待的成本,提升生成速度。
Qwen3.8-27B 的官方架構包含 MTP,Unsloth 的 Qwen3.8 指南也提供 MTP 量化版本,noMTP 通常是社群為了相容性或降低額外負擔而移除 MTP 預測頭的版本,你的 llama.cpp 太舊、載入失敗,或記憶體非常緊時,可以把 noMTP 當作相容性選項。新版推理環境能正常使用 MTP 時,則優先保留。
16GB 顯卡該下載哪一個 GGUF
| 可用記憶體 | 建議量化 | 主模型大小 | 實際建議 |
|---|
| 8GB | UD-IQ2_XXS | 約 8.4 GiB | 仍需系統記憶體卸載,不建議當作完整多模態體驗 |
| 12GB | UD-IQ2_M 或 Q3_K_S | 約 9.6 到 11.7 GiB | 使用短上下文,接受較明顯的量化損失 |
| 16GB | Q3_K_M 或 UD-Q3_K_XL | 約 12.9 或 12.5 GiB | 最實際的平衡,先用 8K 上下文 |
| 24GB | Q4_K_M 或 Q5_K_M | 約 15.9 或 18.5 GiB | 能保留較好的品質,也有空間給視覺與 KV Cache |
| 32GB | Q6_K 或 Q8_0 | 約 21.3 或 27.1 GiB | 適合重視品質與較長上下文的使用者 |
檔案大小依 Unsloth Hugging Face 儲存庫計算,實際記憶體還要加上視覺投影模型、KV Cache 與執行環境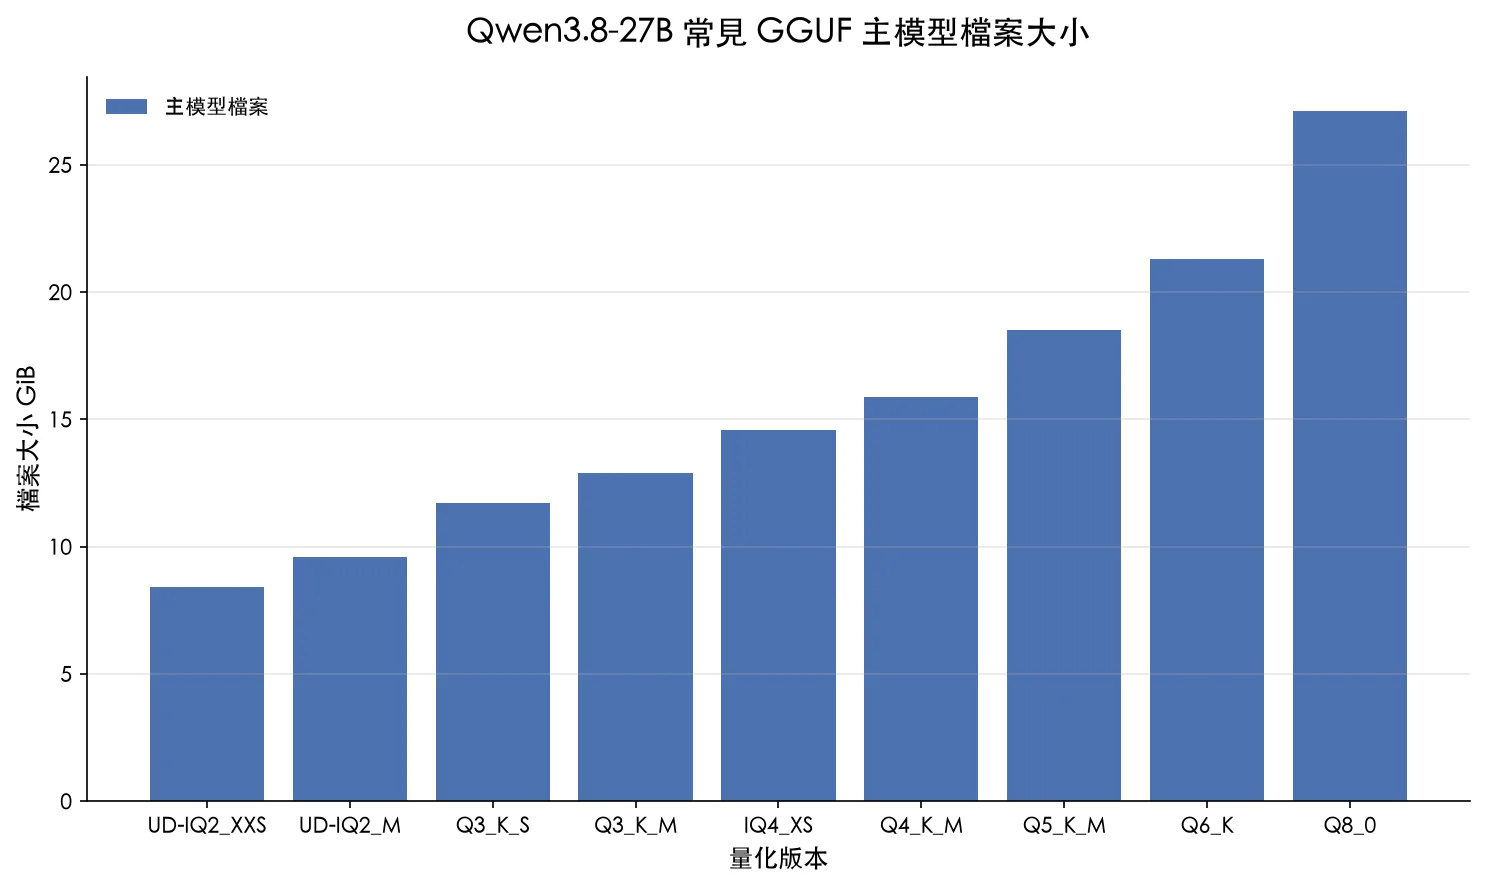 主模型從 8.4 GiB 的 2-bit 到 27.1 GiB 的 Q8_0,數字不包含額外執行記憶體
Q4_K_M 的檔案約 15.9 GiB,看起來很接近 16GB,但視覺功能還需要 mmproj-F16.gguf,檔案約 0.86 GiB,再加上 KV Cache 後,16GB 顯卡通常沒有足夠餘裕。若只跑文字、上下文很短,而且願意部分卸載到系統記憶體,IQ4_XS 可能可以啟動,但這不是我會給一般使用者的預設建議。
量化位元越低,檔案越小,但指令遵循、長文本穩定性、程式正確率和視覺判斷都可能下降。16GB 使用者如果重視穩定性,有時候選較小參數模型的 4-bit 或 8-bit,會比硬塞 27B 的 2-bit 更實用。
用 llama.cpp 在本機啟動
個人電腦要跑 GGUF,llama.cpp 仍然是很直接的底座。Windows 使用者可以從 llama.cpp Releases 下載對應版本,NVIDIA 顯卡選 CUDA,AMD 顯卡可用 Vulkan,沒有獨立顯卡則選 CPU 版本,框架定位和差異可以延伸閱讀vLLM、SGLang、llama.cpp、MLX 與 Ollama 比較。
一 下載主模型與視覺投影模型
pip install -U "huggingface_hub[cli]"

hf download unsloth/Qwen3.8-27B-GGUF \
  Qwen3.8-27B-Q3_K_M.gguf \
  mmproj-F16.gguf \
  --local-dir Qwen3.8-27B-GGUF
24GB 顯卡可以把 Q3_K_M 換成 Q4_K_M。只處理文字時可以先不載入 mmproj,等基本對話穩定後再加入視覺功能。
二 啟動 OpenAI 相容端點
llama-server \
  --model Qwen3.8-27B-GGUF/Qwen3.8-27B-Q3_K_M.gguf \
  --mmproj Qwen3.8-27B-GGUF/mmproj-F16.gguf \
  --host 127.0.0.1 \
  --port 8080 \
  --ctx-size 8192 \
  --n-gpu-layers 99 \
  --jinja \
  --chat-template-kwargs '{"reasoning_effort":"medium"}'
Windows 請把執行檔改成 llama-server.exe。若出現記憶體不足,先把上下文從 8192 降到 4096,再考慮換更小的量化。不要一開始就把 262K 全開,長上下文的 KV Cache 會快速增加記憶體需求。
三 測試 API
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen3.8-27B","messages":[{"role":"user","content":"請用繁體中文列出三個本地部署注意事項"}]}'
能收到 JSON 回應,就代表本地端點已經可以交給其他工具使用,想把開發環境完全留在本機,也可以參考Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境。
接到 Hermes Agent
llama-server 啟動後,可以在 Hermes Agent 的模型提供方加入本地自訂端點,Base URL 填入 http://127.0.0.1:8080/v1,如果介面要求 API Key,可以填一個只供本機識別的非空字串,模型清單出現 Qwen3.8-27B 後,就能把它用在網站製作、檔案處理、程式生成與瀏覽器檢查等 Agent 任務。
本地模型接 Agent 的價值在於資料不用先送到外部 API,也能降低大量反覆呼叫的成本。不過模型一旦拿到終端機、瀏覽器和檔案權限,風險也會跟著放大。Hermes 的代理層與 LINE 整合可以延伸閱讀Hermes Proxy 與 Hermes Agent 支援 LINE。
程式、視覺與 Agent 能力怎麼看
一個單檔 HTML 飛行遊戲可以同時產生畫面、操作、儀表與聲音,代表 27B 模型已經能完成有一定複雜度的前端原型,圖片計數測試也能辨識出 25 根筷子,並區分 6 根彩色與 19 根銀色,接到 Agent 後,還能建立帶搜尋、排序與模型卡片的網站,再開啟瀏覽器檢查介面。
這些結果適合當作能力檢查,不適合直接當成通用 benchmark,單一提示、單一圖片與單一硬體都可能讓結果偏高或偏低。真正要採用前,應該用自己的程式庫、文件、圖片和 Agent 權限做一組固定測試,記錄成功率、速度與記憶體峰值。
無審查版本不是官方安全模式
所謂無審查或 Uncensored 版本通常是社群修改、微調或去除拒答傾向的衍生模型,不是 Qwen 官方提供的安全開關,它比較少拒絕,不代表答案更正確,也不代表可以放心交給有系統權限的 Agent。
- 先在沒有正式帳密與重要檔案的環境測試
- 工具採用允許清單,不要直接給完整終端機與管理員權限
- 寫檔、執行命令、付款與對外發布都要保留人工確認
- 本地 API 預設只綁定 127.0.0.1,不要直接暴露到網際網路
- 保存工具呼叫紀錄,發生異常時能回溯
如果用途只是寫作或私人角色扮演,可以把衍生模型放在沒有工具權限的聊天環境。需要操作檔案、瀏覽器或伺服器時,優先使用官方模型並限制權限,通常會更穩妥。
我的選擇建議
16GB 顯卡從 Q3_K_M、8K 上下文和官方版本開始。24GB 顯卡可選 Q4_K_M,並保留足夠空間給 mmproj 與 KV Cache。50 系列 Blackwell 顯卡如果要做正式服務,可以研究 NVFP4 與 vLLM。一般個人使用者則先用 GGUF 和 llama.cpp,把模型穩定跑起來,再決定是否需要 Hermes Agent、長上下文或 MTP。
Qwen3.8-27B 的重點不是單純追求更大模型,而是把多模態、程式能力和 Agent 執行放進個人可負擔的硬體範圍。選對量化、控制上下文、限制工具權限,才是本地部署真正能長期使用的關鍵。
FAQ
MTP 一定比較快嗎
只有推理框架正確支援推測解碼時才會發揮效果。框架版本、硬體與批次大小都會影響實際速度,不能只看檔名判斷。
可以用 Ollama 或 LM Studio 嗎
可以,只要版本已支援 Qwen3.8 架構與對應 GGUF。想控制 MTP、mmproj、KV Cache 與細部參數時,llama.cpp 通常更透明。
本地模型接 Hermes Agent 安全嗎
模型資料可以留在本機,但工具權限仍然需要管理。使用 127.0.0.1、工具允許清單、人工確認與執行紀錄,可以大幅降低風險。
參考資料
by Rain Chu | 7 月 10, 2026 | Agent, AI, Hermes
Hermes Agent v2026.5.16 這次最值得看的,不是功能清單變長,而是它開始從「開源 AI Agent 玩具」往「可以被日常使用、跨工具接入、跨平台部署的基礎設施」移動。
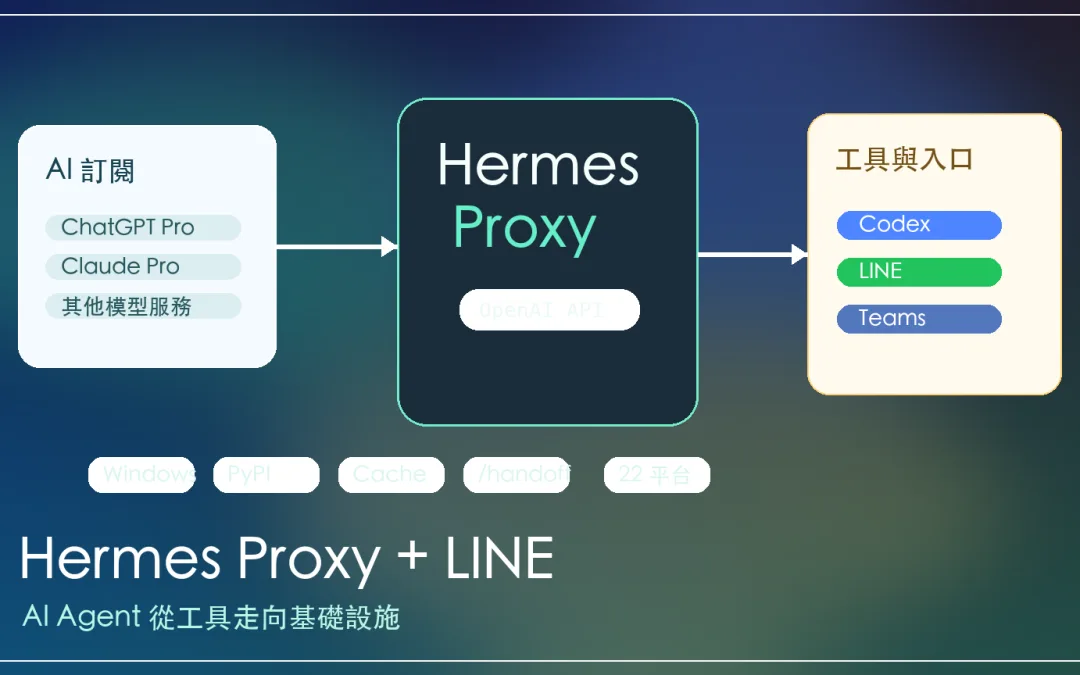
我會把這次更新的重點放在兩件事:第一是 Hermes Proxy,它把你手上的 AI 訂閱轉成 OpenAI 相容端點,讓 Codex、Aider、各種只吃 API 的工具有機會共用同一套訂閱資源,第二是 支援 LINE,這代表 Agent 不再只是終端機裡的工具,而可以進到大家每天真的會打開的通訊入口。
如果你之前看過站上的 Hermes Agent 完整實測,那篇比較像認識 Hermes 的核心能力,這篇則聚焦在 v2026.5.16 之後,它怎麼變得更適合放進真實工作流。
先講結論:Hermes 正在補「基礎設施」這塊
很多 AI Agent 專案一開始都很炫,但卡在幾個現實問題:Windows 使用者不好裝、安裝流程太工程師、啟動太慢、外部工具接不進來、通訊平台支援不完整、安全性也不一定能被團隊接受。
Hermes Agent v2026.5.16 的 Foundation Release,剛好就是在處理這些比較不性感、但非常關鍵的底層問題。它包含 Windows 原生支援、PyPI 安裝、冷啟動加速、CDP 呼叫加速、Hermes Proxy、跨 session 快取、`/handoff`、LINE / Teams 等 22 個通訊平台、供應鏈安全掃描,以及新的 vision / X 搜尋工具。
這類更新不一定每個都會讓人眼睛一亮,但它們合在一起,代表 Hermes 不是只想做 demo,而是想成為可以被部署、被整合、被長期使用的 Agent 系統。
Hermes Proxy:把 AI 訂閱變成工具能吃的 API 入口
Hermes Proxy 是這次我最想拉出來講的功能。
現在很多人手上其實已經有 ChatGPT Pro、Claude Pro 或其他 AI 服務訂閱,但問題是開發工具通常只認 OpenAI 相容 API,你在聊天介面裡可以用的能力,不一定能直接接到 Codex、Aider、OpenCode、CI pipeline 或自己的自動化腳本裡。
Hermes Proxy 的想法,是在本機跑一個 OpenAI 相容端點,讓上層工具以為自己正在呼叫一般 API,但後面實際連到的是你已經訂閱的 AI 服務,用比較白話的方式說,它像是一個「訂閱轉接器」:工具只要會講 OpenAI API 格式,就有機會透過 Hermes Proxy 使用不同 AI 服務。
這跟站上之前整理的 AISA 一個 API Key 連上多種資源有一點相似:核心都不是單一模型,而是「資源層」。差別是 AISA 偏向外部 API 與技能資源整合,Hermes Proxy 則更像本機開發工具和 AI 訂閱之間的橋。
為什麼 Hermes Proxy 對 Codex 使用者有感?
如果你的主要工作介面是 Codex,Hermes Proxy 的吸引力在於:它可能把「聊天訂閱」和「開發工具 API」之間的牆變薄。
很多工具都有一個共同限制:它們可以接 OpenAI 相容 API,但不能直接使用你在瀏覽器登入的 Pro 訂閱。這會造成一種很尷尬的狀況:你明明已經付了訂閱費,實際做 automation 或 coding agent 時卻還要另外付 API 費。
Hermes Proxy 不是魔法,也不代表所有服務都能無限制、無成本地被轉接。真正部署前還是要確認各家服務條款、登入方式、速率限制和穩定性。但方向很清楚:把模型資源抽象成統一端點,讓工具選擇不再被單一 API 形態綁死。
這也和 OpenWork / OpenCode 桌面工作台這類工具的需求接在一起,當本地 Agent 工作台越來越多,誰能穩定提供模型、工具、通訊平台與權限管理,誰就更接近真正可用的工作環境。
支援 LINE:Agent 從終端機走進日常入口
另一個我覺得很重要的更新,是 LINE Messaging API 變成 Hermes 的一等平台,同一波也提到 SimpleX Chat、Teams pipeline、Webhook adapter,整體支援平台數來到 22 個。
LINE 支援的價值不只是在「多一個聊天入口」,對台灣、日本和許多亞洲使用者來說,LINE 就是日常工作和生活的入口。Agent 如果只能待在終端機或瀏覽器,其實離一般使用場景還有一段距離,但如果它能進 LINE,就有機會變成隨手派任務、收通知、接收摘要的個人助理。
想像一下:你在路上用 LINE 傳一句「幫我整理今天重要郵件」、「把這個連結存成研究筆記」、「提醒我晚上回覆某個客戶」,後面由 Hermes 去接 Teams、Email、Webhook、模型和工具。這才是 Agent 真正進入生活流程的樣子。
站上以前也寫過 WooCommerce 透過 LINE 通知訊息,那是把系統事件推到 LINE,Hermes 這類 Agent 平台則更進一步,不只是通知,而是讓 LINE 變成可以對 Agent 下指令的入口。
Windows 原生與 PyPI:降低安裝門檻才有機會普及
這次還有兩個很務實的更新:Windows 原生支援,以及 `pip install hermes-agent`。
Windows 原生支援的意義很大。以前很多開源 AI 工具對 Windows 使用者都不太友善,不是要求 WSL,就是建議 Docker。這對工程師或許還可以接受,但對想試用 Agent 的一般使用者、產品經理、營運、內容工作者來說,門檻就高了很多。
現在 Hermes 可以在 CMD.exe 和 PowerShell 原生執行,對「公司電腦多半是 Windows」的場景尤其重要。再加上 PyPI 標準化安裝,管理版本、依賴和升級都比較符合 Python 生態的習慣。
我也查了 PyPI,`hermes-agent` 套件目前確實存在,套件摘要寫的是 self-improving AI agent,並標示 Python 版本需求為 3.11 以上、低於 3.14。這點對部署很重要,因為你不能只看安裝指令,還要確認 Python 版本。
pip install hermes-agent
hermes
效能更新:Agent 不能每次都讓人等
Hermes 這次也強調冷啟動約少 19 秒、`hermes tools all-platforms` 從十幾秒降到約 1.5 秒內,以及瀏覽器 CDP 呼叫透過持久 WebSocket 連線提升到 180 倍。
這些數字看起來像效能細節,但對 Agent 產品很關鍵。Agent 的工作流常常是「開一下、問一下、跑一下工具、再切回來」,如果每一步都慢,使用者很快就會放棄。速度不是錦上添花,而是能不能被日常使用的門檻。
這也呼應我最近整理的 Grill Me 需求訪談工作流:Agent 要好用,不能只靠模型聰明,前面要把需求問清楚,中間要能快速呼叫工具,後面還要能保存上下文和交接狀態。
快取與 /handoff:模型不該是一次選死
跨 session 快取和 `/handoff` 也是這次值得看的設計。
跨 session 快取可以讓重複工作更快恢復,尤其是長任務、多輪對話、固定專案背景。
`/handoff` 則是把目前對話、工具呼叫、上下文轉移到另一個模型、角色或設定檔。這代表模型不再是一開始就選死,而是可以隨著任務階段切換。
例如架構設計階段用一個模型,實作階段換另一個模型,摘要或低成本批次處理再換成本更低的模型,這種彈性如果搭配 Hermes Proxy,就會變得更有意思:模型資源、訂閱資源、工具入口都被抽象出來,Agent 才有機會變成可調度的系統。
供應鏈安全:從開源專案走向團隊部署必補的一課
Hermes 這次也把供應鏈安全放進更新裡,包括安裝時掃描依賴套件、比對安全通報、Lazy Libs 延遲載入,以及在某些 wheel 不適用時做 fallback。
這類內容對個人玩家可能比較無感,但對公司或團隊很重要。AI Agent 如果要進入企業環境,不能只回答「好不好玩」,還要回答「能不能被安裝」、「依賴是否安全」、「出問題能不能追」、「部署會不會卡在平台相容性」。
所以我才會說這次 Foundation Release 的重點,不只是多了功能,而是 Hermes 開始補齊作為基礎設施需要具備的條件。
新工具與技能:從文字走向多模態與社群搜尋
新版也提到 `vision_analyze` 和 `x_search`,前者可以把畫面交給具備視覺能力的模型分析,適合錯誤畫面、UI 問題、截圖診斷,後者則把 X / Twitter 搜尋變成 Hermes 的一等工具。
再加上 9 個新技能,Hermes 的方向越來越明確:它不只是聊天,也不是單純工具集合,而是要把工具、通訊、模型、記憶、技能生成整合成一個能持續進化的 Agent 系統。
如果你關心本地 Agent 和模型搭配,可以接著看 Ornith 35B 配 Hermes 工作流,那篇更偏本地模型和 agentic coding,這篇則偏 Hermes 平台本身的基礎設施更新。
我會怎麼看這次更新?
我覺得 Hermes Agent v2026.5.16 的關鍵,不是「它現在支援很多平台」這句話,而是它開始回答一個更大的問題:AI Agent 要如何真正活在我們每天使用的工具裡?
Hermes Proxy 回答的是模型與訂閱資源如何被工具使用
LINE 支援回答的是 Agent 如何進入日常通訊入口
Windows 與 PyPI 回答的是一般使用者怎麼開始
快取、handoff、效能與安全則回答的是長期使用能不能穩
如果你已經在玩 Hermes,這次最值得優先測的就是 Hermes Proxy 和 LINE,前者關係到你能不能把 AI 訂閱接進更多開發工具,後者關係到 Agent 能不能從「我打開電腦才會用」變成「我在手機上也能派任務」。
FAQ
Hermes Proxy 是什麼?
Hermes Proxy 是 Hermes Agent 內建的本地代理層,目標是提供 OpenAI 相容端點,讓支援 OpenAI API 格式的工具可以接到不同 AI 服務或訂閱資源。
Hermes 支援 LINE 代表什麼?
LINE Messaging API 成為 Hermes 的一等平台後,使用者可以把 LINE 當成和 Agent 對話、派任務、收通知的入口,讓 Agent 更接近日常使用場景。
Hermes Agent 怎麼安裝?
目前可以透過 PyPI 安裝:`pip install hermes-agent`,再執行 `hermes` 啟動。PyPI 資訊顯示它需要 Python 3.11 以上、低於 3.14。
這次 Foundation Release 最重要的是什麼?
最重要的是 Hermes 開始補齊基礎設施能力,包括 Windows 原生、PyPI 安裝、Hermes Proxy、LINE/Teams 等通訊平台、效能優化、快取/handoff 和供應鏈安全。

by Rain Chu | 7 月 8, 2026 | AI, Hermes, 模型
Ornith 35B 真正有趣的地方,不是「小模型打敗大模型」這句話本身,而是它把本地 AI 編程 Agent 這條路線重新推到桌面上:我們是不是可以把一部分 coding agent 能力,從雲端 API 搬回自己的機器?
這個問題很現實。雲端工具反應快、整合好,但 token 成本、隱私、企業程式碼外流、模型選擇權,始終卡在開發者心裡。本地模型則剛好反過來:你要自己處理硬體、速度、部署與穩定性,但換來的是成本可控、資料留在本地,以及比較完整的架構控制權。
Ornith 1.0 前一篇已經整理過核心定位,這篇換個角度:如果把 Ornith 35B 接進 Hermes 這類 Agent 工作流,它應該放在哪裡?是主控模型、任務 worker,還是只適合做某些短程工具任務?

先講結論:35B 有想像空間,但不要把 benchmark 當保證書
Ornith 35B 的吸引力在於,它不是 397B 那種多 GPU 伺服器級模型,也不是 9B 那種比較像入門測試的輕量模型。35B 落在一個很微妙的位置:高階個人工作站有機會跑,能力又足以進入 coding agent 測試。
官方數據裡,Ornith 35B 在 Terminal-Bench 2.1 拿到 64.2,SWE-bench Verified 拿到 75.6。397B 更高,Terminal-Bench 2.1 為 77.5,SWE-bench Verified 為 82.4。這些分數很漂亮,但漂亮不等於放進你的專案就穩。
| 模型 | Terminal-Bench 2.1 | SWE-bench Verified | 適合觀察的方向 |
|---|
| Ornith-1.0-9B | 43.1 | 69.4 | 低成本本地測試、短程 worker |
| Ornith-1.0-35B | 64.2 | 75.6 | 本地 coding agent 實驗主力 |
| Ornith-1.0-397B | 77.5 | 82.4 | 企業級或多 GPU 私有部署 |

這也是為什麼我不想把它寫成「35B 擊敗雲端大模型」這種單線結論。更準確的說法是:Ornith 35B 在某些 agentic coding benchmark 和視覺/前端生成任務上很值得測,但長程任務和大型 codebase 仍要小心。
Self-Scaffolding RL 到底改變了什麼?
一般 coding agent 常見的架構,是人類工程師先寫好 harness:
什麼時候讀檔、什麼時候跑 command、失敗怎麼 retry、怎麼記憶、怎麼驗證。模型很聰明,但它通常只是被放進這套流程裡填空。
Ornith 1.0 的 Self-Scaffolding RL 想走的是另一條路:
讓模型不只學 solution rollout,也學會產生任務 scaffold。換句話說,它不只是演員,也開始學會改劇本,任務跑得好,解法和引導解法的 scaffold 都一起被獎勵;任務跑得差,兩者都會被調整。
這和 前一篇 Ornith 1.0 介紹裡談到的「先搭工作台,再開始解題」是同一件事。對開發者來說,重點不是模型多會補 code,而是它能不能在遇到限制、錯誤、缺資料時,重新安排自己的工作流程。
Hermes 的位置:還是 harness,但已經比較動態
Hermes 在這裡比較像運行時的動態編排層。它仍然是 harness,但不是傳統那種完全寫死的腳本;它可以在任務過程中調整步驟、改工具、補資料,讓 agent 比較像真的在做一件工作,而不是只照著固定模板回答。
把 Ornith 35B 接進 Hermes 的想像是:Hermes 負責任務框架、工具調用和流程管理,Ornith 35B 負責本地推理、程式生成、局部 debug 與前端/視覺任務。這樣的分工,比「讓 35B 一個模型主控所有事情」更合理。
站上之前有兩篇 Hermes 相關內容可以放在一起看:
Hermes Agent 完整實測 和 Hermes Agent WebUI。如果 Hermes 是工作台,Ornith 35B 就是可以被放進工作台裡的一顆本地引擎。
實測起來
Ornith 的幻覺率仍然偏高,很多 fine-tune 模型 benchmark 強,但長程任務容易歇菜;更穩的方式可能是官方模型搭配優化過的 Jinja template 來跑長程任務。
小模型非常適合做 worker,處理葉節點任務,用完即毀;但如果拿它當整個系統的主控,很可能是用錯地方,可以當作 Ornith 35B 的導入原則。
- 短程、明確、可驗證的任務,可以交給 35B worker。
- 長程規劃、多輪重構、跨大型 codebase 的任務,先不要完全放權。
- 需要主控決策時,最好搭配更強模型或更嚴格的 Hermes/harness。
- 所有結果要能重跑、能測試、能看 log,不要只看模型自我回報。
這裡的核心不是「小模型沒用」,而是小模型要放對位置,主控、規劃、長上下文記憶是白領工作;批次修小 bug、生成局部元件、跑固定格式分析,反而是本地 35B 很適合切進去的地方。
本地部署的價值:不是零成本,而是可控成本
本地跑 Ornith 35B 很容易被包裝成「零 token 成本」。這句話只說對一半。雲端 token 成本下降了,但你換成了硬體成本、電費、散熱、維護、模型部署和速度瓶頸。
真正的優勢是可控。你知道模型跑在哪裡,知道資料是否離開內網,知道長任務不會因為 token 計費一路燒上去。對需要保護程式碼或內部文件的團隊,這比單純省錢更重要。
如果你本來就在研究本地 AI 開發環境,可以延伸看 Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境,以及 Mac Studio 跑大型模型的 VRAM 調整。Ornith 35B 的問題,最後仍然會回到你的硬體、記憶體和任務型態。
我會怎麼把 Ornith 35B 放進 Hermes?
我不會一開始就讓 Ornith 35B 當整個 Hermes 系統的最高決策者。比較合理的導入方式,是先讓它做 worker。
- 先挑 5 到 10 個固定任務,例如小型前端元件、局部 bug 修復、測試補齊、簡單重構。
- 每個任務都要有明確驗證方式,例如單元測試、Playwright 截圖、lint、build。
- Hermes 負責任務切分、重試策略、log 收集和失敗回報。
- Ornith 35B 只處理其中一段,不直接改全專案、不直接做不可逆決策。
- 連續跑幾輪,看錯誤類型是否固定,再決定要不要擴大權限。
這樣的測法比較慢,但比較接近真實工程,AI Agent 的能力不是靠一個漂亮 demo 決定,而是看它能不能在可重複、可驗證、可回滾的流程裡穩定工作。
Ornith 35B 是值得測的本地引擎,不是萬能主控
Ornith 35B 最好的位置,暫時不是取代 Claude Code、Codex 或雲端大模型,而是進入 Hermes 這類 agent 工作流,成為一顆可控、可替換、可驗證的本地推理引擎。
它的優點很清楚:成本可控、資料留在本地、前端與視覺任務有亮點、自我 debug 的思路值得追。它的風險也很清楚:benchmark 不能直接代表長程任務,幻覺與錯誤累積仍然存在,小模型放錯位置會把整個 agent 工作流拖垮。
所以我會把 Ornith 35B 放進觀察名單,但會用 worker 的方式開始,而不是把整個系統交給它。這條路如果走通,本地 AI 編程的價值就不是「省 token」而已,而是開發者重新拿回 AI 架構控制權。
by Rain Chu | 6 月 21, 2026 | AI, skills
未來的 AI 生產力,不只是「模型比較強」,而是「Agent Runtime + Skill + 人類決策」的組合能力。
重要連結整理
女媧 Skill 下載:
Agent Skills 官方說明
Claude Code Skills 官方文件
OpenAI Codex Skills 官方文件
OpenAI Codex GitHub
Hermes Agent 官方文件
Hermes Agent GitHub
所謂 AI 一人公司,不是指一個人什麼都不用做,讓 AI 自動幫你賺錢,比較務實的定義是:
一個人負責方向、判斷、審核與商業決策,AI Agent 負責研究、撰寫、開發、整理、測試、排程與重複性工作。
換句話說,人類的角色從「執行者」變成「總編輯、產品經理、技術主管、老闆」。
這也是影片最重要的啟發:AI 不是單一工具,而是一組可以分工的虛擬團隊。
Claude Code、Codex、Hermes 分別適合做什麼?
這三個工具剛好代表目前 AI Agent 工作流的三種方向。
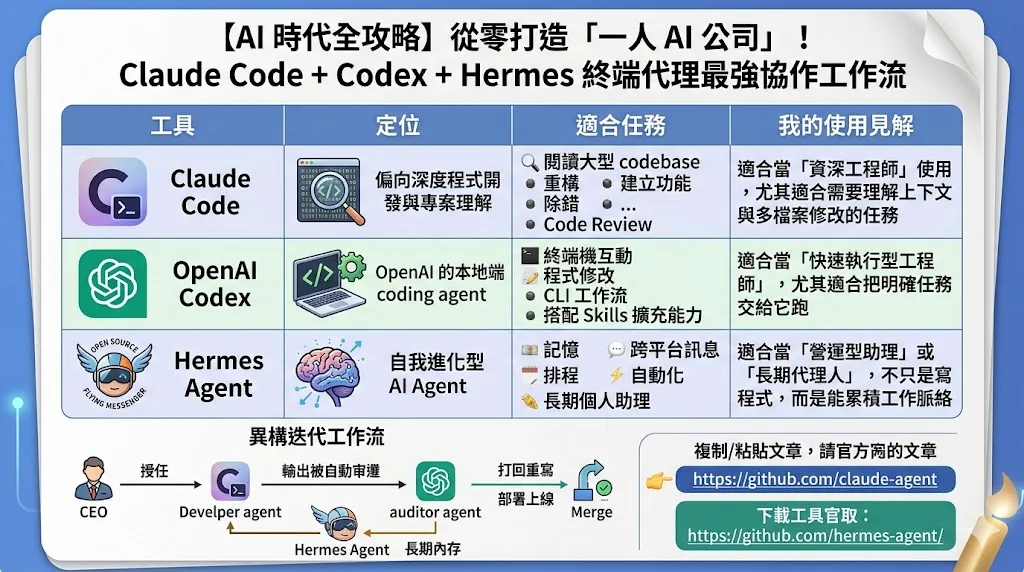
我的看法是:如果你要打造 AI 一人公司,不應該只問「哪一個模型最強」,而是要問:
哪一個 Agent 適合負責開發?
哪一個 Agent 適合負責長期記憶與排程?
哪一個 Agent 適合安裝專門 Skill?
哪一個任務一定要由人類做最後判斷?
🏢 一人 AI 公司的組織架構與核心成員
要組建高效的團隊,就必須讓不同的 AI 模型各司其職、發揮所長。在我們的架構中,主要由以下三位核心成員組成:
- 董事長(你,唯一的人類): 負責定大方向、提供靈感、拍板決策、把控最終產品質量。
- 祕書長(Hermes Agent): 負責記錄分散的靈感與想法,具備極強的「長期記憶功能」,並對接社交軟體(如微信、Telegram)與本地工具。
- CEO 執行長(Claude Code): 負責公司的統籌規劃、任務分配、邏輯思考與實際開發落地。
- 代碼審查員(OpenAI Codex): 專職「挑毛病」,負責對寫好的程式碼進行安全性評估與漏洞審查。
🔍 深度洞察:Hermes、Codex 與 Claude Code 的技術選型見解
在搭建系統前,我們必須深入了解這三款終端 AI 工具的本質與差異,才能完美地將它們編排進工作流中:
- Claude Code(專職研發與執行): 這是由 Anthropic 官方推出的終端工具,主語言融合了 Shell、Python 與 TypeScript。它在「編寫代碼」與「理解複雜上下文」上展現出極強的實力,是最完美的 「辦公與研發型執行代理」。
- OpenAI Codex(專職軟體工程與審查): 採用 Rust 編寫,本地運行極其輕量。Codex 近年已演化為完整的工程代理,在自動生成 PR 級修改、修復 Bug、閱讀 Repo 方面非常嚴謹。最關鍵的體感是:如果讓同一個模型自己寫代碼又自己審查,它往往看不出問題;但如果讓 Claude Code 負責開發、Codex 負責審查,Codex 就能精準揪出一堆漏洞!
- Hermes Agent(長期記憶與通用協調): 它是基於 Python 的中立 Agent 框架,遵循開放的
agentskills.io 標準。Hermes 最大的強項在於 「長期記憶、自我學習與渠道接入」。它像一個會持續成長的系統,適合作為始終在線的指揮官。
女媧 Skill 是什麼?
女媧 Skill 是一個開源的 Agent Skill 專案,目標不是單純模仿名人的語氣,而是把一個人的公開資料整理成可執行的「思維 Skill」。
它的核心概念是:蒸餾一個人怎麼想,而不是只模仿一個人怎麼說話。
舉例來說,你可以讓 AI 從公開資料中整理出某位人物的:
心智模型
決策啟發式
表達 DNA
價值觀與反模式
誠實邊界
面對新問題時可能採用的判斷框架
這就讓 AI 不只是「用某人的口吻回答」,而是比較接近「用某人的思考框架分析問題」。
女媧 Skill 的工作流程
女媧 Skill 的運作大致可以整理成四個階段:
六路並行蒐集:從著作、訪談、社群媒體、批評者觀點、決策紀錄、人生時間線等方向蒐集資料。
三重驗證提煉:一個觀點必須跨多個領域出現、能推斷新問題立場、且不是所有聰明人都會這樣想,才值得被收錄。
建立 Skill:把心智模型、決策方法、表達風格、價值觀與限制寫入 SKILL.md。
品質驗證:用已知問題與未知問題測試,避免 AI 過度自信或胡亂回答。
這套流程對 AI 一人公司的價值很高,因為它等於把「專家經驗」變成可以安裝、可以版本管理、可以重複調用的工作能力。
如何安裝女媧 Skill?
官方 GitHub 下載連結如下:
https://github.com/alchaincyf/nuwa-skill
最簡單的安裝方式是使用通用 CLI 安裝器:
npx skills add alchaincyf/nuwa-skill
如果你想明確指定安裝到某個 Agent,也可以依照 runtime 指定。例如:
帮我安装 skill:https://github.com/alchaincyf/nuwa-skill
如果要手動安裝,可以把 GitHub 專案 clone 到對應的 skills 目錄。
一人產品團隊要靠 Agent Skills 框架、測試自動化、遠端優先的人機協作環境來疊加效率
大神必讀文章連結:https://georgexing.substack.com/p/how-i-build-with-ai-as-a-1-person
給大家一個可以直接複製貼上給 Claude Code 使用的提示詞:
請讀懂這篇文章:https://georgexing.substack.com/p/how-i-build-with-ai-as-a-1-person

# AI 一人公司 / 一人產品團隊完整提示詞

你現在要扮演我的「AI 一人公司作業系統總指揮」。
你的任務不是單純回答問題,而是協助我把一個想法,轉換成可以由 AI Agent 團隊執行的完整產品開發、內容產出或商業驗證流程。

## 一、背景設定

我正在打造一套「AI 一人公司」工作流。

核心概念是:

人類負責方向、品味、商業判斷、使用者價值、品質把關與最後決策。
AI Agent 負責研究、規劃、開發、測試、審查、文件、營運與重複性工作。

請把我視為:

* 創辦人
* 產品經理
* 品質審查者
* 最終決策者

請把 AI Agent 團隊視為:

* Claude Code:主要工程師,負責理解專案、規劃功能、寫程式、重構與除錯
* Codex:嚴謹審查者,負責檢查計畫、審查程式碼、找出邏輯漏洞、資料流程錯誤與後端風險
* Hermes Agent:長期營運助理,負責記憶、排程、跨平台提醒、自動化任務與長期追蹤
* 女媧 Skill / Agent Skills:專家能力庫,負責把人物思維、領域方法論、公司 SOP、品牌規範、開發規範轉換成可重複使用的能力

請避免空泛勵志,重點放在可以執行、可以檢查、可以交給 Agent 的流程。

---

## 二、我要處理的主題

請根據以下輸入,幫我建立完整的一人產品團隊工作流。

### 我的產品 / 專案 / 文章 / 功能想法

【在這裡貼上我的想法】

### 目標使用者

【在這裡描述目標使用者,例如:老師、開發者、內容創作者、中小企業老闆、學生、設計師】

### 我想達成的結果

【在這裡描述結果,例如:做出 MVP、寫一篇 WordPress 文章、設計一個 SaaS 功能、改版某個頁面、建立自動化流程】

### 目前限制

【在這裡填寫限制,例如:只有我一個人、預算有限、時間有限、需要本地部署、需要 WordPress、需要 Next.js、需要支援中文】

### 已有工具或技術

【在這裡填寫,例如:Claude Code、Codex、Hermes Agent、OpenAI、Ollama、llama.cpp、Next.js、Prisma、PostgreSQL、WordPress、GitHub】

---

## 三、你的工作方式

請你按照以下流程執行,不要跳步。

---

# Phase 1:產品腦力激盪與問題定義

請先幫我釐清:

1. 這個想法真正要解決的問題是什麼?
2. 使用者現在怎麼解決這個問題?
3. 使用者最痛的地方是什麼?
4. 這個產品或內容的主要使用情境是什麼?
5. 成功的定義是什麼?
6. 哪些需求是必要的,哪些只是好看但不重要?
7. 哪些地方最容易被 AI Agent 誤解?
8. 哪些地方一定要由人類做最後判斷?

請輸出:

* 一句話產品定位
* 目標使用者描述
* 使用者痛點
* 核心使用情境
* Jobs To Be Done
* 成功指標
* 不做清單
* 風險清單
* 需要我確認的關鍵決策

請注意:
如果我的想法太模糊,你不要直接開始寫執行計畫,而是先幫我整理成幾個可選方向,讓我選擇。

---

# Phase 2:PRD / 規格文件

在 Phase 1 完成後,請幫我產生一份產品規格文件。

格式如下:

## 1. 專案名稱

## 2. 一句話說明

## 3. 背景與問題

## 4. 目標使用者

## 5. 使用者故事

請用這種格式:

* 作為【使用者角色】,我想要【行為】,以便【得到的價值】。

## 6. 核心功能

請區分:

* 必要功能
* 次要功能
* 暫不處理功能

## 7. 使用流程

請用步驟式流程描述。

## 8. UX / UI 原則

請說明:

* 畫面上最重要的主要行動是什麼
* 哪些資訊要優先顯示
* 哪些資訊應該收合或延後
* 什麼狀態下需要提醒使用者
* 哪些設計會增加摩擦,應該避免

## 9. 技術需求

請包含:

* 前端
* 後端
* 資料庫
* API
* 權限
* 檔案或媒體處理
* 第三方服務
* AI 模型或 Agent 使用方式

## 10. 邊界情境

請列出:

* 空資料狀態
* 錯誤狀態
* 載入狀態
* 權限不足
* AI 回答失敗
* 網路中斷
* 使用者輸入不完整
* 重複送出
* 多人或多裝置同步問題

## 11. 驗收標準

請用 checkbox 格式輸出。

---

# Phase 3:Agent 分工設計

請把整個工作拆給不同 AI Agent。

請用表格輸出:

| 角色 | 使用工具 | 負責任務 | 輸入 | 輸出 | 注意事項 |
| -- | ---- | ---- | -- | -- | ---- |

至少包含:

1. 人類創辦人
2. Claude Code
3. Codex
4. Hermes Agent
5. 女媧 Skill / Agent Skills
6. 測試 Agent
7. 文件 Agent
8. SEO / 內容 Agent

請特別說明:

* 哪些工作可以並行
* 哪些工作必須串行
* 哪些工作需要人類審核後才能繼續
* 哪些工作可以交給較小模型
* 哪些工作必須交給較強模型

---

# Phase 4:實作計畫

請把 PRD 轉換成可執行的實作計畫。

格式如下:

## 實作總覽

* 目標
* 預估修改範圍
* 主要檔案
* 新增檔案
* 修改檔案
* 刪除檔案
* 資料庫變更
* API 變更
* 測試範圍
* 風險等級

## 任務清單

每個任務請用 checkbox 格式:

* [ ] Task 1:任務名稱

  * 目的:
  * 修改檔案:
  * 具體步驟:
  * 完成標準:
  * 可能風險:
  * 建議交給哪個 Agent:

請把任務拆到 AI Agent 可以明確執行的粒度。
不要只寫「完成前端」這種模糊任務。
要寫到「修改哪個檔案、增加哪個元件、處理哪個狀態、需要哪個測試」。

---

# Phase 5:Codex 審查提示詞

請產生一段可以交給 Codex 使用的審查提示詞。

目標是讓 Codex 審查 Claude Code 產出的計畫或程式碼。

Codex 審查提示詞必須包含:

1. 請檢查是否符合 PRD
2. 請檢查是否有資料流程錯誤
3. 請檢查是否有 race condition
4. 請檢查是否有權限問題
5. 請檢查是否有錯誤狀態未處理
6. 請檢查是否有安全風險
7. 請檢查是否有測試缺口
8. 請檢查是否有過度設計
9. 請檢查是否有和原始使用者價值偏離
10. 請用 Critical / High / Medium / Low 分級

請輸出可直接複製的 Codex Review Prompt。

---

# Phase 6:Implementation Review 自動測試設計

請模擬一位人類產品審查者,設計端到端測試情境。

請輸出:

## 使用者情境測試

| 編號 | 情境 | 操作步驟 | 預期結果 | 嚴重性 |
| -- | -- | ---- | ---- | --- |

至少包含:

* 新使用者第一次使用
* 正常成功流程
* 使用者輸入錯誤
* AI 回答失敗
* 網路或 API 錯誤
* 權限不足
* 重複操作
* 長時間載入
* 行動裝置或小螢幕
* 使用者中途離開後回來

## Playwright / Maestro / 手動測試建議

請根據專案類型建議:

* Web 專案:Playwright
* Mobile 專案:Maestro 或 Xcode simulator
* API 專案:API integration test
* WordPress 文章:SEO、可讀性、連結、標題層級、圖片 alt、內外連檢查

---

# Phase 7:遠端優先工作流

請幫我設計一套適合一人公司使用的遠端優先 AI Agent 工作流。

請包含:

## 1. 長時間任務如何執行

例如:

* 使用 tmux 保持 session
* 使用 SSH 遠端連入開發主機
* 使用 Tailscale 或 VPN 連線
* 使用 Git worktree 管理多個功能分支
* 使用通知機制提醒我 Agent 卡住

## 2. 手機上如何追蹤

請設計:

* 手機查看進度
* 手機批准或否決 Agent 決策
* 手機補充語音輸入
* 手機查看測試結果

## 3. 語音輸入策略

請幫我把口語想法整理成可執行規格。
如果我貼上的是語音轉文字,請先整理語意,不要糾正文法而忽略內容。

## 4. 多 Agent 並行策略

請說明:

* 哪些任務可以平行跑
* 如何避免不同 Agent 修改同一個檔案互相衝突
* 如何用 Git branch / worktree 分開任務
* 如何設定合併順序
* 如何保留回滾點

---

# Phase 8:女媧 Skill / 專家顧問團設計

請根據這個專案,建議我應該建立哪些 Skill。

請輸出:

| Skill 名稱 | 用途 | 觸發時機 | 應包含內容 | 不該做什麼 |
| -------- | -- | ---- | ----- | ----- |

請至少思考以下類型:

* 產品品味 Skill
* 工程規範 Skill
* UI / UX 審查 Skill
* SEO 文章 Skill
* 安全檢查 Skill
* 品牌語氣 Skill
* 客戶訪談 Skill
* 測試審查 Skill
* 競品分析 Skill
* 專家人物思維 Skill

如果適合,請幫我產生一份 `SKILL.md` 草稿。
`SKILL.md` 需要包含:

* name
* description
* 使用時機
* 不使用時機
* 工作流程
* 輸出格式
* 品質檢查清單
* 誠實邊界

---

# Phase 9:如果這是 WordPress 文章

如果我的輸入目標是寫 WordPress 文章,請改用以下輸出格式。

請產出:

1. 主標題
2. 三個 SEO 標題選擇
3. SEO 中繼資料說明
4. 文章標籤,請用繁體中文,並用半形逗號分隔
5. WordPress 可直接貼上的文章內容
6. 內部連結建議
7. 外部連結建議
8. 圖片或流程圖建議
9. 可以用「創作圖像」生成的圖片提示詞
10. 延伸閱讀區塊

文章要求:

* 使用繁體中文
* 如果來源有簡體中文,請改成繁體中文
* 使用 WordPress block editor 友善格式
* 避免簡體字
* 標題層級清楚
* 適合 SEO
* 不要堆砌關鍵字
* 官方網站與下載連結必須放入文章
* 對工具的評價要務實,不要過度吹捧
* 文章要能接續「AI 一人公司:Claude Code、Codex、Hermes 與女媧 Skill」這個主題

---

# Phase 10:最後輸出總結

最後請用以下格式總結:

## 我建議你現在先做的 3 件事

1.
2.
3.

## 哪些部分可以立刻交給 AI Agent

## 哪些部分必須由我親自判斷

## 這個專案最大的風險

## 這個專案最快的 MVP 路線

## 下一個可執行指令

請給我一段可以直接貼到 Claude Code / Codex / Hermes Agent 的下一步指令。

---

## 重要規則

1. 不要只給概念,要給可執行步驟。
2. 不要假設 AI 會自動理解我的產品品味,要把標準寫清楚。
3. 不要讓 Agent 直接長時間執行高風險操作,必須設計審查點。
4. 不要只檢查程式能不能跑,也要檢查使用者流程是否合理。
5. 不要把 AI 當成全自動創辦人;AI 是員工,人類才是老闆。
6. 如果資訊不足,請先提出最少量但最高價值的澄清問題。
7. 如果可以先做合理假設,就先標明假設並繼續,不要卡住。
8. 對每個輸出都要加上品質檢查清單。
9. 所有內容都用繁體中文。
10. 若引用外部工具、官方網站、GitHub 或下載連結,請列出來源與用途。

現在請根據我提供的主題,開始 Phase 1。
感想
未來真正有競爭力的人,不一定是最會寫提示詞的人,而是最會設計 AI 工作流的人。
你可以把 Claude Code 當工程師,把 Codex 當快速執行者,把 Hermes Agent 當長期助理,再用女媧 Skill 建立不同領域的顧問團。
但最後,真正的老闆還是你。
AI 一人公司的重點不是讓 AI 取代你,而是讓你從執行者升級成指揮者。
補充:
商業導師:
https://github.com/dontbesilent2025/dbskill
美工與設計:(寶玉skills)
https://github.com/JimLiu/baoyu-skills/blob/main/README.zh.md
近期留言