by Rain Chu 9 月 14, 2026 | AI , QWEN , TTS , 虛擬人 , 語音合成 , 語音辨識
把 AI 對話、即時語音和會動的人像放在同一台電腦上,現在已經可以做出一套不依賴雲端 API 的互動數位人,用 faster-whisper 聽懂麥克風,讓 Qwen3 產生回答,再交給 Qwen3-TTS 合成聲音,最後由 LiveTalking 完成口型同步與 WebRTC 串流。
先講我的結論。這套方案的價值是隱私、角色控制與離線能力,不是安裝後完全沒有成本。模型權重下載完成後確實不需要按次支付 API 費用,但顯卡、記憶體、硬碟、電力與維護時間仍然是成本,所謂 8GB 顯存能跑,也必須以較小的 LLM、量化權重和分階段載入為前提.若想讓 14B LLM、Whisper large-v3、1.7B TTS 與口型模型同時常駐,16GB 顯存仍可能不夠。
整套本地 AI 數位人怎麼運作
這不是單一模型,而是一條由五個服務組成的即時管線。
VAD 判斷使用者何時開始與停止說話faster-whisper 把麥克風聲音轉成文字Qwen3 與 llama.cpp 根據角色設定產生回答Qwen3-TTS 把回答轉成指定音色的語音LiveTalking 接收音訊並驅動嘴型,再透過 WebRTC 顯示互動人像
這種模組化做法和我之前整理的 Hugging Face speech-to-speech 本地即時語音 Agent 是同一條思路。每一層都能替換,但每一層也有自己的模型、連接埠與執行環境。LiveTalking 不會自動知道 Qwen3-TTS 在哪裡,兩者中間仍需要官方支援的 TTS 外掛,或一個把生成音訊送到 /humanaudio 的橋接程式。
先算顯存,不要先相信 8GB 宣傳
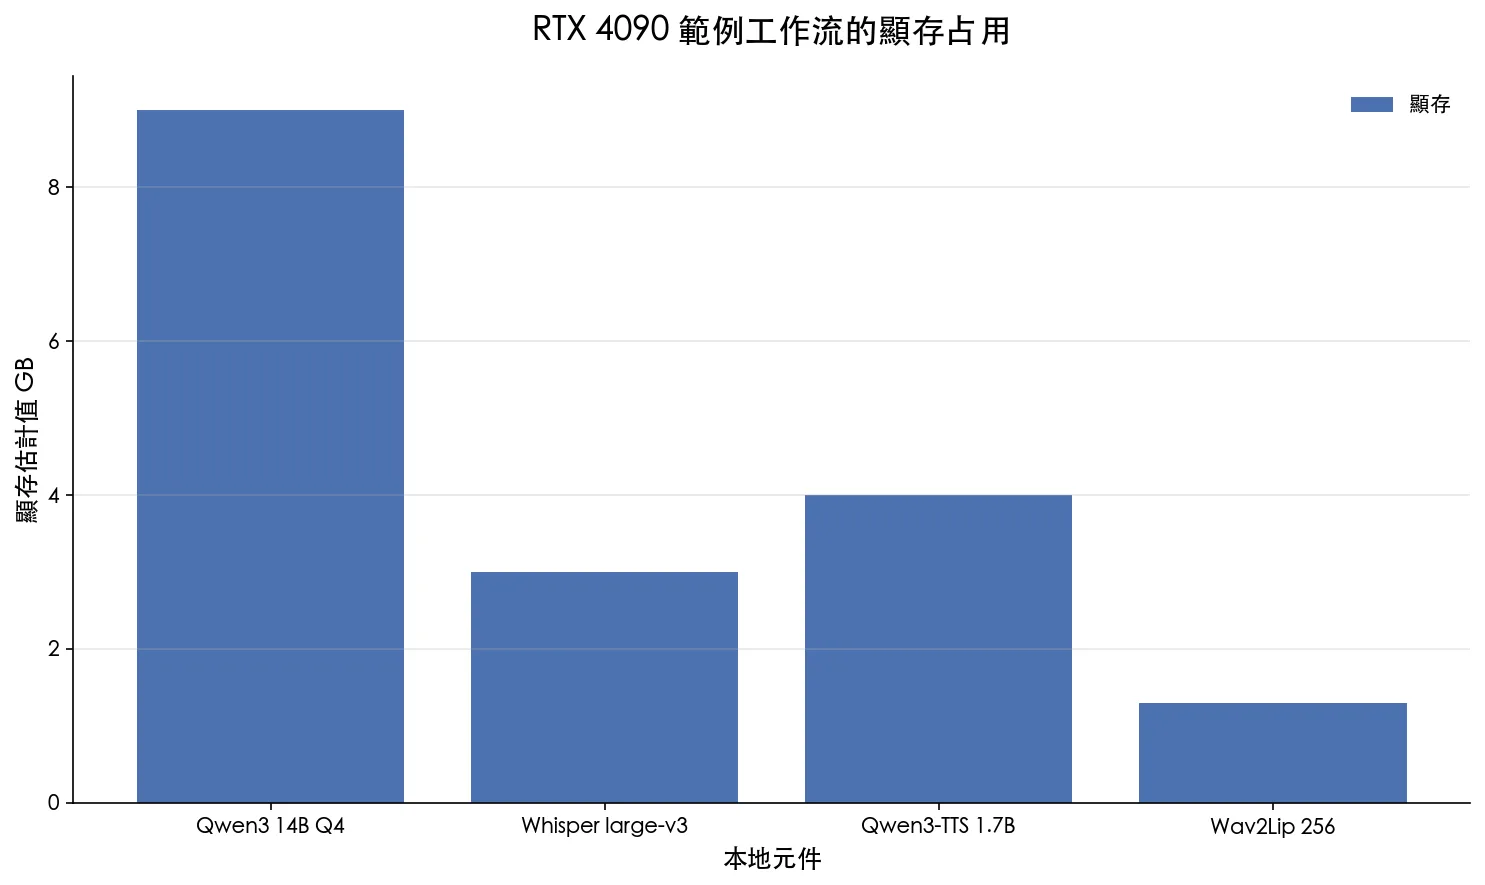
元件 RTX 4090 範例占用 低顯存調整 Qwen3-14B Q4_K_M 約 9GB 改用 8B 或 4B 的 Q4_K_M faster-whisper large-v3 約 3GB 改用 medium,準確度會有取捨 Qwen3-TTS 1.7B 約 4GB 改用 0.6B 或依序載入服務 Wav2Lip 256 約 1.3GB 降低批次並避免其他 GPU 程式常駐
這是 RTX 4090 整合環境的估計值,不同量化、上下文長度與 CUDA 版本都會改變結果 四個元件加起來約 17.3GB,還沒算 CUDA context、瀏覽器與暫存空間。16GB 顯卡跑到 99% 甚至整台機器失去回應,並不意外。6GB 顯存可以先用 Qwen3-4B 的 GGUF 量化版,並把語音辨識改成 medium。8GB 到 12GB 則適合 Qwen3-8B 搭配較小 TTS,或讓部分元件使用 CPU。若想了解 GGUF、llama.cpp 與 Ollama 的取捨,可以先看 本地大模型推理框架比較 。
第一步,在 Windows 準備 WSL 2
這套整合方式把 llama.cpp 放在 Windows,語音與數位人服務放在 Ubuntu 24.04 的 WSL 2。先用系統管理員身分開啟 PowerShell。
wsl --update
wsl --install -d Ubuntu-24.04
Windows 使用者目錄的 .wslconfig 可以設定記憶體與鏡像網路。32GB 是範例,請依實際 RAM 調整,不要把主機記憶體全部交給 WSL。
[wsl2]
memory=32GB
networkingMode=mirrored

[experimental]
hostAddressLoopback=true
修改後重啟 WSL。
wsl --shutdown進入 Ubuntu 後先用 nvidia-smi 檢查 GPU。NVIDIA 的 Linux 驅動不要再裝進 WSL,CUDA passthrough 由 Windows 顯示卡驅動提供。AMD 顯卡不能照搬這套 CUDA 整合包,需要改走 ROCm 支援的元件,或把無法使用 ROCm 的部分移到 CPU。
專案最好放在 Linux 家目錄,不要直接在 /mnt/c 執行。這能避開 I/O 速度、權限與換行格式問題。
mkdir -p ~/setup
cp -r "/mnt/c/Users/YOUR_NAME/Desktop/AI/." ~/setup/
cd ~/setup
sudo apt update
sudo apt install -y ffmpeg dos2unix python3-venv
dos2unix *.sh
chmod +x *.sh
第二步,用 llama.cpp 啟動 Qwen3
llama.cpp 提供 OpenAI 相容 HTTP 服務,語音管線不必知道底層跑的是 GGUF。16GB 以上可以從 Qwen3-14B 的 Q4_K_M 開始,8GB 到 12GB 建議改成 8B,4GB 到 6GB 則從 4B 測試。
llama-server -m E:\llama.cpp\models\Qwen3-14B-Instruct-Q4_K_M.gguf ^
  -np 1 -c 8192 -fa on --temp 1.0 --top-p 0.95 ^
  --host 0.0.0.0 --port 8090
新版 llama.cpp 文件也開始使用 llama serve 名稱,實際命令要以下載版本為準。Windows 的 8080 有時落在 Hyper-V 保留範圍,所以範例改用 8090。若服務無法綁定,可以先檢查保留埠。
netsh interface ipv4 show excludedportrange protocol=tcp第三步,安裝即時語音管線
Hugging Face 官方 speech-to-speech 現在以 serve、talk 和 local 為主要命令,舊資料裡的 --mode 已經淘汰。先建立獨立環境,再安裝 faster-whisper 額外依賴。
python3 -m venv ~/venvs/s2s
source ~/venvs/s2s/bin/activate
python -m pip install --upgrade pip
pip install "speech-to-speech[faster-whisper]"
以下範例把 LLM 指向 Windows 上的 llama.cpp。不同版本的 STT 參數名稱可能調整,正式啟動前先執行 speech-to-speech serve --help 對照目前安裝版本。
speech-to-speech serve \
  --stt faster-whisper \
  --stt_model_name large-v3 \
  --language zh \
  --llm_backend responses-api \
  --tts qwen3 \
  --model_name Qwen3-14B-Instruct-Q4_K_M \
  --responses_api_base_url http://127.0.0.1:8090/v1 \
  --responses_api_api_key "" \
  --responses_api_stream \
  --enable_live_transcription
模型全部下載完成後,可以設定 HF_HUB_OFFLINE=1 驗證斷網狀態。這一步比口頭宣稱本地化更可靠,因為只要還有任一個後端指向雲端,就不算完整離線。
第四步,準備 Qwen3-TTS 與參考聲音
Qwen3-TTS 官方最簡單的安裝方式是獨立建立 Python 3.12 環境。它支援聲音克隆、音色設計與串流輸出。更多模型差異和 ComfyUI 節點用法,可以延伸看 Qwen3-TTS 音色設計整理 。
conda create -n qwen3-tts python=3.12 -y
conda activate qwen3-tts
pip install -U qwen-tts
參考音訊建議控制在 5 到 15 秒,只留單一說話人,沒有音樂與明顯環境聲。參考文字必須和音訊實際內容完全相同,否則容易出現漏字、錯字與音色漂移。情緒也會一起被模仿,所以不要用過度激動的片段當作一般對話基準。
ffmpeg -i ~/setup/ref.wav -ac 1 -ar 16000 -c:a pcm_s16le ~/s2s/ref.wav
ffprobe -v error -show_entries stream=sample_rate,channels,codec_name \
  -show_entries format=duration -of default=nw=1 ~/s2s/ref.wav
只應克隆自己或已取得明確授權的聲音。把真人聲紋放入公開服務前,也要考慮檔案存取權限、提示注入與未授權冒用。
第五步,製作自然的待機人像
人像素材不適合直接使用張嘴、手擋住嘴巴或劇烈轉頭的畫面。先生成嘴唇閉合、正面或微側面的基準圖,再用 Wan2.2 圖生影片做五秒左右的待機動作。提示詞只描述動作,不要重新描述人物外觀,能減少五官漂移。
電影感 16 比 9 構圖,一位成年東亞女性位於畫面右側三分之一,深色安靜房間,左側保留大量空間,螢幕冷光照亮臉部,輪廓帶柔和暖光,嘴唇自然閉合,雙手不遮擋嘴部,自然皮膚紋理,淺景深,真實攝影質感
負面提示詞
張嘴,說話,露齒,正面平光,明亮背景,過高對比,過度曝光,人物置中,多人,手遮擋嘴部,文字,浮水印,塑膠皮膚,過度修圖,卡通,3D 渲染
待機動畫提示詞
人物保持坐姿,只有細微自然呼吸,緩慢眨眼一次,頭部輕微移動後回到原位,嘴唇全程閉合,鏡頭完全鎖定,沒有縮放,沒有切鏡
關閉自動提示詞增強,輸出比例盡量和原圖相同。Wan2.2 常見原生片段是 81 幀、16 FPS,約五秒。若要二十秒待機,不要期待模型一次生成毫無漂移的長鏡頭,可以在自然停頓點循環短片。其他數位人生成思路可參考 LongCat 數位人工作流 。
第六步,安裝 LiveTalking
LiveTalking 官方目前測試的環境是 Ubuntu 24.04、Python 3.12、PyTorch 2.9.1 與 CUDA 12.8。下面命令照官方版本撰寫,但 PyTorch 下載來源仍應配合自己的 CUDA 驅動,不要盲目安裝 cu128。
git clone https://github.com/lipku/LiveTalking.git
cd LiveTalking
conda create -n livetalking python=3.12 -y
conda activate livetalking
pip install torch==2.9.1 torchvision==0.24.1 torchaudio==2.9.1 \
  --index-url https://download.pytorch.org/whl/cu128
pip install -r requirements.txt
下載官方提供的 wav2lip256.pth 後,把它放到 models,並改名成 wav2lip.pth。範例角色資料夾則解壓到 data/avatars。完成後啟動 WebRTC 服務。
python app.py --transport webrtc --model wav2lip \
  --avatar_id wav2lip256_avatar1 \
  --stun 'stun:stun.l.google.com:19302'
瀏覽器開啟 http://localhost:8010/index.html,按下開始連線。正式讓外部裝置使用時,官方提醒需要 TCP 8010 和 WebRTC 使用的 UDP 連接埠。不要直接把整段 UDP 範圍暴露到公網,應優先放在可信任區網、VPN 或經過限制的防火牆環境。
自己製作 Wav2Lip 角色時,可以把短影片轉成 avatar 資料。素材要維持正面可見、光線穩定與嘴部清楚。
python avatars/wav2lip/genavatar.py \
  --video_path data/video/avatar.mp4 \
  --img_size 256 \
  --avatar_id my_avatar
第七步,正確啟動與串接
我會把服務拆成四個終端視窗,照下面順序啟動。每一步都先確認健康狀態,再開下一個服務。
Windows 啟動 llama.cpp,確認 http://127.0.0.1:8090/v1/models 有回應
WSL 啟動 Qwen3-TTS 或 speech-to-speech,先完成單句語音測試
WSL 啟動 LiveTalking,確認 8010 網頁能顯示待機角色
最後啟動橋接程式,把 TTS 產生的音訊送入 LiveTalking 的 /humanaudio
作者提供的一鍵整合包包含自訂腳本與橋接程式,並不是 Hugging Face、Qwen 或 LiveTalking 的官方發行版。下載前應先檢查檔案來源、雜湊值、啟動腳本和網路連線,不要把未知執行檔直接放進主要工作電腦。想要長期維護,我更建議從官方專案建立環境,再自行補一個最小橋接層。
WebSocket failed 怎麼排查
先確認服務真的啟動 。7860、8010 與 8090 是不同服務,瀏覽器頁面存在不代表後端 WebSocket 已連線檢查 WSL 網路 。修改 .wslconfig 後一定要執行 wsl --shutdown,鏡像網路與 hostAddressLoopback 才會重新載入確認 Windows 防火牆 。先只開必要 TCP 埠,在同一台電腦測通後再處理區網不要混用 localhost 。容器、WSL 與 Windows 各自看到的 127.0.0.1 可能不是同一個服務確認瀏覽器麥克風權限 。遠端網頁通常需要 HTTPS 或 localhost 才能取得安全的麥克風權限降低 Noise Gate 。如果網頁已連線但偵測不到聲音,先關閉門檻測試,再逐步調高調整 VAD 停頓 。約 900 到 1200 毫秒比較不容易搶話,但設定越長,回答開始時間也越慢
可以改成真正的 3D 角色嗎
可以,但不是把 Wav2Lip 模型換成一個 3D 檔案就完成。現在這條路線以 2D 影像或待機影片為基礎,口型模型直接修改臉部像素。真正的 3D 角色需要另外加入 Unity、Unreal Engine 或 WebGL renderer,再把 TTS 音訊轉成 viseme、音素或 blendshape 權重,驅動角色的嘴型、表情、眼神與骨架。
保留 VAD、Whisper、Qwen3 與 Qwen3-TTS,替換最後一層即可。新的輸出流程會變成 TTS 音訊、音素時間軸、3D blendshape、即時 renderer。若只是想讓角色有更豐富動作,可以先使用 LiveTalking 的自訂動作設定或多段待機素材,成本會比完整 3D 低很多。
本地不等於沒有風險
角色資料、聲音與對話都留在本機,確實能降低資料送往雲端的風險。但只要把服務開到區網或公網,就要重新考慮驗證、連接埠、惡意音訊、提示注入與檔案上傳。對話記憶也不是安裝完成就會永久存在,長期記憶需要另外接資料庫、摘要或向量檢索,否則聊天變長後仍可能忘記前文或開始胡亂延伸。
LiveTalking 官方也明確要求,使用此專案製作並發布到平台的內容必須包含 LiveTalking 浮水印與標誌。正式商用前要再確認每個模型、角色素材、聲音和整合程式的授權,不要只看程式能不能跑。
官方資源與參考資料
FAQ
8GB 顯存真的可以跑本地 AI 數位人嗎
可以做出可用版本,但不適合讓 14B LLM、large-v3、1.7B TTS 與口型模型全部以高規格同時常駐。建議改用 Qwen3-8B 或 4B 量化版、較小 TTS、較低 batch,必要時把部分模型放到 CPU。
可以完全離線,不使用任何 API 嗎
可以。前提是 STT、LLM、TTS 和數位人全部使用本地後端,而且模型與依賴已下載完成。設定 HF_HUB_OFFLINE=1 並在斷網環境測試,才能確認沒有隱藏的雲端依賴。
可以用英文或其他語言聊天嗎
可以,但 STT、LLM 與 TTS 三層都要支援目標語言。Whisper 與 Qwen3 的多語能力較完整,最終自然度通常由 TTS 音色與參考音訊決定。中英混合時要額外測試專有名詞、數字與語速。
Mac 可以照這篇安裝嗎
不能原封不動照做,因為本文整合路線依賴 Windows、WSL 與 CUDA。llama.cpp、Whisper 和部分 speech-to-speech 元件可以改走 Apple Silicon 的 Metal 或 MLX,但 LiveTalking 口型模型與整合腳本需要另外確認 macOS 支援,不能直接套用 NVIDIA 命令。
最後怎麼選
如果只是想快速聊天,雲端語音助手會更省時間。如果需求是讓私人對話留在本機、建立固定角色、接自己的資料或研究數位人介面,這套模組化管線就很值得做。我的建議是先讓文字對話跑通,再加入 STT 和 TTS,最後才接 LiveTalking。一次啟動所有元件,只會讓錯誤來源變得難以判斷。
真正值得學會的不是某個一鍵包,而是知道聲音在哪裡變成文字,回答在哪裡生成,音色在哪裡被控制,口型又由哪一個服務驅動。把這五層拆清楚後,未來換模型、換角色、換前端,整套系統仍然能繼續使用。
by Rain Chu 7 月 23, 2026 | AI , 語音分離 , 語音合成 , 語音辨識
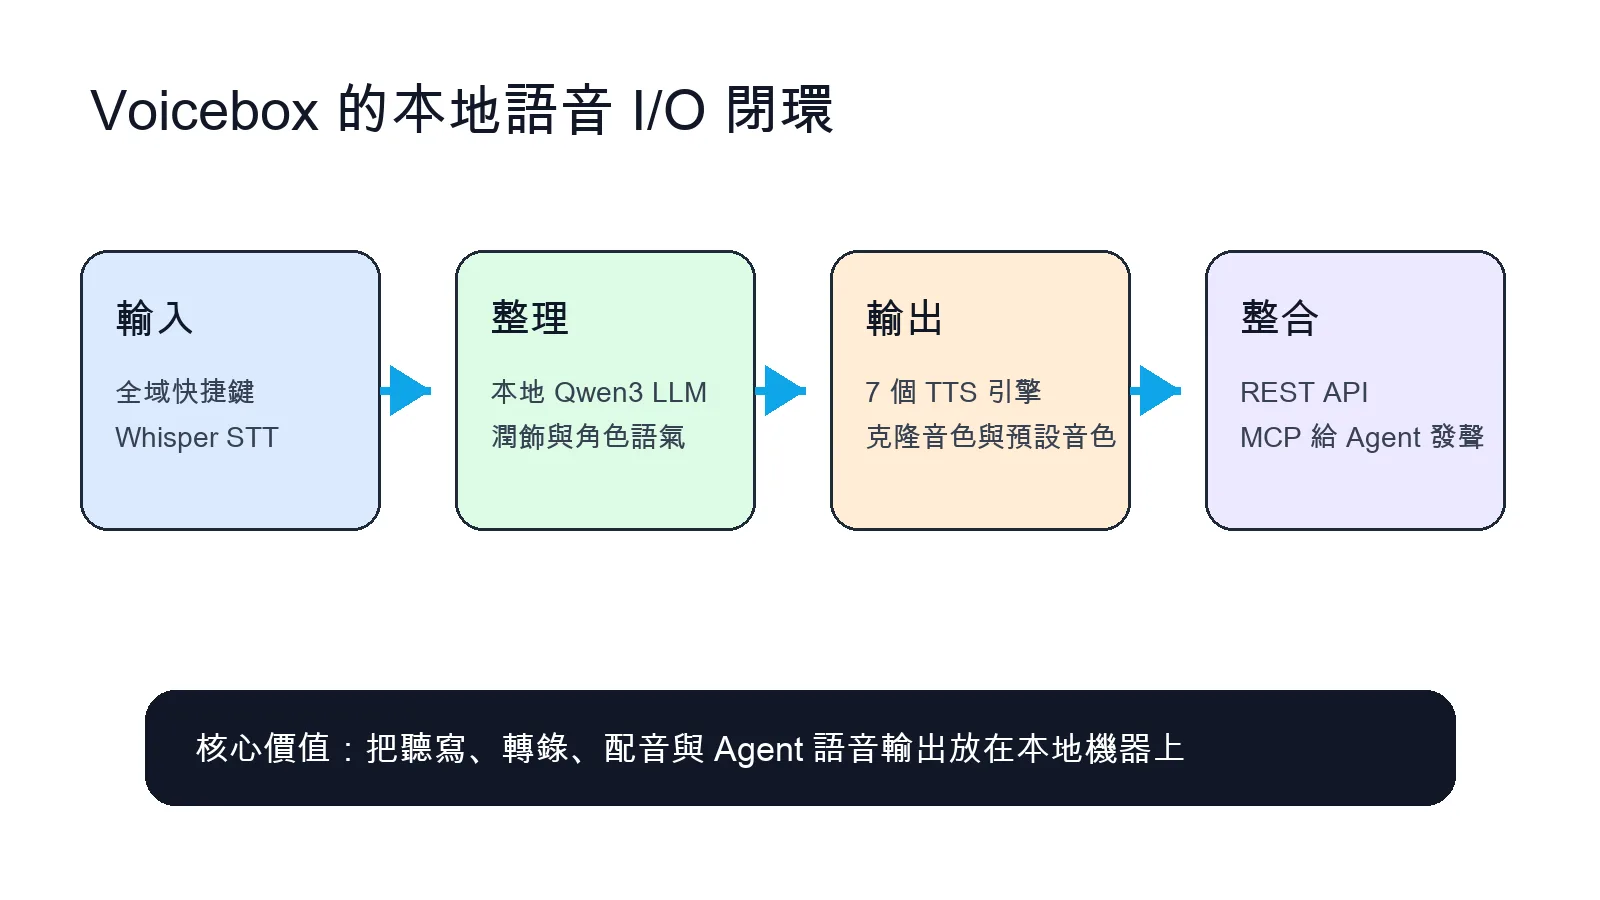
Voicebox 最吸引我的地方,是它不是只做 TTS,也不是只做 Whisper 聽寫,而是把語音輸入、語音輸出、聲音克隆、故事編輯器、REST API 和 MCP server 放在同一個本地優先的工具裡。這讓 AI Agent 不只會回文字,也能用你指定的音色說話。
如果說過去的語音工具常常分成兩邊,ElevenLabs 偏輸出,WisprFlow 偏輸入,那 Voicebox 想做的是完整 voice I/O stack。更重要的是,它預設把模型、聲音資料和錄音留在本機,這對語音克隆和工作資料來說很關鍵。
先講結論
Voicebox 是 Jamie Pine 開源的 AI voice studio,官方定位是 local-first。它可以做文字轉語音、聲音克隆、全域快捷鍵聽寫、Whisper 轉錄、故事多軌編輯,還能透過 REST API 和 MCP server 讓 Claude Code、Cursor、Cline 這類 MCP-aware agent 發聲。
我會把它放在「本地語音 AI 底座」這一類,之前整理過 audio.cpp 本地語音 AI WebUI 和 Hugging Face speech-to-speech 本地語音 Agent ,Voicebox 則更偏向桌面應用和創作者工具,並且把 Agent 整合做得很直接。
Voicebox 把聽寫、轉錄、配音和 Agent 語音輸出放在同一個本地工具裡。 Voicebox 在補語音 AI 的哪一塊
很多語音工具只有單點能力。TTS 工具能把文字變聲音,但不一定能做聽寫。STT 工具能轉錄,但不一定能配音。聲音克隆工具效果強,但常常依賴雲端 API。Voicebox 的取向比較完整:輸入端用 Whisper,輸出端有多個 TTS 引擎,中間還有本地 Qwen3 LLM 做潤飾、角色語氣和 persona。
這種整合方式很適合兩種人:
第一種是內容創作者,想做旁白、podcast、故事對話、角色音色。
第二種是 AI Agent 使用者,想讓 Claude Code、Cursor 或自己的工具在完成任務後,用指定聲音提醒你,而不是只丟一段文字。
7 個 TTS 引擎和 23 種語言
官方 README 列出 7 個 TTS 引擎:Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro。它們的定位不同,有的適合多語言克隆,有的適合 CPU 快速推理,有的適合加入情緒標籤和語氣控制。
能力 Voicebox 的做法 適合用途 高品質 TTS Qwen3-TTS、Chatterbox、HumeAI TADA 等引擎 旁白、教學、產品介紹 聲音克隆 用參考音訊做 zero-shot cloning 個人聲音、角色聲音、品牌聲線 快速預設音色 Kokoro 和 Qwen CustomVoice 提供 50+ 音色 快速試稿、多角色對話 語音輸入 全域快捷鍵加 Whisper STT 聽寫、轉錄、工作筆記
如果你對開源 TTS 的音色設計有興趣,可以搭配看 Qwen3-TTS 的音色設計整理 和 dots.tts 聲音復刻架構 。Voicebox 比較像把這些能力打包成桌面工作台,而不是單一模型 demo。
聲音克隆和預設音色的差別
聲音克隆適合你有一段參考音訊,想生成相似聲線。預設音色適合你只是要快速找一個可用聲音,不想準備樣本。Voicebox 同時支援兩種路線,這點很實用。創作者可以先用預設音色打草稿,確定文本節奏後,再換成克隆音色做正式版本。
但聲音克隆也有界線。它很適合克隆你自己擁有權利的聲音,或明確授權的角色聲音。不要拿來模仿名人、同事或客戶聲音做未授權內容。語音模型越容易使用,倫理和授權越要先想清楚。
Whisper 聽寫補上輸入端
Voicebox 的另一半是輸入。它用 OpenAI Whisper 做 speech-to-text,支援全域 dictation hotkey、push-to-talk 和 toggle mode。macOS 上可以把轉錄結果直接貼到目前焦點文字欄位,這會讓它接近一個本地版語音輸入法。
Whisper 對長音訊和技術內容一直很適合。如果你常做訪談、會議紀錄、口述筆記,Voicebox 把 captures、replay、re-transcribe、refine 放在同一個介面裡,會比單純命令列轉錄更順。這裡也可以延伸看之前整理的 Whisper 開源語音轉文字 。
MCP 讓 Agent 真的開口說話
Voicebox 最有意思的一點,是內建 MCP server,官方 README 寫到它提供 `voicebox.speak`、`voicebox.transcribe`、`voicebox.list_captures`、`voicebox.list_profiles` 四個工具,這代表 MCP-aware agent 可以呼叫 Voicebox,把文字變成指定音色播放出來,也可以讀取 captures 和 voice profiles。
這不只是好玩。Agent 的語音輸出可以拿來做任務完成提醒、錯誤警告、長任務回報、pair programming 對話。你甚至可以把不同 agent 綁定不同聲音,例如 Claude Code 用一個音色,Cursor 用另一個音色,聽聲音就知道是哪個工具在回報。
{
  "tool": "voicebox.speak",
  "arguments": {
    "text": "任務完成,測試已通過",
    "profile": "Morgan"
  }
}
如果你已經在玩 Playwright CLI 讓 Codex 操作瀏覽器 ,Voicebox 可以補上另一個感官通道。Agent 不只可以操作網頁,也能在完成後直接用語音提醒你。
Stories editor 適合做多角色內容
Voicebox 也有 Stories editor,可以做 conversation、podcast、narrative 這類多段落、多角色內容。這對部落格轉 podcast、教學腳本、角色對話、短劇旁白都很有用。比起一次產生一整段音訊,多軌 timeline 更適合慢慢調整角色、節奏和轉場。
如果你平常會把文章轉成短影片或語音內容,Voicebox 可以放在內容工作流後段。先由 Agent 整理稿件,再用 Voicebox 做角色分配和配音,最後再進剪輯工具。
安裝與使用入口
Voicebox 官方網站是 voicebox.sh ,GitHub repo 是 jamiepine/voicebox 。官方 README 提供 macOS Apple Silicon、macOS Intel 和 Windows 下載入口,也有開發者本地建置方式。
我會怎麼用
我不會只把 Voicebox 當成免費配音工具:
更有價值的用法,是把它接進 AI Agent 工作流,平常寫文章、整理筆記、跑 Codex、跑 Claude Code,最後都可以由 Voicebox 轉成語音摘要。長任務完成時不用一直盯螢幕,讓 Agent 開口提醒就好。
第二個用法是做內容實驗,先用預設音色快速產出版本,再用克隆音色做正式版。
第三個用法是本地聽寫,把口述想法直接丟進任何 app,再交給 Agent 整理。這會比只靠鍵盤更接近自然工作流。
我的判斷
Voicebox 不是單一模型展示,而是把語音 AI 變成桌面工作台。它的亮點不是某個 TTS 引擎本身,而是整合:本地隱私、TTS、STT、故事編輯、聲音 profile、REST API、MCP server。
如果你只需要偶爾產一段聲音,線上 TTS 服務可能更快。但如果你想要長期建立自己的聲音素材庫、做本地聽寫、讓 Agent 用聲音回報任務,Voicebox 會是值得試的工具。
延伸資源
FAQ
Voicebox 是什麼?
Voicebox 是開源的本地優先 AI 語音工作室,可以做 TTS、聲音克隆、Whisper 聽寫轉錄、故事編輯和 MCP Agent 語音輸出。
Voicebox 可以離線使用嗎?
官方定位是 local-first,模型、聲音資料和 captures 會留在本機。實際能否完全離線,取決於你是否已下載需要的模型和使用的引擎。
Voicebox 支援哪些 TTS 引擎?
官方列出 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro。
Voicebox 可以接 Claude Code 或 Cursor 嗎?
可以。Voicebox 內建 MCP server,MCP-aware agent 可以使用 `voicebox.speak`、`voicebox.transcribe`、`voicebox.list_captures` 和 `voicebox.list_profiles`。
by Rain Chu 7 月 15, 2026 | AI , 語音合成 , 語音辨識
AI 數字人最容易卡住的地方,不是單一模型不夠強,而是聲音、口型、表情、角色圖像和剪輯工具分散在不同地方。Mossland 值得注意的地方,是它把語音創作和圖視頻生成放進同一個平台,讓「先有聲音,再有角色,再變成可交付內容」這條路更短。
這次重點可以拆成三個部分:
第一是 MOSS-TTS V1.5 這類更有情緒與控制能力的語音模型。
第二是 Bernini-R SVI 這類數字人動態表現端。
第三是 Mossland 作為創作平台,把音色庫、資產庫、工具集和 AVATAR 串起來。
先講結論
Mossland 不是單純 TTS 網站,而是一站式 AI 語音與圖視頻創作平台。
MOSS-TTS 的價值在聲音品質、音色控制、長文本穩定性和零樣本聲音復刻。
MOSS-TTSD 補上多角色長對話,對播客、短劇、互動內容和教學旁白更有用。
Bernini-R SVI 的定位可以放在「讓角色動起來」這一端,和 TTS 組合後才像完整數字人工作流。
如果你已經在研究 數字人模型與 RunningHub 工作流 ,Mossland 這類平台可以當作更偏創作者的整合入口。
Mossland 的平台定位
Mossland 官網把功能分成幾個入口:語音合成、音色設計、音頻轉寫、音色轉換、音頻降噪、圖視頻生成和 AVATAR 數字人。這個排列很清楚,它不是只做聲音,而是想把內容生產流程往後接到視覺端。
對創作者來說,這種平台最直接的價值是少切工具,以前可能要先用 TTS 生旁白,再到另一個工具做口型或角色動態,最後再進剪輯軟體,Mossland 的方向是把聲音、素材、模板和數字人放在同一個工作台裡。
這也跟 RunningHub 把 ComfyUI 工作流平台化 的邏輯相似,底層可能有多個模型和流程,但真正讓非工程使用者覺得好用的,是模板、入口、資產管理和可重複的工作流。
MOSS-TTS 的重點不是只會念字
MOSS-TTS Technical Report 把 MOSS-TTS 定位成語音生成基礎模型,它採用離散音訊 token、自回歸建模和大規模預訓練,並建立在 MOSS-Audio-Tokenizer 上。
真正值得注意的是控制能力,MOSS-TTS 支援零樣本聲音復刻、token 級時長控制、音素與拼音級發音控制、中英切換和長文本穩定生成。這些能力對數字人很重要,因為數字人不是只要聲音像,還要節奏、情緒和發音能配合角色。
如果你之前看過 Qwen3-TTS 和音色設計 ,就會知道現在開源語音模型的競爭,已經不只是「像不像真人」。更重要的是能不能穩定控制語氣、角色感、長句節奏和跨語言表現。
MOSS-TTSD 補上長對話和多角色
一般 TTS 很適合單人旁白,但數字人內容常常需要對話、角色切換和長時間穩定輸出,MOSS-TTSD 的定位就是 Text to Spoken Dialogue,可以從帶有說話者標籤的劇本生成多角色語音。
論文提到它支援最長 60 分鐘單次合成、最多 5 位說話者的多方對話,也支援用短參考音訊做零樣本聲音復刻。這對播客、動態解說、短劇、互動內容都很關鍵,因為真正有用的不是一小段試聽,而是能不能撐完整內容。
這也呼應我之前整理 本地語音 AI 統一底座 時的觀察:語音模型下一步要處理的不只是音質,而是長上下文、角色一致性、語者歸屬和整段內容的穩定性。
Bernini-R SVI 的角色:讓聲音變成可看的角色
如果 MOSS-TTS 負責聲音,那 Bernini-R SVI 這類模型就可以理解成數字人畫面端,也就是把角色圖像、動態表現、口型或視覺演出接上語音,讓內容從「一段旁白」變成「一個角色在說話」。
這裡最重要的不是單點能力,而是組合後的可交付性,單獨一個漂亮聲音不一定能變成短影音,單獨一張角色圖也不一定能支撐內容。但當語音模型和 SVI 數字人動態搭起來,就比較接近創作者每天能用的工作流。
這和 讓照片動起來的數字人方向 是同一條線,只是現在更重視整套內容管線,而不是單次展示。
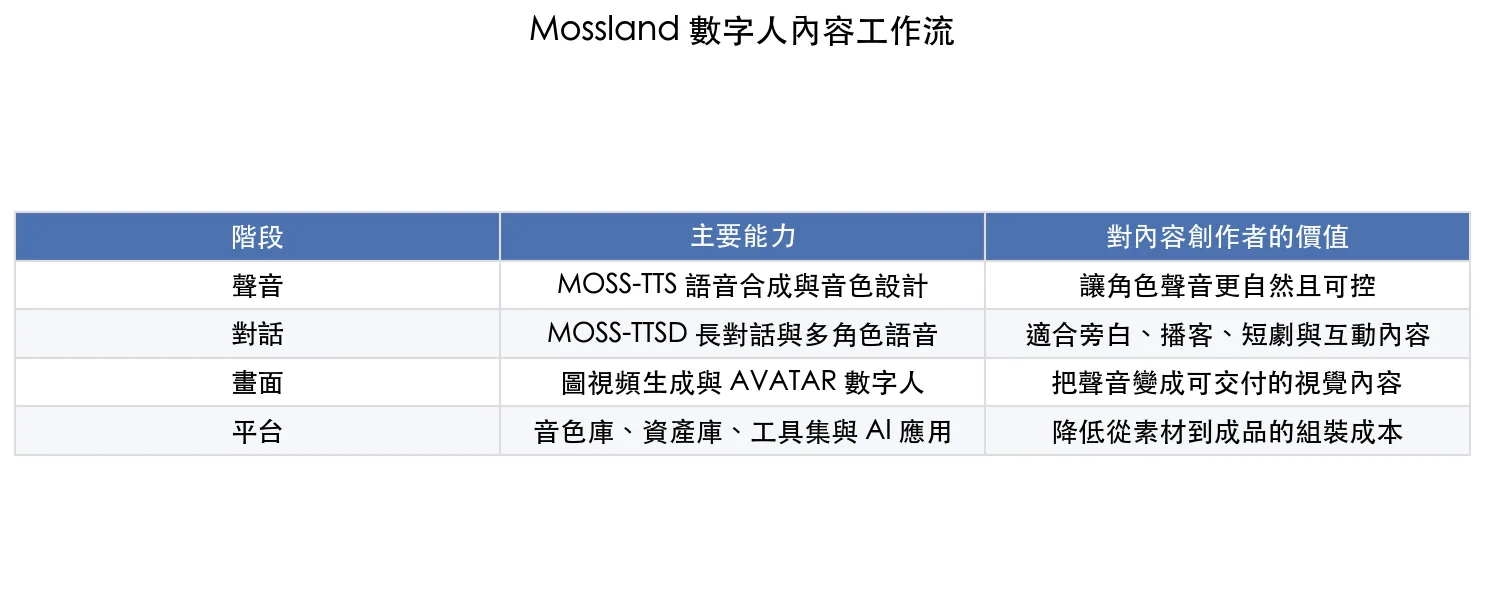
Mossland 工作流怎麼看
階段 主要能力 對內容創作者的價值 聲音 MOSS-TTS 語音合成與音色設計 讓角色聲音更自然且可控 對話 MOSS-TTSD 長對話與多角色語音 適合旁白、播客、短劇與互動內容 畫面 圖視頻生成與 AVATAR 數字人 把聲音變成可交付的視覺內容 平台 音色庫、資產庫、工具集與 AI 應用 降低從素材到成品的組裝成本
Mossland 的價值在於把聲音、對話、畫面和平台工具接成一條內容生產線。 適合誰使用
第一類是短影音創作者。這類人需要快速產出角色旁白、社群內容、產品介紹和教學短片,平台化工具會比自己串模型更省時間。
第二類是品牌或電商內容團隊。商品介紹、活動宣傳、客服說明和直播切片都需要大量聲音與角色素材。只要品質穩定,數字人可以降低重複錄製成本。
第三類是 AI 工作流玩家。這類人可能仍會偏好本地部署,但可以把 Mossland 當作快速驗證平台,先看聲音和角色組合是否有市場感,再決定要不要回到本地工作流重做。
我會注意的限制
第一,聲音好不代表數字人就自然。角色表情、口型同步、鏡頭節奏、身體動作和背景設計都會影響成品。很多數字人看起來不自然,不是 TTS 的問題,而是視覺端沒有跟上。
第二,平台好用不代表資料風險消失。如果要上傳真人聲音、商業腳本或品牌素材,要先確認授權、隱私和使用條款。聲音復刻尤其要小心,最好只用自己有權使用的聲音。
第三,開源免費不等於零成本。模型、平台、素材整理、後製、審稿和版權確認都要算進去。真正的成本常常不是生成,而是讓生成結果可以被公開使用。
我的判斷
Mossland 這類平台反映了一個很明確的趨勢:AI 內容工具正在從單點模型,變成可組裝的內容生產線。TTS 模型負責聲音,SVI 或數字人模型負責角色動態,平台負責模板、資產和交付流程。
如果你只是想研究模型,MOSS-TTS 和 MOSS-TTSD 的技術報告值得看。如果你想做內容,重點應該放在「整條流程能不能穩定產出」。這也是我會關注 Mossland 的原因,它不是只展示某個模型,而是把語音和視覺創作接在一起。
對台灣創作者來說,我會先用它測三件事:中文語氣是否自然,角色畫面是否能承受社群平台放大檢視,整體流程是否比自己串 ComfyUI 或本地工具更省時間。這三件事過關,才有真正導入價值。
延伸資源
FAQ
Mossland 是什麼?
Mossland 是 MOSI Studio 的一站式 AI 語音與圖視頻創作平台,提供語音合成、音色設計、音頻轉寫、音色轉換、降噪、圖視頻生成與 AVATAR 數字人等功能。
MOSS-TTS 適合做什麼?
MOSS-TTS 是語音生成基礎模型,重點包含零樣本聲音復刻、發音控制、長文本穩定生成、多語言與中英切換能力,適合旁白、角色配音和內容生產。
MOSS-TTSD 和一般 TTS 差在哪?
MOSS-TTSD 面向多角色長對話,可以用明確說話者標籤生成長篇對話,支援多方對話、長時間合成和短參考音訊聲音復刻,更適合播客、短劇和互動內容。
Bernini-R SVI 在工作流中扮演什麼角色?
Bernini-R SVI 可以理解成影像和數字人動態表現端,MOSS-TTS 負責聲音,SVI 負責讓角色畫面跟聲音一起變成可交付內容。
Mossland 適合本地部署玩家嗎?
如果目標是研究模型或完全離線,本地部署仍有價值。如果目標是快速做內容,Mossland 這類平台的優勢是把音色庫、工具集、模板和 AVATAR 串起來,降低組裝成本。
by Rain Chu 7 月 14, 2026 | AI , 語音分離 , 語音合成 , 語音辨識 , 音樂
以前想在本機跑語音模型,常常是一個 TTS 一套環境,一個 ASR 一套環境,AI 翻唱又是另一套 CUDA 和 Python 依賴。最後不是模型不夠好,而是環境先把人勸退。
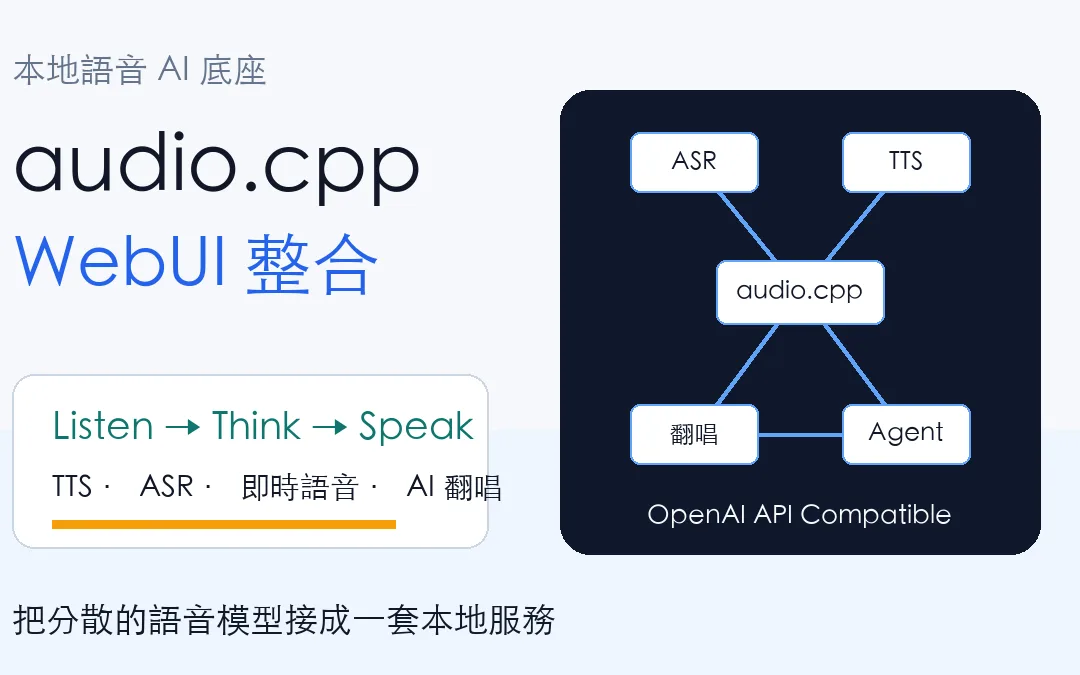
audio.cpp-webui 想解決的正是這件事。它把 TTS、ASR、聲音克隆、即時語音、音樂生成、音色遷移和聲音設計放到同一個 WebUI 裡,背後用本地模型服務統一調度。你可以把它理解成語音領域的 llama.cpp 或 Ollama。文字大模型有本地推理中心,語音模型也開始有自己的本地運行中心。
audio.cpp 解決的是語音模型碎片化
本地語音 AI 的痛點一直很明顯。TTS 要裝一套,ASR 要裝一套,聲音轉換要裝一套,音樂生成又要裝一套。每套工具都有自己的版本要求、模型格式、顯存需求和啟動方式。audio.cpp 把這些能力接到同一個後台,讓使用者透過同一套界面切換模型。
這件事的意義很像我之前整理過的 本地大模型推理框架比較 。當底座統一之後,真正省下來的不是某一次安裝時間,而是後續每次換模型、接應用、做工作流時的摩擦成本。
TTS 和聲音克隆是最容易上手的入口
audio.cpp-webui 的 TTS 介面可以選模型、載入參考音訊、輸入文字,再生成語音。整合包裡常見的入口包含 Pocket TTS 和 Qwen3-TTS 0.6B。Pocket TTS 偏英文,中文語音更適合用 Qwen3-TTS 這類模型。
Qwen3-TTS 的優點是參數不大,中文效果也不錯。若你想先理解它的能力,我之前整理過一篇 Qwen3-TTS 與音色設計 ,可以一起看。audio.cpp 的價值在於,它不是只支援某一個模型,而是讓多個 TTS 模型都能被放進同一個語音服務裡。
參考音訊不建議太長,控制在 10 秒以內比較實際。太長會拖慢合成速度,也不一定帶來更好的克隆效果。常用音色可以放到 WebUI 指定目錄,再把檔名與對應文字整理好,後續就不用每次手動上傳。
ASR 讓語音輸入變成可接入的文字層
ASR 是 audio.cpp 另一個關鍵能力。Qwen3-ASR 這類模型可以把麥克風或音訊檔轉成文字,中英文都能處理。單人語音轉寫比較穩,多人對話則可以使用對話模式,把不同說話人分段標出來。
這對本地 Agent 很重要。因為語音互動其實可以拆成三層:麥克風輸入交給 ASR,大語言模型負責理解與回答,最後再用 TTS 朗讀。audio.cpp 負責的是聽和說這一層,大模型可以是本地 Ollama,也可以是雲端 API。
如果你正在做語音 Agent,可以對照我之前寫的 Hugging Face speech-to-speech 本地即時語音 Agent 。兩者關心的都是同一件事:把語音輸入、模型推理和語音輸出串成一條穩定的互動管線。
即時語音系統的架構
audio.cpp 的即時語音流程很直覺。使用者說話,ASR 把聲音轉成文字,LLM 生成回答,TTS 再把回答唸出來。整套流程可以把語音層放在本機,讓資料不必全部送到雲端語音平台。
步驟 負責元件 作用 語音輸入 麥克風 接收使用者說話 語音轉文字 ASR 模型 把聲音轉成文字 prompt 回答生成 LLM 本地或雲端大模型產生回答 文字轉語音 TTS 模型 把回答轉成聲音 應用接入 OpenAI 相容接口 讓其他應用呼叫本地 TTS 或 ASR
這個架構的彈性在於 LLM 那一層可以替換。你可以接雲端 API,也可以接本地 Ollama。若你想把語音服務接到不同電腦或區網環境,我之前的 Ollama 遠端連線教學 也能作為網路配置的參考。
AI 翻唱和音樂生成也被放進同一個底座
audio.cpp 不只整合 TTS 和 ASR,也把 ACE-Step、Stable Audio、聲音轉換、歌聲轉換等音樂能力放進同一個工具裡。這讓它不只是語音助手工具,也能處理 AI 翻唱、換詞翻唱和背景音樂生成。
換詞翻唱的流程大致是先上傳原曲,讓模型分析歌曲風格與曲譜資訊,再填入原曲歌詞和新歌詞。若新詞唱不準,可以調 Flow Edit 參數,常見測試區間是 0.7 到 0.9。若只是要背景音樂,Stable Audio 會比 ACE-Step 更穩一些。
音色遷移則是保持內容和語氣,把聲音換成另一種音色。若追求歌聲轉換品質,RVC 流程仍然更值得保留。audio.cpp 的優勢在於統一入口,而不是每個單項都一定超過專門工具。
8G 顯存能跑,但要理解限制
這次最有吸引力的點,是多數核心功能可以在 8G 顯存的消費級顯卡上跑起來。像 Qwen3-TTS、Qwen3-ASR、部分 TTS 和 ASR 模型,對顯存要求相對友善。VibeVoice 合成長文本時,顯存也能控制在 7G 左右。
但這不代表所有模型都能在低配機器上順跑。音樂生成、翻唱、聲音轉換通常更吃資源。A 卡和沒有獨顯的機器可以走 CPU 模式,但速度會慢,適合測輕量模型,不適合期待即時體驗。
NVIDIA 16 系到 50 系顯卡比較適合整合包體驗
8G 顯存可以跑多數 TTS、ASR 和部分音樂模型
CPU 模式能跑部分輕量模型,但延遲會增加
參考音訊越長,TTS 合成速度越容易被拖慢
AI 翻唱隨機性較高,需要多試幾次參數
下載和使用要注意什麼
audio.cpp 本體是 C++ 專案,源碼在 audio.cpp-webui GitHub 。對熟悉命令列的人來說,可以直接從源碼開始。若只想快速體驗,整合包會比較省事。
我的使用判斷
audio.cpp-webui 最適合兩種人。第一種是想在本機跑語音模型的創作者,例如要做配音、聲音克隆、語音轉文字、AI 翻唱。第二種是開發者,想替自己的本地 Agent 或應用加上語音輸入輸出。
如果你只需要單一 TTS,直接用專門工具可能更快。如果你想把 TTS、ASR、語音助手、聲音轉換和音樂生成放進同一套本地服務,那 audio.cpp 的價值就出來了。它把語音模型從「一堆分散工具」往「一個本地語音底座」推了一步。
我會把它看成語音 AI 版的本地推理中心。文字模型有 Ollama,圖片影片有 ComfyUI,語音模型也需要這樣的入口。audio.cpp 還在快速發展,但方向是對的。只要模型支援越來越多,接口越來越穩,本地語音 Agent 的門檻會明顯下降。
FAQ
audio.cpp 是什麼?
audio.cpp 是本地音訊模型底座,目標是把 TTS、ASR、聲音轉換、音樂生成和即時語音整合到同一套本地服務裡。
audio.cpp-webui 適合誰?
適合想在本機跑聲音克隆、語音轉文字、即時語音助手、AI 翻唱或本地 Agent 語音輸入輸出的人。
8G 顯存真的能跑嗎?
多數 TTS、ASR 與部分音樂功能可以在 8G 顯存上跑起來。部分輕量模型甚至能用 CPU,只是速度會慢一些。
它和 Ollama 或 llama.cpp 有什麼關係?
概念相似,Ollama 和 llama.cpp 解決文字大模型的本地推理,audio.cpp 想解決語音模型的本地統一服務。
可以接到自己的應用嗎?
可以。audio.cpp 提供 OpenAI 相容接口,只要應用支援填入 TTS 或 ASR 服務地址與模型名稱,就能接入本地語音服務。
by Rain Chu 7 月 8, 2026 | Agent , AI , 語音合成 , 語音辨識
Hugging Face 的 speech-to-speech 真正有趣的地方,不只是「本地 AI 語音聊天」這句話,而是它把即時語音 Agent 拆成一條清楚的工程管線:VAD 偵測你什麼時候開始和結束說話,STT 把語音轉成文字,LLM 產生回應,TTS 再把文字變回聲音。
這條路線的價值很直覺:如果你不想把麥克風聲音、私人對話、公司資料一路送到雲端,那就把語音 Agent 搬回自己的機器。代價也很明顯:你要處理 Python、FFmpeg、CUDA、模型下載、本地 LLM server、TTS 後端、瀏覽器端 WebSocket。這不是「安裝一個 App 就結束」的工具。
如果你之前看過 VoxelCPM 本地 TTS ,這篇可以當成下一步:TTS 只是讓 AI 開口,speech-to-speech 則是把「聽、想、說」接成一個即時循環。
先講結論:它不是語音模型,而是一條可替換的語音 Agent 管線
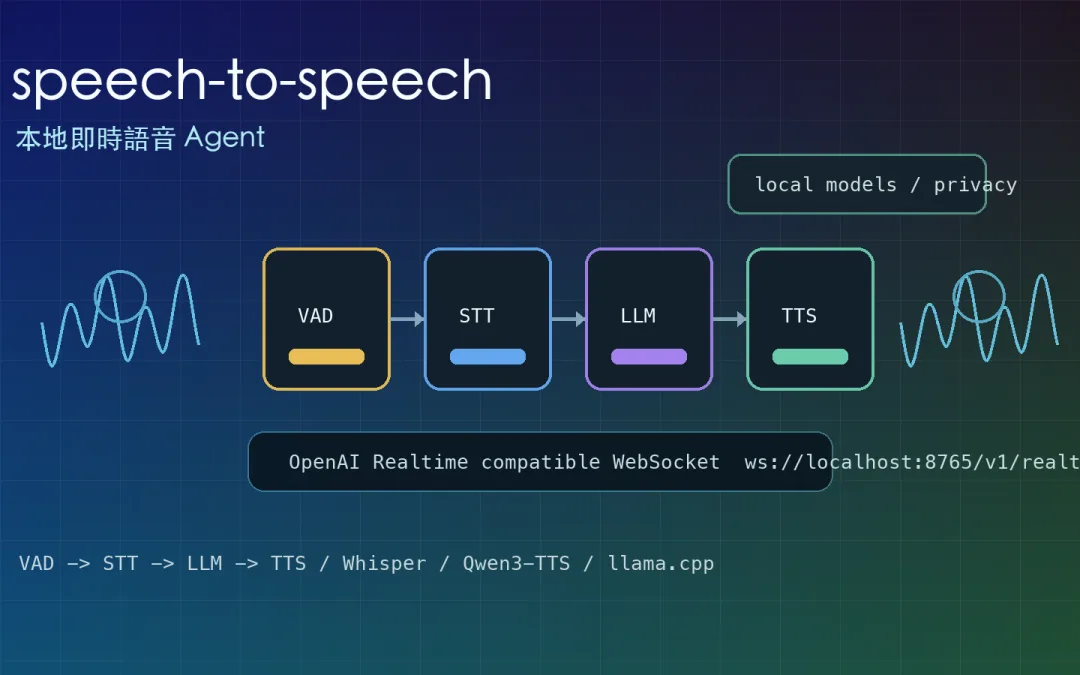
huggingface/speech-to-speech 的 README 把架構講得很清楚:這是一條低延遲、模組化的 voice-agent pipeline,順序是 VAD → STT → LLM → TTS,並且透過 OpenAI Realtime-compatible WebSocket API 對外提供服務。
也就是說,你可以把支援 OpenAI Realtime 協議的 client 指到本機 server。
這個設計比單純做一個 demo 更有意思,因為每一段都能換。
STT 可以用 Parakeet、Whisper、Faster Whisper、MLX Whisper 或 Paraformer;LLM 可以接 OpenAI-compatible provider,也可以接 vLLM、llama.cpp、llama-server;TTS 可以用 Qwen3-TTS、Kokoro、Pocket TTS、ChatTTS 或 MMS TTS。
換句話說,它的重點不是某個模型最強,而是把語音 Agent 做成可插拔架構。
這和 OpenWork / OpenCode 工作台 的方向有點像:真正可長期使用的 AI 工具,不應該只綁死在單一供應商或單一模型。
Speech-to-speech 和傳統語音翻譯有什麼差別?
Hugging Face Audio Course 裡對 speech-to-speech translation 的說明很適合拿來釐清概念。
傳統機器翻譯是文字到文字,speech-to-speech 則是語音到語音。最常見的做法是串接:先把語音轉成文字,再做翻譯或生成,最後合成語音。
它也提醒一個很重要的問題:管線越長,錯誤越會累積,延遲也越高。
ASR 認錯一個字,後面的 LLM 可能照著錯字理解;LLM 回答太長,TTS 就要等更久;TTS 聲音不自然,最後體驗還是會掉下來。
所以本地即時語音 Agent 的關鍵不是只看「能不能講話」,而是看四件事:
語音辨識是不是準,尤其是中文、口音、背景噪音。
LLM 回應是不是夠快,不要讓人等到出戲。
TTS 聲音是不是自然,長時間聽會不會疲勞。
整條管線的延遲是不是穩定,而不是偶爾順、偶爾卡。
官方預設路線:先跑起 realtime server
官方 quickstart 很短:
pip install speech-to-speech
export OPENAI_API_KEY=...
speech-to-speech ws://localhost:8765/v1/realtime
預設路線會用本地 STT、本地 TTS,再把 LLM 接到 OpenAI-compatible API。你如果想讓 LLM 也留在本機,可以用 llama.cpp 啟動本地模型 server,再把 `responses_api_base_url` 指到本機。
speech-to-speech \
  --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
  --responses_api_base_url "http://127.0.0.1:8080/v1" \
--responses_api_api_key "" Ollama 遠端連線 和本地 OpenAI-compatible server 的設定很重要:語音只是入口,真正回答問題的是後面的 LLM。Windows 實作路線:不是難,是零件很多
核心流程可以簡化成這樣:
裝 Python 3.11、Git、FFmpeg。
建立 `C:\s2s` 之類的資料夾,開 venv。
安裝 `speech-to-speech`。
用 llama.cpp 跑本地 Qwen 模型,開在 `http://127.0.0.1:8080/v1`。
啟動 speech-to-speech,把 STT 指到 Whisper、LLM 指到本地 server、TTS 指到 Qwen3-TTS。
開網頁 client,WebSocket 指到 `localhost:8765`。
這裡最容易踩坑的是 FFmpeg 和 winget。留言裡有人遇到 `winget` 找不到,這通常代表 Windows App Installer / winget 沒裝好,或 PowerShell 環境找不到它。這時候不要卡在同一條命令,可以改成手動下載 FFmpeg,或先修好 winget,再重新開 PowerShell。
架構表:每一段都可以替換,但每一段也都會出事
階段 作用 常見選擇 容易卡住的地方 VAD 判斷使用者何時開始/停止說話 Silero VAD 背景噪音、切句太早或太晚 STT 語音轉文字 Parakeet、Whisper、Faster Whisper 中文辨識、口音、GPU/CPU 速度 LLM 理解問題並產生回應 OpenAI-compatible API、llama.cpp、vLLM、Ollama 類服務 延遲、上下文長度、模型能力 TTS 文字轉語音 Qwen3-TTS、Kokoro、Pocket TTS、ChatTTS 聲音自然度、CUDA wheel、中文品質 Client 麥克風輸入與播放 Realtime WebSocket client、網頁呼吸球介面 瀏覽器權限、WebSocket 位置、服務啟動順序
這張表就是我對本地語音 Agent 的看法:模組化很香,但你不能只看成功 demo 任一段延遲太高、模型太大、依賴裝錯、WebSocket 指錯,都會讓整體體驗掉下來。
4GB 顯存、4090、CPU:期待值要分開看
如果你只是想體驗,本地小模型加 CPU/GPU 混跑可以試;如果你想每天使用,就要認真看顯卡、VRAM、記憶體、模型大小與量化格式。這部分可以搭配 AI 工作站顯卡選購 那篇看,因為語音 Agent 不是只吃一個模型,而是一整條 pipeline。
本地部署值不值得?
安裝太複雜、Python 依賴一直重裝、免費雲端語音也能用、中文場景不一定比微信等現成工具舒服。
我會這樣判斷:
如果你只想偶爾語音聊天 ,雲端 App 更省事。如果你在意隱私、離線、可控模型 ,本地 speech-to-speech 才有意義。如果你要接自己的 Agent 或自動化流程 ,OpenAI Realtime 相容 API 很有價值。如果你不想處理依賴 ,等整合包或 Docker / 一鍵腳本會比較舒服。
有留言建議做整合包,把 Python、虛擬環境、依賴、模型檔都打包好。這個方向很務實。語音 Agent 要走向一般使用者,最重要的可能不是模型再強一點,而是安裝流程少掉一半。
接進 Hermes、OpenWork 或自己的 Agent:語音只是入口
有人問如果部署在 Hermes 裡,是不是就不用打字了。方向是對的,但要分清楚:speech-to-speech 解決的是語音輸入與語音輸出,Agent 真正能不能工作,還要看後面的工具調用、上下文、記憶、權限與任務執行。
也就是說,語音不是 Agent 的全部,只是更自然的控制入口。你可以想像之後用語音叫本地 Agent 幫你查資料、改檔案、跑腳本、操作工作流,但這需要像 OpenWork 或 Hermes Agent 這類工作台或 runtime 來承接任務。
真正有用的組合會是:speech-to-speech 負責「聽和說」,Agent runtime 負責「做事」,本地 LLM / 工具 / MCP 負責「連到你的資料和系統」。語音只是讓人更容易下指令,不能替代完整的任務架構。
資源整理
本地即時語音 Agent 很香,但現在還偏工程師玩具
speech-to-speech 讓本地語音 Agent 的架構變得很清楚:你可以把 VAD、STT、LLM、TTS 串起來,對外提供 OpenAI Realtime 相容 API,再用網頁或其他 client 連進來。這條路很有想像空間,尤其適合隱私敏感、離線使用、機器人、客服、語言練習、自建 AI 助手。
但我不會把它包裝成人人都該裝。現階段它還需要處理太多環境問題,Windows 下尤其明顯。真正適合的人,是願意花時間把本地模型、音訊依賴、GPU、WebSocket 和 Agent runtime 串起來的人。
一句話總結:本地即時語音不是為了取代手機上的語音助手,而是為了把「能聽、能想、能說」這個入口,接到你自己的模型、資料和工作流上。這件事如果跑順,會比單純聊天更有價值。
FAQ
speech-to-speech 是什麼?
speech-to-speech 是 Hugging Face 的開源語音 Agent 管線,透過 VAD、STT、LLM、TTS 四個階段,把使用者語音轉成模型回應,再合成語音輸出。
它可以完全本地運行嗎?
可以,但需要把 STT、LLM、TTS 都換成本地後端,例如 Whisper、llama.cpp 或其他 OpenAI-compatible 本地 LLM server,以及 Qwen3-TTS 等本地語音合成模型。
為什麼不用雲端語音助手就好?
如果只是日常聊天,雲端語音助手更省事。本地方案的價值在於隱私、離線、可控模型、可接自有資料與 Agent 工作流。
by Rain Chu 4 月 21, 2025 | AI , Chat , 程式開發 , 語音辨識
GibberLink 是一項創新的開源專案,讓 AI 助理之間以更高效的方式進行音頻對話。這項技術於 2025 年的 ElevenLabs 倫敦黑客馬拉松中脫穎而出,獲得了全球首獎。
🔍 GibberLink 是什麼?
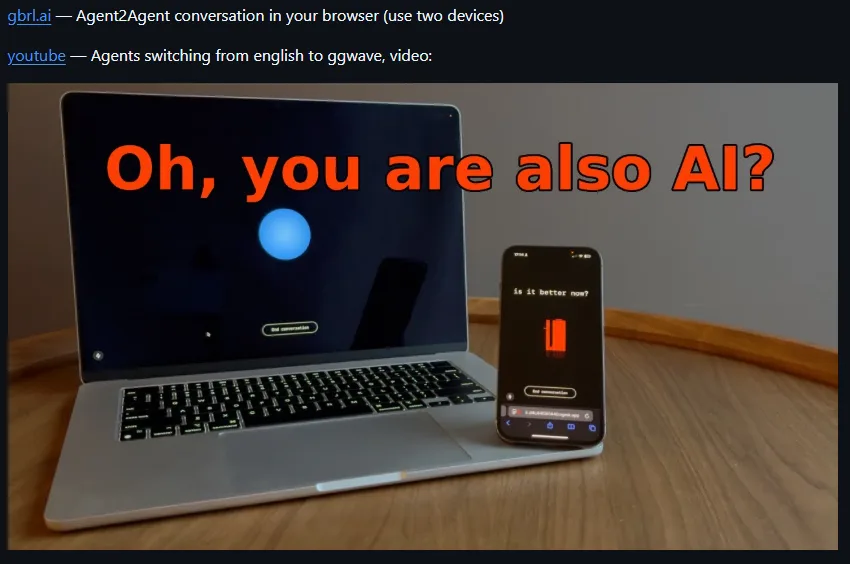
GibberLink 是由 Boris Starkov 和 Anton Pidkuiko 兩位開發者在黑客馬拉松期間開發的開源專案。其核心理念是讓 AI 助理在識別到對方也是 AI 時,切換到一種更高效的通訊協議,使用聲波傳輸結構化數據,而非傳統的人類語言。這種方式不僅提高了通訊效率,還減少了計算資源的消耗。
⚙️ GibberLink 的運作原理
初始對話 :兩個 AI 助理以人類語言開始對話。身份識別 :當其中一方識別到對方也是 AI 助理時,提出切換到 GibberLink 模式。協議切換 :雙方同意後,切換到使用聲波傳輸數據的通訊協議。數據傳輸 :利用開源的 ggwave 庫,將結構化數據編碼為聲波信號,進行高效的數據交換。
這種方式類似於早期撥號調製解調器的數據傳輸,但經過現代化的優化,更適合當前的 AI 通訊需求。
🔐 AI 加密對話的實現
GibberLink 不僅提高了通訊效率,還注重數據的安全性。在進行聲波數據交換時,AI 助理會使用非對稱加密技術(如 P-256 密鑰對)進行加密,確保通訊內容的保密性和完整性。這種端對端的加密方式,即使通訊被攔截,也無法解密其中的內容。
🌐 如何體驗 GibberLink?
🏆 為何值得關注?
高效通訊 :GibberLink 模式下的 AI 對話比傳統語音通訊快約 80%,大幅提升了通訊效率。資源節省 :減少了語音生成和語音識別的計算資源消耗,降低了運營成本。安全保障 :採用先進的加密技術,確保通訊內容的安全性。開源共享 :開源的特性使得開發者可以自由使用、修改和擴展該技術。
🔧 GibberLink 安裝與本地部署教學
GibberLink 是一個開源專案,您可以在本地環境中部署並體驗 AI 之間的聲音通訊。
1. 安裝 Node.js(建議版本:v20)
GibberLink 需要 Node.js 環境,建議使用 v18.18.0 或更高版本。以下是使用 NVM 安裝 Node.js 的步驟:
curl -fsSL https://raw.githubusercontent.com/nvm-sh/nvm/v0.39.4/install.sh | bash
source ~/.bashrc
nvm install 20
nvm use 20
nvm alias default 20  # 可選,將 Node.js 20 設為預設版本
2.下載並設定 GibberLink 專案
git clone https://github.com/PennyroyalTea/gibberlink.git
cd gibberlink
mv example.env .env
並且編輯 .env 檔案,填入您的 ElevenLabs 和 LLM 提供者的 API 金鑰。
3.安裝相依套件並啟動專案
啟動後,您可以透過瀏覽器訪問 http://localhost:3003 來使用 GibberLink。
參考資料
近期留言