by Rain Chu 9 月 14, 2026 | AI , QWEN , TTS , 虛擬人 , 語音合成 , 語音辨識
把 AI 對話、即時語音和會動的人像放在同一台電腦上,現在已經可以做出一套不依賴雲端 API 的互動數位人,用 faster-whisper 聽懂麥克風,讓 Qwen3 產生回答,再交給 Qwen3-TTS 合成聲音,最後由 LiveTalking 完成口型同步與 WebRTC 串流。
先講我的結論。這套方案的價值是隱私、角色控制與離線能力,不是安裝後完全沒有成本。模型權重下載完成後確實不需要按次支付 API 費用,但顯卡、記憶體、硬碟、電力與維護時間仍然是成本,所謂 8GB 顯存能跑,也必須以較小的 LLM、量化權重和分階段載入為前提.若想讓 14B LLM、Whisper large-v3、1.7B TTS 與口型模型同時常駐,16GB 顯存仍可能不夠。
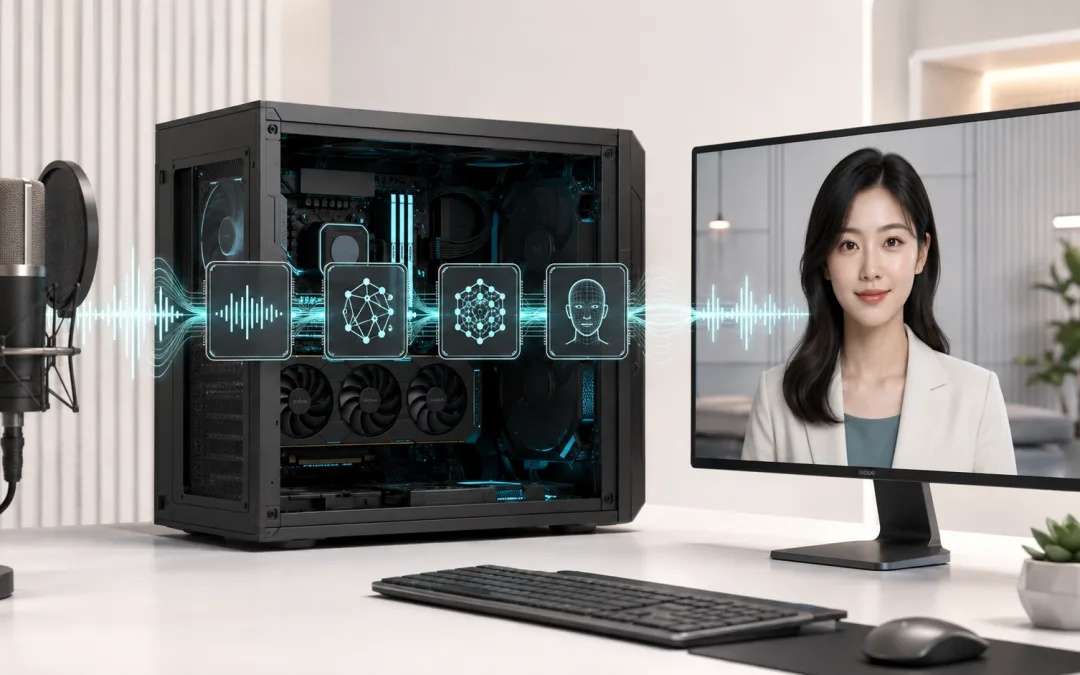
整套本地 AI 數位人怎麼運作
這不是單一模型,而是一條由五個服務組成的即時管線。
VAD 判斷使用者何時開始與停止說話faster-whisper 把麥克風聲音轉成文字Qwen3 與 llama.cpp 根據角色設定產生回答Qwen3-TTS 把回答轉成指定音色的語音LiveTalking 接收音訊並驅動嘴型,再透過 WebRTC 顯示互動人像
這種模組化做法和我之前整理的 Hugging Face speech-to-speech 本地即時語音 Agent 是同一條思路。每一層都能替換,但每一層也有自己的模型、連接埠與執行環境。LiveTalking 不會自動知道 Qwen3-TTS 在哪裡,兩者中間仍需要官方支援的 TTS 外掛,或一個把生成音訊送到 /humanaudio 的橋接程式。
先算顯存,不要先相信 8GB 宣傳
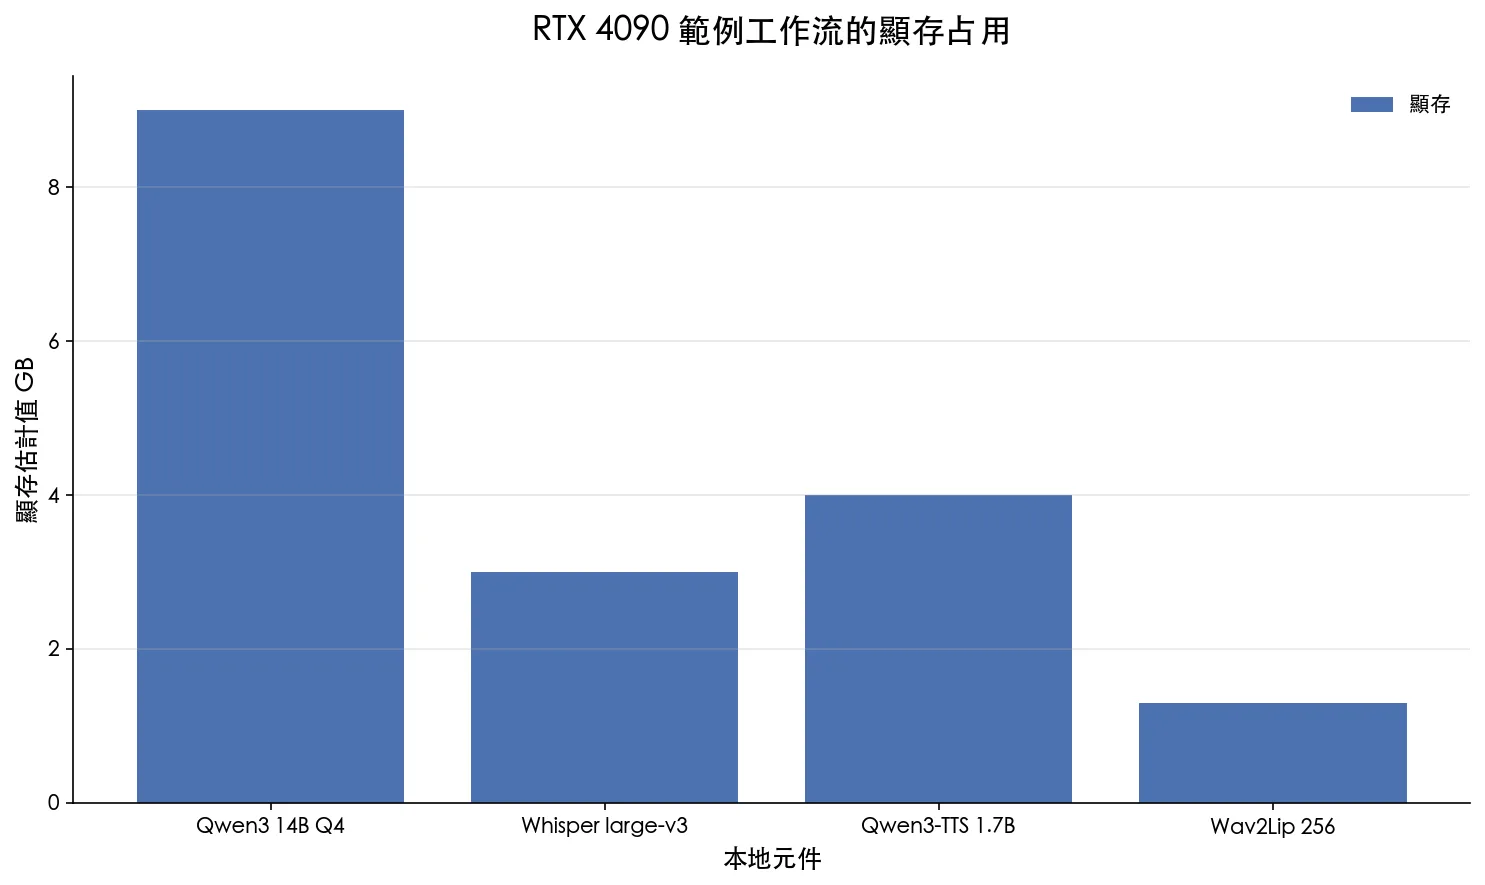
元件 RTX 4090 範例占用 低顯存調整 Qwen3-14B Q4_K_M 約 9GB 改用 8B 或 4B 的 Q4_K_M faster-whisper large-v3 約 3GB 改用 medium,準確度會有取捨 Qwen3-TTS 1.7B 約 4GB 改用 0.6B 或依序載入服務 Wav2Lip 256 約 1.3GB 降低批次並避免其他 GPU 程式常駐
這是 RTX 4090 整合環境的估計值,不同量化、上下文長度與 CUDA 版本都會改變結果 四個元件加起來約 17.3GB,還沒算 CUDA context、瀏覽器與暫存空間。16GB 顯卡跑到 99% 甚至整台機器失去回應,並不意外。6GB 顯存可以先用 Qwen3-4B 的 GGUF 量化版,並把語音辨識改成 medium。8GB 到 12GB 則適合 Qwen3-8B 搭配較小 TTS,或讓部分元件使用 CPU。若想了解 GGUF、llama.cpp 與 Ollama 的取捨,可以先看 本地大模型推理框架比較 。
第一步,在 Windows 準備 WSL 2
這套整合方式把 llama.cpp 放在 Windows,語音與數位人服務放在 Ubuntu 24.04 的 WSL 2。先用系統管理員身分開啟 PowerShell。
wsl --update
wsl --install -d Ubuntu-24.04
Windows 使用者目錄的 .wslconfig 可以設定記憶體與鏡像網路。32GB 是範例,請依實際 RAM 調整,不要把主機記憶體全部交給 WSL。
[wsl2]
memory=32GB
networkingMode=mirrored

[experimental]
hostAddressLoopback=true
修改後重啟 WSL。
wsl --shutdown進入 Ubuntu 後先用 nvidia-smi 檢查 GPU。NVIDIA 的 Linux 驅動不要再裝進 WSL,CUDA passthrough 由 Windows 顯示卡驅動提供。AMD 顯卡不能照搬這套 CUDA 整合包,需要改走 ROCm 支援的元件,或把無法使用 ROCm 的部分移到 CPU。
專案最好放在 Linux 家目錄,不要直接在 /mnt/c 執行。這能避開 I/O 速度、權限與換行格式問題。
mkdir -p ~/setup
cp -r "/mnt/c/Users/YOUR_NAME/Desktop/AI/." ~/setup/
cd ~/setup
sudo apt update
sudo apt install -y ffmpeg dos2unix python3-venv
dos2unix *.sh
chmod +x *.sh
第二步,用 llama.cpp 啟動 Qwen3
llama.cpp 提供 OpenAI 相容 HTTP 服務,語音管線不必知道底層跑的是 GGUF。16GB 以上可以從 Qwen3-14B 的 Q4_K_M 開始,8GB 到 12GB 建議改成 8B,4GB 到 6GB 則從 4B 測試。
llama-server -m E:\llama.cpp\models\Qwen3-14B-Instruct-Q4_K_M.gguf ^
  -np 1 -c 8192 -fa on --temp 1.0 --top-p 0.95 ^
  --host 0.0.0.0 --port 8090
新版 llama.cpp 文件也開始使用 llama serve 名稱,實際命令要以下載版本為準。Windows 的 8080 有時落在 Hyper-V 保留範圍,所以範例改用 8090。若服務無法綁定,可以先檢查保留埠。
netsh interface ipv4 show excludedportrange protocol=tcp第三步,安裝即時語音管線
Hugging Face 官方 speech-to-speech 現在以 serve、talk 和 local 為主要命令,舊資料裡的 --mode 已經淘汰。先建立獨立環境,再安裝 faster-whisper 額外依賴。
python3 -m venv ~/venvs/s2s
source ~/venvs/s2s/bin/activate
python -m pip install --upgrade pip
pip install "speech-to-speech[faster-whisper]"
以下範例把 LLM 指向 Windows 上的 llama.cpp。不同版本的 STT 參數名稱可能調整,正式啟動前先執行 speech-to-speech serve --help 對照目前安裝版本。
speech-to-speech serve \
  --stt faster-whisper \
  --stt_model_name large-v3 \
  --language zh \
  --llm_backend responses-api \
  --tts qwen3 \
  --model_name Qwen3-14B-Instruct-Q4_K_M \
  --responses_api_base_url http://127.0.0.1:8090/v1 \
  --responses_api_api_key "" \
  --responses_api_stream \
  --enable_live_transcription
模型全部下載完成後,可以設定 HF_HUB_OFFLINE=1 驗證斷網狀態。這一步比口頭宣稱本地化更可靠,因為只要還有任一個後端指向雲端,就不算完整離線。
第四步,準備 Qwen3-TTS 與參考聲音
Qwen3-TTS 官方最簡單的安裝方式是獨立建立 Python 3.12 環境。它支援聲音克隆、音色設計與串流輸出。更多模型差異和 ComfyUI 節點用法,可以延伸看 Qwen3-TTS 音色設計整理 。
conda create -n qwen3-tts python=3.12 -y
conda activate qwen3-tts
pip install -U qwen-tts
參考音訊建議控制在 5 到 15 秒,只留單一說話人,沒有音樂與明顯環境聲。參考文字必須和音訊實際內容完全相同,否則容易出現漏字、錯字與音色漂移。情緒也會一起被模仿,所以不要用過度激動的片段當作一般對話基準。
ffmpeg -i ~/setup/ref.wav -ac 1 -ar 16000 -c:a pcm_s16le ~/s2s/ref.wav
ffprobe -v error -show_entries stream=sample_rate,channels,codec_name \
  -show_entries format=duration -of default=nw=1 ~/s2s/ref.wav
只應克隆自己或已取得明確授權的聲音。把真人聲紋放入公開服務前,也要考慮檔案存取權限、提示注入與未授權冒用。
第五步,製作自然的待機人像
人像素材不適合直接使用張嘴、手擋住嘴巴或劇烈轉頭的畫面。先生成嘴唇閉合、正面或微側面的基準圖,再用 Wan2.2 圖生影片做五秒左右的待機動作。提示詞只描述動作,不要重新描述人物外觀,能減少五官漂移。
電影感 16 比 9 構圖,一位成年東亞女性位於畫面右側三分之一,深色安靜房間,左側保留大量空間,螢幕冷光照亮臉部,輪廓帶柔和暖光,嘴唇自然閉合,雙手不遮擋嘴部,自然皮膚紋理,淺景深,真實攝影質感
負面提示詞
張嘴,說話,露齒,正面平光,明亮背景,過高對比,過度曝光,人物置中,多人,手遮擋嘴部,文字,浮水印,塑膠皮膚,過度修圖,卡通,3D 渲染
待機動畫提示詞
人物保持坐姿,只有細微自然呼吸,緩慢眨眼一次,頭部輕微移動後回到原位,嘴唇全程閉合,鏡頭完全鎖定,沒有縮放,沒有切鏡
關閉自動提示詞增強,輸出比例盡量和原圖相同。Wan2.2 常見原生片段是 81 幀、16 FPS,約五秒。若要二十秒待機,不要期待模型一次生成毫無漂移的長鏡頭,可以在自然停頓點循環短片。其他數位人生成思路可參考 LongCat 數位人工作流 。
第六步,安裝 LiveTalking
LiveTalking 官方目前測試的環境是 Ubuntu 24.04、Python 3.12、PyTorch 2.9.1 與 CUDA 12.8。下面命令照官方版本撰寫,但 PyTorch 下載來源仍應配合自己的 CUDA 驅動,不要盲目安裝 cu128。
git clone https://github.com/lipku/LiveTalking.git
cd LiveTalking
conda create -n livetalking python=3.12 -y
conda activate livetalking
pip install torch==2.9.1 torchvision==0.24.1 torchaudio==2.9.1 \
  --index-url https://download.pytorch.org/whl/cu128
pip install -r requirements.txt
下載官方提供的 wav2lip256.pth 後,把它放到 models,並改名成 wav2lip.pth。範例角色資料夾則解壓到 data/avatars。完成後啟動 WebRTC 服務。
python app.py --transport webrtc --model wav2lip \
  --avatar_id wav2lip256_avatar1 \
  --stun 'stun:stun.l.google.com:19302'
瀏覽器開啟 http://localhost:8010/index.html,按下開始連線。正式讓外部裝置使用時,官方提醒需要 TCP 8010 和 WebRTC 使用的 UDP 連接埠。不要直接把整段 UDP 範圍暴露到公網,應優先放在可信任區網、VPN 或經過限制的防火牆環境。
自己製作 Wav2Lip 角色時,可以把短影片轉成 avatar 資料。素材要維持正面可見、光線穩定與嘴部清楚。
python avatars/wav2lip/genavatar.py \
  --video_path data/video/avatar.mp4 \
  --img_size 256 \
  --avatar_id my_avatar
第七步,正確啟動與串接
我會把服務拆成四個終端視窗,照下面順序啟動。每一步都先確認健康狀態,再開下一個服務。
Windows 啟動 llama.cpp,確認 http://127.0.0.1:8090/v1/models 有回應
WSL 啟動 Qwen3-TTS 或 speech-to-speech,先完成單句語音測試
WSL 啟動 LiveTalking,確認 8010 網頁能顯示待機角色
最後啟動橋接程式,把 TTS 產生的音訊送入 LiveTalking 的 /humanaudio
作者提供的一鍵整合包包含自訂腳本與橋接程式,並不是 Hugging Face、Qwen 或 LiveTalking 的官方發行版。下載前應先檢查檔案來源、雜湊值、啟動腳本和網路連線,不要把未知執行檔直接放進主要工作電腦。想要長期維護,我更建議從官方專案建立環境,再自行補一個最小橋接層。
WebSocket failed 怎麼排查
先確認服務真的啟動 。7860、8010 與 8090 是不同服務,瀏覽器頁面存在不代表後端 WebSocket 已連線檢查 WSL 網路 。修改 .wslconfig 後一定要執行 wsl --shutdown,鏡像網路與 hostAddressLoopback 才會重新載入確認 Windows 防火牆 。先只開必要 TCP 埠,在同一台電腦測通後再處理區網不要混用 localhost 。容器、WSL 與 Windows 各自看到的 127.0.0.1 可能不是同一個服務確認瀏覽器麥克風權限 。遠端網頁通常需要 HTTPS 或 localhost 才能取得安全的麥克風權限降低 Noise Gate 。如果網頁已連線但偵測不到聲音,先關閉門檻測試,再逐步調高調整 VAD 停頓 。約 900 到 1200 毫秒比較不容易搶話,但設定越長,回答開始時間也越慢
可以改成真正的 3D 角色嗎
可以,但不是把 Wav2Lip 模型換成一個 3D 檔案就完成。現在這條路線以 2D 影像或待機影片為基礎,口型模型直接修改臉部像素。真正的 3D 角色需要另外加入 Unity、Unreal Engine 或 WebGL renderer,再把 TTS 音訊轉成 viseme、音素或 blendshape 權重,驅動角色的嘴型、表情、眼神與骨架。
保留 VAD、Whisper、Qwen3 與 Qwen3-TTS,替換最後一層即可。新的輸出流程會變成 TTS 音訊、音素時間軸、3D blendshape、即時 renderer。若只是想讓角色有更豐富動作,可以先使用 LiveTalking 的自訂動作設定或多段待機素材,成本會比完整 3D 低很多。
本地不等於沒有風險
角色資料、聲音與對話都留在本機,確實能降低資料送往雲端的風險。但只要把服務開到區網或公網,就要重新考慮驗證、連接埠、惡意音訊、提示注入與檔案上傳。對話記憶也不是安裝完成就會永久存在,長期記憶需要另外接資料庫、摘要或向量檢索,否則聊天變長後仍可能忘記前文或開始胡亂延伸。
LiveTalking 官方也明確要求,使用此專案製作並發布到平台的內容必須包含 LiveTalking 浮水印與標誌。正式商用前要再確認每個模型、角色素材、聲音和整合程式的授權,不要只看程式能不能跑。
官方資源與參考資料
FAQ
8GB 顯存真的可以跑本地 AI 數位人嗎
可以做出可用版本,但不適合讓 14B LLM、large-v3、1.7B TTS 與口型模型全部以高規格同時常駐。建議改用 Qwen3-8B 或 4B 量化版、較小 TTS、較低 batch,必要時把部分模型放到 CPU。
可以完全離線,不使用任何 API 嗎
可以。前提是 STT、LLM、TTS 和數位人全部使用本地後端,而且模型與依賴已下載完成。設定 HF_HUB_OFFLINE=1 並在斷網環境測試,才能確認沒有隱藏的雲端依賴。
可以用英文或其他語言聊天嗎
可以,但 STT、LLM 與 TTS 三層都要支援目標語言。Whisper 與 Qwen3 的多語能力較完整,最終自然度通常由 TTS 音色與參考音訊決定。中英混合時要額外測試專有名詞、數字與語速。
Mac 可以照這篇安裝嗎
不能原封不動照做,因為本文整合路線依賴 Windows、WSL 與 CUDA。llama.cpp、Whisper 和部分 speech-to-speech 元件可以改走 Apple Silicon 的 Metal 或 MLX,但 LiveTalking 口型模型與整合腳本需要另外確認 macOS 支援,不能直接套用 NVIDIA 命令。
最後怎麼選
如果只是想快速聊天,雲端語音助手會更省時間。如果需求是讓私人對話留在本機、建立固定角色、接自己的資料或研究數位人介面,這套模組化管線就很值得做。我的建議是先讓文字對話跑通,再加入 STT 和 TTS,最後才接 LiveTalking。一次啟動所有元件,只會讓錯誤來源變得難以判斷。
真正值得學會的不是某個一鍵包,而是知道聲音在哪裡變成文字,回答在哪裡生成,音色在哪裡被控制,口型又由哪一個服務驅動。把這五層拆清楚後,未來換模型、換角色、換前端,整套系統仍然能繼續使用。
by Rain Chu 8 月 26, 2026 | 未分類
DeepSeek V4 Flash 0731 最值得注意的,不只是模型跑得更快,而是 Agent 能力明顯補強,它可以在 Agent 框架裡撰寫程式、呼叫工具、修正錯誤,完成遊戲、互動網頁與自動化任務,這是一個 284B 總參數的 MoE 大模型,即使每次只啟用 13B 參數,完整權重仍然很大。
模型權重採 MIT 授權,可以免費下載,但本機部署並不便宜,Unsloth 的 3-bit GGUF 約 103GB,建議至少準備 110GB 可用記憶體,接近無損的 Q4 版本約 155GB,較適合 192GB 記憶體工作站或多卡伺服器,一般 16GB、32GB,甚至 64GB 電腦都不適合硬跑完整模型。
DeepSeek V4 Flash 0731 是什麼
DeepSeek V4 Flash 0731 是 V4 Flash 的正式開源版本,官方模型卡表示,新版延續 Flash DSpark 架構,加入 speculative decoding 模組,並針對 Agent 任務完成新的後訓練。模型總參數為 284B,每次推理啟用約 13B 參數,最大上下文為 1,048,576 tokens。
項目 規格 實際意義 總參數 284B 權重檔案很大,不能用 13B 模型的硬體需求估算 啟用參數 13B MoE 每次只啟用部分專家,有助降低運算量 最大上下文 1M tokens 理論上可處理超長任務,但 KV cache 會大量吃記憶體 授權 MIT 可下載、修改與商業使用,仍需遵守授權條款 主要強項 Agent 與工具使用 適合程式開發、工具呼叫與長流程自動化
這裡最容易誤會的是 13B 啟用參數,它代表單次前向運算只會用到部分專家,不代表只需要載入 13B 權重。完整 MoE 權重依然要放進記憶體,所以本機部署需求遠高於一般 13B 模型。
Agent 能力提升多少
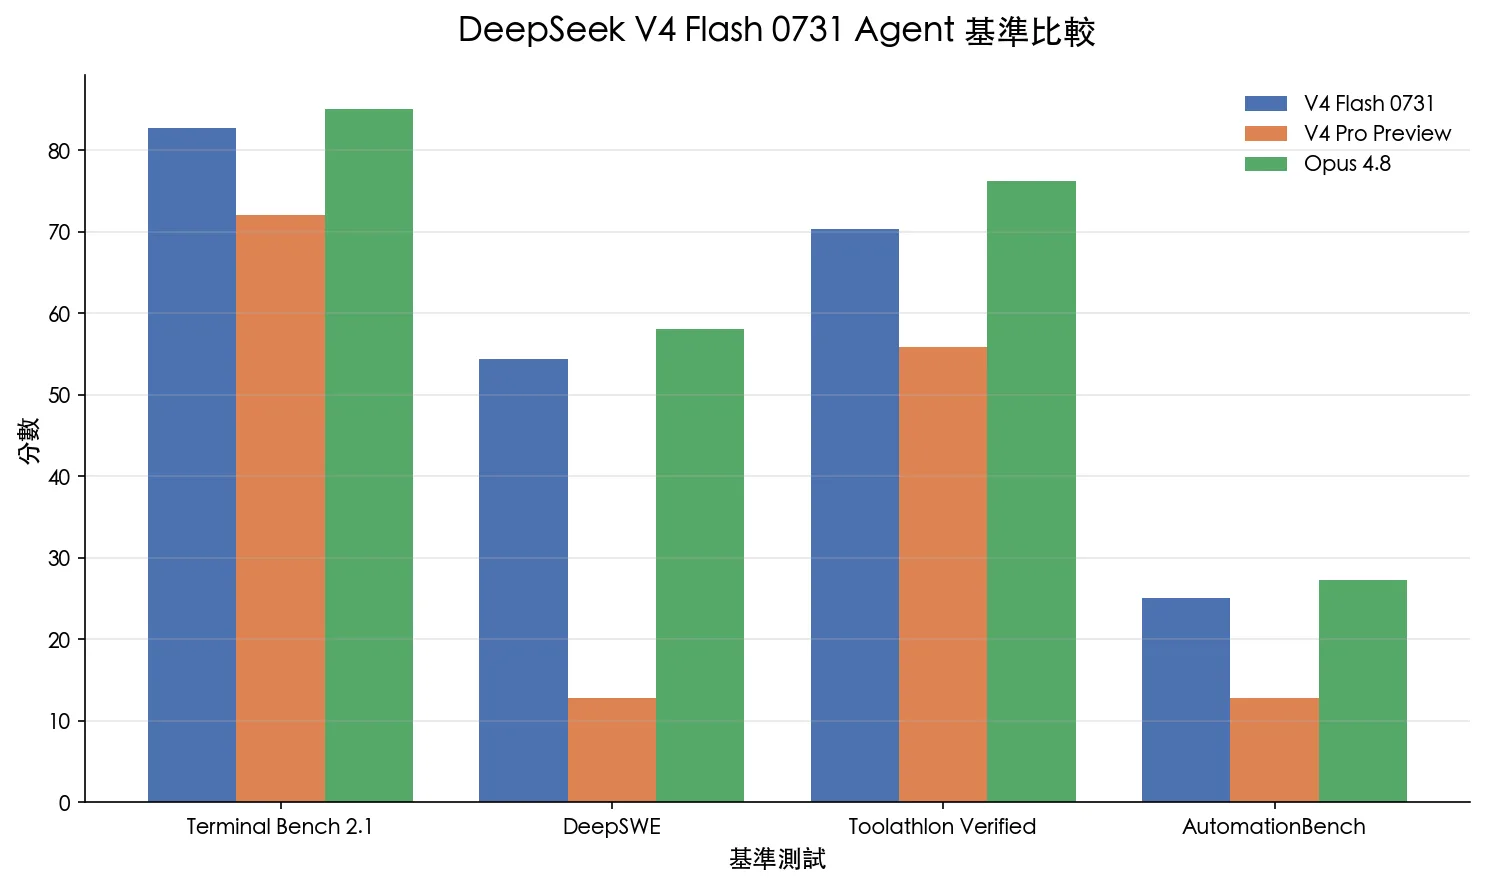
官方模型卡列出的 Agent 評測顯示,0731 版比 V4 Pro Preview 進步很多,Terminal Bench 2.1 從 72.1 提升到 82.7,DeepSWE 從 12.8 提升到 54.4,Toolathlon Verified 從 55.9 提升到 70.3,AutomationBench Public 則從 12.8 提升到 25.1。
DeepSeek V4 Flash 0731 的 Agent 評測大幅領先 Preview,但多數項目仍略低於 Opus 4.8。資料來自官方模型卡。 評測 V4 Flash 0731 V4 Pro Preview Opus 4.8 Terminal Bench 2.1 82.7 72.1 85.0 DeepSWE 54.4 12.8 58.0 Toolathlon Verified 70.3 55.9 76.2 AutomationBench Public 25.1 12.8 27.2
這些分數不能直接等同於所有人的使用體驗,但是各大 AI 網紅們都給予極高的肯定,官方的程式 Agent 評測使用 DeepSeek Harness minimal mode,搭配 max reasoning、temperature 1.0 與 top_p 0.95。部分 DSBench 項目也是內部資料集,模型、Agent 框架、提示詞、工具權限和驗證流程都會影響最後結果。
為什麼能做出 2D、3D 遊戲和太陽系
實際展示涵蓋 2D 平台遊戲、3D 闖關遊戲、太陽系模擬、圖片生成與影片生成流程。這些結果證明它很適合放進 Hermes Agent 一類的工具框架,但不能解讀成模型本身具備完整視覺能力。
DeepSeek V4 Flash 0731 的核心仍是文字模型,它會產生 HTML、JavaScript、Three.js 或其他程式碼,再由 Agent 啟動瀏覽器、執行程式與呼叫外部圖片工具,若 Agent 沒有截圖回饋或視覺模型協助,它無法像多模態模型一樣直接看見成果,前端展示看起來很完整,功勞來自模型能力與 Agent 工具鏈的組合。
要評估這類展示,我會看三件事
第一是第一次產出的可用程度.
第二是 Agent 能否自行執行並找出錯誤。
第三是移除人工協助後能否重複成功。
免費到底指什麼
「免費」至少有三種不同意思,最好分開看。
開源權重免費 :模型採 MIT 授權,可以從 Hugging Face 下載。網頁聊天免費 :官方網站可能提供免費額度,但服務規則可能調整。API 免費活動 :公測或限時額度不代表永久免費,串接正式服務前應重新查價。
截至 2026 年 8 月 1 日,DeepSeek 官方 API 文件已列出 deepseek-v4-flash 的計費資訊,每百萬 input tokens 在 cache hit 時為 0.0028 美元,cache miss 為 0.14 美元,output 為 0.28 美元。價格與活動可能隨時改變,上線前應以官方定價頁 為準。
本機執行雖然沒有按 token 付 API 費用,卻要負擔記憶體、GPU、儲存空間、電力與維護成本。對偶爾使用的人來說,API 可能反而比較便宜。對需要大量批次處理、資料不能離開內網,或想研究 Agent 框架的人,本機部署才更有價值。
Q4 為什麼還要約 155GB
DeepSeek V4 Flash 0731 在訓練時已採用量化感知訓練,約 96% 的 routed experts 原生使用 MXFP4,其餘權重使用 FP8 或 BF16,Q4 並不是把一個完整 BF16 模型全部壓成四分之一,而是保留原本已經是 4-bit 的專家,再量化其他張量。
這也解釋了為什麼 Unsloth 的 UD-Q4_K_XL 仍約 155.1GB,和官方參考權重 156.4GB 很接近,它的重點不是極端縮小檔案,而是在維持原生 MXFP4 專家的前提下,降低非專家張量的空間。UD-Q8_K_XL 約 161.9GB,Unsloth 將它定位為接近位元層級重建的無損版本。
量化版本 約略大小 建議記憶體 適合情境 1-bit 約 92GB 至少 96GB 以能跑為優先,品質犧牲較大 2-bit 約 102GB 至少 110GB 記憶體緊張的測試用途 UD-IQ3_XXS 約 103GB 110GB 到 128GB 128GB 裝置的實用起點 UD-Q4_K_XL 約 155GB 建議 192GB 接近無損品質 UD-Q8_K_XL 約 162GB 建議 192GB 以上 重視精度與重現性
表格只算模型權重仍不夠,作業系統、llama.cpp、KV cache 與長上下文都需要額外空間,128GB 機器即使用 103GB 版本,也不應一開始就把 context 設成 1M,先從 32K 或更低開始,確認速度與記憶體餘裕,再逐步增加。
量化概念也可以參考我整理的 MXFP8、NVFP4 與不同量化格式比較 ,不要只看檔名裡的 Q4,還要看原始權重格式和哪些張量被量化。
用 Unsloth Studio 安裝
想用圖形介面管理模型,可以先裝 Unsloth Studio,macOS、Linux 與 WSL 使用下面的命令。
curl -fsSL https://unsloth.ai/install.sh | shWindows PowerShell 使用下面的命令。
irm https://unsloth.ai/install.ps1 | iex安裝完成後啟動服務。
unsloth studio -H 0.0.0.0 -p 8888如果只在本機使用,建議不要對外開放 8888 連接埠。需要從區域網路操作時,應搭配防火牆、反向代理與登入驗證。
用 llama.cpp 下載與執行 GGUF
Unsloth 官方文件提供 Hugging Face 直接載入方式。以下先以 UD-IQ3_S 為例。記憶體更緊張時,可在模型頁改選 UD-IQ3_XXS。
export LLAMA_CACHE="unsloth/DeepSeek-V4-Flash-0731-GGUF"

./llama.cpp/llama-cli \
  -hf unsloth/DeepSeek-V4-Flash-0731-GGUF:UD-IQ3_S \
  --ctx-size 32768 \
  --temp 1.0 \
  --top-p 1.0 \
  --min-p 0.0
若要先完整下載指定分片,可以使用 Hugging Face CLI。
hf download unsloth/DeepSeek-V4-Flash-0731-GGUF \
  --local-dir unsloth/DeepSeek-V4-Flash-0731-GGUF \
  --include "*UD-IQ3_S*"
大型 GGUF 往往分成多個檔案,下載前先確認磁碟空間與網路穩定度。不同作業系統、CPU、GPU offload 比例與記憶體頻寬都會影響速度,想比較其他引擎,可以看 vLLM、SGLang、llama.cpp、MLX 與 Ollama 推理框架比較 ,若使用 DGX Spark,也可參考 DGX Spark 搭配 GGUF 與 llama.cpp 的實作方式 。
推理參數怎麼設
官方與 Unsloth 建議 temperature 1.0。一般對話可用 top_p 1.0,Agent 任務則可改成 top_p 0.95。Think High 是預設的深度推理模式。Think Max 需要更大的輸出與上下文空間,官方建議至少預留 384K,並不適合記憶體剛好壓線的本機環境。
一般對話:temperature 1.0,top_p 1.0
Agent 任務:temperature 1.0,top_p 0.95
本機初次測試:context 從 16K 或 32K 開始
長任務:先監看記憶體與輸出速度,再增加 context
本機執行與隱私安全
把開源權重放在自己的機器上,可以降低提示詞和文件傳送到第三方服務的需求,但不代表自動安全,仍要確認模型來源、雜湊值、推理程式、下載腳本與網路連線,處理公司資料時,也要記錄哪些 Agent 工具有檔案、終端和瀏覽器權限。
Agent 會執行模型產生的程式碼,風險比單純聊天高,建議使用容器、虛擬機或權限受限的工作目錄,並在刪除檔案、安裝套件、登入網站、發送資料與付費操作前要求人工確認,模型能完成任務,不代表每個操作都值得信任。
若你希望在本機開發工具裡使用模型,可以延伸閱讀 Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境 ,再依自己的硬體改用 llama.cpp 或相容 API。
誰適合部署
DeepSeek V4 Flash 0731 適合擁有 128GB 以上統一記憶體工作站、多卡伺服器、DGX Spark 類設備,並且真的需要 Agent、自動化或大量私有資料處理的人,它也適合研究 MoE、推測解碼和量化感知訓練。
如果只是想體驗模型能力,先用官方網頁或 API 更合理。16GB 到 64GB 電腦不必為了完整模型勉強選極低位元量化,你會付出很長的載入時間、很慢的生成速度和明顯品質損失,最後還不一定比雲端便宜。
我的判斷
DeepSeek V4 Flash 0731 真正的進步,是從擅長回答問題,往可以在工具環境中完成工作的方向前進,Agent 評測已經逼近高階閉源模型,開源權重也讓企業有機會把資料和推理留在自己的環境。
它仍不是一般消費級電腦的輕量模型,284B 總參數決定了權重與記憶體成本,13B 啟用參數無法改變這件事,對多數人最務實的路線,是先用 API 驗證工作流,只有在使用量、隱私或客製化需求足夠明確時,再投資 128GB 到 192GB 的本機部署環境。
參考資料
FAQ
DeepSeek V4 Flash 0731 可以在 64GB 電腦執行嗎?
不建議。Unsloth 最小的實用量化仍接近 92GB,3-bit 推薦版本約 103GB,還要保留 KV cache 與系統空間。較合理的起點是 110GB 可用記憶體,128GB 裝置會比較實際。
為什麼只有 13B 啟用參數,權重卻超過 100GB?
13B 是每次推理被路由啟用的參數量。模型共有 284B 參數,完整專家權重仍要載入記憶體,因此硬體需求不能用一般 13B 模型估算。
DeepSeek V4 Flash 0731 是多模態模型嗎?
它主要是文字與程式模型。遊戲和視覺成果通常由 Agent 執行程式碼或呼叫外部工具產生。若要讓 Agent 看見並判斷畫面,還需要瀏覽器截圖回饋或另外接入視覺模型。
DeepSeek V4 Flash 0731 完全免費嗎?
模型權重採 MIT 授權,可免費下載。官方網頁可能有免費額度,API 則應依當下定價。自行部署還有硬體、電力、儲存與維護成本。
by Rain Chu 8 月 19, 2026 | AI , GGUF , QWEN , 模型
Qwen3.8-27B 把文字、圖片、影片、程式設計與 Agent 工作流放進同一個稠密模型,對想把 AI 留在本機的人來說,這是一個能力和硬體成本相對平衡的新選擇。
16GB 顯卡不要直接選 Q4_K_M,因為 15.9 GiB 只是主模型檔案,還沒有算約 0.86 GiB 的視覺投影模型、KV Cache 與執行環境。比較實際的選擇是 Q3_K_M 或 UD-Q3_K_XL,再從 8K 上下文開始測試。8GB 顯卡雖然可以用極低位元量化搭配系統記憶體卸載,但不等於 27B 多模態模型能完整放進 8GB 顯示記憶體。
Qwen3.8-27B 是什麼
Qwen3.8-27B 官方模型 採用 Apache 2.0 授權,是一個 27B 參數的稠密視覺語言模型,它不是只會聊天的純文字模型,而是原生理解圖片與影片,也把程式設計、專業工作、研究和長時間 Agent 任務列為主要能力。
27B 稠密模型,64 層,Hidden Dimension 為 5120
原生支援圖片與影片理解
原生上下文長度 262,144 tokens,可透過 YaRN 延伸到 1,000,000 tokens
支援思考與非思考模式,也能用 reasoning_effort 調整推理深度
訓練時加入多步 MTP,執行環境支援時可用於推測解碼
如果你正在比較本地模型,建議先看站內的Qwen 3.6 的 27B、35B、MXFP8 與 NVFP4 比較 ,Qwen3.8-27B 延續 27B 稠密模型的定位,但多模態、Agent 執行和思考控制都更完整。
MTP 和 noMTP 差在哪裡
MTP 是 Multi-Token Prediction,一般自迴歸模型每次產生一個 token,MTP 會另外預測後續多個候選 token,再由主模型驗證,推理框架支援推測解碼時,可以減少逐 token 等待的成本,提升生成速度。
Qwen3.8-27B 的官方架構包含 MTP,Unsloth 的 Qwen3.8 指南 也提供 MTP 量化版本,noMTP 通常是社群為了相容性或降低額外負擔而移除 MTP 預測頭的版本,你的 llama.cpp 太舊、載入失敗,或記憶體非常緊時,可以把 noMTP 當作相容性選項。新版推理環境能正常使用 MTP 時,則優先保留。
16GB 顯卡該下載哪一個 GGUF
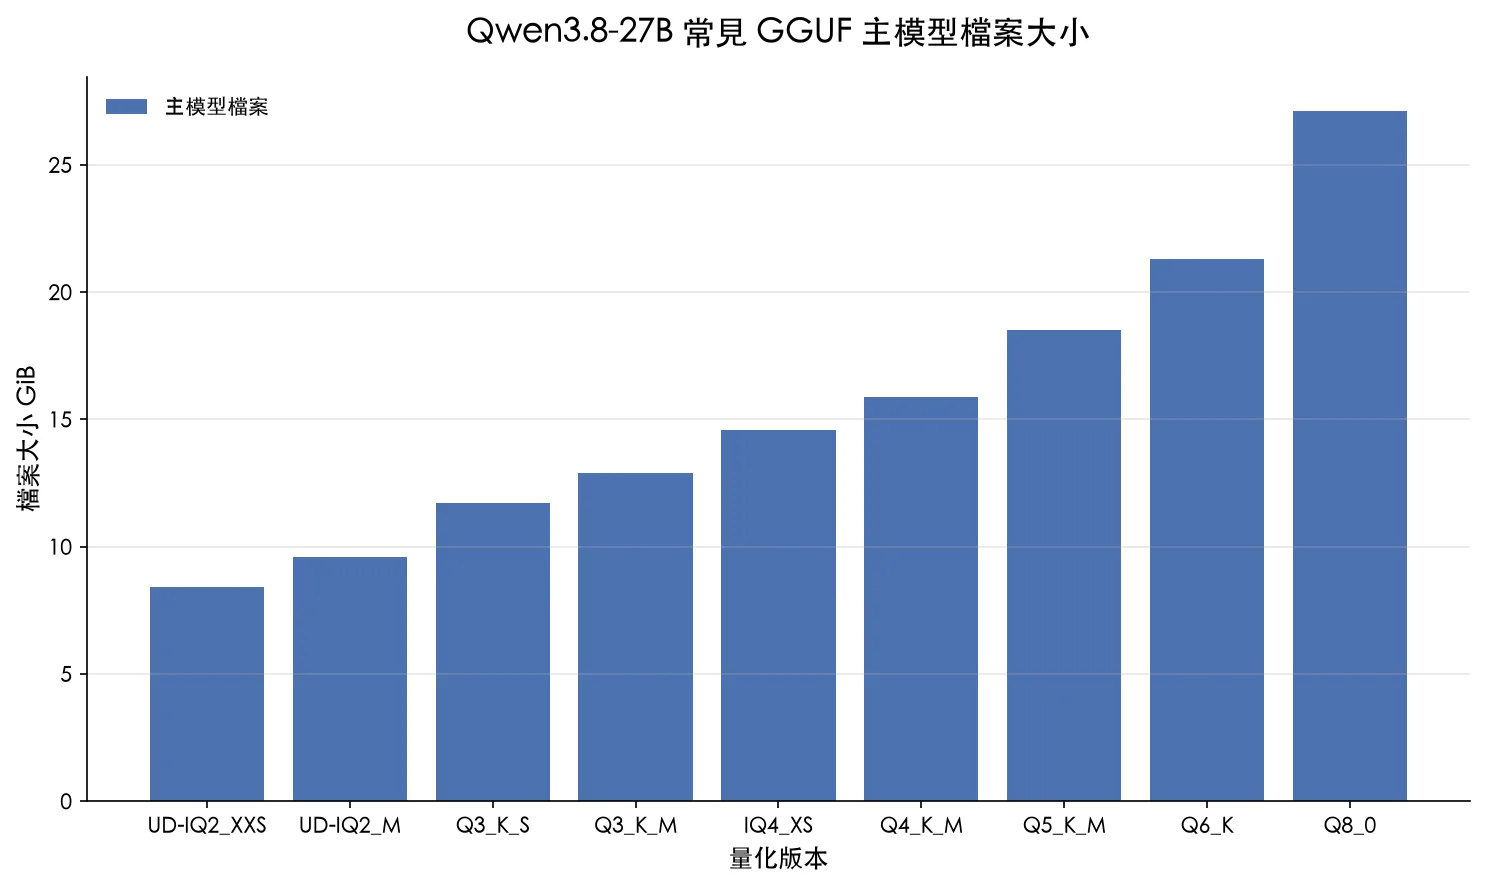
可用記憶體 建議量化 主模型大小 實際建議 8GB UD-IQ2_XXS 約 8.4 GiB 仍需系統記憶體卸載,不建議當作完整多模態體驗 12GB UD-IQ2_M 或 Q3_K_S 約 9.6 到 11.7 GiB 使用短上下文,接受較明顯的量化損失 16GB Q3_K_M 或 UD-Q3_K_XL 約 12.9 或 12.5 GiB 最實際的平衡,先用 8K 上下文 24GB Q4_K_M 或 Q5_K_M 約 15.9 或 18.5 GiB 能保留較好的品質,也有空間給視覺與 KV Cache 32GB Q6_K 或 Q8_0 約 21.3 或 27.1 GiB 適合重視品質與較長上下文的使用者
檔案大小依 Unsloth Hugging Face 儲存庫計算,實際記憶體還要加上視覺投影模型、KV Cache 與執行環境 主模型從 8.4 GiB 的 2-bit 到 27.1 GiB 的 Q8_0,數字不包含額外執行記憶體 Q4_K_M 的檔案約 15.9 GiB,看起來很接近 16GB,但視覺功能還需要 mmproj-F16.gguf,檔案約 0.86 GiB,再加上 KV Cache 後,16GB 顯卡通常沒有足夠餘裕。若只跑文字、上下文很短,而且願意部分卸載到系統記憶體,IQ4_XS 可能可以啟動,但這不是我會給一般使用者的預設建議。
量化位元越低,檔案越小,但指令遵循、長文本穩定性、程式正確率和視覺判斷都可能下降。16GB 使用者如果重視穩定性,有時候選較小參數模型的 4-bit 或 8-bit,會比硬塞 27B 的 2-bit 更實用。
用 llama.cpp 在本機啟動
個人電腦要跑 GGUF,llama.cpp 仍然是很直接的底座。Windows 使用者可以從 llama.cpp Releases 下載對應版本,NVIDIA 顯卡選 CUDA,AMD 顯卡可用 Vulkan,沒有獨立顯卡則選 CPU 版本,框架定位和差異可以延伸閱讀vLLM、SGLang、llama.cpp、MLX 與 Ollama 比較 。
一 下載主模型與視覺投影模型
pip install -U "huggingface_hub[cli]"

hf download unsloth/Qwen3.8-27B-GGUF \
  Qwen3.8-27B-Q3_K_M.gguf \
  mmproj-F16.gguf \
  --local-dir Qwen3.8-27B-GGUF
24GB 顯卡可以把 Q3_K_M 換成 Q4_K_M。只處理文字時可以先不載入 mmproj,等基本對話穩定後再加入視覺功能。
二 啟動 OpenAI 相容端點
llama-server \
  --model Qwen3.8-27B-GGUF/Qwen3.8-27B-Q3_K_M.gguf \
  --mmproj Qwen3.8-27B-GGUF/mmproj-F16.gguf \
  --host 127.0.0.1 \
  --port 8080 \
  --ctx-size 8192 \
  --n-gpu-layers 99 \
  --jinja \
  --chat-template-kwargs '{"reasoning_effort":"medium"}'
Windows 請把執行檔改成 llama-server.exe。若出現記憶體不足,先把上下文從 8192 降到 4096,再考慮換更小的量化。不要一開始就把 262K 全開,長上下文的 KV Cache 會快速增加記憶體需求。
三 測試 API
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen3.8-27B","messages":[{"role":"user","content":"請用繁體中文列出三個本地部署注意事項"}]}'
能收到 JSON 回應,就代表本地端點已經可以交給其他工具使用,想把開發環境完全留在本機,也可以參考Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境 。
接到 Hermes Agent
llama-server 啟動後,可以在 Hermes Agent 的模型提供方加入本地自訂端點,Base URL 填入 http://127.0.0.1:8080/v1,如果介面要求 API Key,可以填一個只供本機識別的非空字串,模型清單出現 Qwen3.8-27B 後,就能把它用在網站製作、檔案處理、程式生成與瀏覽器檢查等 Agent 任務。
本地模型接 Agent 的價值在於資料不用先送到外部 API,也能降低大量反覆呼叫的成本。不過模型一旦拿到終端機、瀏覽器和檔案權限,風險也會跟著放大。Hermes 的代理層與 LINE 整合可以延伸閱讀Hermes Proxy 與 Hermes Agent 支援 LINE 。
程式、視覺與 Agent 能力怎麼看
一個單檔 HTML 飛行遊戲可以同時產生畫面、操作、儀表與聲音,代表 27B 模型已經能完成有一定複雜度的前端原型,圖片計數測試也能辨識出 25 根筷子,並區分 6 根彩色與 19 根銀色,接到 Agent 後,還能建立帶搜尋、排序與模型卡片的網站,再開啟瀏覽器檢查介面。
這些結果適合當作能力檢查,不適合直接當成通用 benchmark,單一提示、單一圖片與單一硬體都可能讓結果偏高或偏低。真正要採用前,應該用自己的程式庫、文件、圖片和 Agent 權限做一組固定測試,記錄成功率、速度與記憶體峰值。
無審查版本不是官方安全模式
所謂無審查或 Uncensored 版本通常是社群修改、微調或去除拒答傾向的衍生模型,不是 Qwen 官方提供的安全開關,它比較少拒絕,不代表答案更正確,也不代表可以放心交給有系統權限的 Agent。
先在沒有正式帳密與重要檔案的環境測試
工具採用允許清單,不要直接給完整終端機與管理員權限
寫檔、執行命令、付款與對外發布都要保留人工確認
本地 API 預設只綁定 127.0.0.1,不要直接暴露到網際網路
保存工具呼叫紀錄,發生異常時能回溯
如果用途只是寫作或私人角色扮演,可以把衍生模型放在沒有工具權限的聊天環境。需要操作檔案、瀏覽器或伺服器時,優先使用官方模型並限制權限,通常會更穩妥。
我的選擇建議
16GB 顯卡從 Q3_K_M、8K 上下文和官方版本開始。24GB 顯卡可選 Q4_K_M,並保留足夠空間給 mmproj 與 KV Cache。50 系列 Blackwell 顯卡如果要做正式服務,可以研究 NVFP4 與 vLLM。一般個人使用者則先用 GGUF 和 llama.cpp,把模型穩定跑起來,再決定是否需要 Hermes Agent、長上下文或 MTP。
Qwen3.8-27B 的重點不是單純追求更大模型,而是把多模態、程式能力和 Agent 執行放進個人可負擔的硬體範圍。選對量化、控制上下文、限制工具權限,才是本地部署真正能長期使用的關鍵。
FAQ
MTP 一定比較快嗎
只有推理框架正確支援推測解碼時才會發揮效果。框架版本、硬體與批次大小都會影響實際速度,不能只看檔名判斷。
可以用 Ollama 或 LM Studio 嗎
可以,只要版本已支援 Qwen3.8 架構與對應 GGUF。想控制 MTP、mmproj、KV Cache 與細部參數時,llama.cpp 通常更透明。
本地模型接 Hermes Agent 安全嗎
模型資料可以留在本機,但工具權限仍然需要管理。使用 127.0.0.1、工具允許清單、人工確認與執行紀錄,可以大幅降低風險。
參考資料
by Rain Chu 7 月 11, 2026 | 未分類
本地部署大模型到了 2026 年,問題已經不只是「模型要選哪一個」。同一張顯卡、同一台 Mac、同一個模型,只要推理框架選錯,吞吐量、延遲、顯存使用率和維運成本都會差很多。
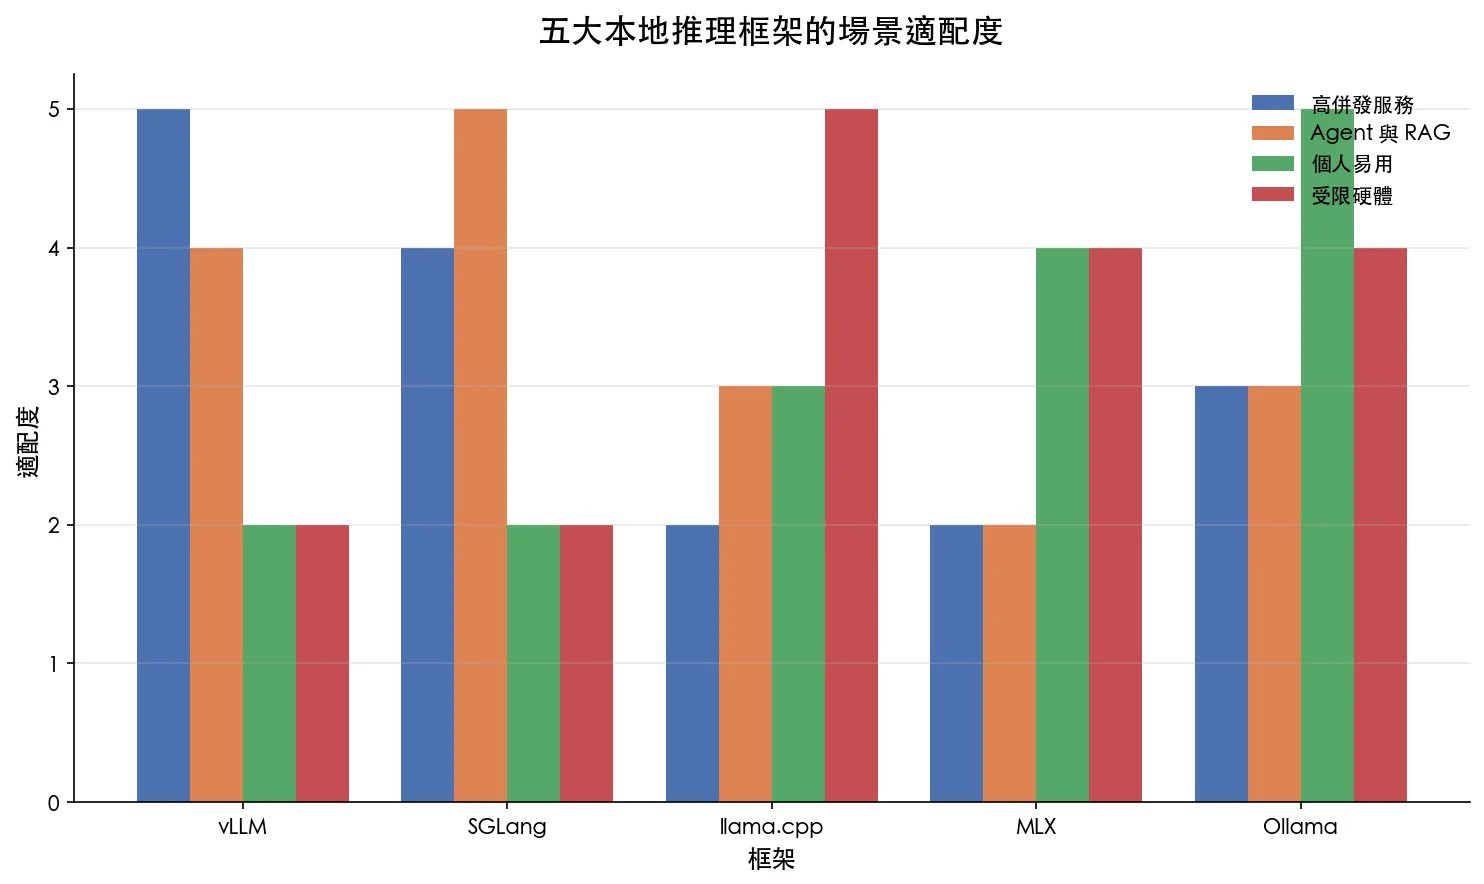
這也是為什麼 vLLM、SGLang、llama.cpp、MLX、Ollama 這五個工具會被放在一起比較。它們不是同一類產品的不同包裝,而是對應不同部署場景的五種答案。選對框架,比盲目追更大參數更實際。
先講結論
如果你要做高併發 API 服務,先看 vLLM。如果你在做 AI Agent、RAG、多輪工具呼叫,SGLang 很值得研究。如果你要跨平台、邊緣設備、低資源環境,llama.cpp 仍然是最靈活的選擇,如果你主要用 Apple Silicon,MLX 是最貼近硬體的路線。如果你只是想快速讓團隊或個人跑起來,Ollama 依然是最省心的入口。
五個框架的定位差異
框架 核心強項 適合場景 不適合情況 vLLM PagedAttention、Continuous Batching、高吞吐 生產 API、多使用者併發、GPU 服務 個人桌機快速試模型 SGLang RadixAttention、KV Cache 重用、結構化輸出 Agent、RAG、多輪對話、JSON 輸出 只想一鍵跑模型 llama.cpp GGUF、生態成熟、跨平台 CPU、邊緣設備、Mac、Windows、Linux、嵌入式 大規模高併發服務 MLX Apple Silicon 統一記憶體最佳化 M 系列 Mac、本地研究、Mac 開發者 NVIDIA GPU 伺服器 Ollama 安裝簡單、模型管理方便、API 友善 個人使用、團隊內部工具、快速 Demo 需要極致吞吐與深度客製
vLLM:高併發服務優先
vLLM 的代表性技術是 PagedAttention,可以把它理解成用作業系統管理記憶體的思路來管理 KV Cache,讓不同長度的請求不會浪費大量顯存,再加上 Continuous Batching,當某個請求完成後,新請求可以馬上進入批次,不必等整批全部結束。
所以 vLLM 最適合放在需要吞吐量的地方,例如公司內部模型 API、客服系統、多人同時使用的知識庫、需要穩定服務層的產品,你如果正在評估顯卡工作站,也可以對照我之前整理的 RTX PRO 6000 Blackwell 選購分析 ,因為推理框架和硬體規格要一起看才有意義。
SGLang:Agent 和 RAG 的效率選擇
SGLang 的重點不只是跑得快,而是能把複雜互動流程裡重複的上下文計算省下來,它的 RadixAttention 對多輪對話、RAG、知識庫查詢、Agent 工具呼叫很有價值,因為這些場景常常有大量共用前綴和重複上下文。
如果你的應用是「使用者問一句,模型答一句」,SGLang 的優勢不一定完全發揮。但如果你要處理多步驟推理、固定系統提示、文件檢索、JSON 格式化輸出,它會比一般推理框架更貼近 Agent 工程需求。
llama.cpp:跨平台與低資源環境的底座
llama.cpp 最大的價值是能跑在很多地方,從 Mac、Windows、Linux,到 CPU-only、小型邊緣設備、GGUF 量化模型,它提供的是一種很穩的本地推理底座,你不一定拿它做高併發生產 API,但它很適合實驗、嵌入式、離線環境、低成本部署。
如果你關心本地離線模型,之前整理過 gpt-oss 本地離線運行 ,那篇的思路也可以放到 llama.cpp 生態來看。
MLX:Apple Silicon 使用者要特別看
MLX 是 Apple Silicon 上很有意思的選擇。M 系列晶片的統一記憶體架構,讓 CPU、GPU 可以更有效率地共享資料,MLX 的價值就在於它不是把 Mac 當成一般電腦硬跑,而是更貼近 Apple 自家的硬體特性。
如果你手上是 Mac Studio、MacBook Pro 或其他 M 系列設備,MLX 適合拿來做本地研究、模型微調實驗、小型推理服務。它不是 NVIDIA 伺服器的替代品,但在 Mac 生態裡,這條路線會越來越重要。
Ollama:最容易讓人開始用
Ollama 的優勢不是極致效能,而是降低使用門檻。安裝、拉模型、切模型、提供本地 API,整個體驗很適合個人、教學、內部工具和快速 Demo。對很多團隊來說,先用 Ollama 把流程跑通,比一開始就追求 vLLM 的生產級架構更務實。
如果你要把 Ollama 放到內網或 AI Server 上,可以看 Ollama 遠端連線教學 。如果你想把開發環境成本壓低,也可以參考 LM Studio 與 Ollama 的零 API 成本開發環境 。
不要只選一個,混合部署更實際
真正成熟的部署,不一定是一個框架包打天下。比較實際的做法是分層:個人和內部 Demo 用 Ollama,Mac 研究環境用 MLX,跨平台和邊緣設備用 llama.cpp,RAG 和 Agent 後端看 SGLang,高併發正式服務再交給 vLLM。
如果你的硬體是 DGX Spark 或其他 AI Server,也可以把 DGX Spark GB10 Ollama 最佳設定 當作入口,再逐步把高併發服務拆到更專業的推理框架。
我的選型建議
個人開發者:先用 Ollama,真的需要跨平台或量化控制,再補 llama.cpp。
Mac 使用者:Ollama 做入口,MLX 做進階研究和 Apple Silicon 最佳化。
企業內部知識庫:先確認 RAG 架構和上下文重用需求,再評估 SGLang。
正式 API 服務:vLLM 是第一優先,特別是多使用者併發和 GPU 成本敏感時。
邊緣設備或離線場景:llama.cpp 的彈性仍然很難取代。
2026 年的本地 AI 部署,重點會從「能不能跑」走向「跑得是否有效率」。模型能力很重要,但推理框架決定了你花出去的硬體成本能不能真正轉成服務能力。選型時不要只看 benchmark,要看你的流量模式、硬體環境、維運能力和未來要不要接 Agent 工作流。
FAQ
本地大模型推理框架要先學哪一個?
一般使用者先學 Ollama,工程師再補 llama.cpp。需要生產服務時,再研究 vLLM 或 SGLang。
vLLM 和 SGLang 差在哪裡?
vLLM 強在高併發吞吐和生產服務,SGLang 更適合多輪對話、RAG、Agent 和重複上下文很多的流程。
Mac 使用者該選 MLX 還是 Ollama?
想快速跑模型先用 Ollama,想深入 Apple Silicon 最佳化和研究實驗,再看 MLX。
llama.cpp 還值得學嗎?
值得。它在 GGUF、量化、跨平台、CPU 和邊緣設備上仍然非常重要,是本地模型生態的底層工具之一。
by Rain Chu 7 月 8, 2026 | Agent , AI , 語音合成 , 語音辨識
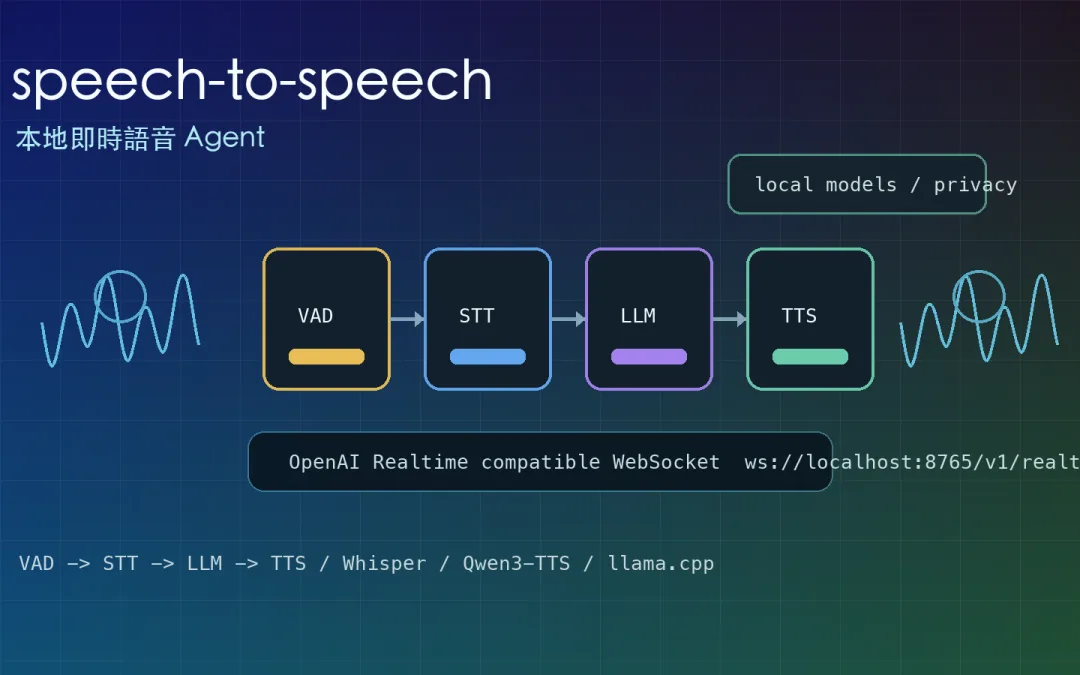
Hugging Face 的 speech-to-speech 真正有趣的地方,不只是「本地 AI 語音聊天」這句話,而是它把即時語音 Agent 拆成一條清楚的工程管線:VAD 偵測你什麼時候開始和結束說話,STT 把語音轉成文字,LLM 產生回應,TTS 再把文字變回聲音。
這條路線的價值很直覺:如果你不想把麥克風聲音、私人對話、公司資料一路送到雲端,那就把語音 Agent 搬回自己的機器。代價也很明顯:你要處理 Python、FFmpeg、CUDA、模型下載、本地 LLM server、TTS 後端、瀏覽器端 WebSocket。這不是「安裝一個 App 就結束」的工具。
如果你之前看過 VoxelCPM 本地 TTS ,這篇可以當成下一步:TTS 只是讓 AI 開口,speech-to-speech 則是把「聽、想、說」接成一個即時循環。
先講結論:它不是語音模型,而是一條可替換的語音 Agent 管線
huggingface/speech-to-speech 的 README 把架構講得很清楚:這是一條低延遲、模組化的 voice-agent pipeline,順序是 VAD → STT → LLM → TTS,並且透過 OpenAI Realtime-compatible WebSocket API 對外提供服務。
也就是說,你可以把支援 OpenAI Realtime 協議的 client 指到本機 server。
這個設計比單純做一個 demo 更有意思,因為每一段都能換。
STT 可以用 Parakeet、Whisper、Faster Whisper、MLX Whisper 或 Paraformer;LLM 可以接 OpenAI-compatible provider,也可以接 vLLM、llama.cpp、llama-server;TTS 可以用 Qwen3-TTS、Kokoro、Pocket TTS、ChatTTS 或 MMS TTS。
換句話說,它的重點不是某個模型最強,而是把語音 Agent 做成可插拔架構。
這和 OpenWork / OpenCode 工作台 的方向有點像:真正可長期使用的 AI 工具,不應該只綁死在單一供應商或單一模型。
Speech-to-speech 和傳統語音翻譯有什麼差別?
Hugging Face Audio Course 裡對 speech-to-speech translation 的說明很適合拿來釐清概念。
傳統機器翻譯是文字到文字,speech-to-speech 則是語音到語音。最常見的做法是串接:先把語音轉成文字,再做翻譯或生成,最後合成語音。
它也提醒一個很重要的問題:管線越長,錯誤越會累積,延遲也越高。
ASR 認錯一個字,後面的 LLM 可能照著錯字理解;LLM 回答太長,TTS 就要等更久;TTS 聲音不自然,最後體驗還是會掉下來。
所以本地即時語音 Agent 的關鍵不是只看「能不能講話」,而是看四件事:
語音辨識是不是準,尤其是中文、口音、背景噪音。
LLM 回應是不是夠快,不要讓人等到出戲。
TTS 聲音是不是自然,長時間聽會不會疲勞。
整條管線的延遲是不是穩定,而不是偶爾順、偶爾卡。
官方預設路線:先跑起 realtime server
官方 quickstart 很短:
pip install speech-to-speech
export OPENAI_API_KEY=...
speech-to-speech ws://localhost:8765/v1/realtime
預設路線會用本地 STT、本地 TTS,再把 LLM 接到 OpenAI-compatible API。你如果想讓 LLM 也留在本機,可以用 llama.cpp 啟動本地模型 server,再把 `responses_api_base_url` 指到本機。
speech-to-speech \
  --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
  --responses_api_base_url "http://127.0.0.1:8080/v1" \
--responses_api_api_key "" Ollama 遠端連線 和本地 OpenAI-compatible server 的設定很重要:語音只是入口,真正回答問題的是後面的 LLM。Windows 實作路線:不是難,是零件很多
核心流程可以簡化成這樣:
裝 Python 3.11、Git、FFmpeg。
建立 `C:\s2s` 之類的資料夾,開 venv。
安裝 `speech-to-speech`。
用 llama.cpp 跑本地 Qwen 模型,開在 `http://127.0.0.1:8080/v1`。
啟動 speech-to-speech,把 STT 指到 Whisper、LLM 指到本地 server、TTS 指到 Qwen3-TTS。
開網頁 client,WebSocket 指到 `localhost:8765`。
這裡最容易踩坑的是 FFmpeg 和 winget。留言裡有人遇到 `winget` 找不到,這通常代表 Windows App Installer / winget 沒裝好,或 PowerShell 環境找不到它。這時候不要卡在同一條命令,可以改成手動下載 FFmpeg,或先修好 winget,再重新開 PowerShell。
架構表:每一段都可以替換,但每一段也都會出事
階段 作用 常見選擇 容易卡住的地方 VAD 判斷使用者何時開始/停止說話 Silero VAD 背景噪音、切句太早或太晚 STT 語音轉文字 Parakeet、Whisper、Faster Whisper 中文辨識、口音、GPU/CPU 速度 LLM 理解問題並產生回應 OpenAI-compatible API、llama.cpp、vLLM、Ollama 類服務 延遲、上下文長度、模型能力 TTS 文字轉語音 Qwen3-TTS、Kokoro、Pocket TTS、ChatTTS 聲音自然度、CUDA wheel、中文品質 Client 麥克風輸入與播放 Realtime WebSocket client、網頁呼吸球介面 瀏覽器權限、WebSocket 位置、服務啟動順序
這張表就是我對本地語音 Agent 的看法:模組化很香,但你不能只看成功 demo 任一段延遲太高、模型太大、依賴裝錯、WebSocket 指錯,都會讓整體體驗掉下來。
4GB 顯存、4090、CPU:期待值要分開看
如果你只是想體驗,本地小模型加 CPU/GPU 混跑可以試;如果你想每天使用,就要認真看顯卡、VRAM、記憶體、模型大小與量化格式。這部分可以搭配 AI 工作站顯卡選購 那篇看,因為語音 Agent 不是只吃一個模型,而是一整條 pipeline。
本地部署值不值得?
安裝太複雜、Python 依賴一直重裝、免費雲端語音也能用、中文場景不一定比微信等現成工具舒服。
我會這樣判斷:
如果你只想偶爾語音聊天 ,雲端 App 更省事。如果你在意隱私、離線、可控模型 ,本地 speech-to-speech 才有意義。如果你要接自己的 Agent 或自動化流程 ,OpenAI Realtime 相容 API 很有價值。如果你不想處理依賴 ,等整合包或 Docker / 一鍵腳本會比較舒服。
有留言建議做整合包,把 Python、虛擬環境、依賴、模型檔都打包好。這個方向很務實。語音 Agent 要走向一般使用者,最重要的可能不是模型再強一點,而是安裝流程少掉一半。
接進 Hermes、OpenWork 或自己的 Agent:語音只是入口
有人問如果部署在 Hermes 裡,是不是就不用打字了。方向是對的,但要分清楚:speech-to-speech 解決的是語音輸入與語音輸出,Agent 真正能不能工作,還要看後面的工具調用、上下文、記憶、權限與任務執行。
也就是說,語音不是 Agent 的全部,只是更自然的控制入口。你可以想像之後用語音叫本地 Agent 幫你查資料、改檔案、跑腳本、操作工作流,但這需要像 OpenWork 或 Hermes Agent 這類工作台或 runtime 來承接任務。
真正有用的組合會是:speech-to-speech 負責「聽和說」,Agent runtime 負責「做事」,本地 LLM / 工具 / MCP 負責「連到你的資料和系統」。語音只是讓人更容易下指令,不能替代完整的任務架構。
資源整理
本地即時語音 Agent 很香,但現在還偏工程師玩具
speech-to-speech 讓本地語音 Agent 的架構變得很清楚:你可以把 VAD、STT、LLM、TTS 串起來,對外提供 OpenAI Realtime 相容 API,再用網頁或其他 client 連進來。這條路很有想像空間,尤其適合隱私敏感、離線使用、機器人、客服、語言練習、自建 AI 助手。
但我不會把它包裝成人人都該裝。現階段它還需要處理太多環境問題,Windows 下尤其明顯。真正適合的人,是願意花時間把本地模型、音訊依賴、GPU、WebSocket 和 Agent runtime 串起來的人。
一句話總結:本地即時語音不是為了取代手機上的語音助手,而是為了把「能聽、能想、能說」這個入口,接到你自己的模型、資料和工作流上。這件事如果跑順,會比單純聊天更有價值。
FAQ
speech-to-speech 是什麼?
speech-to-speech 是 Hugging Face 的開源語音 Agent 管線,透過 VAD、STT、LLM、TTS 四個階段,把使用者語音轉成模型回應,再合成語音輸出。
它可以完全本地運行嗎?
可以,但需要把 STT、LLM、TTS 都換成本地後端,例如 Whisper、llama.cpp 或其他 OpenAI-compatible 本地 LLM server,以及 Qwen3-TTS 等本地語音合成模型。
為什麼不用雲端語音助手就好?
如果只是日常聊天,雲端語音助手更省事。本地方案的價值在於隱私、離線、可控模型、可接自有資料與 Agent 工作流。
近期留言