by Rain Chu 10 月 6, 2026 | 硬體 , 程式
核心數增加,程式不一定會等比例變快。真正的限制,可能是工作不能同時做、資料送不進來,或有人早已做完,卻還在等最慢的那一份。
要改善平行運算效能,先找出時間花在哪裡,再決定要加核心、減少資料搬移,還是重新分配工作。
想像一間廚房:增加廚師,只有在食材供應、料理分工和出餐順序都配合時才有用。
如果所有人都擠在同一個冰箱前,爐子再多也救不了。這個觀點同樣適用於 CPU、GPU,以及把工作分到多台電腦的系統。
先看三種「人多卻更慢」的情況
把一疊數字分給兩個人計算,算的部分確實可以縮短,但如果兩人坐在教室兩端,還得走過去交付小計,最後的總時間就包含計算、傳遞與合併。省下的時間,可能全被溝通吃掉。
換成四個人,也不保證改善,如果其中一份特別難,另外三人先完成後只能等待,完成時間仍由最慢的一份決定,再把全班都拉進來數人頭,如果要先搬椅子、換座位、協調隊形,光是準備工作就可能比直接清點更久。
這三種情況,分別對應通訊成本、負載不均,以及拆分工作的額外開銷,Stanford CS149 第一講 用課堂活動說明這些限制,實際程式裡則可能表現成資料複製、同步等待、任務建立與排程。
「有變快」和「用得有效率」是兩回事
加速比是原本的執行時間除以新的執行時間。同一件事從一分鐘變成半分鐘,就是兩倍加速。這可能已經有商業價值,但如果用了大量額外硬體,仍要另外看資源利用率與成本。
比較時要固定資料量、演算法、輸出品質與計時範,。拿最佳化過的多核心版本,去對照刻意寫得很慢的單核心版本,得到的漂亮倍數無法說明平行化本身貢獻多少。
加核心有上限:用 Amdahl 定律算一個例子
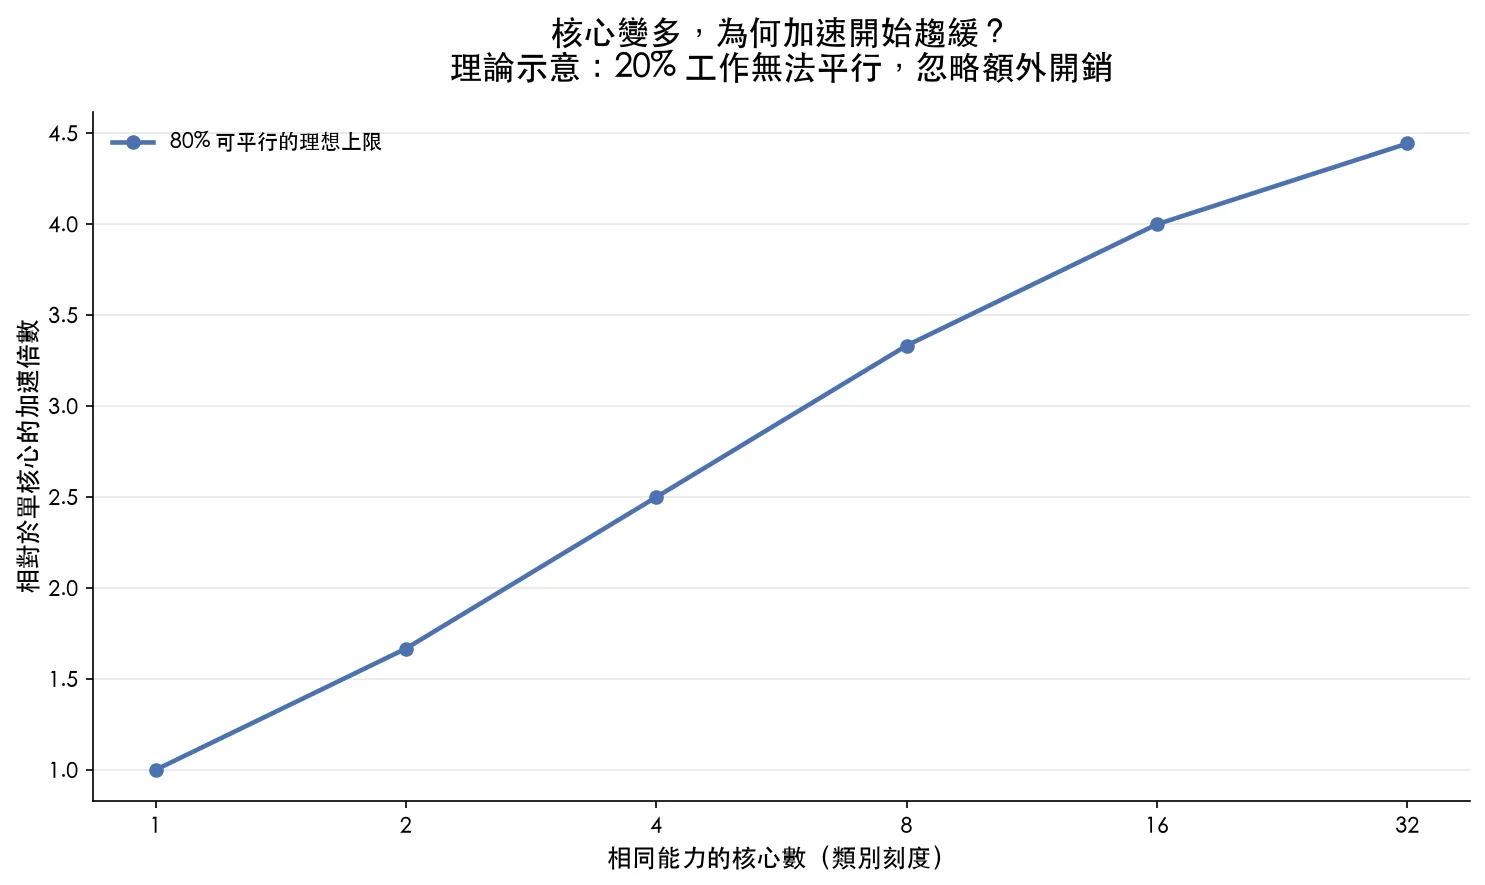
假設一項固定工作在單核心需要 100 秒,其中 20 秒必須依序做,剩下 80 秒可以完美分工。
即使忽略排程與通訊成本,增加核心也只能縮短那 80 秒。這是本文另外設計的理論示意,不是影片實測,也不是任何 CPU 的跑分。
總時間=20+80 ÷ 核心數。加速比=100 ÷ 總時間。 這個簡化模型對應 Amdahl 定律 ,假設各核心能力相同,工作量固定,而且可平行的部分能均勻分配。
核心數 理論執行時間 相對單核心加速 1 100.0 秒 1.00 倍 2 60.0 秒 1.67 倍 4 40.0 秒 2.50 倍 8 30.0 秒 3.33 倍 16 25.0 秒 4.00 倍 32 22.5 秒 4.44 倍
固定工作量、20% 依序執行、忽略額外開銷的理論示意。橫軸採類別刻度,並非硬體實測。 即使核心數持續增加,這個例子的加速也只會逐漸逼近五倍,實際程式還有其他開銷,所以診斷時要同時看「哪些部分不能拆」和「拆開後多付了什麼成本」,如果增加的是工作量而不只是核心數,就要另看吞吐量或弱擴展。
超純量、多核心、SIMD,分別在平行什麼?
處理器早就不只靠提高時脈來加速。功耗、散熱和指令相依關係,限制了單一執行流程的成長。
多放運算資源只是起點,軟體還要提供足夠、可同時執行的工作。
超純量:在同一條指令流裡找出可同時做的事
超純量處理器可以在條件允許時同時發出多道指令,例如兩筆互不依賴的乘法有機會重疊執行,但下一步若要用到前一步的結果,就必須尊重相依關係。硬體能尋找現有的平行性,卻不能憑空消除資料依賴。
多核心:讓不同工作各自前進
多核心讓不同執行緒有機會同時執行,各核心可以處理不同的指令流。
前提是程式、函式庫或執行環境有把工作拆開。只開一條主要計算執行緒,不會因為買到更多核心就自動平均分散。
課程以縮小複雜控制邏輯、換取更多核心來解釋設計取捨,但這是幫助理解的模型
。實際 CPU 常同時具備複雜核心、多核心與向量單元,不應理解成現代多核心都取消了亂序執行,或每個核心必然比較慢。
SIMD:同一個動作,一次處理多筆資料
SIMD 是單一指令、多重資料,例如把一批像素的亮度做相同調整,向量指令能同時處理多個元素,一次能處理幾筆,取決於指令集、向量寬度與資料型別,「一次八筆」只是常見教學例子。
如果不同元素需要走不同分支,部分運算通道可能被遮蔽,等待另一條路完成,這就是分支分歧造成的浪費,多核心的各個核心可以走不同指令流,SIMD 組內則有更強的共同執行限制,兩者不能當成同一回事,參考 CS149 的多核心架構講義 。
NumPy 等工具可以把批次運算交給最佳化實作,但一個陣列加號不代表整個陣列只需要一道機器指令。
通常仍有分批載入、向量運算、寫回及邊界處理,是否使用 SIMD 也受資料型別與平台影響,NumPy 官方 SIMD 說明 介紹了依 CPU 能力選擇運算核心的機制。
快取解決什麼?讓同一份資料少跑幾趟
記憶體階層可以想成倉庫、車庫與工作桌,空間越靠近操作的人,通常越有限,卻也越方便拿取,快取的價值,就是讓近期或附近會用到的資料留在靠近核心的位置。
時間區域性:剛用過的資料,稍後還會再用,保留它能減少重新讀取。
空間區域性:這筆資料旁邊的內容很快也會用到,連續存取能更有效利用一次帶回的快取列。
所以同樣數量的運算,不同資料排列方式可能有明顯速度差,連續掃描陣列,和沿著分散的指標到處跳,給記憶體系統的壓力不同。把工作切成適合快取的小區塊,完成區塊內的多個步驟再往下一塊,常比每個步驟都重掃整份資料更值得試。
快取不會保證所有存取都快,工作集合太大、資料重用不足,或不同核心反覆改動同一快取列,都可能增加傳輸,甚至兩個執行緒修改的是不同變數,只要它們碰巧位於同一快取列,也可能產生偽共享,需要用量測確認。
延遲與頻寬不同,多執行緒也不能取代頻寬
延遲是等一份資料需要多久,頻寬是單位時間內能送多少資料。
增加車道可以讓更多車通過,卻不必然縮短每台車從起點到終點的行程,相同地,記憶體頻寬提高,不代表每一次零散讀取都會更快。
硬體多執行緒的想法,是某條執行緒等待時,先安排另一條準備好的執行緒使用運算單元,它可以隱藏部分等待,增加整體吞吐量,但不會讓原本那份資料提早到達,也不等於多出完整的實體核心。
這招需要足夠的獨立工作和可用資源,如果記憶體通道早已滿載,再增加執行緒只是在增加排隊者,把「多執行緒能隱藏延遲」直接說成「多執行緒能解決所有記憶體問題」,就會選錯最佳化方向。
為什麼高階 GPU 也可能吃不滿?
做兩個大陣列的逐元素乘法時,每筆結果只做少量算術,卻要讀取輸入並寫回輸出,這種工作可能先用完記憶體傳輸能力,運算單元仍有餘裕,CS149 第三講 以 V100 時代的假設硬體與運算模型說明這件事,低利用率是特定工作負載相對算術峰值的估算,不能解讀成所有 GPU 都只有固定百分比有效能。
這裡的關鍵是算術強度:相對於搬動的資料量,完成了多少運算,若能把資料載入後多用幾次,或避免不必要的中間結果寫回,就可能提高效率,不過增加無意義的計算,只會讓數字好看,並沒有更快完成使用者的工作。
跑本地模型時也要區分「放得下」和「送得快」,容量決定可容納的資料與模型規模,頻寬影響搬運速度,實際瓶頸還會隨批次與階段改變。可以接著看站內的 本地 AI 記憶體容量與頻寬整理 ,理解為什麼只看 GPU 核心數不夠。
工作怎麼分,決定大家會不會互相等待
靜態分配是在開始前先切好每個工作者負責的範圍。它簡單、開銷低,也容易保留資料區域性,適合每份工作成本接近的情況,若有些影像區塊特別難算,平均分配像素數不等於平均分配計算時間。
動態分配則讓工作者完成一批後,再領下一批,降低有人空等的機會,代價是領取任務、同步與管理佇列都要成本,每批太大,仍可能負載不均。每批太小,則可能忙著領工作而非真正計算。
一個實用折衷,是把大任務切成數量多於工作者的區塊,同時讓每個區塊保有足夠的連續資料,再比較不同區塊大小的總耗時,而不是預設動態排程一定比較快,CS149 的工作分配與排程講義 也把負載平衡和管理開銷放在一起討論。
判斷一批整數是否為質數,就是很直觀的例子,使用逐一試除的做法時,不同數字可能花費不同時間,平均分配數字個數不代表負載均衡,如果能事先估計成本,提早安排較大的任務,也可能減少最後只剩一人忙碌的長尾。
ISPC 與 Cilk:表達可平行的工作,交給系統安排
ISPC 讓你用接近逐筆處理的方式描述運算,再以一組 program instances,也就是 gang,執行相同程式。
要特別分清楚:在 CPU 的常見用法中,gang 主要對應向量化,並不代表每個 instance 都是一條作業系統執行緒。
跨核心並行還需要 task 或呼叫端的多執行緒安排,入門可參考 ISPC 官方文件 與 CS149 第一份程式作業 。
Cilk 則以分支、匯合的方式表達任務相依關係,當一個工作者沒有事做,可以透過 work stealing 從其他工作者取得尚待執行的工作。重點是暴露可平行的任務,再由執行系統排程,而不是為每個小任務都建立一條新執行緒。想動手學習,可以從 OpenCilk 的平行任務教學 開始。
快速排序則呈現另一種情況:先把資料按基準值分成兩側,接著左右可以分別排序,可平行的子問題隨遞迴逐步出現,是否能順利利用多核心,還受分區均衡與最小任務大小影響,Cilk 的關鍵字也不是所有標準 C++ 編譯器都直接支援,實作時要使用支援它的工具鏈。
資料搬運也要分:必要交換,還是實作多出的往返?
有些通訊是目前演算法與工作分配必須付出的成本,例如把影像分區後,相鄰區域需要交換邊界資料。
有些則來自實作細節,例如快取容量不足、傳輸粒度太大、重複複製中間結果。CS149 第六講 將兩者區分為 inherent communication 與 artifactual communication。
區分的目的,是找到可以改的地方。必要交換不代表完全無法減少,重新選擇分區方式可能縮小邊界,實作造成的往返,也可能透過更好的資料布局、合併步驟和重用快取來降低。
把模型或工作拆到多台機器時,這些原則仍成立,除了各台機器的能力,還要看互連、分片方式與交接資料量,站內的 EXO 與本機 AI 分工整理 ,可以延伸理解多機合作為什麼不是把規格直接相加。
同樣地,顯存不足時把部分模型卸載到系統記憶體,可能讓工作成功執行,卻增加資料搬移。像 LTX 的低顯存工作流程 ,就適合用「容量換取可執行性,再付出搬運成本」的角度評估,不能只看是否成功啟動。
遇到程式跑不快,我會按這個順序檢查
固定基準:使用同一份輸入、相同輸出品質與完整計時範圍,保留可重現的單核心或原始版本。
找出熱點:先確認時間花在計算、I/O、記憶體、同步還是外部服務,別直接從增加執行緒開始。
逐步增加並行度:比較少量與較多工作者的總時間,也看各工作者是否平均忙碌。
檢查資料路徑:是否反覆複製、跨裝置來回、產生巨大暫存,或無法利用連續存取。
一次改一項:調整區塊大小、合併運算或排程策略後,重新檢查正確性與總耗時。
不要只追求 CPU 或 GPU 的使用率數字。忙碌可能代表重複計算,低使用率也可能是合理地等待磁碟或網路。最終要回答的是:在相同品質與限制下,完成同一件事花了多久,用掉多少資源。
平行運算常見問題
核心越多,任何程式都會更快嗎?
不會。程式必須有足夠可同時執行的工作,而且不能被序列部分、記憶體頻寬、同步或負載不均限制。更多核心也可能增加額外開銷。
SIMD 和多核心有什麼不同?
SIMD 讓一個指令同時作用於多筆資料,多核心則讓不同核心執行各自的指令流。兩者可以並用,但工作必須符合各自的執行方式。
快取越大,效能一定越好嗎?
不一定。資料是否會重用、存取是否連續、工作集合大小與其他核心的存取方式,都會影響快取是否真的減少等待與搬運。
多執行緒可以解決記憶體頻寬不足嗎?
多執行緒能在有獨立工作時隱藏部分延遲,但不會增加實際可用頻寬。通道滿載後,增加執行緒可能只增加排隊與競爭。
應該先升級硬體,還是先改程式?
先量測。若主要成本是重複搬移、任務分配或序列熱點,改善程式可能更有效。確認瓶頸確實對應硬體能力後,才有依據選擇升級項目。
先找到等待發生在哪裡,再談加速
平行運算的核心問題,是讓可同時做的工作真正同時進行,同時控制搬資料、分工與等待的成本。多核心提供空間,SIMD 提高相同運算的吞吐,快取減少遠端存取,多執行緒利用等待空檔,排程則避免工作分配失衡。它們各自解決不同問題,沒有哪一招能包辦全部。
如果手上就有一段跑不快的程式,先記錄它在不同工作者數量下的完整耗時,找出哪一步開始不再改善。這個轉折點,往往比硬體規格表更能告訴你下一步該改什麼。
延伸學習:Stanford CS149 前六講
想沿著相同脈絡深入,可以從 Stanford CS149 官方課程播放清單 開始,並搭配 課程講義目錄 。
by Rain Chu 2 月 11, 2026 | PHP , 程式
最近我的伺服器突然出現網站 502 錯誤,檢查後發現 php8.2-fpm 服務竟然被系統強制終止。透過一系列排查,最終確認是 Linux OOM Killer(Out Of Memory) 觸發導致。
這篇文章整理完整排查過程與解決方案,提供給遇到相同問題的人參考。
📌 問題現象
使用 systemctl status php8.2-fpm 發現:
Active: failed (Result: oom-kill)
進一步檢查 kernel log:
Out of memory: Killed process 7057 (php-fpm8.2)
anon-rss:283560kB
shmem-rss:119848kB
代表:
系統記憶體耗盡
Linux 啟動 OOM Killer
強制殺掉 php-fpm worker
🔍 進一步分析
查看當時 PHP worker 記憶體使用情況:
ps -o pid,rss,etime,cmd -C php-fpm8.2 --sort=-rss | head -n 20
當時結果顯示:
RSS 約 250MB ~ 325MB/每個 worker
而之前狀態顯示:
Processes active: 80
idle: 0
🔥 問題核心
如果每個 worker 約 300MB:
但機器只有:
👉 記憶體一定會爆。
🧠 伺服器環境
這代表:
沒有 swap 作為緩衝
一旦瞬間記憶體尖峰,直接 OOM
🛠 解決方案
✅ 1️⃣ 建立 8GB Swap(防止再次 OOM)
sudo fallocate -l 8G /swapfile
sudo chmod 600 /swapfile
sudo mkswap /swapfile
sudo swapon /swapfile
echo '/swapfile none swap sw 0 0' | sudo tee -a /etc/fstab
確認:
結果:
建議調整 swappiness
echo 'vm.swappiness=10' | sudo tee /etc/sysctl.d/99-swappiness.conf
sudo sysctl -p /etc/sysctl.d/99-swappiness.conf
✅ 2️⃣ 調整 PHP-FPM 設定(關鍵)
編輯:
/etc/php/8.2/fpm/pool.d/www.conf
修改為:
pm = dynamic
pm.max_children = 25
pm.start_servers = 6
pm.min_spare_servers = 4
pm.max_spare_servers = 10
pm.max_requests = 500
為什麼設 25?
假設每個 worker 約 150MB:
在 15GB RAM 環境下非常安全。
✅ 3️⃣ 開啟 Slow Log(抓出慢請求)
在 www.conf 加入:
request_slowlog_timeout = 10s
slowlog = /var/log/php8.2-fpm/www-slow.log
request_terminate_timeout = 60s
建立目錄:
sudo mkdir -p /var/log/php8.2-fpm
sudo chown -R www-data:www-data /var/log/php8.2-fpm
sudo systemctl restart php8.2-fpm
查看慢請求:
sudo tail -f /var/log/php8.2-fpm/www-slow.log
📊 調整後效果
重啟後查看:
ps -o pid,rss,etime,cmd -C php-fpm8.2 --sort=-rss | head -n 20
結果:
RSS 約 100MB ~ 170MB
ELAPSED 僅 20 秒左右
✔ 不再出現 300MB 以上肥 worker
🎯 問題總結
本次 OOM 原因:
pm.max_children 設定過高每個 worker 記憶體使用偏高
沒有 swap 緩衝
慢請求導致 worker 堆積
最終解法:
限制 max_children
建立 swap
開 slowlog 抓慢請求
設定 max_requests 避免 memory leak
🚀 建議最佳實務
設定 建議 Swap 一定要有(至少 4GB) max_children 用 RAM / worker RSS 計算 max_requests 300~1000 slowlog 必開 request_terminate_timeout 必設
📌 結論
OOM Killer 不是錯誤,它是保護機制。
真正的問題通常是:
PHP-FPM 設定不合理
慢請求堆積
記憶體容量與負載不匹配
只要正確限制 worker 數量並建立 swap,伺服器穩定度會大幅提升。
如果你也遇到 php-fpm 被 OOM kill 的問題,希望這篇實戰紀錄能幫助你快速排查與解決。
相關資訊
by Rain Chu 8 月 8, 2025 | Agent , AI , Javascript , Python , RPA , 瀏覽器 , 程式開發
想用 AI 控制網頁自動化,但程式碼又要精準可靠,同時享受自然語言,高效又方便?那你絕不能錯過由 Browserbase 團隊推出的 Stagehand —— 這款專為 AI 時代設計的瀏覽器自動化框架,不僅支援 TypeScript 與 Python、可本地或雲端部署,還比 Browser‑Use 更快、更耐變動!
Stagehand 兼具控制力與智慧的 AI 瀏覽器自動化框架
Stagehand 是以 Playwright 為核心構建的 AI-native 自動化工具,它加入了 LLM 判斷能力,結合程式精準控制與自然語言指令,令自動化腳本更穩定、更智慧也更高效
自然語言 + 程式碼混合操作 :你可以用程式寫明確動作,也能用「act(‘點擊第一個 Stagehand 元件’)」這樣類人語法完成UI操作 。接口完整,支援察看、執行與資料萃取 :核心三大命令 act、observe、extract,讓操作更透明、更可控 容錯與自恢復能力 :UI 略有變動也不怕,Stagehand 的 observe + 快取策略讓腳本更具彈性完美整合 Playwright :所有 Playwright 腳本都能無縫升級 Stagehand,省心又高效
核心玩法!TypeScript/JavaScript 快速上手範例
// Use Playwright functions on the page object
const page = stagehand.page;
await page.goto("https://github.com/browserbase");

// Use act() to execute individual actions
await page.act("click on the stagehand repo");

// Use Computer Use agents for larger actions
const agent = stagehand.agent({
    provider: "openai",
    model: "computer-use-preview",
});
await agent.execute("Get to the latest PR");

// Use extract() to read data from the page
const { author, title } = await page.extract({
  instruction: "extract the author and title of the PR",
  schema: z.object({
    author: z.string().describe("The username of the PR author"),
    title: z.string().describe("The title of the PR"),
  }),
});
這段程式完整示範了初始化、導航、AI 驅動操作到資料萃取的流程,不僅省事,也大幅提升開發效率。
Stagehand 與 Browser-Use 比較
功能面 Stagehand(此文主角) Browser-Use 控制精準度 Token 級動作掌控 + 自然語言指令混合 攻擊角度偏自然語言,程式控制較弱 容錯能力 observe + 快取策略,對 DOM 變化更耐受缺少自恢復機制 雲端支援 原生整合 Browserbase,輕鬆雲端部署 需額外集成,無預設雲平台支援 語言支援 TypeScript / Python 主要依賴 Python AI 整合 天生結合 LLM,支援複雜任務拆解 依賴外部 LLM,不那麼一體化
只要先學四個指令,快速上手
指定去那一個網頁
goto():
    # 初始化
    page = stagehand.page
    # 指定去那一個頁面
    await page.goto("https://rain.tips/")
使用自然語言操作
act():
await page.act("點選確定按鈕"); 抓取數據資料
extract():
post = await page.extract("取得標題") 預覽功能
observe():
links = await page.observe("找到頁面中的所有連結") 實戰快速導覽
安裝
# 用 pip
pip install stagehand python-dotenv

# 安裝playwright
python -m playwright install

# 裝 chromium 瀏覽器
python -m playwright install chromium
建立 .env
export BROWSERBASE_API_KEY="your_browserbase_api_key"
export BROWSERBASE_PROJECT_ID="your_browserbase_project_id"
export MODEL_API_KEY="your_model_api_key"  # OpenAI, Anthropic, etc.
建立程式碼 main.py
import asyncio
import os
from stagehand import Stagehand, StagehandConfig
from dotenv import load_dotenv

load_dotenv()

async def main():
    config = StagehandConfig(
        env="BROWSERBASE",
        api_key=os.getenv("BROWSERBASE_API_KEY"),
        project_id=os.getenv("BROWSERBASE_PROJECT_ID"),
        model_name="gpt-4o",
        model_api_key=os.getenv("MODEL_API_KEY")
    )

    stagehand = Stagehand(config)

    try:
        await stagehand.init()
        page = stagehand.page

        await page.goto("https://docs.stagehand.dev/")
        await page.act("click the quickstart link")

        result = await page.extract("extract the main heading of the page")

        print(f"Extracted: {result}")

    finally:
        await stagehand.close()

if __name__ == "__main__":
    asyncio.run(main())
驗證與測試
若要用本地端的瀏覽器的話,可以改成下面的程式碼
import asyncio
import os
from dotenv import load_dotenv
from stagehand import StagehandConfig, Stagehand

load_dotenv()

async def main():
    # 检查API密钥是否设置
    api_key = os.getenv("OPENAI_API_KEY")

    config = StagehandConfig(
        env="LOCAL",  # 本地运行
        # AI模型配置 - 使用环境变量
        model_name="gpt-4o-mini",  # 使用更便宜的模型
        model_api_key=api_key,  # 从环境变量读取

        # 本地运行配置
        headless=False,  # 显示浏览器窗口
        verbose=3,  # 详细日志
        debug_dom=True,  # DOM调试
    )

    # 使用配置创建Stagehand实例
    stagehand = Stagehand(config)

    # 初始化Stagehand(启动浏览器会话)
    await stagehand.init()

    # 获取页面对象,用于后续的页面操作
    page = stagehand.page

    await page.goto("https://rain.tips/")

    # # 使用observe()取得文章的連結
    blog_links = await page.observe("取得文章中的所有連結)
    print(f"✅ Page link: {blog_links}")

    await page.act(blog_links[0])
    data_post_1 = await page.extract("取得文章的標題和內文")
    print(f"✅ 文章資訊如下: {data_post_1}")

if __name__ == "__main__":
    asyncio.run(main())
總結:為什麼 Stagehand 是下一代自動化框架?
語言直覺更自然,人類可理解 對 UI 變化具彈性、不易失效 結合 LLM,自動拆解任務,效率提升數倍 支援本地與雲端,開發與生產環境都得心應手
Stagehand 正重新定義瀏覽器自動化,不再只是死板指令,而是一場「程式控+AI 智能」的完美結合,無論對開發者或 AI 自動化愛好者,都是一大利器。快一起駕馭它,打造更強、更智慧的自動化流程!
參考資料
BrowserBase
GitHub Stagehand
Demo
開發說明文件
https://www.aivi.fyi/aiagents/introduce-stagehand
by Rain Chu 4 月 26, 2025 | Python , 程式
UIAutoDev
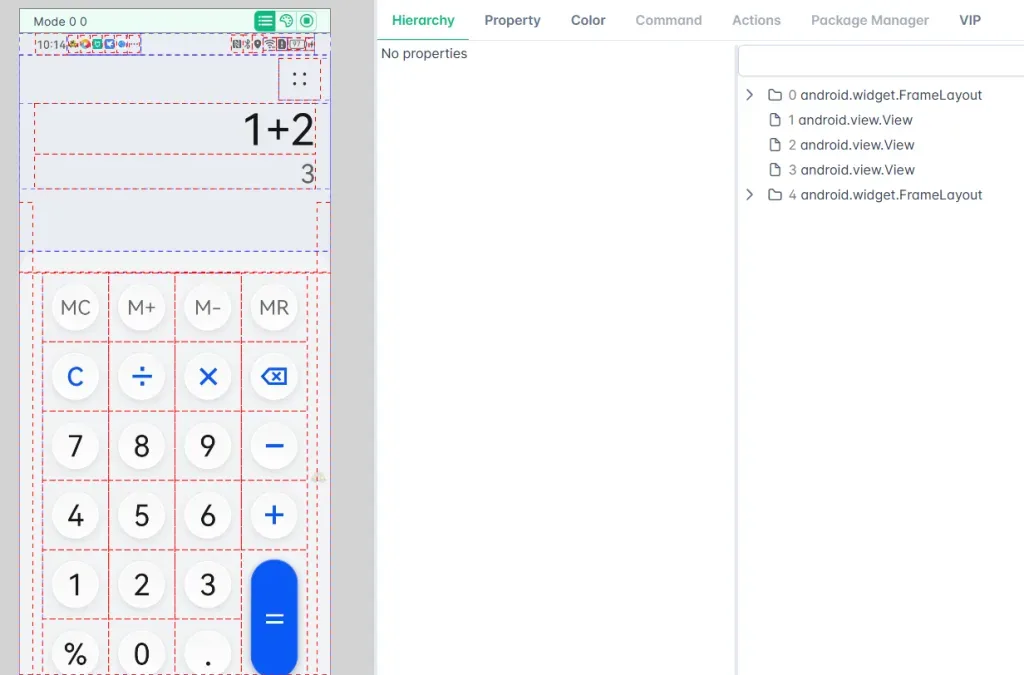
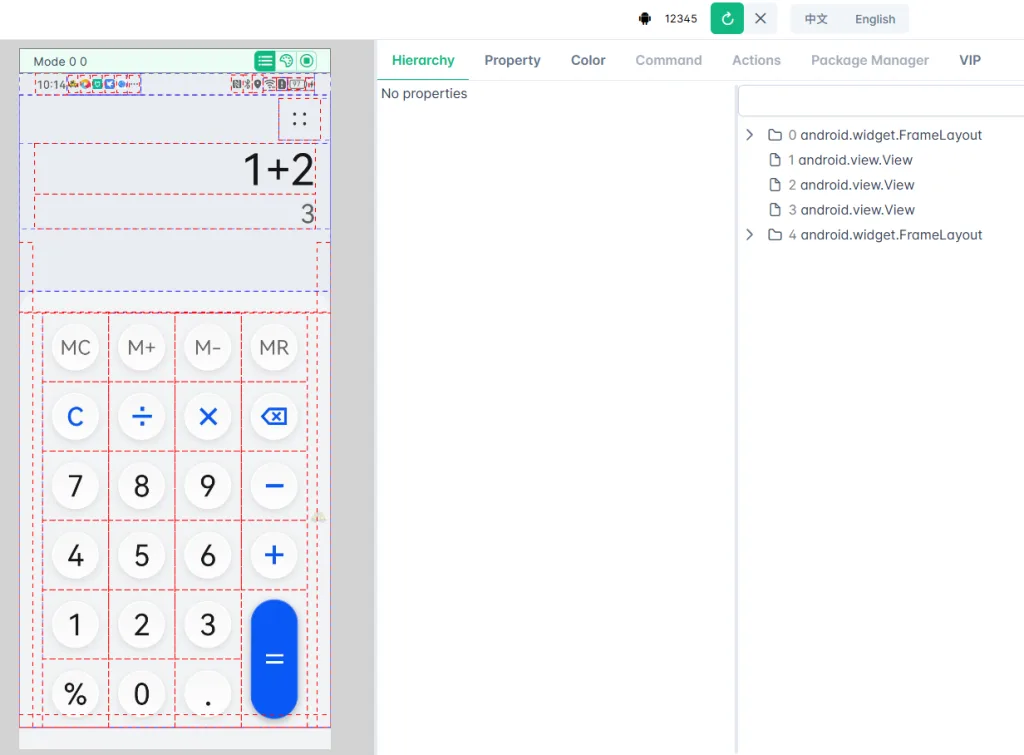
UIAutoDev UI DEMO 🔧 UIAutoDev 的核心特色
1. 支援 Android 和 iOS 平台
UIAutoDev 同時支援 Android 和 iOS 裝置的 UI 元素檢視與操作。對於 iOS,用戶需自行啟動 WebDriverAgent(WDA)服務,以實現與裝置的連接。
2. 直觀的控件選擇與屬性檢視
透過滑鼠點選應用程式中的控件,UIAutoDev 會即時顯示該元素的屬性資訊,如 resource-id、text、class 等,並在控件樹中高亮顯示,方便用戶精確定位。
3. 自動生成 XPath 選擇器
UIAutoDev 能夠根據選取的控件,自動生成多個 XPath 選擇器,並標示每個選擇器匹配的元素數量,協助用戶選擇最合適的定位方式。
4. 色彩分析與坐標微調
工具提供找色功能,允許用戶獲取指定位置的 RGB 和 HSB 色值。同時,透過方向鍵微調坐標,精確定位需要操作的區域,提升自動化腳本的準確性。
🚀 安裝與使用指南
1. 安裝 Python 環境
確保系統已安裝 Python 3.8 或以上版本。
2. 安裝 UIAutoDev
在終端機中執行以下命令:
3. 啟動 UIAutoDev
安裝完成後,執行以下命令啟動工具:
啟動後,瀏覽器將自動打開 UIAutoDev 的網頁介面。
4. 連接裝置
Android :啟用開發者選項並允許 USB 偵錯,使用 USB 或 Wi-Fi 連接裝置。iOS :啟動 WebDriverAgent(WDA)服務,並確保裝置與電腦在同一網路下。
5. 使用工具進行 UI 元素定位
在網頁介面中選擇已連接的裝置。
點擊「刷新」按鈕,同步裝置當前畫面。
使用滑鼠點選畫面中的控件,查看其屬性資訊,並在右側控件樹中進行導航。
利用自動生成的 XPath 選擇器,快速編寫自動化腳本。
🧪 實際應用範例
可以先看DEMO
以下是一段使用 uiautomator2 與 UIAutoDev 結合的 Python 腳本範例:
import uiautomator2 as u2

# 連接到裝置
d = u2.connect()

# 啟動應用程式
d.app_start("com.example.app")

# 點擊指定的控件
d(resourceId="com.example.app:id/button").click()

# 輸入文字
d(resourceId="com.example.app:id/input").set_text("測試輸入")

# 關閉應用程式
d.app_stop("com.example.app")
透過 UIAutoDev 提供的控件屬性資訊,您可以輕鬆取得 resource-id 等屬性,快速編寫上述腳本。
參考資料
https://testerhome.com/topics/40069
by Rain Chu 3 月 27, 2025 | Python , 程式
當你在開發 Python 時,將程式轉換為可執行檔案(如 .exe)並提升執行效率是許多開發者關心的議題,Nuitka 是一款大家都推薦的 Python 編譯器,能夠將 Python 原始碼編譯為 C 語言,進而生成高效的可執行檔案,今天來介紹 Nuitka 的安裝、封裝流程、靜態檔案,與相依套件的處理,以及常見問題與性能優化建議,讓即使是初學者也能輕鬆上手。
1. 安裝與執行封裝
安裝 Nuitka
安裝 C++ 編譯器 :Nuitka 需要 C++ 編譯器來編譯生成的 C 程式碼。在 Windows 系統上,推薦安裝 MinGW64。安裝 Nuitka :使用 pip 安裝 Nuitka:
執行封裝
假設您的主程式為 main.py,可以使用以下命令將其封裝為可執行檔案:
nuitka --standalone --mingw64 --enable-plugins=tk-inter --disable-console --remove-output --onefile --output-dir=output main.py 上述命令的參數說明:
--standalone:生成獨立的可執行檔案,包含所有相依套件。--mingw64:使用 MinGW64 作為編譯器。--enable-plugins=tk-inter:啟用 tkinter 插件,根據實際使用的套件啟用相應插件。--disable-console:隱藏執行時的控制台視窗,適用於 GUI 應用程式。--remove-output:在編譯完成後移除中間產物。--output-dir=output:指定輸出目錄為 output。–onefile:如果希望輸出為單一 .exe 檔案
如果是要用 Visual Studio C++ 來封裝的話可以改用
nuitka --standalone --msvc=latest --enable-plugins=tk-inter --disable-console --remove-output --output-dir=output main.py 2.靜態檔案的處理
在某些應用中,可能需要包含額外的靜態檔案(如圖片、配置檔案)。Nuitka 提供了 --include-data-dir 參數來處理這些檔案:
此命令將當前目錄下的 static 資料夾包含到生成的可執行檔案中,並在執行時可正常訪問。
3.相依套件的處理
Nuitka 會自動檢測並包含大多數的相依套件。然而,對於某些特殊的套件,可能需要手動啟用相應的插件。例如,若您的程式使用了 PySide6,則需要在編譯時啟用該插件:
您可以使用 nuitka --plugin-list 命令查看所有可用的插件列表。
4.常見問題的處理
Nuitka 在首次編譯大型專案時可能需要較長時間。為了加快編譯速度,可以安裝 ccache 來進行編譯快取。
由於 Nuitka 會將所有相依套件包含在內,生成的可執行檔案可能較大。可以嘗試使用 --onefile 參數將所有內容打包成單一檔案,或使用壓縮工具對生成的檔案進行壓縮。
5.關於速度的優化
Nuitka 通過將 Python 程式編譯為 C 語言,通常能提升程式的執行效率。然而,實際的性能提升取決於程式的結構和內容。為了獲得最佳性能,建議:
優化原始碼 :確保程式碼中沒有不必要的計算和冗餘。使用內建函數 :盡可能使用 Python 的內建函數,因為它們通常經過高度優化。避免過度使用動態特性 :如 eval、exec 等,這些可能影響編譯器的優化能力。
6.🌟使用 Nuitka GUI 友善介面
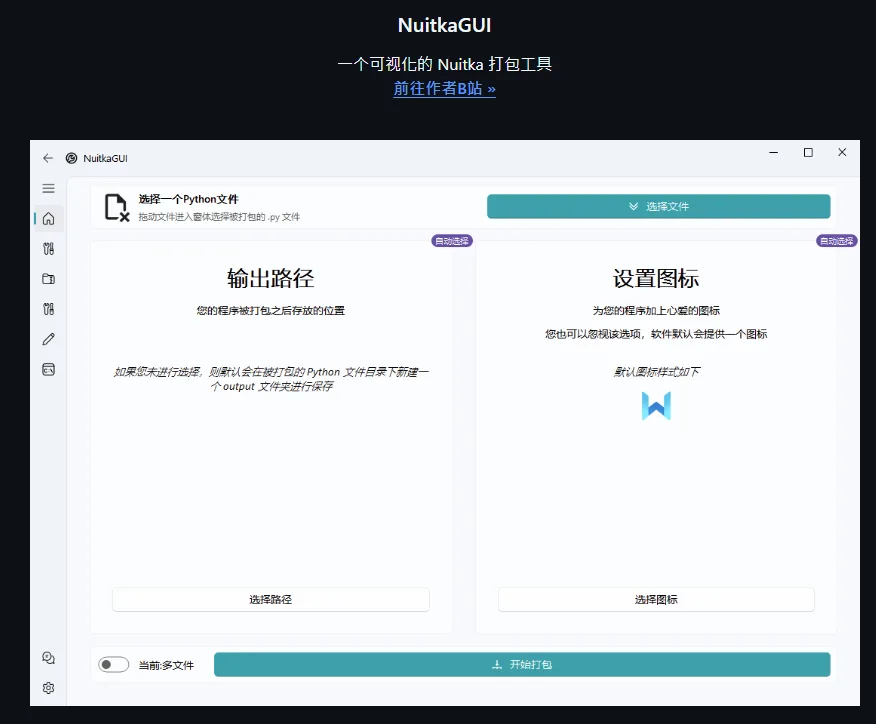
因為既指令很麻煩,推薦使用 Nuitka GUI,這是一款直覺且操作簡單的圖形介面工具。
Nuitka 官方 GUI 安裝:
開啟 Nuitka GUI:
或是用開源的 GUI
https://github.com/271374667/NuitkaGUI
參考資料
https://nuitka.net
by Rain Chu 2 月 20, 2025 | PHP , 程式
什麼是 OpenTBS?
OpenTBS(Open Template-Based Substitution)是一個基於 PHP 的插件,允許開發者使用 OpenTBS 在 Office Open XML(如 .docx、.xlsx、.pptx)以及 OpenDocument 格式(如 .odt、.ods、.odp)的範本中動態插入數據。它基於 TBS(TinyButStrong)引擎,並提供了一種靈活且易於使用的方法來生成動態文件。
為何選擇 OpenTBS?
無需額外安裝 Office 軟體 :OpenTBS 直接操作 Office 文件格式,無需安裝 Microsoft Office 或 LibreOffice。輕量級 :僅需一個 PHP 文件,即可輕鬆集成到現有項目。模板驅動 :允許使用標準的 Office 應用程式來設計範本,無需學習額外的標記語言。支持多種格式 :可處理 .docx、.xlsx、.pptx、.odt 等格式,適用於多種場景,如報表、合同、發票等。
安裝 OpenTBS
OpenTBS 是一個 PHP 插件,可通過下載或使用 Composer 來安裝。
下載 Zip 檔
前往 官方網站 下載 tbs_class.php 和 tbs_plugin_opentbs.php。
將這兩個文件放入你的 PHP 項目中。
GitHub
說明文件
DEMO 網站
基本使用方法
以下是使用 OpenTBS 生成 Word(.docx)文件的基本示例。
1. 建立 Word 範本
在 Word (.docx) 文件中,使用 [] 來標記動態數據,例如:
2. 編寫 PHP 代碼
require_once('tbs_class.php');
require_once('tbs_plugin_opentbs.php');

// 創建 TBS 實例
$TBS = new clsTinyButStrong;
$TBS->Plugin(TBS_INSTALL, OPENTBS_PLUGIN);

// 載入範本文件
template = 'template.docx';
$TBS->LoadTemplate($template, OPENTBS_ALREADY_UTF8);

// 設定變數
$data = array(
    'company_name' => 'ABC 公司',
    'date' => date('Y-m-d'),
    'client_name' => '王小明'
);
$TBS->MergeField('var', $data);

// 輸出生成的文件
$output_file = 'output.docx';
$TBS->Show(OPENTBS_DOWNLOAD, $output_file);
exit;
圖片的進階用法
在 Word 模板中設定圖片
打開 Word (.docx) ,選擇一張要被替換的圖片,
設定 TBS 標籤(放入圖片的「替代文字」區域): 選取圖片 → 右鍵 → 圖片格式 在「替代文字」欄位輸入以下內容 :
[img.user_logo;ope=changepic] pic 是變數名稱,稍後在 PHP 代碼中會用到,這樣 OpenTBS 就知道這張圖片要被替換! 使用 OPENTBS_CHANGE_PICTURE 手動更換圖片
其他參數
要根據原始圖片的框架大小設計的話可以使用
其他 adjust 參數:
參數 說明 adjust=inside圖片自動調整以適應框架(推薦 ) adjust=samewidth圖片的寬度與模板圖片相同 adjust=sameheight圖片的高度與模板圖片相同 adjust=100%圖片維持原始大小
範例
[onshow.pic;ope=changepic;adjust=samewidth;default=current;tagpos=inside] 特殊關鍵字
onshow : 會直接使用php中的同名變數做替換
結論
OpenTBS 是一個強大且輕量的 PHP 插件,能夠讓開發者方便地生成 Word、Excel、PowerPoint 等格式的動態文件,特別適用於報表生成、合約填寫、數據輸出等應用場景,如果你的項目需要動態生成 Office 文檔,可以試試 OpenTBS,它將為你帶來極大的便利!
近期留言