by Rain Chu 8 月 27, 2026 | AI , DeepSeek , 模型
把兩台小型 AI 超級電腦接在一起,最先增加的不是單一請求速度,而是可承載的模型規模、上下文長度與同時服務能力,MSI EdgeXpert 採用 NVIDIA GB10 平台,每台有 128GB 統一記憶體,雙節點可讓 284B 的 DeepSeek V4 Flash、397B 的 Qwen3.5 MoE 與 230B 的 MiniMax M2 進入本地推理測試範圍。
我會把這類設備看成桌上型 AI 伺服器,而不是高階遊戲電腦,它最有價值的地方,是統一記憶體、低功耗、200GbE 高速互連,以及把敏感資料留在本地的能力,若只想偶爾聊天或寫程式,雲端 API 通常更省錢,若要處理長時間視覺串流、企業內網資料、批次 Agent 或需要 100GB 以上權重,本地設備才開始顯出意義。
MSI EdgeXpert 是什麼
EdgeXpert MS-C931 是基於 NVIDIA DGX Spark 平台思路打造的小型 AI 工作站,核心採 GB10 Grace Blackwell Superchip,把 20 核 Arm CPU、Blackwell GPU 與 128GB LPDDR5X 統一記憶體放進 151mm 見方的機身,重量約 1.2kg,儲存空間為 4TB NVMe M.2。
項目 EdgeXpert 規格 實際意義 處理器 10 顆 Cortex-X925 加 10 顆 Cortex-A725 適合資料處理、服務調度與模型前後處理 GPU NVIDIA GB10 Grace Blackwell 6144 CUDA 核心,第 5 代 Tensor Core 統一記憶體 128GB LPDDR5X CPU 與 GPU 共用,適合大型權重 記憶體頻寬 273GB/s 容量很大,但頻寬低於高階獨立顯卡 高速網路 2 個 200GbE QSFP56 可用雙鏈路連接兩個節點 一般網路 10GbE RJ-45 管理、檔案傳輸與區域網路服務 其他連接 4 個 USB 3.2 Type-C、HDMI 2.1a、Wi-Fi 7、藍牙 5.4 方便接相機、儲存裝置與顯示器 功耗 140W TDP 比傳統多卡工作站更容易放進辦公環境
GB10 與 RTX 5070 都有 6144 CUDA 核心,但定位完全不同,GB10 有 128GB 統一記憶體與最高 1000 AI TOPS,記憶體頻寬約 273GB/s,RTX 5070 只有 12GB GDDR7,頻寬約 672GB/s,前者能裝下大模型,後者在權重能完整放入顯存時通常跑得更快,容量和頻寬不能只選一個數字判斷。
雙機互連不是把速度直接乘二
兩個節點透過 QSFP56 連接後,模型權重會分散到兩台機器,每完成一層或一段運算,節點之間就要交換張量,這讓單台放不下的模型能夠執行,也能增加併發量,但同時帶來網路同步、序列化與等待成本。
容量擴張 :雙節點約有 256GB 統一記憶體可供系統與模型使用。模型並行 :大型權重被切到兩台機器,任何一台故障都會讓服務中斷。鏈路聚合 :兩條 200GbE 能降低通訊瓶頸,但收益取決於模型本身的計算與通訊比例。延遲代價 :併發越高,P95 尾端延遲通常越明顯。
有人實際把四台同類設備做環形連接,確實能執行更大的模型,但速度不一定理想,節點增加後,容量會先變大,通訊路徑與維運難度也一起增加。這也是為什麼 273GB/s 記憶體頻寬與網路拓撲,比單看 AI TOPS 更值得注意。
三個大型 MoE 模型的雙機測試
測試固定使用 200G RoCE,透過 OpenAI 相容的 completions 介面送出三組工作提示。併發從 1、2、4、6 增加到 8,每個設定重複三次,觀察聚合吞吐量、P95 延遲、失敗請求與異常輸出。
模型 總參數與啟用參數 量化 模型載入量 每節點記憶體 測試上下文 Qwen3.5 397B A17B 397B、啟用 17B INT4 AutoRound 約 226GB 98.24GiB 262K DeepSeek V4 Flash 284B、啟用 13B FP4 加 FP8 約 160GB 75.8GiB 500K MiniMax M2 AWQ 230B、啟用 10B AWQ 4-bit 約 121GB 56.38GiB 128K
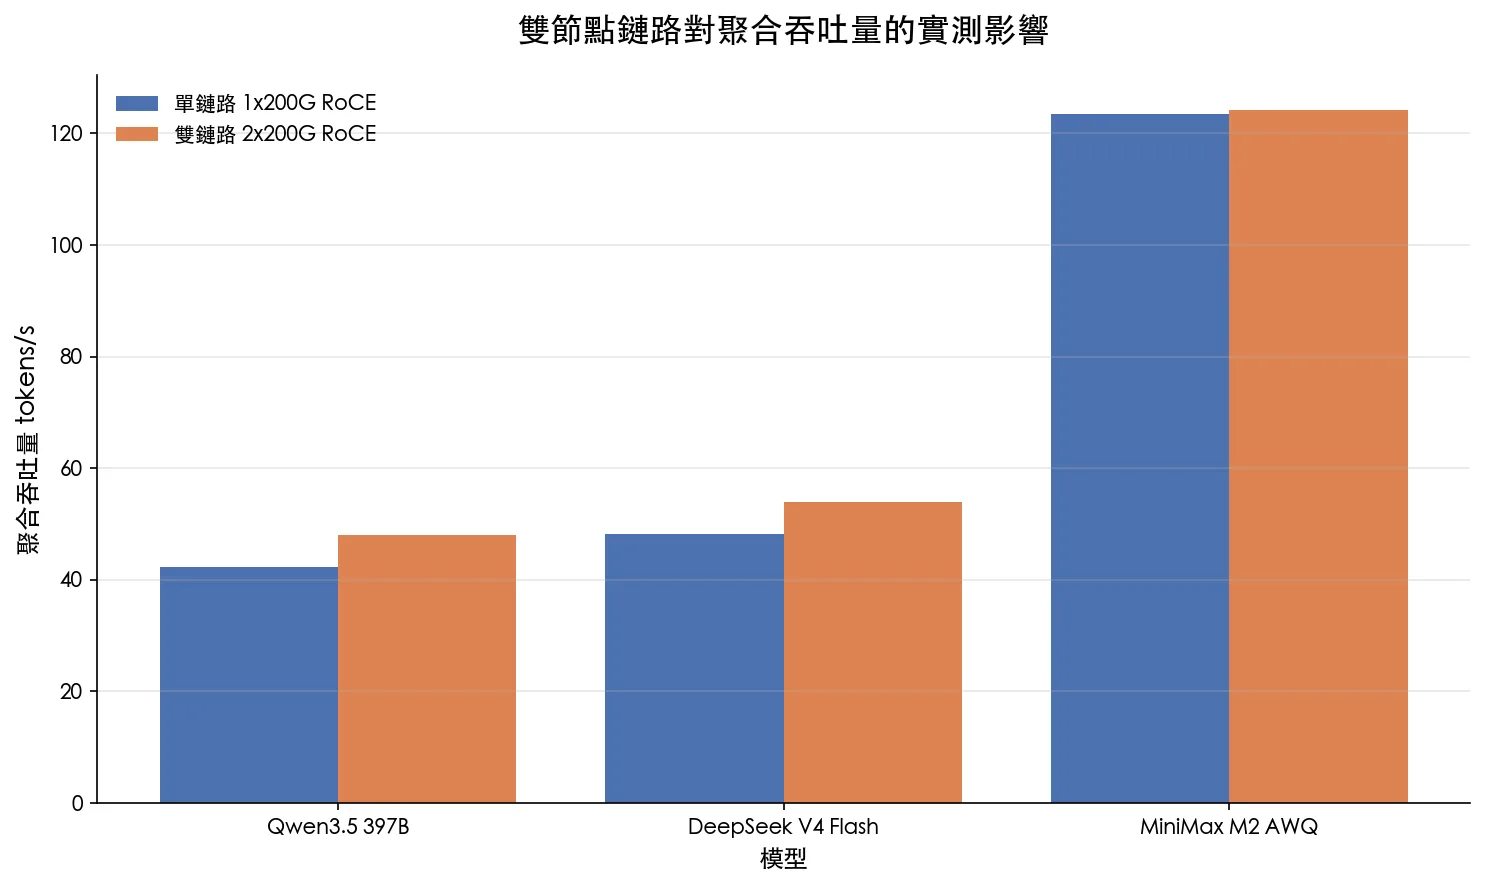
雙鏈路對 Qwen3.5 與 DeepSeek V4 Flash 有明顯幫助,對 MiniMax M2 的增幅很小。資料為每組三次測試平均。 模型 單鏈路 tokens/s 雙鏈路 tokens/s 增幅 Qwen3.5 397B 42.3 48.1 13.5% DeepSeek V4 Flash 48.3 53.9 11.6% MiniMax M2 AWQ 123.4 124.2 0.6%
結果很清楚,雙鏈路只會改善被節點通訊限制的模型,Qwen3.5 與 DeepSeek 的吞吐量分別增加約 13.5% 與 11.6%,MiniMax M2 幾乎沒有變化,代表它在這組設定下的主要瓶頸不在互連。
這組數字也不能直接拿來比較模型聰明程度,三者的量化格式、啟用專家數、上下文與模型大小都不同,MiniMax 速度最快,不代表回答品質最高,Qwen3.5 能用 262K 上下文啟動,DeepSeek V4 Flash 能用 500K 上下文啟動,這些容量優勢本身就是雙機部署的重要價值。
本地部署和 API 到底怎麼選
設備畫面標示單台價格為台幣 20 萬元,兩台還要加上高速線材、交換器、儲存與維護成本,若每月只是少量使用,雲端 API 很可能更划算,若每天持續分析大量影像、處理敏感文件、需要固定延遲,或模型呼叫量足以抵銷硬體成本,本地部署才有機會回本。
我比較在意的是混合部署,一般聊天與高難度推理交給雲端模型,持續監控、文件整理、影像理解與私有資料處理留在本地,這比要求一套設備取代所有 API 更務實,推理框架的選擇也會直接影響吞吐量,可以延伸閱讀 vLLM、SGLang、llama.cpp、MLX 與 Ollama 比較 。若手上已經有 DGX Spark,也可參考 DGX Spark 搭配 llama.cpp 的部署筆記 。
JoyAI-VL-Interaction 不只是看圖問答
JoyAI-VL-Interaction 是京東 JoyAI 團隊開源的即時視覺語言互動模型。它採 8B 級規模,真正特別的地方不是再回答一張圖片裡有什麼,而是持續觀看直播流,自己判斷現在應該開口、保持安靜,還是把困難工作交給背景 Agent。
一般 VLM 是回合制。使用者先問,它才回答。JoyAI 把行動時機訓練進模型,每秒做一次決策。火爐上的鍋開始冒煙、運動員出現關鍵動作、商店貨架少了一項商品,都不必等人先提出問題。這讓它更接近監控助手、直播解說員與現場操作夥伴。
決策 輸出 適合情境 保持安靜 silence 畫面沒有重要變化,避免持續打擾 直接回應 response 加文字 即時提醒、解說、計數與操作指引 委派工作 delegate 加任務 需要搜尋、推理、程式或外部 API 的複雜問題
官方公開超過 400 萬筆時間對齊的視覺互動樣本,並用強化學習調整說話時機,系統以約 1 fps 接收影像,把短期畫面、問答紀錄與長期記憶一起交給 VLM,每累積一段畫面就壓成摘要,再把多段摘要整理成長期記憶。
這種架構很適合長時間串流,但仍要注意 token 成本,官方把 AdaCodec 描述為只對重要變化保留完整細節的預測式視覺編碼方向,實際部署時要確認目前下載的模型與服務版本是否已啟用對應能力,不能只看架構圖就當成預設功能。
JoyAI 可以做什麼
居家安全 :觀察煙霧、跌倒、危險區域與幼兒動作,在需要時主動提醒。體育與直播 :即時解說、關鍵事件判斷、計數與彈幕式評論。零售與操作引導 :辨識貨架、產品與手機介面變化,逐步帶使用者完成任務。RTSP 監控 :接入網路攝影機,讓視覺模型持續理解而不只是傳統動作偵測。企業背景 Agent :把需要查資料或產生報告的工作交給 Codex 或其他 API,同時不中斷眼前的畫面監看。
官方在 26 個離線理解基準的平均分數為 57.53,高於 Qwen3-VL-8B-Instruct 的 54.16。這不代表它在所有聊天問題都勝過大型閉源模型。它真正的優勢區,是視覺觸發的主動性、回應時機、時間感與長串流記憶。若想了解另一種文件與 OCR 導向的 VLM,可參考 InternVL3 本地多模態整理 。
JoyAI 完整部署命令
官方目前建議 Linux、NVIDIA GPU、CUDA 12.x、535 以上驅動與 Python 3.12。先從最小服務開始,確認視覺推理和 WebUI 能正常工作。
git clone https://github.com/jd-opensource/JoyAI-VL-Interaction.git
cd JoyAI-VL-Interaction

./install/install.sh --with-all
./install/download-models.sh --all

./services/scripts/run.sh minimal
啟動後在瀏覽器開啟以下網址。第一次使用會遇到自簽憑證提示,僅在確認是自己的主機後繼續。
https://127.0.0.1:8099若需要語音輸入、語音輸出與背景 Agent,可以啟動完整服務。
./install/install-audio-runtime.sh --all
./services/scripts/run.sh all
完整系統預設把主 VLM 放在 GPU 0,摘要模型放在 GPU 1,ASR 與 TTS 放在 GPU 2。兩台 EdgeXpert 比較適合先跑最小服務,再把 ASR、TTS 或背景 Agent 改接另一台主機或外部 API。若把所有服務硬塞進同一組節點,記憶體餘裕與即時延遲都要重新測量。
需要完整語音體驗時,JoyAI 預設可搭配 Qwen3-ASR 1.7B 與 Qwen3-TTS 1.7B。想先了解本地聲音設計與 TTS 部署,可閱讀 Qwen3-TTS 音色設計與本地工作流 。
把雙機分工用在 JoyAI
雙機不一定要只跑一個超大模型。對即時視覺系統來說,服務分工可能更有效率。
節點 A :JoyAI 主視覺模型、WebUI、攝影機或 RTSP 輸入。節點 B :摘要模型、ASR、TTS、向量資料庫與背景 Agent。高速鏈路 :交換畫面摘要、長期記憶與委派結果,不必讓每一層模型張量都跨節點。雲端補位 :只有複雜推理與大型搜尋才呼叫 API,平常監看留在本地。
這種拆法不會得到 256GB 的單一權重空間,但可減少模型並行的同步成本,讓即時互動更穩定。若目標是部署 284B 或 397B 權重,才改用跨節點模型並行。先定義工作負載,再決定是合併記憶體還是拆分服務。
隱私與維運不能省略
JoyAI 會持續接收相機與麥克風資料,本地部署能降低內容離開內網的機率,但不代表自動安全,WebUI、OpenAI 相容 API、RTSP、背景 Agent 與檔案權限都要分別控管。不要把服務連接埠直接暴露到公網,也不要讓背景 Agent 在沒有確認的情況下執行刪除、付款或外部發布。
模型判斷也會出錯。居家安全、工廠告警與醫療照護不能只依賴單一 VLM,重要事件應保留傳統感測器、規則引擎、人工複核與完整日誌。開放權重帶來可控性,也把測試責任交回部署者。
我的判斷
EdgeXpert 雙機最吸引人的不是把 tokens/s 翻倍,而是用 256GB 級統一記憶體打開大型 MoE、超長上下文與私有化多模態服務。雙 200GbE 對通訊密集模型確實有幫助,但 0.6% 到 13.5% 的差異也提醒我們,瓶頸可能在記憶體頻寬、模型計算、量化核心或排程。
JoyAI 更像這類硬體的合理應用,它不只等待問題,而是長時間留在場景裡,知道何時說話、何時安靜、何時交給另一個 Agent,真正值得做的不是把所有模型都搬回家,而是把持續、敏感、可重複的工作留在本地,把偶發而困難的任務交給更強的雲端模型。
參考資料
FAQ
兩台 EdgeXpert 會讓推理速度變成兩倍嗎?
不會。雙節點主要增加可用記憶體與併發空間。實測中雙鏈路讓 Qwen3.5 增加約 13.5%,DeepSeek V4 Flash 增加約 11.6%,MiniMax M2 只增加約 0.6%。
JoyAI 一定要三張 GPU 嗎?
最小服務只需要主視覺模型與 WebUI。官方完整預設才會把主模型、摘要模型、ASR 與 TTS 分配到三張 GPU。資源較少時可停用語音與背景 Agent,或把它們接到其他服務。
JoyAI 和一般 VLM 最大差異是什麼?
一般 VLM 多半等使用者提問。JoyAI 持續觀察即時畫面,每秒自主決定保持安靜、直接回應或委派任務,適合監控、直播、操作引導與長時間互動。
本地 AI 一定比雲端 API 便宜嗎?
不一定。低用量通常是 API 更便宜。本地部署適合高頻使用、敏感資料、固定延遲與需要客製化服務的人。評估時要把硬體、電力、儲存、網路與維護時間全部算進去。
by Rain Chu 7 月 14, 2026 | AI , QWEN , 模型
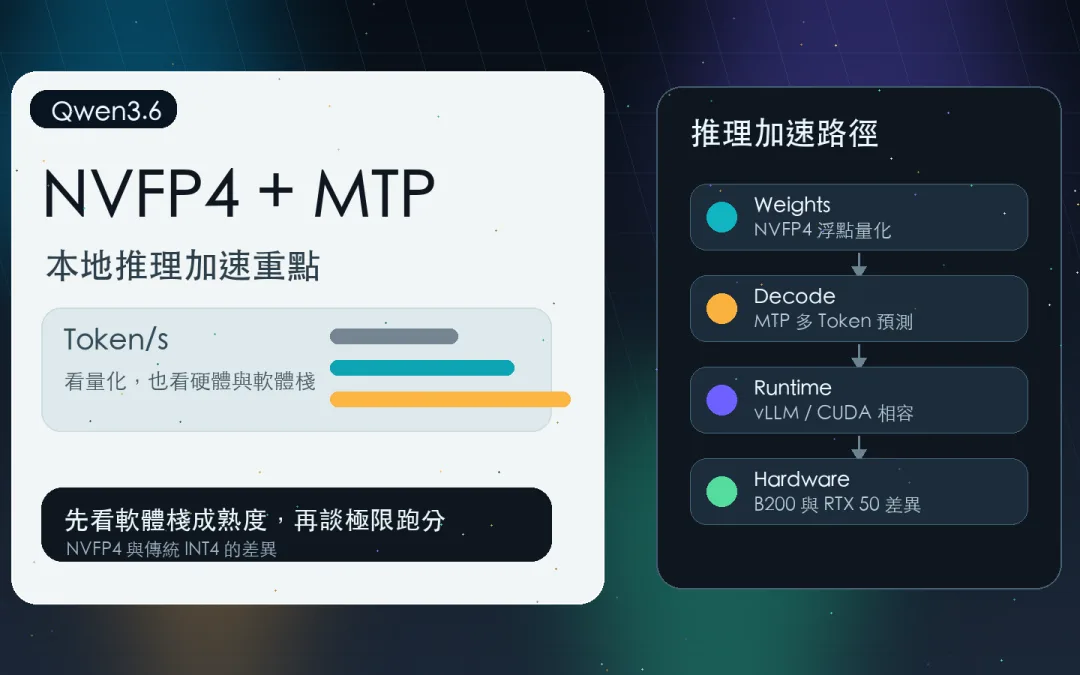
NVFP4 和 MTP 最近被放在一起討論,原因很簡單:本地大模型推理開始從「能不能放進顯存」進入「怎麼把記憶體搬運成本壓到最低」的階段,Unsloth 釋出的 Qwen3.6 NVFP4 quants 主打 27B 模型可在 24GB VRAM 上運行,35B-A3B 在 B200 上可達 17,561 tok/s,並宣稱相對 NVIDIA NVFP4 quant 有 2.5 倍速度提升。
這些數字很吸引人,但不能直接翻譯成「買 RTX 5090 就一定變快」。真正該看的,是 NVFP4 和 INT4 的格式差異、MTP 如何降低推理瓶頸,以及消費級 Blackwell 現階段為什麼可能吃不到企業級 B200 的完整紅利。
先講結論
NVFP4 是 4 位元浮點量化,不是傳統 4 位元整數量化
INT4 的刻度固定,NVFP4 的浮點表示更適合保留權重動態範圍
MTP 是多 Token 預測,重點是減少每個 token 都重新搬一次權重的浪費
17,561 tok/s 是特定企業級硬體條件下的吞吐量,不是一般 RTX 50 的保證值
企業部署時,驅動、CUDA、vLLM、llama.cpp、環境變數和自動更新都可能比模型本身更容易出事
如果你之前看過我整理的 Qwen 3.6、MXFP8、NVFP4 比較 ,這篇可以當成補充版,前一篇偏選型,這篇偏底層原因和部署風險。
NVFP4 和傳統 INT4 差在哪
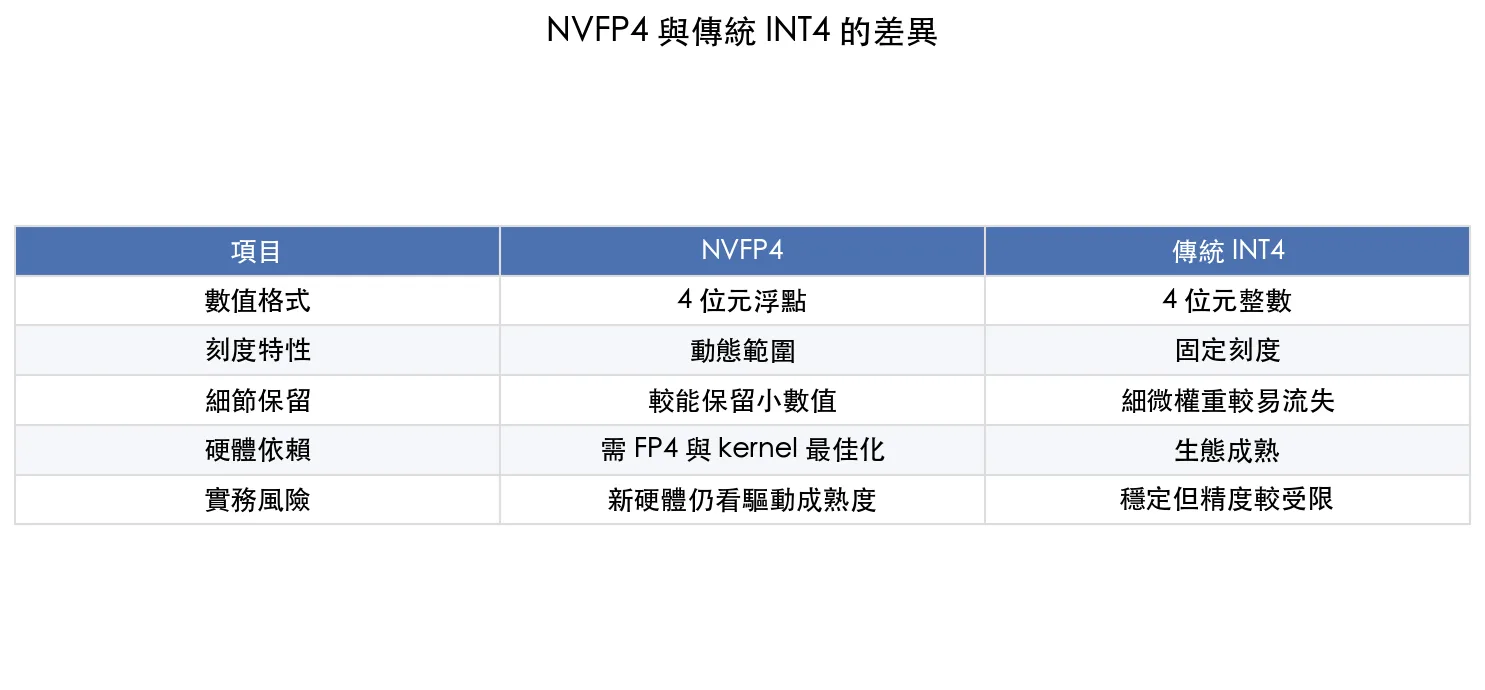
INT4 是 4 位元整數量化。你可以把它想成一把固定刻度的尺,每一格距離都一樣。問題是神經網路權重分布通常不是均勻的,很多重要數值會擠在接近零的位置,也會偶爾出現比較大的極端值。固定刻度很省空間,但容易犧牲細微權重差異。
NVFP4 則是 4 位元浮點量化,它仍然只用 4 位元,但用浮點格式表達數值,能用有限 bit 描述更大的動態範圍,小數值區域可以保留比較細的變化,大數值區域則用比較寬的範圍表示,這就是為什麼 NVFP4 在某些模型上可以比傳統 INT4 更接近原始權重的行為。
項目 NVFP4 傳統 INT4 數值格式 4 位元浮點 4 位元整數 刻度特性 動態範圍 固定刻度 細節保留 較能保留小數值 細微權重較易流失 硬體依賴 需要 FP4 支援與 kernel 最佳化 生態成熟 實務風險 新硬體仍看驅動成熟度 穩定但精度較受限
這裡要補一個很重要的判斷:NVFP4 不是自動贏 INT4。若硬體、驅動、kernel、推理框架都沒有最佳化,NVFP4 可能反而更慢。格式更先進,不代表你手上的卡和軟體棧已經準備好了。
MTP 為什麼會讓速度暴衝
MTP 是 Multi-Token Prediction,也就是多 Token 預測。傳統自回歸語言模型通常一次產生一個 token。每產生一個 token,都要讀取大量模型權重,再做一次運算。對大模型來說,很多時間不是花在純計算,而是花在權重從顯存搬到運算核心的路上。
MTP 的核心思路,是在一次權重讀取裡嘗試預測多個後續 token。它不是讓模型魔法般跳過推理,而是把原本每一步都要重複付出的記憶體傳輸成本攤薄。當瓶頸主要在顯存頻寬和權重搬運時,這種方式就能明顯提高吞吐量。
Reddit 原始討論裡也有人問 MTP 是否已加入,Unsloth 相關回覆指出 MTP 已經在裡面,並且有說法提到 MTP tensors 已直接內建到 quants 中。這表示使用者不只是拿到一個 NVFP4 量化權重,而是拿到帶有 MTP 加速路徑的版本。
2.5 倍速度提升要怎麼看
這次最容易被誤讀的是「2.5 倍」。Reddit 討論中有人問這個速度提升是不是相對 Q4,Unsloth 回覆脈絡指出,這個比較是相對 NVIDIA 的 NVFP4 quant,而不是拿所有 Q4 或 INT4 實作一起比較。這一點很重要,因為不同量化格式、不同框架、不同 GPU、不同 batch 和 context 設定,都會影響 token/s。
另外,35B-A3B 達到 17,561 tok/s 的數字是在 B200 這類企業級硬體條件下出現。這可以說明 NVFP4 和 MTP 的上限很高,但不代表一般 RTX 50 系列能直接複製。企業採購或本地部署,最怕把資料中心卡的極限數字誤當成桌機卡的常態表現。
為什麼 RTX 50 可能反而沒有變快
同樣叫 Blackwell,不代表所有 Blackwell 都一樣。B200 屬於資料中心路線,軟體路徑和底層 kernel 通常優先被最佳化。RTX 50 消費級卡雖然也有新架構能力,但 SM120 的軟體支援成熟度可能還沒跟上。
Reddit 討論中有人提到,消費級 Blackwell 的 NVFP4 利用率仍可能不理想,也有人實測 NVIDIA NVFP4 Qwen3.6 27B 對比原本 INT4 時,token 生成速度不但沒有提升,還有下降的案例。這些不是說 NVFP4 沒用,而是說「硬體支援」和「軟體真的最佳化」中間有一段距離。
如果你正在看 RTX 5090、5080 或 5060 Ti 類配置,不要只看 NVFP4 四個字。你要確認推理框架是否真的支援你的 GPU、驅動和 CUDA 是否符合要求、實際模型是否有對應 kernel,還要看你的工作負載是 prompt processing 重,還是 token generation 重。
企業部署最容易踩到的不是模型,而是環境
這類極限加速模型最怕直接上正式環境。逐字稿和社群討論都提到一個共通風險:推理框架和底層格式更新太快,vLLM、CUDA、驅動、模型權重、環境變數任何一層沒對上,都可能變慢甚至崩潰。
我會把部署流程拆成四步。第一步先在單機沙盒測模型能不能正常跑。第二步測固定 prompt、長上下文、工具調用和 agent loop。第三步鎖定版本,關掉正式環境自動更新。第四步再進入內部 PoC。這和我之前整理的 本地大模型推理框架選型 是同一個邏輯,速度只是其中一個指標,穩定性才決定能不能上線。
正式環境不要開自動更新
先鎖定 CUDA、driver、vLLM 或 llama.cpp 版本
不要把 B200 benchmark 直接套到 RTX 50 採購決策
工具調用和 agent 流程要單獨壓測
用 24GB VRAM 跑 27B 可以測,但不代表企業就一定該選最大模型
為什麼 9B 和 GGUF 反而更實用
當大家看到 27B 可塞進 24GB VRAM,甚至 35B-A3B 跑出極限吞吐量,很容易以為模型越大越好。但真正落地時,很多企業只需要工單分類、客服輔助、內部文件查詢、簡單自動化。這些任務未必需要 27B 或 35B。
9B 模型的價值在於部署門檻更低,可以放進 12GB 或 16GB 顯卡,還能保留更多 VRAM 給上下文和工具調用。GGUF 則讓 llama.cpp 這類本地推理路線更容易接上 CPU 或低階硬體。這也是為什麼社群一邊討論 17,561 tok/s,一邊仍然敲碗 9B 和 GGUF 版本。
對中小企業來說,我會優先問三個問題。你的資料是否需要完全本地化,你的任務是否真的需要大模型,你是否有能力維護最新 GPU kernel 和推理框架。如果答案不明確,小模型加穩定部署,通常比追逐極限跑分更務實。
我的判斷
NVFP4 和 MTP 很重要,因為它們代表本地 AI 推理正在處理真正的瓶頸:顯存容量、權重搬運、吞吐量和模型品質之間的平衡。NVFP4 解決的是低 bit 量化下如何保留更多數值動態範圍,MTP 解決的是一次只吐一個 token 帶來的記憶體傳輸浪費。
但我不會把它解讀成「RTX 玩家立刻起飛」。比較健康的看法是:資料中心硬體已經看到 NVFP4 和 MTP 的上限,消費級硬體還在等軟體棧補齊。現在要採購或部署,應該把 PoC、版本鎖定、框架支援和真實任務測試放在跑分前面。
真正值得期待的是,這些技術成熟後,27B 不再只能放在機房裡,9B 和 GGUF 也能讓更小的團隊取得足夠好用的本地 AI。極限跑分很好看,但真正改變企業日常的,通常是穩定、便宜、好維護的那一條路。
延伸資源
FAQ
NVFP4 是什麼?
NVFP4 是 NVIDIA 4 位元浮點量化格式。它和 INT4 一樣節省記憶體,但用浮點方式表達數值,較適合保留神經網路權重中的動態範圍。
NVFP4 和 INT4 最大差異是什麼?
INT4 是固定刻度的整數量化,NVFP4 是 4 位元浮點量化。前者生態成熟,後者更依賴硬體 FP4 支援和軟體 kernel 最佳化。
MTP 是什麼?
MTP 是 Multi-Token Prediction,多 Token 預測。它讓模型在一次權重讀取中嘗試預測多個後續 token,降低記憶體傳輸瓶頸,提高吞吐量。
by Rain Chu 7 月 11, 2026 | 未分類
本地部署大模型到了 2026 年,問題已經不只是「模型要選哪一個」。同一張顯卡、同一台 Mac、同一個模型,只要推理框架選錯,吞吐量、延遲、顯存使用率和維運成本都會差很多。
這也是為什麼 vLLM、SGLang、llama.cpp、MLX、Ollama 這五個工具會被放在一起比較。它們不是同一類產品的不同包裝,而是對應不同部署場景的五種答案。選對框架,比盲目追更大參數更實際。
先講結論
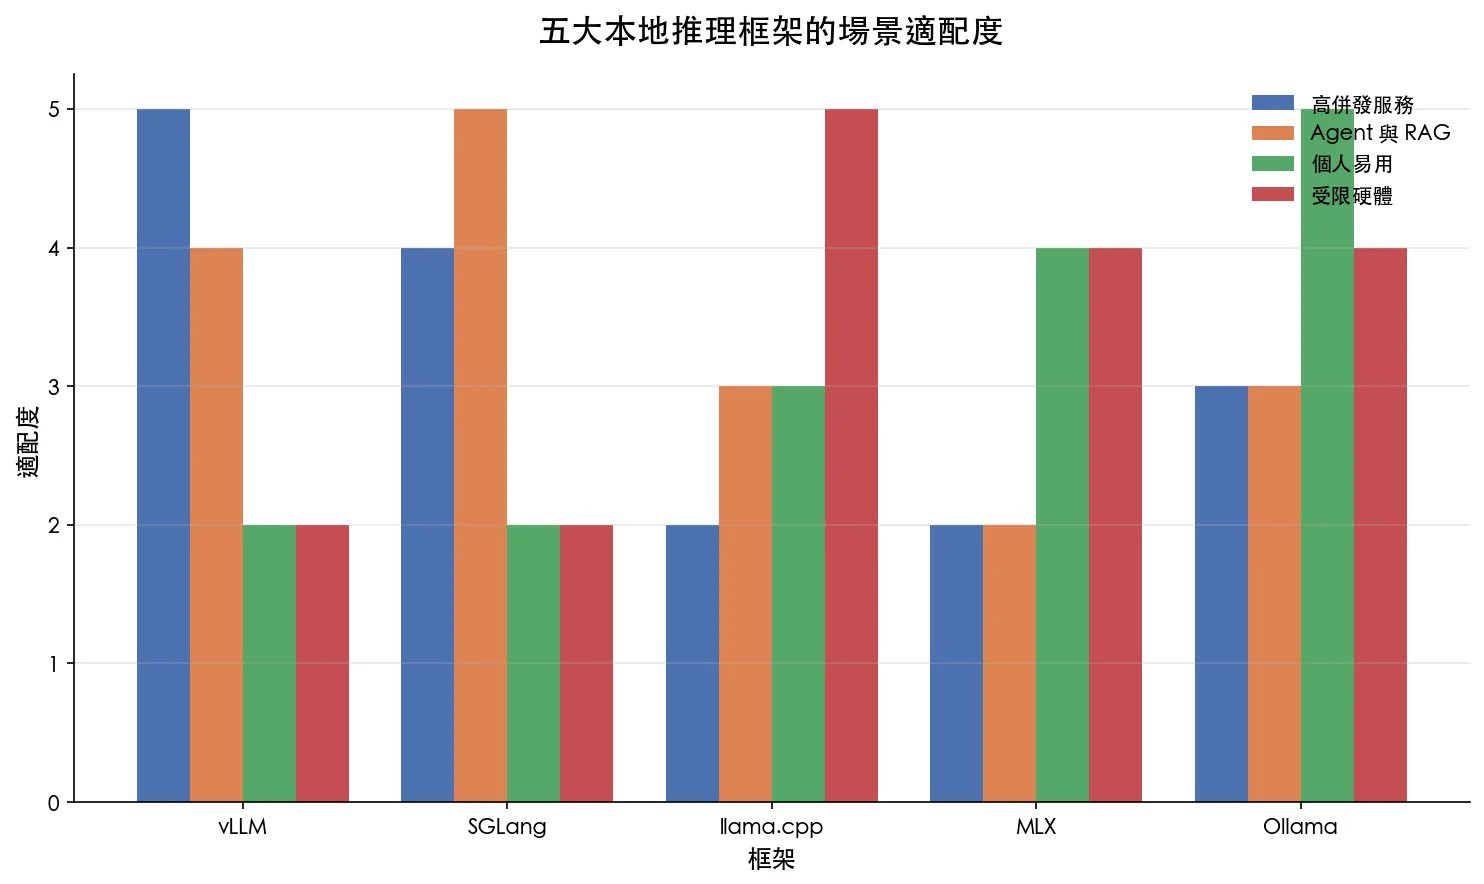
如果你要做高併發 API 服務,先看 vLLM。如果你在做 AI Agent、RAG、多輪工具呼叫,SGLang 很值得研究。如果你要跨平台、邊緣設備、低資源環境,llama.cpp 仍然是最靈活的選擇,如果你主要用 Apple Silicon,MLX 是最貼近硬體的路線。如果你只是想快速讓團隊或個人跑起來,Ollama 依然是最省心的入口。
五個框架的定位差異
框架 核心強項 適合場景 不適合情況 vLLM PagedAttention、Continuous Batching、高吞吐 生產 API、多使用者併發、GPU 服務 個人桌機快速試模型 SGLang RadixAttention、KV Cache 重用、結構化輸出 Agent、RAG、多輪對話、JSON 輸出 只想一鍵跑模型 llama.cpp GGUF、生態成熟、跨平台 CPU、邊緣設備、Mac、Windows、Linux、嵌入式 大規模高併發服務 MLX Apple Silicon 統一記憶體最佳化 M 系列 Mac、本地研究、Mac 開發者 NVIDIA GPU 伺服器 Ollama 安裝簡單、模型管理方便、API 友善 個人使用、團隊內部工具、快速 Demo 需要極致吞吐與深度客製
vLLM:高併發服務優先
vLLM 的代表性技術是 PagedAttention,可以把它理解成用作業系統管理記憶體的思路來管理 KV Cache,讓不同長度的請求不會浪費大量顯存,再加上 Continuous Batching,當某個請求完成後,新請求可以馬上進入批次,不必等整批全部結束。
所以 vLLM 最適合放在需要吞吐量的地方,例如公司內部模型 API、客服系統、多人同時使用的知識庫、需要穩定服務層的產品,你如果正在評估顯卡工作站,也可以對照我之前整理的 RTX PRO 6000 Blackwell 選購分析 ,因為推理框架和硬體規格要一起看才有意義。
SGLang:Agent 和 RAG 的效率選擇
SGLang 的重點不只是跑得快,而是能把複雜互動流程裡重複的上下文計算省下來,它的 RadixAttention 對多輪對話、RAG、知識庫查詢、Agent 工具呼叫很有價值,因為這些場景常常有大量共用前綴和重複上下文。
如果你的應用是「使用者問一句,模型答一句」,SGLang 的優勢不一定完全發揮。但如果你要處理多步驟推理、固定系統提示、文件檢索、JSON 格式化輸出,它會比一般推理框架更貼近 Agent 工程需求。
llama.cpp:跨平台與低資源環境的底座
llama.cpp 最大的價值是能跑在很多地方,從 Mac、Windows、Linux,到 CPU-only、小型邊緣設備、GGUF 量化模型,它提供的是一種很穩的本地推理底座,你不一定拿它做高併發生產 API,但它很適合實驗、嵌入式、離線環境、低成本部署。
如果你關心本地離線模型,之前整理過 gpt-oss 本地離線運行 ,那篇的思路也可以放到 llama.cpp 生態來看。
MLX:Apple Silicon 使用者要特別看
MLX 是 Apple Silicon 上很有意思的選擇。M 系列晶片的統一記憶體架構,讓 CPU、GPU 可以更有效率地共享資料,MLX 的價值就在於它不是把 Mac 當成一般電腦硬跑,而是更貼近 Apple 自家的硬體特性。
如果你手上是 Mac Studio、MacBook Pro 或其他 M 系列設備,MLX 適合拿來做本地研究、模型微調實驗、小型推理服務。它不是 NVIDIA 伺服器的替代品,但在 Mac 生態裡,這條路線會越來越重要。
Ollama:最容易讓人開始用
Ollama 的優勢不是極致效能,而是降低使用門檻。安裝、拉模型、切模型、提供本地 API,整個體驗很適合個人、教學、內部工具和快速 Demo。對很多團隊來說,先用 Ollama 把流程跑通,比一開始就追求 vLLM 的生產級架構更務實。
如果你要把 Ollama 放到內網或 AI Server 上,可以看 Ollama 遠端連線教學 。如果你想把開發環境成本壓低,也可以參考 LM Studio 與 Ollama 的零 API 成本開發環境 。
不要只選一個,混合部署更實際
真正成熟的部署,不一定是一個框架包打天下。比較實際的做法是分層:個人和內部 Demo 用 Ollama,Mac 研究環境用 MLX,跨平台和邊緣設備用 llama.cpp,RAG 和 Agent 後端看 SGLang,高併發正式服務再交給 vLLM。
如果你的硬體是 DGX Spark 或其他 AI Server,也可以把 DGX Spark GB10 Ollama 最佳設定 當作入口,再逐步把高併發服務拆到更專業的推理框架。
我的選型建議
個人開發者:先用 Ollama,真的需要跨平台或量化控制,再補 llama.cpp。
Mac 使用者:Ollama 做入口,MLX 做進階研究和 Apple Silicon 最佳化。
企業內部知識庫:先確認 RAG 架構和上下文重用需求,再評估 SGLang。
正式 API 服務:vLLM 是第一優先,特別是多使用者併發和 GPU 成本敏感時。
邊緣設備或離線場景:llama.cpp 的彈性仍然很難取代。
2026 年的本地 AI 部署,重點會從「能不能跑」走向「跑得是否有效率」。模型能力很重要,但推理框架決定了你花出去的硬體成本能不能真正轉成服務能力。選型時不要只看 benchmark,要看你的流量模式、硬體環境、維運能力和未來要不要接 Agent 工作流。
FAQ
本地大模型推理框架要先學哪一個?
一般使用者先學 Ollama,工程師再補 llama.cpp。需要生產服務時,再研究 vLLM 或 SGLang。
vLLM 和 SGLang 差在哪裡?
vLLM 強在高併發吞吐和生產服務,SGLang 更適合多輪對話、RAG、Agent 和重複上下文很多的流程。
Mac 使用者該選 MLX 還是 Ollama?
想快速跑模型先用 Ollama,想深入 Apple Silicon 最佳化和研究實驗,再看 MLX。
llama.cpp 還值得學嗎?
值得。它在 GGUF、量化、跨平台、CPU 和邊緣設備上仍然非常重要,是本地模型生態的底層工具之一。
by rainchu 7 月 31, 2024 | AI , Chat
2024/07 相信 AI 界最火的是 Microsoft 推出的 GraphRAG 了,看起來很簡單,但坑也不少,網路上教學很多,我這邊專門做一集推坑以及救贖的文章
訓練價格過高
用便宜模型 gpt-4o-mini
llm:
  api_key: ${GRAPHRAG_API_KEY}
  type: openai_chat # or azure_openai_chat
  model: gpt-4o-mini
  model_supports_json: true # recommended if this is available for your model.
用 local ollama, vllm, LM Studio
要用 ollama 的話,要先安裝 ollama 的庫
並且用別人已經改好的程式碼
git clone https://github.com/TheAiSingularity/graphrag-local-ollama.git 執行細節可以看
https://medium.com/@vamshirvk/unlocking-cost-effective-local-model-inference-with-graphrag-and-ollama-d9812cc60466
VIDEO
視覺化模型
請下載 Gephi
打開 settings.yaml 並且找到 snapshots 將 graphml 打開,這樣子在 index 的時候就會幫你生成 .graphml 的檔案,之後就可以用 Gephi 去編輯他
snapshots:
  graphml: true
  raw_entities: true
  top_level_nodes: true
參考資料
GraphRAG Github
https://github.com/microsoft/graphrag
近期留言