by Rain Chu | 9 月 25, 2026 | Agent, AI, 模型
Laya 提供了可以在本機執行的開源決策模型,但目前還不足以支持「直接取代 Jev」,在相同的垃圾簡訊與銀行客服分類樣本上,Jev 的準確率較高,Laya 則在 Apple M3 上呈現較短的實際等待時間。
Laya 是什麼?把語意轉成程式可用的判斷
Laya 接收文字或結構化狀態,再依你定義的問題回傳選項、分數或機率。它採用非自回歸架構,經由編碼器理解輸入,再由決策頭評估候選答案,省去逐字生成回答與解析自由文字的步驟。
可以用一張客服單理解三種題型:
choice 判斷要分給帳務、技術還是業務,score 依事先描述的等級評估急迫性,noul 回傳「客人是否明確要求退款」這類命題成立的機率。
這與 TypeSafe 的 System One 設計有相近的工作分工,需要分類、分流與檢查時使用決策模型,需要撰寫回覆時再接生成模型,想先了解實際如何串接,可以參考 Jev 的五個工作流場景。
Laya 英文模型卡列出的基礎版本採用 ModernBERT-large,總參數量約 4.21 億,權重採 Apache 2.0 授權。
另有多語言與 typed-decisions 等 checkpoint。這次受測的是英文基礎版,沒有為這兩份評測資料另外微調,不能把其他版本的分數直接套過來。
Laya 的 開源專案也提供相容 Jev 請求形狀的介面,能降低改接服務的工作量。
這次比較怎麼做?先把版本與條件固定
依 公開評測紀錄,Laya 測試日期為 2026 年 9 月 23 日,使用 Laya 0.3.11、英文 convaiinnovations/laya checkpoint,以及 Apple M3 的 MPS 加速。Jev 沿用 9 月 20 日透過 OpenRouter 取得的 jev-1.13 原始回答,兩者並非同一時間重新呼叫。
- SMS Spam:200 則英文簡訊,其中 27 則垃圾訊息、173 則正常訊息。
- Banking77:462 則英文銀行客服訊息,77 個意圖各取 6 則。
- 兩邊使用相同的樣本 ID、輸入狀態、正確答案與題目設定,再由同一份評分程式計算結果。
- Laya 在本機逐筆執行,Jev 走雲端服務。延遲反映這兩條實際執行路徑,並非相同硬體下的模型速度測試。
核對資料時,官網已列出 0.3.20 的更新內容,下文數字應視為 0.3.11 英文基礎版的固定評測,不是對所有新版本、所有語言或微調模型的總排名。
範例一:垃圾簡訊二分類,84% 準確率該怎麼看?
這個任務只問一件事:簡訊是不是垃圾訊息。評分程式把 noul 大於或等於 0.5 的回答判成垃圾訊息,再與資料標籤比較。Jev 答對 193 則,Laya 答對 168 則。
| 任務 | 模型 | 答對 / 樣本 | 準確率 | Macro F1 |
|---|
| SMS Spam | Jev | 193 / 200 | 96.5% | 0.926 |
| SMS Spam | Laya | 168 / 200 | 84.0% | 0.759 |
| Banking77 | Jev | 377 / 462 | 81.6% | 0.806 |
| Banking77 | Laya | 183 / 462 | 39.6% | 0.346 |
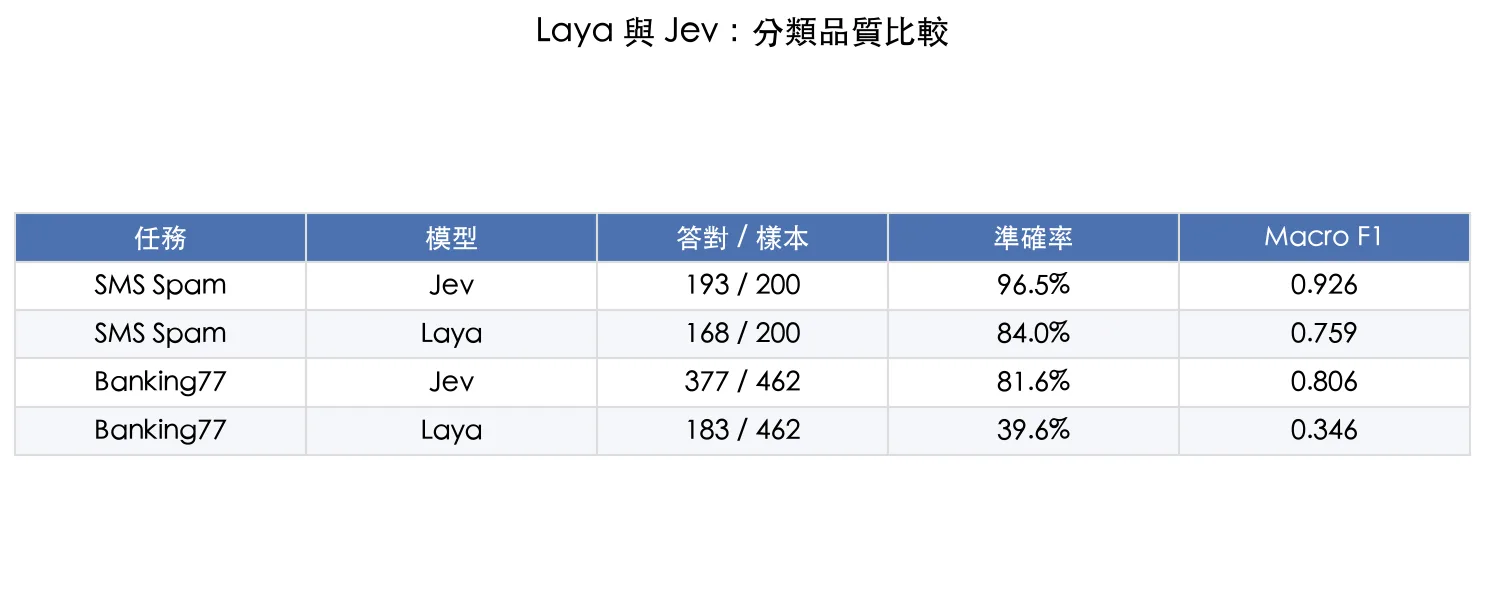 資料:01Coder 公開評測,Laya 0.3.11 英文基礎版。本文已由原始回答重新核算答對筆數與 Macro F1。
這裡不能只盯著 84%。因為正常簡訊佔 173 / 200,若把全部訊息都判成正常,準確率也有 86.5%。這是依樣本比例計算的簡單基準,說明類別不平衡時,整體準確率可能掩蓋模型對少數類別的處理能力。
原始錯誤也不是完全重疊:29 則只有 Jev 答對,4 則只有 Laya 答對,另外 3 則兩者都錯。這顯示 Jev 在這份樣本上整體較好,但仍有值得回頭檢查的個別案例,不能把任何一方當成永遠正確的裁判。
範例二:Banking77 的 77 選 1,差距為什麼變大?
Banking77 資料集把銀行客服需求拆成 77 個意圖。這組測試的任務,是從所有候選意圖裡直接選出一個。Jev 答對 377 / 462,Laya 答對 183 / 462,Macro F1 也從 Jev 的 0.806 降到 Laya 的 0.346。
候選答案多,不只增加選擇難度,也會消耗描述選項的空間。依官方目前的限制說明,英文 Laya 的選項提示預算 head_max_len 預設為 192 tokens,所有選項必須共享這段空間。當相近的分類名稱與描述被裁短,模型可能失去區分它們的重要文字。
官方提醒,有簡短描述的選項增加到大約 20 個後,就應留意預算與裁切。20 不是所有請求通用的硬性上限,實際影響取決於指令、標籤長度與 checkpoint。77 選 1 已超出建議的使用範圍,因此這個結果同時反映任務難度與目前設定的限制。
分成兩層分類,是可以驗證的改法
一種改法是先把候選答案縮到幾個大類,再在選中的大類裡做細分。以概念示例來說,先分出「卡片」「轉帳」「現金提領」「帳戶」,再於卡片類別中辨認啟用、遺失或付款問題。這樣每一步需要容納的描述較少。
這個策略值得測試,但本文引用的 77 選 1 成績不是兩階段分類的成績。第二層也會受到第一層錯誤影響,所以要評估完整流程的最終分類準確率、兩次呼叫的總延遲,以及無法判斷時的回退方式。不能只拿第一層大類的分數宣稱問題已解決。
Laya 比較快嗎?先分清楚本機等待時間與模型速度
| 任務 | Jev p50 | Laya p50 | Jev p95 | Laya p95 |
|---|
| SMS Spam | 447 ms | 50 ms | 922 ms | 66 ms |
| Banking77 | 432 ms | 294 ms | 658 ms | 354 ms |
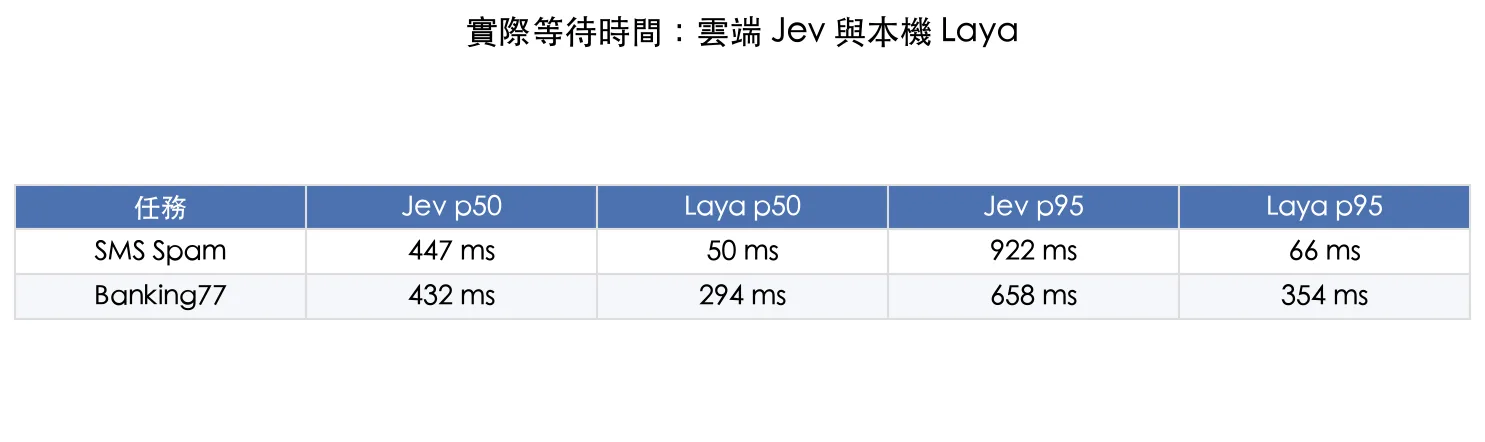 同一公開評測的觀察值,單位為毫秒。Jev 經網路呼叫,Laya 在 Apple M3 本機 MPS 執行,不能當成純模型速度比。
p50 是中位數,p95 反映較慢端的等待情況。在這台電腦與這批請求上,Laya 的兩項數值都較低,但差距會隨任務改變。垃圾簡訊的 p50 為 50 毫秒,77 類銀行意圖則上升到 294 毫秒,說明「一次前向運算」不代表任何問題都花相同時間。
更精確地說,銀行客服的原始請求同時包含 77 類 intent 與 10 類 group 兩個獨立問題,所以表中的延遲是整次請求的耗時。這與先取得大類、再縮小選項進行第二次呼叫的分層分類不同,兩者不能混為一談。
這些數字也不能涵蓋首次下載與模型載入。常駐服務可以攤平啟動成本,偶爾才執行一次的工具則可能更在意冷啟動。重新測試時,應把啟動、單筆延遲、批次吞吐量與尖峰等待分開記錄。
本機執行能減少推論時把輸入交給外部服務的需要,但「沒有逐次 API 費用」仍要加上硬體、電力與維護成本。若系統還會使用雲端備援或外部工具,資料流向也要一起看,這與 本機 AI 與雲端分流的取捨有直接關係。
信心值與微調,不能省略的兩個驗收環節
信心值很高,只能描述模型如何分配機率,不能直接當成答案正確的保證。公開評測特別記錄,0.3.11 在 11 個以上選項時會限制溫度,回傳的信心值也未完成相應校準,因此這次沒有拿 77 類任務做可直接比較的信心門檻結論。
如果原本 Jev 設定某個門檻就自動處理,換成 Laya 時不能只保留相同數字。應用自己的已標註資料檢查:門檻提高後,剩下多少案件能自動處理,其中又有多少判錯。選擇門檻的依據,應是可接受的錯誤與覆蓋率。
另一方面,基礎 checkpoint 能直接接受新題目,不等於在任何領域都已經可靠。Laya 官方同時提供微調方向,且承認基礎版在部分工作流測試中表現有限。用自己的領域資料訓練,可能改善結果,但必須留出沒有參與訓練的測試資料。
微調、蒸餾與量化處理的是不同問題。如果要用較強模型產生教學訊號來訓練小模型,可以延伸閱讀 模型蒸餾與本地部署的差異。不能只因為模型變小、能在本機跑,就推論判斷能力等同原服務。
想試 Laya,先從一個可驗收的任務開始
- 先選標準清楚、選項不多的任務,例如把客服單分到幾個部門,並保留其他或資訊不足的處理方式。
- 建立代表真實需求的標註集,涵蓋常見、少見與容易混淆的案例。同時比較簡單規則、Laya 與目前採用的服務。
- 記錄 checkpoint、套件版本、題目文字、選項描述、裝置與推論設定,讓數字可以重現。
- 先找出錯誤集中在哪些分類,再判斷要改題目、縮短選項、分層分類或微調。一次改一個主要因素。
- 把正確率、各類別表現、誤判成本與整條流程的延遲一起驗收,再決定哪些判斷可以自動處理。
如果要重現這次比較,可從 完整評測目錄取得樣本、題目、原始回答與評分程式。只想核對現有數字時,先讀保存的 runs 與 reports 即可。要重跑模型,再依 LAYA.md 的鎖定環境操作,並確認是否沿用了舊結果檔,避免把跳過已完成項目的續跑誤認為新的全量測試。
Laya 與 Jev 常見問題
Laya 可以直接取代 Jev 嗎?
介面相容有助於改接,但不能保證判斷品質相同。在這次 662 筆英文樣本中,Jev 的準確率較高,Laya 的本機延遲較低,是否替換仍需用自己的任務驗收。
Laya 一定要微調才能使用嗎?
基礎 checkpoint 可以直接接受新題目,但可執行不代表準確度足夠。先測原始模型,若錯誤超出需求,再評估題目設計、分層分類或領域微調。
Laya 最多只能選 20 個類別嗎?
約 20 個是官方對預設選項預算的實務提醒,不是固定上限。指令和標籤長度都會影響裁切,候選類別很多時,應檢查預算並測試縮小候選集合的方法。
這次測試能代表 Laya 的中文能力嗎?
不能。受測的是英文基礎 checkpoint 與兩份英文資料集。中文工作應選適合的 checkpoint,另用中文標註資料驗證,不能沿用這裡的準確率。
選擇的依據,是你的任務能不能通過驗收
這次結果支持一個務實的起點:把 Laya 當成可自行部署、值得針對固定任務調整的決策元件。需要大量細分類、又希望直接使用預設設定時,這份測試裡 Jev 的表現較好。先挑一個明確任務做完整驗收,再決定是否替換或混合使用,會比只看「開源平替」四個字更有幫助。
by Rain Chu | 9 月 25, 2026 | AI, claude, 程式開發
Claude Opus 5.5 值得關注的地方,是把需求轉成可操作作品的能力。
同樣交給 AI 一段描述,成果可以是動畫、原生 App、可走進去的 3D 房屋,也可以是帶有武器切換與戰鬥互動的遊戲。真正要問的,是這些作品做到哪裡,以及哪些地方仍需要人檢查。
這次整理把公開案例分成動畫、應用程式、空間、遊戲、介面與機械六個方向。
Opus 5.5、Claude Code、Claude Design,分別負責什麼?
Anthropic 於 2026 年 9 月 22 日推出 Claude Opus 5.5,官方 Claude Code 文件說明了這些操作能力,單純在聊天視窗請模型寫一段程式,與讓它在完整專案裡編譯、測試,是不同的工作方式。
Claude Design則偏向視覺設計與互動原型,它適合探索頁面、版型和設計方向,但畫面上的按鈕可以切換,不代表會員、金流、資料庫與部署已經接好。選工具前,先決定要的是設計提案、可執行專案,還是正式服務。
動畫案例:蝴蝶、水墨與中子星,要分別驗收
蝴蝶生命週期:連續動作比單張漂亮畫面更重要
蝴蝶案例串起卵、幼蟲吃葉成長、結蛹、羽化與展翅飛行,成蝶剛離開蛹時,翅膀仍處於折疊狀態,之後才逐步展開,這種任務同時考驗形態變化與時間節奏,不能只看某一幀像不像蝴蝶,若用於教學,還要檢查各階段的順序與說明是否正確。
需求可以寫成「每個階段停留到足以辨認,再進入下一段,提供暫停與重播」。這比只要求畫面華麗更容易驗收,也能讓模型把時間軸與互動控制一起規劃。
國風水墨:觀察暈染與轉場是否連續
水墨案例在 Claude Design 中完成,從墨色在宣紙上暈染開始,接著帶出層疊山脈、日輪、飛鳥、水面與小船,再轉到荷葉荷花、梅樹,最後以多色墨跡旋轉交織收尾。它把抽象風格落到連續的動態規則,包含擴散速度、留白、筆觸密度與前後景層次。
要延伸成品牌片或教學動畫,可以先做一小段品質樣本,再擴充完整分鏡。站上的Claude Code 與 Remotion 動畫工作流提供了分鏡、工具分工與逐幀檢查的方法,適合把一次展示整理成可重複修改的製作流程。
中子星:視覺化與物理模擬是兩種交付
另中子星動畫展示,透過自動播放與不同角度呈現天文題材。這段口述的模型名稱與全片主題不完全一致,因此本文只把它當成視覺化題材示例,不作單獨的版本比較依據。若要作為科學教材,還須說清楚哪些是示意,哪些參數有資料依據,畫面有說服力並不會自動證明物理模型正確。
原生 App:macOS 音樂播放器與 iOS 背單字工具
macOS 音樂播放器:介面之外,播放流程才是重點
音樂播放器案例採取接近 Apple Music 的介面方向,在 Xcode 開啟專案後執行,展示匯入音樂、播放、暫停與調整音量,也能建立播放清單、瀏覽歌曲、專輯與歌手,並叫出迷你播放器。這讓驗收從靜態畫面進一步走到檔案與媒體操作。
如果要延伸成日常使用的工具,我會再檢查取消匯入、無法辨識的檔案、重複歌曲、播放進度與重新啟動後的資料保留。這些都是下一步的驗收項目,不能因為正常播放一次,就推定全部都已完成。
3D 房屋:從平面圖走進空間,也要檢查還原程度
把一張平面圖轉成能探索的三維房屋,是這組案例很直觀的亮點。操作包含切換一樓與二樓俯視圖,再進入屋內探索客廳、臥室、廚房、洗手間與書房。門會在靠近與離開時自動開關,也能沿樓梯上樓,從臥室走到陽台。
我會把驗收拆成兩部分。第一部分是空間對應,房間的位置、連通關係與樓層是否符合原圖。第二部分是互動,能不能正常進出、是否穿牆、樓梯是否可走。建模結果適合空間溝通或概念展示,不能直接視為具有尺寸與結構驗證的施工模型。
Claude Design:鍵盤詳情頁與宇宙探索 App 原型
鍵盤詳情頁:漂亮版型要能支持產品資訊
鍵盤產品頁展示不同視覺方向,包含深色主題,用產品圖像、留白與版面安排呈現較俐落的風格。若要從設計展示變成電商頁,還要確認規格、選項、價格與購買路徑,並測試手機版是否仍容易操作。
可以搭配Claude Code 網站製作工作流,把設計方向、元件、動效與正式網站需求分開規劃,減少外觀已完成、功能仍空白的落差。
宇宙探索 App:探索體驗與內容可信度分開檢查
宇宙探索原型提供不同風格,能切換探索、太陽系與星空等頁面,拖曳查看行星,打開木星、地球等天體詳情,並比較行星大小。它展示了導覽與資訊卡片如何串接,但天體數據、比例與描述仍需另行核對,不能把可點擊的原型當成已驗證的天文資料庫。
Claude Opus 5.5 價格:單價降低,不代表每個任務固定省多少
依官方 Opus 價格資訊,標準 API 單價如下。這是按 tokens 計費的價格,不是 Claude 訂閱月費。
| 每百萬 tokens,美元 | Opus 5 | Opus 5.5 |
|---|
| 輸入 | 5.00 | 4.00 |
| 輸出 | 25.00 | 20.00 |
| 快取讀取 | 0.50 | 0.20 |
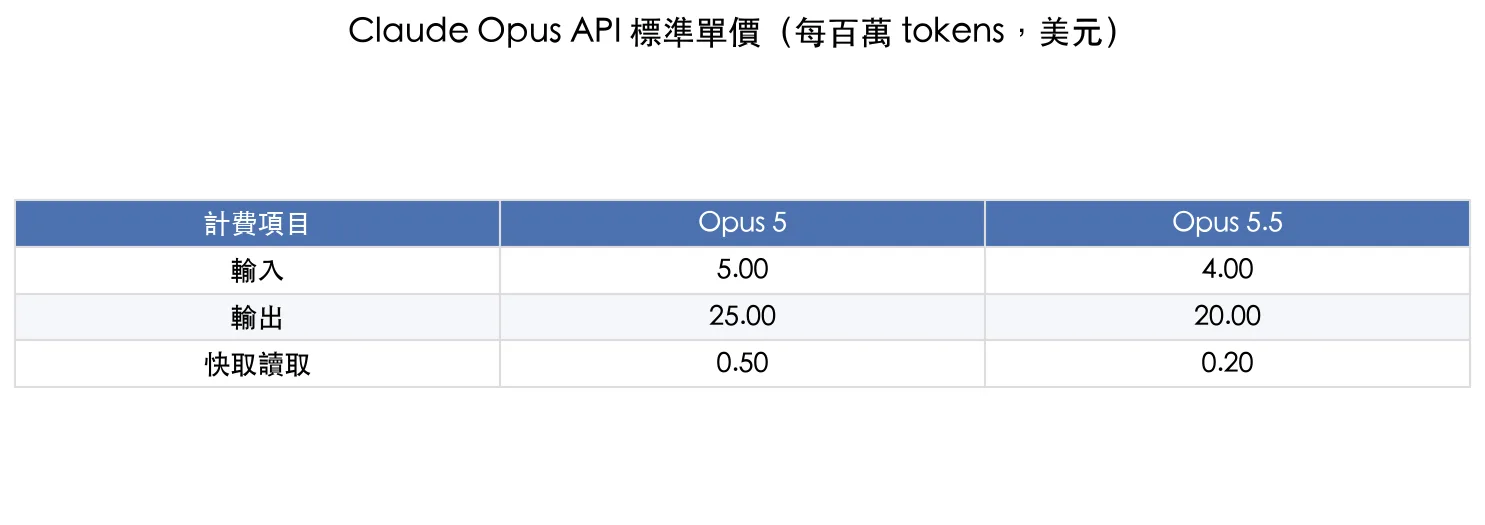 2026 年 9 月 23 日核對的標準 API 單價,不含 Fast mode 或其他服務費用。
任務總成本還取決於輸入量、輸出量、快取命中、重試次數與工具使用。官方對典型工作負載的節省估計,不能直接套用成每個專案的保證。想比較模型,最好給相同需求與驗收條件,同時記錄費用和修改次數。
把案例用到自己的專案:先做一條完整流程
在 Claude Code 中,可依官方模型設定說明指定 claude-opus-5-5。帳號可用性與額度仍以實際介面為準,不要只憑模型自稱的版本判斷是否切換成功。
如果要開始嘗試,可以先選一個範圍小、結果清楚的任務。播放器先完成匯入與播放,單字 App 先完成一輪學習與保存,3D 房屋先完成一個房間與一扇門。把這條流程做對,再增加視覺細節與次要功能。
開工前可先用需求訪談的方式釐清使用者、裝置、資料來源與驗收標準。不要只交付「做得漂亮」,而要列出哪些操作必須成功,以及失敗時應該發生什麼。
專案開始修改前也要留好版本。依Vibe Coding 版本管理方法分階段保存,出現問題才有辦法知道改了哪裡、回到哪一版。模型變強,並不會讓版本管理與驗收失去必要性。
想延伸研究,可從作者的公開 GitHub 專案入口查找相關工具,但不能據此假定本次所有展示都有提供原始碼。重現案例前,應先確認有沒有完整專案、依賴與執行方式。
Claude Opus 5.5 常見問題
Claude Opus 5.5 可以直接做出可上架 App 嗎?
它能協助產生與修改原生 App 專案,但可執行原型和正式上架不同。仍需檢查功能、資料保存、權限、簽署與發行流程。
Claude Code 和 Claude Design 要怎麼選?
要編輯專案、執行工具與測試,可使用 Claude Code。要探索視覺方向和互動原型,可使用 Claude Design。兩者都需要清楚的需求與驗收標準。
Opus 5.5 API 多少錢?
標準 API 每百萬 tokens 的輸入為 4 美元、輸出為 20 美元、快取讀取為 0.20 美元。訂閱方案、Fast mode 與其他服務費用另計。
Opus 5.5 的知識更新到什麼時候?
官方支援文件列出訓練資料截至 2026 年 6 月。即時問題仍應透過可靠來源查證,不能只相信模型自述。
by Rain Chu | 9 月 25, 2026 | AI, Stable Diffusion, 圖型處理, 影片製作, 繪圖
Stable Diffusion 的基本做法,是從隨機雜訊開始,在文字條件引導下反覆更新潛在表示,最後解碼成圖片。
輸入「一隻卡通柴犬」,模型便逐步生成符合描述的輪廓、色彩與細節。雜訊裡並沒有藏著一張等待被找回的柴犬照片。
理解這個流程,可以分別看 UNet 怎麼學習預測雜訊、CLIP 怎麼處理文字,以及 VAE 為何能減少運算負擔。負
向提示詞與 CFG,則是在生成過程中調整方向的工具。
本文以經典 SD 1.x 的架構為主,不同版本會更換文字編碼器、預測目標或去噪網路,不能把同一套零件規格套到所有模型。
例如 Stable Diffusion 3 採用 Transformer 架構與 rectified flow,若還沒接觸過這類工具,可先看站內早期的 Stable Diffusion 繪圖示例,其中舊服務的額度與介面以當前官方資訊為準。
UNet 怎麼學畫圖?先學習估計加進去的雜訊
把一張柴犬照片加入高斯雜訊,就能得到模糊、顆粒很多的版本。訓練程式知道原始資料、抽到的雜訊與時間步,因此有明確的答案可以用來評估模型。
- 先用 VAE 把訓練圖片編碼成潛在表示。
- 抽取時間步與高斯雜訊,按照排程把雜訊加進潛在表示。
- 把帶噪潛在表示、時間步與文字條件送進 UNet。
- 比較 UNet 預測的雜訊與實際加入的雜訊,更新模型參數。
這裡採用經典的雜訊預測訓練目標,DDPM 論文 說明了前向加噪與反向生成的關係,而 CompVis 原始實作 將去噪工作放進潛在空間,並以文字條件引導。把訓練過程說成「看帶噪圖片,猜出雜訊」容易理解,但實際送進經典 SD UNet 的資料並非 RGB 像素。
從雜訊生成柴犬,為什麼需要反覆更新?
文字生圖時沒有原圖可還原,起點是一份隨機潛在雜訊,UNet 先估計目前狀態中的雜訊,再由 scheduler/取樣器依排程計算下一個狀態,重複後才得到可以解碼的結果。
所以,UNet 的單次輸出不應直接理解成「完成降噪的新圖片」。
預測與更新是兩個步驟。Hugging Face 的流程解說 將 UNet、取樣器與最後的 VAE 解碼分開呈現,有助於看懂 ComfyUI 的節點分工。
示範若把中途結果依序解碼,可能看到柴犬輪廓逐漸清楚。這不代表每一輪都必須經過 VAE,也不代表所有模型都固定需要相同的步數。
CLIP 的工作:把提示詞轉成可用的文字特徵
「卡通柴犬」和「動畫風格的小黃狗」不是同一句話,卻可能描述相近的畫面。
文字編碼器把提示詞轉成數值特徵,讓去噪網路能利用描述中的資訊,相近語意可能得到相關表示,但不同寫法不保證生成同一張圖片。
CLIP 原始研究 使用圖文配對做對比式學習,讓匹配的影像與文字表示更相近,並區分不匹配的組合,拿柴犬照片與汽車照片,分別和「a Shiba Inu」比較,就是直觀的教學案例。這種相似度是表示之間的相對關係,不能直接當成辨識正確率。
在經典文字生圖流程中,主要使用 CLIP 的文字編碼器,透過 cross-attention 把條件交給 UNet,CLIP 的影像編碼器並不是每個去噪步驟都要使用的零件。這也不表示所有圖像生成應用都不需要影像編碼器,加入參考圖的其他管線可能另有設計。
VAE 的工作:在較小的表示中生成,再還原成圖片
VAE 包含 encoder 與 decoder。前者把圖片編碼成潛在表示,後者把潛在表示重建成可見圖片。訓練與圖生圖會需要影像編碼,從純雜訊開始的標準文字生圖則主要在最後使用解碼器。
Latent Diffusion 原始論文 的關鍵,是把反覆進行的擴散運算移到較低維度的表示中,兼顧運算成本與視覺細節。這是經過學習的表示,和把照片縮成小張的縮圖不同。
1024 × 1024 的影像,為什麼會出現 1/48 和 1/12?
以寬、高各縮小 8 倍、潛在通道數為 4 的經典 VAE 為例,可做以下尺寸計算。這只說明表示大小,不表示 SD 1.x 原生訓練解析度就是 1024 × 1024。
| 表示方式 | 寬 × 高 × 通道 | 數值個數 |
|---|
| RGB 影像 | 1024 × 1024 × 3 | 3,145,728 |
| VAE 潛在表示 | 128 × 128 × 4 | 65,536 |
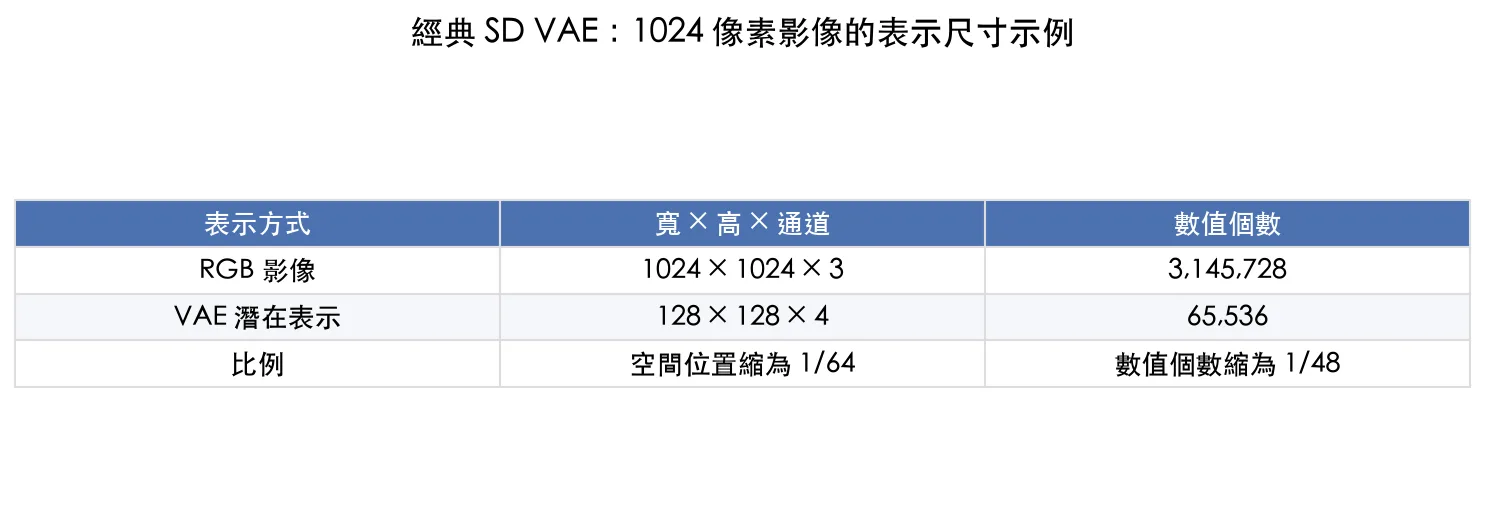 依經典 VAE 的尺寸規則計算,並非生成速度或顯存用量的實測比較。
只比數值個數,比例是 1/48。如果原始 RGB 每個數值用 1 byte,而潛在表示使用每個數值 4 bytes 的 FP32,則是 3 MiB 對 256 KiB,資料儲存量才是 1/12,兩個比例用了不同的比較基準,不能混為一談。實際顯存還包括模型權重、中間運算與其他元件,不會直接照這個比例下降。
反覆重建與旋轉潛在表示,能看出什麼?
把同一張圖重複編碼、解碼,可以觀察有損重建造成的細節變化。但單張示例不能證明每次都會以相同程度劣化,也不能把 VAE 訓練簡化成只有一項逐像素比對。VAE 的原始方法 還包含對潛在分布的約束,實際影像自編碼器也可能使用感知與對抗式目標。
負向提示詞怎麼用?以不戴墨鏡的柴犬為例
想要一隻不戴墨鏡的柴犬,可以先把正向提示詞寫成 a Shiba Inu, clear eyes,負向提示詞填 sunglasses。這是方便測試的起點,不是保證成功的固定配方。
把「不戴墨鏡」整句放在正向提示詞裡,可能無法穩定排除墨鏡。較準確的說法是,這類模型對否定與複雜語意關係的遵循有限,不能推論 CLIP 永遠只懂肯定句,Diffusers 的負向提示詞說明 把它定位為讓生成方向遠離不想要的內容或特徵。
CFG 調整的是兩份預測之間的差異
在支援負向條件的常見 CFG 實作中,模型會估計正向條件與負向條件下的雜訊預測,再依下式組合,沒有填負向詞時,通常使用空文字條件作為基準。
引導後預測 = 負向預測 + CFG ×(正向預測 − 負向預測)
這裡相減的是雜訊預測張量,不是把一張「戴墨鏡的狗」從圖片上剪掉,也不是對文字做算術,基礎概念來自 Classifier-Free Guidance 研究,正負條件的組合方式可對照 Diffusers 管線實作。
CFG 提高會加強兩份預測的差異,但數值過高可能出現失真或不自然的色彩。若負向詞寫得太廣,也可能干擾想保留的元素。先用少量具體詞彙測試,比整串貼上負向詞更容易判斷哪個設定有效。
把完整流程接起來,就能看懂主要設定
- 提示詞先經 tokenizer 與文字編碼器,形成文字條件。
- seed 參與決定初始隨機雜訊,作為生成的起點。
- UNet 接收潛在表示、時間步及文字條件,估計雜訊。
- 依需要使用 CFG,取樣器再更新潛在表示,反覆進行到設定步數。
- 最後以 VAE decoder 轉成 RGB 圖片。
想測提示詞效果,先固定模型、seed、尺寸、取樣器與步數,每次只改一個條件,相同 seed 有助於比較,但跨軟體版本、硬體或不同管線,不保證逐像素重現,步數也不是越高越好,應依所用模型與取樣器的設計調整。
下載模型時,還要分清主模型、文字嵌入與附加權重,站內的 Stable Diffusion 模型類型整理 可用來辨認常見檔案類型,實際相容性仍以各模型說明為準。
LoRA 與蒸餾,和去噪有什麼不同?
LoRA 是調整模型參數的方法。LoRA 論文 以低秩更新減少需要訓練的參數。用在擴散模型時,它可能調整去噪網路或其他部分的行為,但 LoRA 本身不等於一次去噪,也不是另一種取樣器。想觀察權重怎麼影響風格,可延伸看 LoRA 權重與分層設定,留意文中外掛與模型版本的適用範圍。
蒸餾則是利用教師模型的訊號訓練學生。在圖像生成裡,目標之一是讓學生以較少步數完成生成,例如 Adversarial Diffusion Distillation。這需要額外訓練,不能靠把一般模型的步數直接調低就獲得同樣效果,也不一定讓參數量變少。站內 模型蒸餾原理整理 說明了更廣泛的教師與學生關係,圖像模型的具體訓練目標仍要另外看。
Stable Diffusion 原理常見問題
Stable Diffusion 是從雜訊中找回原本的圖片嗎?
標準文字生圖從隨機雜訊開始,沒有一張特定原圖等待還原。模型依文字條件與訓練中學到的規律,逐步生成潛在表示,再解碼成圖片。
UNet、CLIP、VAE 分別做什麼?
在經典 SD 架構中,UNet 預測雜訊,CLIP 的文字編碼器提供文字條件,VAE 負責圖片與潛在表示之間的轉換。取樣器另行決定每一步怎麼更新。
負向提示詞可以保證排除指定物件嗎?
不能保證。它會影響生成方向,但效果取決於模型、正負條件、CFG 與其他設定。應使用具體詞彙逐項測試,而非把它當成物件刪除指令。
VAE 會讓圖片變模糊嗎?
VAE 重建有損,細節與色彩可能改變。是否明顯取決於模型與圖片,反覆編碼解碼也可能累積差異。它不是一般圖片縮放或完全無損壓縮。
生成步數越多,圖片一定越好嗎?
不一定。超過適合的範圍,增加步數可能只有額外耗時。蒸餾模型也可能針對少步數設計,應使用該模型建議的取樣方式與設定。
從一個可比較的小實驗開始
用同一個模型生成柴犬,固定其他設定,依序比較正向描述、負向詞與 CFG 的變化。知道每個元件在做什麼之後,調整設定就能帶著問題進行,不必只靠反覆抽圖。
by Rain Chu | 9 月 24, 2026 | Agent, AI
這篇以 Harness Engineering(AI 執行框架工程)為主軸,把工作案例、生活比喻與延伸設想逐項拆開,再補上實作時需要的界線。重點是做出可驗收的工作成果,而不是收集更多工具名稱。
先釐清:改善 Skill、訓練模型與 Harness 是三件事
把作品整理成提示詞、Skill 或知識庫,再用新案例修訂規則,通常是在改善模型外部的工作方式。除非真的執行參數更新,否則不能直接稱為大模型微調。模型能在目前對話參考你的糾正,也不代表它已永久記住,重要規則仍要明確保存。
Harness 的範圍更廣,包含資料入口、工具權限、任務狀態、評估、重試與交接。Anthropic 的長時間應用開發研究示範把規劃、產生與評估拆開,也強調主觀品質需要可判定的標準。不是多放幾份文件就完成整套工程。
實務上先保留三種素材:用來建立規則的示範、用來反覆調整的驗證案例,以及最後才打開的保留測試。scikit-learn 的交叉驗證文件說明了用同一份測試集反覆調整會造成的問題。
從企業導入到日常工具:先證明你解決了問題
1. 微軟派工程團隊進企業(FDE)
每家公司的資料、權限與作業順序不同,買同一套 AI 工具不代表能得到相同成果。這個例子說明,導入工作常常發生在模型之外。
怎麼用:先盤點實際流程與驗收責任。微軟官方公告日期為 7 月 2 日,將 Frontier Company 描述為新的營運事業,並強調與客戶共同設計及持續改善。不要直接寫成所有企業都不該自己做,或把它等同於一間獨立法人公司。
2. Palantir 到情報單位做原型
工程師到客戶現場、展示原型、接受批評再修改,說明需求必須在真實場景裡被看見。
怎麼用:把第一次展示當成收集回饋的工具。Palantir 的 Deployment Strategist 職務說明確實包含深入客戶流程、理解資料及與工程團隊合作,但不能據此替所有故事細節背書。
3. 漂亮網站隔週壞掉
頁面第一次能跑,和日後能維護是不同要求。這個情境包含故障找不到原因、資料管理不清楚,以及錯誤操作破壞網站。
怎麼用:初版完成後就補上備份、可還原版本、關鍵操作驗證與錯誤紀錄。把「看起來正常」改成「主要工作能完成,而且失敗後能恢復」的驗收標準。
4. 遛狗的牽繩比喻
模型可能用不同路徑完成同一件事,牽繩象徵人在必要時能限制或中止行動。比喻要說明的是可控性,不是要求每次輸出逐字一致。
怎麼用:把牽繩具體化成工具權限、可修改範圍、預算與停止條件。只寫一句「不要出錯」,不能代替程式與權限上的控制。
5. 看起來能賣錢的 Skill,直接問模型也能做到
有人投入心力做工具,卻沒有和一般對話比較。關掉工具、交付相同需求後,如果品質差不多,就還沒有證明額外流程的價值。
怎麼用:做基準比較與移除元件的對照測試,固定模型、資料、任務與評分方式,再比較品質、成本及修改時間。
6. 訪綱 Skill
額外 Skill 的差異沒有想像中明顯。這是上一個原則在內容工作中的具體例子。
怎麼用:同一位來賓的背景資料,分別交給直接對話與 Skill,隱去版本名稱後請編輯評估。訪綱要看可追問性與資料正確性,不能只看格式整齊。
7. 模仿 The Diary of a CEO 設計訪談
先用部分訪談建立提問原則,再給未揭露答案的來賓背景,請 AI 設計問題,最後和實際訪談比較。差異可以揭露它是否忽略個人故事、衝突或追問。
怎麼用:拿實際問題當參考,不把原主持人問過的題目視為唯一答案。反覆修訂使用驗證素材,另留從未用來調整的新來賓或新主題,才能檢查原則是否可遷移。
8. 訪綱越像原稿,反而越僵硬
若評分只獎勵字句相似,系統可能把語助詞、段落節奏與固定句型寫死。它會更像舊答案,卻不一定更會訪問新的來賓。
怎麼用:過擬合的重點是新資料上的泛化表現,不是超過某個分數就發生。不要把八成或八成五寫成通用最佳值,也不要故意讓好答案變差以符合比例。資料洩漏與測試集使用原則可作為評估設計的起點。
模型焦慮與工作安排:把限時額度放回任務價值
09. 近期任務、未來版本與系統改善三份清單
把眼前必須交付的工作、未來想做的功能,以及安全、模型切換與 Skill 管理等改善工作分開,能降低新模型推出時不知道該測什麼的混亂。
怎麼用:預先寫好輸入、預期成果及優先順序。比較新模型時使用固定任務清單,才能看出它是否改善真正的瓶頸,而不只是帶來新的待辦事項。
把個人判斷變成可測試的工作規則
10. 寫出自己的文章與影片腳本分身
只請模型歸納過往文風,容易得到泛泛的形容。較有用的做法,是先讓 AI 按相同題目與大綱寫一版,再對照本人完成的版本。
怎麼用:把差異拆成觀點、結構、證據、取捨與措辭,保存能重複使用的規則。文風相似和內容正確要分開評分,避免模仿語氣卻新增未發生的經歷。
11. 巴菲特分身與台積電評論測試
角色提示可以生成像某位投資人的論述,卻不代表知道本人當時有哪些資訊。用實際公開評論比對,也可能遇到模型早已看過答案的污染問題。
怎麼用:把它當分析練習,要求引用公開資料並分開標示事實與推論。歷史評論的相似度不等於投資能力,更不能代表本人對目前個股的建議。
12. 馬斯克分身與創業問題
用名人身分求創業建議,容易把有辨識度的語氣誤認成可靠判斷。真正值得拆解的是成本假設、限制與需要驗證的關鍵條件。
怎麼用:改成要求列出目標、已知事實、不可省略的條件與可測試假說。第一性原理可幫助重新檢查假設,但不是輸入名人名字就會自動成立的能力。
13. 從演講稿找出自己的思考習慣
把多篇演講稿交給 AI,請它辨識常見的論證及決策方式,能把原本不容易說明的思考偏好,變成可討論的候選規則。
怎麼用:要求每個判斷附原文位置,再用另一篇新稿檢查。不要把 AI 歸納的幾個標籤當人格定論,文字只呈現部分情境下的表達。
14. 提問時附選項、建議與可能後果
只把問題丟給主管,會把分析工作一起往上移。附上替代方案與推薦理由,能讓討論直接進入取捨。
怎麼用:先比較可行方案、成本、風險及決策條件。這可以進一步畫成決策樹,但只列三個選項還不是完整決策樹,計算期望值也需要有根據的機率與效益。
15. 董事會報告自動化後,主管的價值在哪裡
把例行報告交給 AI 之後,人的價值可能需要重新說明。但能產生報告,不等於能承擔組織協調、決策與結果責任。
怎麼用:在自動化之前寫清楚省下的時間要投入什麼,以及誰對決策負責。把報告能力和整個職務混為一談,會高估工具的替代範圍。
教育訓練與企業知識:把成果背後的過程留下來
16. NGO 把教材做成志工培訓短片
既有教材拆成較短的知識單元,再接上講稿、配音、簡報、影片與登入觀看流程,目的是降低重複培訓負擔。
怎麼用:先檢查教材內容與學習目標,再製作媒體。聲音複製須取得本人授權,影片也應經內容審查。是否學會要用練習或操作驗收,不能只看播放完畢。
17. Echo 找問題,Delta 快速做原型
討論用兩種角色說明需求洞察和工程實作的互補性:一邊發現不合理之處,一邊快速做出能測試的方案。
怎麼用:讓每個提案同時具備問題證據、可測的改動和使用者回饋。官方職務頁可確認 Echo 與部署策略職務的關聯,但「特種部隊」及人格分類只是訪談的比喻,不是完整招募規則。
18. 中醫師請 AI 反過來挑戰自己的判斷
與其讓 AI 一味附和,這位醫師用它提出不同解釋、追問選擇理由。這個例子強調專業人士的反思過程。
怎麼用:要求反對意見附證據,並區分缺資料、邏輯問題及可考慮的替代解釋。AI 提出的質疑仍可能錯誤,不能直接據此改方或讓一般讀者自行處置病情。
19. PDF 圖表轉成可檢索內容,並留下來源
只抽取文件文字可能漏掉圖片中的座標、單位與圖例。VLM 可以協助閱讀視覺內容,Markdown 則是保存描述的一種格式,兩者不是同一種東西。
怎麼用:同時保留圖表原檔、頁碼、讀出的數值與不確定處。需要計算時優先取得原始表格,別只依賴看圖估值。可延伸看本地 VLM 與文件理解。
20. 資深編輯的價值藏在退稿與修改往返
只有定稿,AI 很難知道編輯刪掉了什麼。作者初稿、編輯意見、作者回稿與最後定案,才顯示修改的理由和界線。
怎麼用:將修改分成事實、結構、讀者理解與風格,整理正反例。新的稿件再測一次,確認它學會判斷原則,而非對每篇文章都套同樣的刪改方式。
21. 課程企劃的 120 個節點為何不能一路直跑
把大型課程專案連成很長的順序,等全部完成才說不對,很難找出最早偏離需求的地方。分段產出、審查與退回,能讓錯誤更早被看見。
怎麼用:節點數不等於必須配置相同數量的 Agent。先按企劃、內容、驗證等成果切段,設定最多修改次數與人工接手條件。Anthropic 的 Agent 設計模式同時包含工作流與評估迭代,線性流程並非一律錯,應依任務需要選擇。多角色安排可參考CrewAI 與多 Agent 工作流。
內容、跑步與遊戲:把好奇心變成可驗證的專案
22. 全聯與 citysuper 超市開箱
兩種超市開箱哪個更受歡迎,不必只靠直覺猜測,可以先查找已發布作品。訪談用它說明觀察市場的方法,沒有提供可核對的比較樣本。
怎麼用:比較發布時間、頻道規模、題材角度及影片形式。搜尋得到的觀看數只能提供需求線索,不能保證你再拍同一主題也有相同流量。
23. 高中生用論文與姿態辨識研究跑姿
先找運動研究,再分析自己的跑步影片,最後提出調整方向,形成文獻、觀察與練習的回饋流程。訪談未提供所用技能包、原始影片或訓練前後紀錄。
怎麼用:技術上,MediaPipe Pose Landmarker可從影像估計人體關鍵點,但關鍵點不等於直接量到力量、傷害風險或完整動力鏈。需在教練指導下核對鏡頭及追蹤誤差,逐步測試調整,有疼痛時先尋求專業評估。
24. 傳說對決重播,找出戰術與技能時機問題
把玩家喜歡的遊戲當學習題目,回看哪個時間點做了什麼選擇,可以練習提出假說與檢查結果。這段不是已完成的產品實測。
怎麼用:請 AI 指出畫面證據、可選動作及判斷的不確定性,再由熟悉遊戲的人確認。理解重播與即時操作是兩種能力,不能把前者直接推成後者。
25. 錄下網站操作,再整理成可重複使用的 Skill
下載文件、移到指定位置等固定操作,可以先示範,再整理輸入、步驟與驗收方式。所核對的官方插件名稱為 Record & Replay,與字幕中的 recall and play 不同。
怎麼用:錄製內容可作為建立技能的素材,但工作流程仍需確認輸入、權限與結果。這不等於能可靠學會任何即時遊戲,也不代表錄一遍便能替孩子自動打完對局。
六個值得留下的觀點,以下為意譯
先定義成果,再選工具
寺廟需要的是可靠的法會系統。程式語言、模型及插件都應服從這個目標。
知道哪裡不好,是把 AI 用好的前提
如果無法判斷品質,就先和領域專家一起建立標準,不能只讓 AI 自己給自己高分。
完成品之外,修改理由也值得保存
編輯與主管真正的判斷,常出現在否決、補證據及改寫的過程。
把大任務拆成能退回的小循環
每段都有產出、檢查與停止條件,出錯時才知道該修哪裡。
先解決身邊可驗證的需求
主管往來及自己的文章,通常比不可求證的名人分身更容易建立回饋。
興趣要接上實作,才會形成能力
跑步和遊戲都能成為專案入口,前提是願意研究、練習、接受證據與修正。
把這些方法用在自己的第一個專案
挑一個你熟悉、會重複發生,而且能檢查對錯的工作。先寫出使用時機、使用者、輸入與成果,再拿現有直接對話作為基準。建立最小版本後,每次只針對清楚的失敗原因修正,保留改版前後的結果。
能被重複利用的不是一句神奇提示詞,而是一組可信資料、清楚規則和可檢查的成果。等小流程穩定,再增加資料來源、角色分工及自動化程度。
需要了解來賓的課程與教學範圍,可參考說明欄提供的AI 超級大腦課官方頁與李佳達頻道。課程宣傳中的效果與比例不作為本文技術查核證據。
常見問題
Harness Engineering 就是微調模型嗎?
不是。它主要設計模型之外的資料、工具、狀態、權限與評估流程。修改提示詞或 Skill 通常不會更新大模型參數。
把資料分兩半,一半反覆測試就夠了嗎?
被用來修正規則的案例已參與開發。若要檢查泛化,還需要未參與調整的保留測試,並避免重複資料與事後資訊洩漏。
AI 準確率超過八成五就叫過擬合嗎?
不是。過擬合應觀察已見案例和新案例的表現差異,不能用固定百分比判定。不同工作也需要不同品質標準。
一百多個流程節點就需要一百多個 Agent 嗎?
不需要。先依成果、相依關係與驗收責任切分工作,再決定是否增加角色。大量 Agent 也會增加協調成本和錯誤來源。
自己的 AI 分身應該收集哪些資料?
除了完成品,還應保留當時的輸入、初稿、修改意見、理由及定稿,並另留新案例驗證。涉及他人或公司的資料,須具備適當使用權限。
by Rain Chu | 9 月 24, 2026 | Agent, AI, 商模
Meta Muse 的吸引力,在於它開始把「幫我想辦法」接到「替我動手做」,例如找二手商品、向賣家議價、整理購物車、聯絡電信客服,都屬於它想接手的生活任務。這也是市場重新評估 Meta AI 業務的一個理由,最近股價狂漲的關係:消費者終於比較容易想像,AI 能替自己省下什麼時間。
Muse 是產品,Muse Spark 是背後的模型
Meta 在 2026 年 9 月 8 日推出 Muse 個人 AI Agent,以對話方式接收任務,搭配自己的雲端電腦與瀏覽器執行操作。它可以在關閉 App 後持續工作,需要你介入時再通知你。
Muse Spark 是模型系列,Muse 則是把模型、工具、記憶與權限控制整合起來的產品。
Meta 在 9 月 2 日發表的 Muse Spark 1.3,重點包括較長的任務流程、多工作切換與指令遵循。
模型表現改善,與每一個網站任務都能成功,仍是不同層次的事。
此外,能使用 Facebook 或 Instagram 連接器,不代表產品會自動讀取你在所有 Meta 服務中的全部資料,實際能取得什麼,仍取決於你連接的服務、核准的權限與資料是否可用。
Muse 可以做到哪些事?先看六類任務
以下把已出現的公開操作案例、官方公布的能力與仍未完成的環節分開整理,判斷 Agent 是否有用,重點不只是它回覆得好不好,而是它交付了什麼結果。
| 任務 | 可代辦的環節 | 仍須確認的結果 |
|---|
| 找商品與議價 | 搜尋刊登、篩選條件、代發訊息、追蹤回覆 | 對方是否答應,以及是否真的成交 |
| 挑衣服與購物 | 依尺寸與場合選品、準備購物車 | 商品、總價、地址與付款核准 |
| 處理帳單 | 比較方案、開啟客服對話、整理下一步 | 能否登入,優惠是否符合資格 |
| 整理社交資訊 | 依條件搜尋可取得的好友資料 | 資料是否完整,名單是否正確 |
| 追蹤長期目標 | 記住需求、持續追蹤、適時提醒 | 任務是否持續有效,通知是否有用 |
| 行政與內容產出 | 信件、行程、表單、文件與互動頁面 | 寄送、預訂和交付內容是否通過檢查 |
一、Facebook Marketplace:找得到,也能代你開口談
以尋找 iPhone 為例,任務包含地區、品牌與可接受價格,Muse 不只提供搜尋建議,還能整理候選商品,準備議價訊息,經確認後送出,再持續追蹤賣家回覆。
這類工作最耗人的地方,往往是反覆搜尋、比較與等待。交給 Agent 的價值,是把多個零碎步驟串起來。只是「訊息已送出」與「已用理想價格買到」必須分開,公開案例尚不足以證明最後成交或實際省下多少錢。
如果要委託這種任務,條件可以寫得更具體:限可面交地區、指定品牌與容量、最高預算、可接受的商品狀況,以及超出預算時是否必須回報。談價的目標與能承諾的範圍愈清楚,愈容易檢查結果。
二、Facebook 好友整理:
把多年沒聯絡好友找出來,是一個很貼近 Meta 社交背景的需求.
這項案例比較適合用來理解任務方向,還不能作為「能準確重建社交圈」的結論。實際使用時,應要求列出判斷依據與不確定的項目,再由本人決定是否聯絡。
三、長期目標:把一次指令變成持續追蹤
Muse 的另一個方向,是記住你正在處理什麼。買 ㄞiPhone 不必等同一次聊天,還可以成為待追蹤的目標。賣家晚些回覆、條件改變,或需要你決定下一步時,再把資訊帶回來。
官方產品設計說明把這種能力放進 Goals、活動紀錄與記憶管理,讓任務可以依排程或事件繼續推進。對使用者而言,真正該驗收的是「有沒有在需要時帶回新結果」,而非訊息數量多不多。
手機使用時間、學習進度或運動計畫,也能成為對話與追蹤的題目。但提出計畫不等於目標已達成。健康與財務類建議,更需要核對原始資料,不能因為連接了帳戶,就假定分析一定正確。
四、行政與文件:不只回一段文字,也能產出成果
官方公布的用途還包含處理信件、旅行安排與填表。產品設計文件也列出文件、PDF、網頁及互動式追蹤工具等輸出。
這和 讓 AI Agent 操作 Office 文件談的是相近的需求:使用者需要能打開、修改與檢查的成果,而不只是聊天中的一段建議,不同 Agent 的工具、檔案支援與權限仍各有差異。
安全設計怎麼看?付款核准與資料隔離要分清楚
依 Meta 的Muse 安全架構說明,Muse 在獨立雲端環境中工作,外部操作由另一套 Sentinel 權限系統把關。密碼與付款憑證透過隔離儲存供工具使用,主要 Agent 不直接看到原始憑證。
Muse 可以協助購物,但購買時需要使用者核准具體交易內容。應透過產品提供的登入與錢包介面授權,不能把密碼或信用卡號直接貼進聊天,當成安全儲存的替代方式。
官方表示,對話與 VM 資料不直接提供給 Meta 廣告系統,模型訓練使用另有退出設定。現行 Secure VM 並非讓 Meta 在技術上完全無法存取資料,進一步的 Confidential VM 在發表時仍列為後續計畫。
若你在意資料留在哪裡,可以對照本機優先 Agent 與雲端服務的差異。雲端隔離環境和本機部署,解決的問題並不完全相同。對生活助理而言,方便程度也往往和你願意授權的範圍一起增加。
Meta 股價最近為什麼大漲?先把日期對齊
這一波最醒目的變動出現在美東時間 2026 年 9 月 21 日。Meta 收盤價由前一交易日的 665.75 美元升至 741.25 美元,依這兩個未調整收盤價計算,上漲約 11.34%。9 月 22 日則收在 736.60 美元,較前一日回落約 0.63%。
| 美東交易日期 | 收盤價(美元) | 與前一列收盤價相比 |
|---|
| 2026-09-18 | 665.75 | 比較基準 |
| 2026-09-21 | 741.25 | +11.34% |
| 2026-09-22 | 736.60 | −0.63% |
市場重新評價的,是 AI 能否成為大眾產品
依 Yahoo Finance 的 9 月 21 日報導,當日的催化因素包含 Muse 在美國 App Store 免費榜的表現,以及 Wells Fargo 上調 Meta 目標價。報導同時提到,市場正關注即將到來的 Meta Connect。這些因素同時出現,不能把全部漲幅單獨歸因於某一個功能。
我的解讀是,Muse 讓市場比較容易看見 AI 投入與消費者需求之間的連結。模型跑分離多數人的生活很遠,但替人查帳單、找便宜商品、處理行政瑣事,價值更容易被理解。
Meta 的機會,在於它既有的消費者產品與使用習慣。如果個人助理能在熟悉的介面裡完成有用的事,就可能降低嘗試門檻。不過,下載榜名次不是長期活躍人數,更不是付費率或獲利能力的證明。
想試 Muse,先交付一件可驗收的小事
官方公開發表資訊仍以美國推出為主,可從Muse 官方入口確認自己帳號的可用狀態、方案與額度。
開始時,可以沿用先釐清 Agent 任務需求的做法,把目標、限制與交付結果一起說清楚。例如:「找出本週可面交的指定品牌商品,整理價格與狀況,先不要聯絡賣家。」確認資訊品質後,再決定是否交付議價或後續追蹤。
Muse 值得關注的地方,是把生活中的搜尋、判斷、操作與追蹤接得更完整。它能否成為長期使用的個人助理,要看這些日常小事能否反覆做對。Meta 股價已反映一部分期待,接下來還需要使用者留存、服務可靠度與商業成果接棒。
Muse 與 Meta 股價常見問題
Meta Muse 和 Muse Spark 有什麼不同?
Muse 是面向使用者的個人 AI Agent 產品,Muse Spark 是背後的模型系列。實際任務還需要瀏覽器、工具、記憶與權限控制配合。
Muse 可以自行刷卡購物嗎?
它能準備購物流程,但官方設計要求在購買時核准具體交易。憑證應透過專用登入與錢包介面處理,不應直接貼進對話。
台灣現在能使用 Muse 嗎?
截至 2026 年 9 月 23 日核對,官方發表資訊仍以美國推出為主。台灣是否開放、帳號是否符合資格,需以官方入口與帳號顯示為準。
近期留言