Laya 提供了可以在本機執行的開源決策模型,但目前還不足以支持「直接取代 Jev」,在相同的垃圾簡訊與銀行客服分類樣本上,Jev 的準確率較高,Laya 則在 Apple M3 上呈現較短的實際等待時間。
內容目錄
Laya 是什麼?把語意轉成程式可用的判斷
Laya 接收文字或結構化狀態,再依你定義的問題回傳選項、分數或機率。它採用非自回歸架構,經由編碼器理解輸入,再由決策頭評估候選答案,省去逐字生成回答與解析自由文字的步驟。
可以用一張客服單理解三種題型:
choice 判斷要分給帳務、技術還是業務,score 依事先描述的等級評估急迫性,noul 回傳「客人是否明確要求退款」這類命題成立的機率。
這與 TypeSafe 的 System One 設計有相近的工作分工,需要分類、分流與檢查時使用決策模型,需要撰寫回覆時再接生成模型,想先了解實際如何串接,可以參考 Jev 的五個工作流場景。
Laya 英文模型卡列出的基礎版本採用 ModernBERT-large,總參數量約 4.21 億,權重採 Apache 2.0 授權。
另有多語言與 typed-decisions 等 checkpoint。這次受測的是英文基礎版,沒有為這兩份評測資料另外微調,不能把其他版本的分數直接套過來。
Laya 的 開源專案也提供相容 Jev 請求形狀的介面,能降低改接服務的工作量。
這次比較怎麼做?先把版本與條件固定
依 公開評測紀錄,Laya 測試日期為 2026 年 9 月 23 日,使用 Laya 0.3.11、英文 convaiinnovations/laya checkpoint,以及 Apple M3 的 MPS 加速。Jev 沿用 9 月 20 日透過 OpenRouter 取得的 jev-1.13 原始回答,兩者並非同一時間重新呼叫。
- SMS Spam:200 則英文簡訊,其中 27 則垃圾訊息、173 則正常訊息。
- Banking77:462 則英文銀行客服訊息,77 個意圖各取 6 則。
- 兩邊使用相同的樣本 ID、輸入狀態、正確答案與題目設定,再由同一份評分程式計算結果。
- Laya 在本機逐筆執行,Jev 走雲端服務。延遲反映這兩條實際執行路徑,並非相同硬體下的模型速度測試。
核對資料時,官網已列出 0.3.20 的更新內容,下文數字應視為 0.3.11 英文基礎版的固定評測,不是對所有新版本、所有語言或微調模型的總排名。
範例一:垃圾簡訊二分類,84% 準確率該怎麼看?
這個任務只問一件事:簡訊是不是垃圾訊息。評分程式把 noul 大於或等於 0.5 的回答判成垃圾訊息,再與資料標籤比較。Jev 答對 193 則,Laya 答對 168 則。
| 任務 | 模型 | 答對 / 樣本 | 準確率 | Macro F1 |
|---|---|---|---|---|
| SMS Spam | Jev | 193 / 200 | 96.5% | 0.926 |
| SMS Spam | Laya | 168 / 200 | 84.0% | 0.759 |
| Banking77 | Jev | 377 / 462 | 81.6% | 0.806 |
| Banking77 | Laya | 183 / 462 | 39.6% | 0.346 |
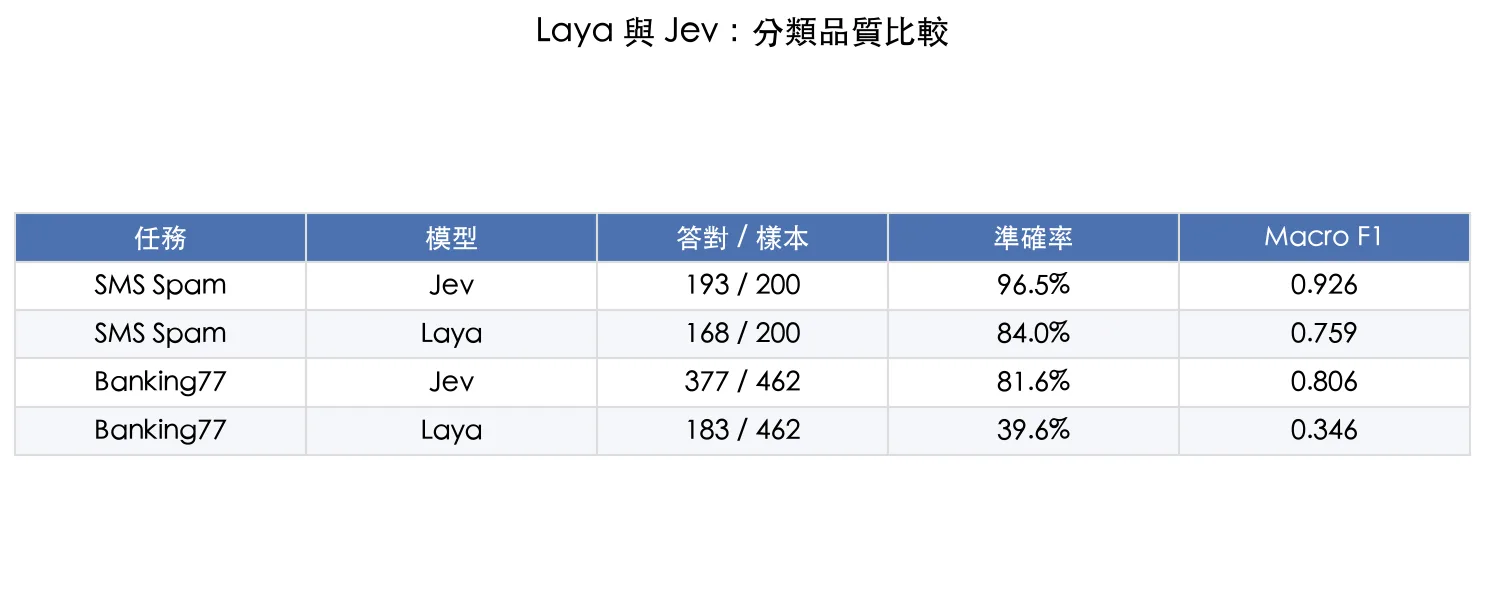
這裡不能只盯著 84%。因為正常簡訊佔 173 / 200,若把全部訊息都判成正常,準確率也有 86.5%。這是依樣本比例計算的簡單基準,說明類別不平衡時,整體準確率可能掩蓋模型對少數類別的處理能力。
原始錯誤也不是完全重疊:29 則只有 Jev 答對,4 則只有 Laya 答對,另外 3 則兩者都錯。這顯示 Jev 在這份樣本上整體較好,但仍有值得回頭檢查的個別案例,不能把任何一方當成永遠正確的裁判。
範例二:Banking77 的 77 選 1,差距為什麼變大?
Banking77 資料集把銀行客服需求拆成 77 個意圖。這組測試的任務,是從所有候選意圖裡直接選出一個。Jev 答對 377 / 462,Laya 答對 183 / 462,Macro F1 也從 Jev 的 0.806 降到 Laya 的 0.346。
候選答案多,不只增加選擇難度,也會消耗描述選項的空間。依官方目前的限制說明,英文 Laya 的選項提示預算 head_max_len 預設為 192 tokens,所有選項必須共享這段空間。當相近的分類名稱與描述被裁短,模型可能失去區分它們的重要文字。
官方提醒,有簡短描述的選項增加到大約 20 個後,就應留意預算與裁切。20 不是所有請求通用的硬性上限,實際影響取決於指令、標籤長度與 checkpoint。77 選 1 已超出建議的使用範圍,因此這個結果同時反映任務難度與目前設定的限制。
分成兩層分類,是可以驗證的改法
一種改法是先把候選答案縮到幾個大類,再在選中的大類裡做細分。以概念示例來說,先分出「卡片」「轉帳」「現金提領」「帳戶」,再於卡片類別中辨認啟用、遺失或付款問題。這樣每一步需要容納的描述較少。
這個策略值得測試,但本文引用的 77 選 1 成績不是兩階段分類的成績。第二層也會受到第一層錯誤影響,所以要評估完整流程的最終分類準確率、兩次呼叫的總延遲,以及無法判斷時的回退方式。不能只拿第一層大類的分數宣稱問題已解決。
Laya 比較快嗎?先分清楚本機等待時間與模型速度
| 任務 | Jev p50 | Laya p50 | Jev p95 | Laya p95 |
|---|---|---|---|---|
| SMS Spam | 447 ms | 50 ms | 922 ms | 66 ms |
| Banking77 | 432 ms | 294 ms | 658 ms | 354 ms |
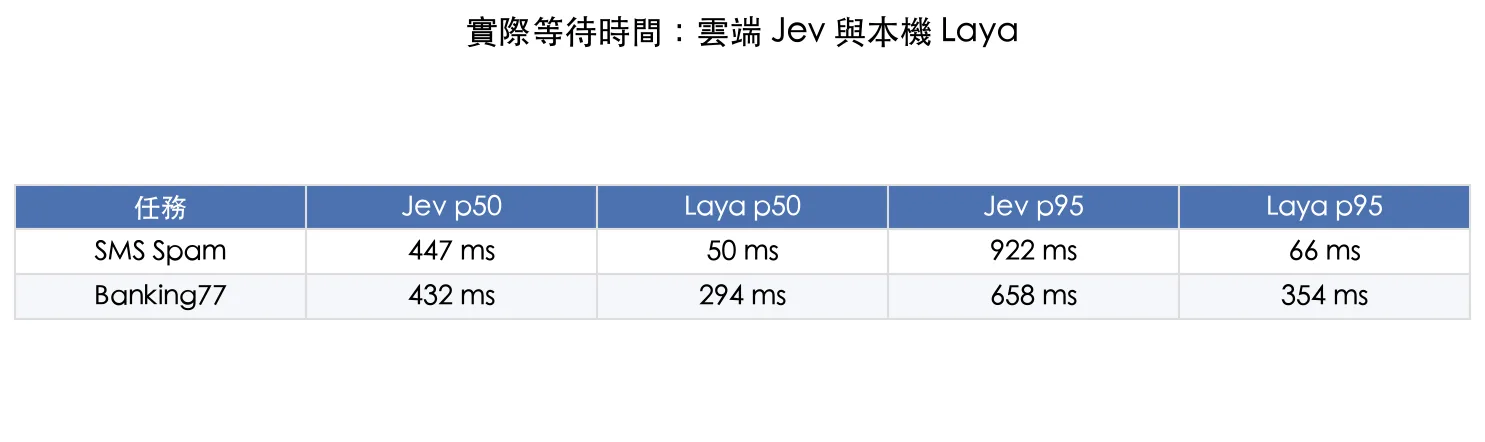
p50 是中位數,p95 反映較慢端的等待情況。在這台電腦與這批請求上,Laya 的兩項數值都較低,但差距會隨任務改變。垃圾簡訊的 p50 為 50 毫秒,77 類銀行意圖則上升到 294 毫秒,說明「一次前向運算」不代表任何問題都花相同時間。
更精確地說,銀行客服的原始請求同時包含 77 類 intent 與 10 類 group 兩個獨立問題,所以表中的延遲是整次請求的耗時。這與先取得大類、再縮小選項進行第二次呼叫的分層分類不同,兩者不能混為一談。
這些數字也不能涵蓋首次下載與模型載入。常駐服務可以攤平啟動成本,偶爾才執行一次的工具則可能更在意冷啟動。重新測試時,應把啟動、單筆延遲、批次吞吐量與尖峰等待分開記錄。
本機執行能減少推論時把輸入交給外部服務的需要,但「沒有逐次 API 費用」仍要加上硬體、電力與維護成本。若系統還會使用雲端備援或外部工具,資料流向也要一起看,這與 本機 AI 與雲端分流的取捨有直接關係。
信心值與微調,不能省略的兩個驗收環節
信心值很高,只能描述模型如何分配機率,不能直接當成答案正確的保證。公開評測特別記錄,0.3.11 在 11 個以上選項時會限制溫度,回傳的信心值也未完成相應校準,因此這次沒有拿 77 類任務做可直接比較的信心門檻結論。
如果原本 Jev 設定某個門檻就自動處理,換成 Laya 時不能只保留相同數字。應用自己的已標註資料檢查:門檻提高後,剩下多少案件能自動處理,其中又有多少判錯。選擇門檻的依據,應是可接受的錯誤與覆蓋率。
另一方面,基礎 checkpoint 能直接接受新題目,不等於在任何領域都已經可靠。Laya 官方同時提供微調方向,且承認基礎版在部分工作流測試中表現有限。用自己的領域資料訓練,可能改善結果,但必須留出沒有參與訓練的測試資料。
微調、蒸餾與量化處理的是不同問題。如果要用較強模型產生教學訊號來訓練小模型,可以延伸閱讀 模型蒸餾與本地部署的差異。不能只因為模型變小、能在本機跑,就推論判斷能力等同原服務。
想試 Laya,先從一個可驗收的任務開始
- 先選標準清楚、選項不多的任務,例如把客服單分到幾個部門,並保留其他或資訊不足的處理方式。
- 建立代表真實需求的標註集,涵蓋常見、少見與容易混淆的案例。同時比較簡單規則、Laya 與目前採用的服務。
- 記錄 checkpoint、套件版本、題目文字、選項描述、裝置與推論設定,讓數字可以重現。
- 先找出錯誤集中在哪些分類,再判斷要改題目、縮短選項、分層分類或微調。一次改一個主要因素。
- 把正確率、各類別表現、誤判成本與整條流程的延遲一起驗收,再決定哪些判斷可以自動處理。
如果要重現這次比較,可從 完整評測目錄取得樣本、題目、原始回答與評分程式。只想核對現有數字時,先讀保存的 runs 與 reports 即可。要重跑模型,再依 LAYA.md 的鎖定環境操作,並確認是否沿用了舊結果檔,避免把跳過已完成項目的續跑誤認為新的全量測試。
Laya 與 Jev 常見問題
Laya 可以直接取代 Jev 嗎?
介面相容有助於改接,但不能保證判斷品質相同。在這次 662 筆英文樣本中,Jev 的準確率較高,Laya 的本機延遲較低,是否替換仍需用自己的任務驗收。
Laya 一定要微調才能使用嗎?
基礎 checkpoint 可以直接接受新題目,但可執行不代表準確度足夠。先測原始模型,若錯誤超出需求,再評估題目設計、分層分類或領域微調。
Laya 最多只能選 20 個類別嗎?
約 20 個是官方對預設選項預算的實務提醒,不是固定上限。指令和標籤長度都會影響裁切,候選類別很多時,應檢查預算並測試縮小候選集合的方法。
這次測試能代表 Laya 的中文能力嗎?
不能。受測的是英文基礎 checkpoint 與兩份英文資料集。中文工作應選適合的 checkpoint,另用中文標註資料驗證,不能沿用這裡的準確率。
選擇的依據,是你的任務能不能通過驗收
這次結果支持一個務實的起點:把 Laya 當成可自行部署、值得針對固定任務調整的決策元件。需要大量細分類、又希望直接使用預設設定時,這份測試裡 Jev 的表現較好。先挑一個明確任務做完整驗收,再決定是否替換或混合使用,會比只看「開源平替」四個字更有幫助。
近期留言