by Rain Chu | 10 月 7, 2026 | AI, QWEN
Strata 能把 Qwen3.8-Flash-Next 分散到 GPU、系統記憶體與 SSD,在個人電腦上提供聊天、圖片理解和 Agent 使用的本地模型服務,依 v0.1.13 文件,較實際的起點是 NVIDIA RTX 30/40/50 系列、12GB 以上顯存,以及 64GB 系統記憶體。
這套工具值得研究的地方,是讓既有桌機分工承擔大型模型,而不是把所有成本變不見,安裝前,先確認顯卡支援、可用 RAM、磁碟空間與打算使用的上下文長度,會比追著最高 tokens/s 更有幫助。
本文以指定的 v0.1.13 為核對基準,案例是公開示範的整理,沒有在本文另外重跑硬體實測。
Strata 是什麼?模型、推理引擎與 Agent 要分開看
Qwen3.8-Flash-Next 官方模型卡列出 125B 主模型參數、每次啟用約 6B,另有 n-gram embedding 與 MTP 元件,MoE 每一步只使用部分專家,有利於分工運算,但完整權重仍要有地方保存。
Strata 負責載入與執行模型,並提供網頁介面和 API,Hermes 等 Agent 則負責規劃、操作檔案及呼叫工具。
把兩者接起來,才會從「產生一段程式碼」進入「建立專案、執行、查看錯誤、再修改」的循環。
- GPU 保留常用運算元件與熱門專家,盡量利用顯存中的資料。
- RAM 保存專家權重,CPU 處理未命中 GPU 快取的部分,與 GPU 協同運算。
- SSD 保存大型查找表,依需要讀取相關資料。
- MTP 先提出後續 token 候選,再由主模型驗證,減少逐步解碼的成本。
這是特定引擎配合特定模型的設計,不能推論任何 GGUF 都能直接換上去,想先了解候選 token 與驗證的概念,可以延伸看站內的 MTP 本地推理加速整理,Strata 的分層細節以 固定版本技術文件為準。
8GB 能跑,但有三個條件不能省略
第一,官方路線是 NVIDIA,AMD CPU 不等於 AMD 顯卡
v0.1.13 的 硬體要求寫明 12GB 以上 NVIDIA 顯卡,並註記 8GB 可以執行但較慢。
安裝程式也會透過 nvidia-smi 檢查 GPU,找不到 NVIDIA 顯卡就停止。
CPU 支援 Intel/AMD 的 x86-64 與 AVX2,這與支援 Radeon 顯卡是兩回事。
因此,這份 Windows/Linux 教學不能直接套到 AMD GPU 或 Apple Silicon。
即使底層借用了 llama.cpp 的元件,也不代表它自動繼承所有後端。
官方量測以 RTX 5070 為主,列入支援範圍的其他系列也不等於逐張完成驗證。
第二,大量 RAM 仍然必要,不能只算顯存
模型的專家權重主要留在系統記憶體。大顯卡可以減少 CPU 的工作,卻不會讓這份 RAM 需求消失。
v0.1.13 安裝程式為不同量化設定了記憶體需求值,以下是部署規劃用數字,不是本文測得的即時占用。
| 量化 | 模型下載量 | 專家記憶體約占 | 安裝程式 RAM 需求值 |
|---|
| Q2_0 | 66.4GB | 34.0GB | 48GB |
| IQ2_XS | 68.0GB | 35.5GB | 48GB |
| IQ3_XXS | 75.8GB | 42.9GB | 60GB |
| IQ3_S | 83.6GB | 50.3GB | 62GB |
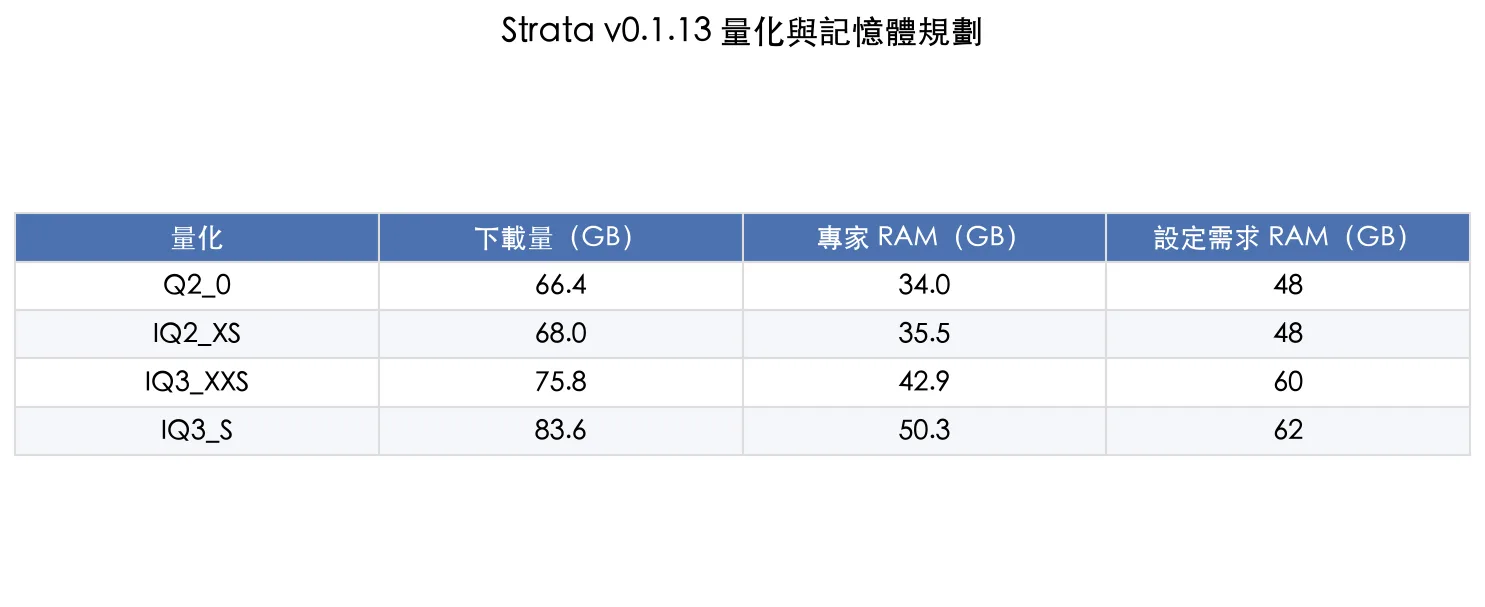 依 v0.1.13 setup.py 整理,GB 沿用原始標示。RAM 需求值不是剩餘記憶體,也不是 GPU 顯存需求。
64GB RAM 是較容易規劃的配置,使用 IQ3_S 時仍要控制背景程式,模型檔之外還有引擎、MTP 與暫存,部分 Q2_0/AVX-512 組合會建立額外的專家資料副本,不能只按下載大小留磁碟。先用較小量化、較短上下文,確認實際餘裕再提高設定。
虛擬記憶體能提供位址空間與換頁機制,但不能當成同容量 RAM 的速度替代。
這個版本也會檢查實體 RAM。若已經不停讀寫磁碟、整機反應很慢,優先關閉其他程式或選較小模型,不要預期把分頁檔加大就能維持同樣吞吐量。
第三,8GB 安裝畫面不能替代 24GB 測試結果
這組公開示範先顯示 8GB 顯存與 64GB RAM 的設定,後續明確切換到 24GB 顯存,才繼續進行程式與 Agent 案例。
因此,後面的遊戲生成表現不能作為「8GB 顯卡同樣快」的證據。
評估自己的電腦時,至少要一起記錄 GPU、RAM、量化、上下文、影像開關與完整任務耗時。
安裝 Strata:先完成文字聊天,再加圖片與 Agent
1. 下載完整專案,分清原始碼與引擎壓縮檔
從 Strata v0.1.13 發行頁進入版本資料。
新手需要包含 START-HERE.bat、setup.py 等檔案的完整專案。
發行附件 strata-windows-x64.zip 是引擎,symbols 壓縮檔供除錯,不要把引擎附件誤認成完整安裝介面。
Windows 更新 NVIDIA 驅動後,解壓完整專案並執行 START-HERE.bat。
Linux 使用 ./setup.sh。
v0.1.13 文件要求驅動 580 或更新版本。安裝器會處理 Python、依賴、引擎與模型下載,沒有現成引擎可用時可能需要編譯。
需要重現版本時,還要查看啟動日誌中的 engine 版本。
v0.1.13 的安裝程式預設下載 latest 發行引擎,所以只下載舊版原始碼,不代表最後執行的一定是同一版引擎。本文沒有把後續 main 分支新增功能混入這份教學。
2. 選原版或 Swift 1.5,再選量化
Swift 1.5是 UkisAI 的微調版本,主要方向是縮短思考內容。
「較快給出答案」可能來自生成的思考 token 變少,不是每一個 token 都跑得更快。效果與授權應分別看模型頁,不能直接當成所有任務都等效的加速開關。
不確定如何選時,可從官方 README 建議的 IQ2_XS 開始。
Swift 1.5 在這個版本沒有 IQ3_S 選項,模型越小越省空間,但程式正確率、長文本與工具使用是否符合需求,仍要用自己的任務驗證。
如果 RAM 不足,Qwen3.8-27B 與 GGUF 部署整理提供另一種較小模型的評估方向,不能把兩者硬體表混用。
3. 上下文與影像功能逐步增加
v0.1.13 安裝程式會依顯存建議上下文,較小顯存通常先選 32K。長上下文會占用更多快取與工作空間,並擠壓 GPU 可保存的專家數量,KV Cache 先用建議的 8-bit,4-bit 是節省空間的選項,不是無條件提升品質與速度。
需要讀圖片時再開啟影像編碼器,官方文件列出的 GPU 影像路線會額外保留約 1.4GB 顯存,這對 8GB 顯卡尤其有感。純文字聊天還沒穩定時,先不要同時開啟最長上下文和影像功能。
4. 確認服務完成啟動
終端機顯示服務就緒後,在同一台電腦開啟 http://127.0.0.1:8080。
Chat 用於聊天,Monitor 查看 GPU、CPU、RAM 與請求狀態。
第一次載入大型權重可能很慢,先看日誌進度。
頁面顯示舊介面時可以強制重新整理,但後端已退出或記憶體不足,需要處理後端原因。
v0.1.13 快在哪裡?讀提示詞與輸出要分開看
v0.1.13 發行說明的重點是 prefill,也就是讀取提示詞的階段。
專案公布的 RTX 5070 12GB、Ryzen 5 7600、64GB DDR5 測試如下。這些是開發者的特定條件測量,不是對任意顯卡的保證。
| 32K-token 提示詞 | v0.1.12 | v0.1.13 |
|---|
| Q2_0 | 572 tokens/s | 1,290 tokens/s |
| IQ3_S | 383 tokens/s | 1,208 tokens/s |
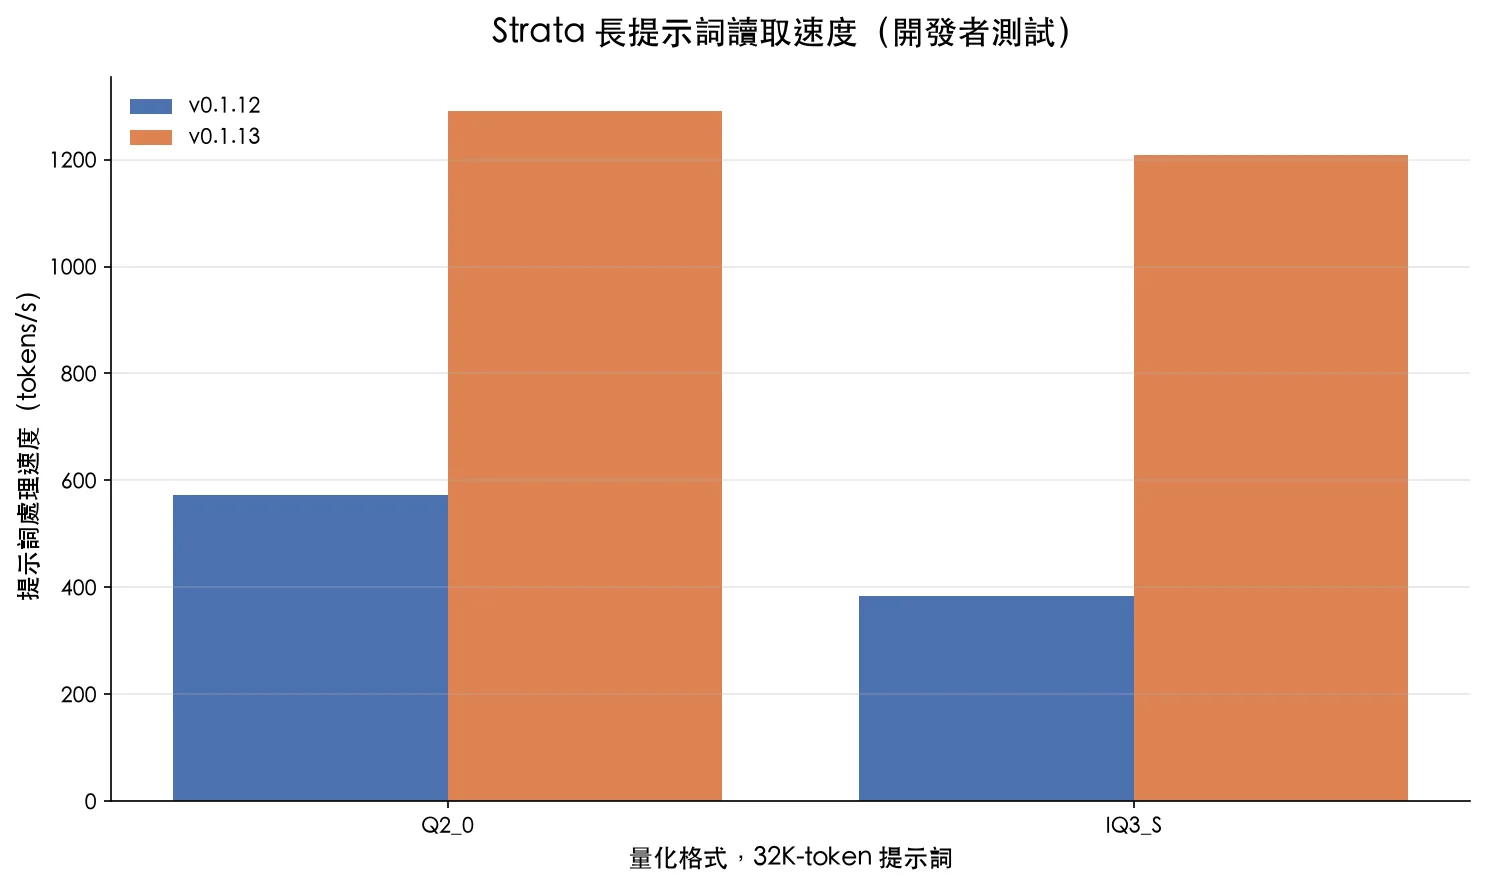 開發者公布的 prefill 測試。RTX 5070 12GB、Ryzen 5 7600、64GB DDR5。數字不是回答生成速度。
新版透過較大提示詞區塊、量化運算核心,以及資料傳輸與運算重疊等方式減少等待。
公開測試紀錄同時寫明:回答輸出路徑未改,生成速度不因此增加,不能把 1,290 tokens/s 當成聊天輸出的速度,也不應把舊 README 的讀取數字與新版測試混成一張排行榜。
實際工作感受由首次等待、思考長度、輸出長度與工具執行時間一起決定,模型每秒輸出很多 token,仍可能花很久生成大型專案。tokens/s 也不能直接換算成固定數量的中文字。
接到 Hermes Agent:先測 API,再交付長任務
在 Agent 中加入 OpenAI 相容提供方,Base URL 使用 http://127.0.0.1:8080/v1。預設本機服務若未啟用驗證,客戶端要求非空 API Key 時可填占位字串。若已設定服務密鑰,就必須使用實際密鑰。模型名稱可依 /v1/models 顯示選擇。
Base URL: http://127.0.0.1:8080/v1
Chat Completions: POST /v1/chat/completions
Model list: GET /v1/models
Health: GET /health
上述 API 路徑可在 Strata API 文件核對。先發送一句短訊息,再測一次小型工具呼叫,最後才做多檔案專案。Agent 若跑在另一台電腦或容器,127.0.0.1 指的是它自己,必須依實際網路環境調整,不能照抄位址。
本地推理可以省去外部模型 API 的逐 token 費用,硬體、電力和維護成本仍然存在。Agent 額外使用的搜尋、語音或其他雲端服務,也要分開確認。先讓工具只操作指定專案資料夾,保留變更紀錄,會比較容易找出長任務失敗的位置。
常見問題
8GB 顯存能跑 Strata 嗎?
v0.1.13 官方細節文件表示可以執行但較慢,建議 12GB 以上 NVIDIA 顯卡。仍需足夠的系統 RAM、相容 CPU 與磁碟空間,不能把 24GB 的示範速度套到 8GB。
AMD 顯卡或 Mac 可以照這篇安裝嗎?
不適用。這份 v0.1.13 安裝流程檢查 NVIDIA GPU 並使用 CUDA。支援 AMD CPU 不代表支援 AMD 顯卡,Apple Silicon 也不在這份流程的支援範圍。
32GB RAM 加大虛擬記憶體就夠嗎?
不要這樣規劃。指定版本的完整模型路線要求大量實體 RAM,最小量化的安裝需求值為 48GB。頻繁換頁會拖慢系統,較小模型通常是更實際的替代選項。
Strata 可以無限長對話嗎?
不行。請求仍受設定的上下文長度與記憶體限制。長任務成功不代表沒有上限,超出時應縮短歷史、開新對話或在硬體允許範圍內調整設定。
我的建議:先驗證日常任務,再追求最大模型
已有足夠 RAM 與相容 NVIDIA 顯卡,可以從較小量化、短上下文、純文字開始,再加入圖片與 Agent。先記錄一次真實工作從送出到完成的時間,確認成品可用,才決定是否值得投入更多硬體。
Strata 的價值是提供個人電腦執行大型模型的新方法。真正要比較的,是你的任務能不能穩定完成,而不只是參數量、瞬間速度,或某一次看起來很漂亮的展示。
資料核對日期:2026 年 9 月 29 日。安裝與量測以 v0.1.13 原始碼、文件及發行說明為基準。更新後請重新確認支援範圍、實際引擎版本與模型授權。
by Rain Chu | 9 月 17, 2026 | AI, 模型
Ornith 1.5 把本地 AI 的一個老問題攤得很清楚:每秒吐出多少 token,和最後有沒有把工作做完,是兩回事,35B-A3B 版本靠 MoE 架構降低每個 token 的運算量,在公開實測中展現速度優勢,也出現思考太久、額度用完卻沒交出程式碼的案例。
如果你想找一顆接在本地程式代理後面的模型,Ornith 1.5 35B 值得列入測試,評估時要一起看量化格式、記憶體餘裕、工具相容性與任務完成率,下面先拆開「自我改進」的意思,再看官方評分、兩組不同硬體的實測,以及實際上手順序。
Ornith 1.5 更新了什麼?先分清楚三種模型
Ornith 1.5 家族包含 9B Dense、35B MoE 與 397B MoE。手機部署的主角是 9B-Mobile 量化版本,與旗艦商用模型比較的宣傳則主要圍繞 397B。本文聚焦中間的 35B-A3B,不能把另外兩款的部署條件或成績直接套過來。版本資訊可從 官方模型集合查看。
如果你看過 Ornith 1.0 的自我拆解任務方式,這次最主要的延伸是把「生成訓練任務」也納入改善流程。
自我改進發生在訓練期間,下載後不會自動改寫權重
依照 Ornith 官方技術說明,模型在訓練中依序扮演三個角色:先根據程式庫與過去解題紀錄出題,再安排工具、指令與拆解方法,最後嘗試解題。結果回饋到強化學習流程,讓題目、執行安排與解法一起改善。
出題也有條件:題目要能驗證、難度合適,而且不能一直重複,官方把目標成功率設在約 20%,讓模型練習有挑戰但仍可能解出的題目。這個百分比是訓練課程的設計目標,不是產品的答題正確率。
可以把它想成練習寫程式時,不只修答案,也回頭調整練習題與測試方式。
下載回來的則是訓練後的模型權重,日常對話、保存記憶或反覆提示,不代表權重正在持續更新。
AlphaLab 對自我改進邊界的分析也提醒,環境與評分規則仍由人設計,分數上升還要確認是否真的學會解題。
35B-A3B 的 A3B,不是記憶體只要放下 3B
MoE 每次只選部分專家參與計算,但其他專家的權重仍要有地方存放。活躍參數主要影響每一步的運算量,總權重與快取才是估算記憶體的起點。官方 35B 模型頁列出約 3B 活躍參數,BF16 權重約 70GB,原生上下文為 262,144 token,模型規格與啟動範例可作為設定依據。
以目前 官方 GGUF 檔案清單為例,Q4_K_M 單一模型檔約 21.71GB,換算約 20.22GiB,這還沒加上推論引擎、上下文快取或視覺投影檔,因此「有 24GB 顯示記憶體」只能作為測試起點,不能直接承諾長上下文與多個並行任務都放得下。
12GB 或 16GB 顯示卡若想跑這個 Q4 檔,通常還得規劃部分權重放在系統記憶體,或改用其他量化版本,能載入模型、能順利對話、能在長任務中維持速度,應分開驗收。Mac 使用統一記憶體,也要預留系統空間,可搭配 本地 AI 的記憶體與頻寬選擇理解這個差別。
官方評分顯示程式能力進步,但要連測試框架一起看
以下是官方模型卡中同尺寸模型的部分成績。
Ornith 1.5 的結果為團隊自報的五次執行平均,並非本文重跑,也不等於所有電腦都會得到相同結果。
| 測試 | Ornith 1.5 35B | Ornith 1.0 35B | Qwen3.6 35B |
|---|
| Terminal-Bench 2.1/Terminus-2 | 67.8 | 64.2 | 52.5 |
| SWE-bench Verified | 79.0 | 75.6 | 73.4 |
| SWE-bench Pro | 59.6 | 50.4 | 49.5 |
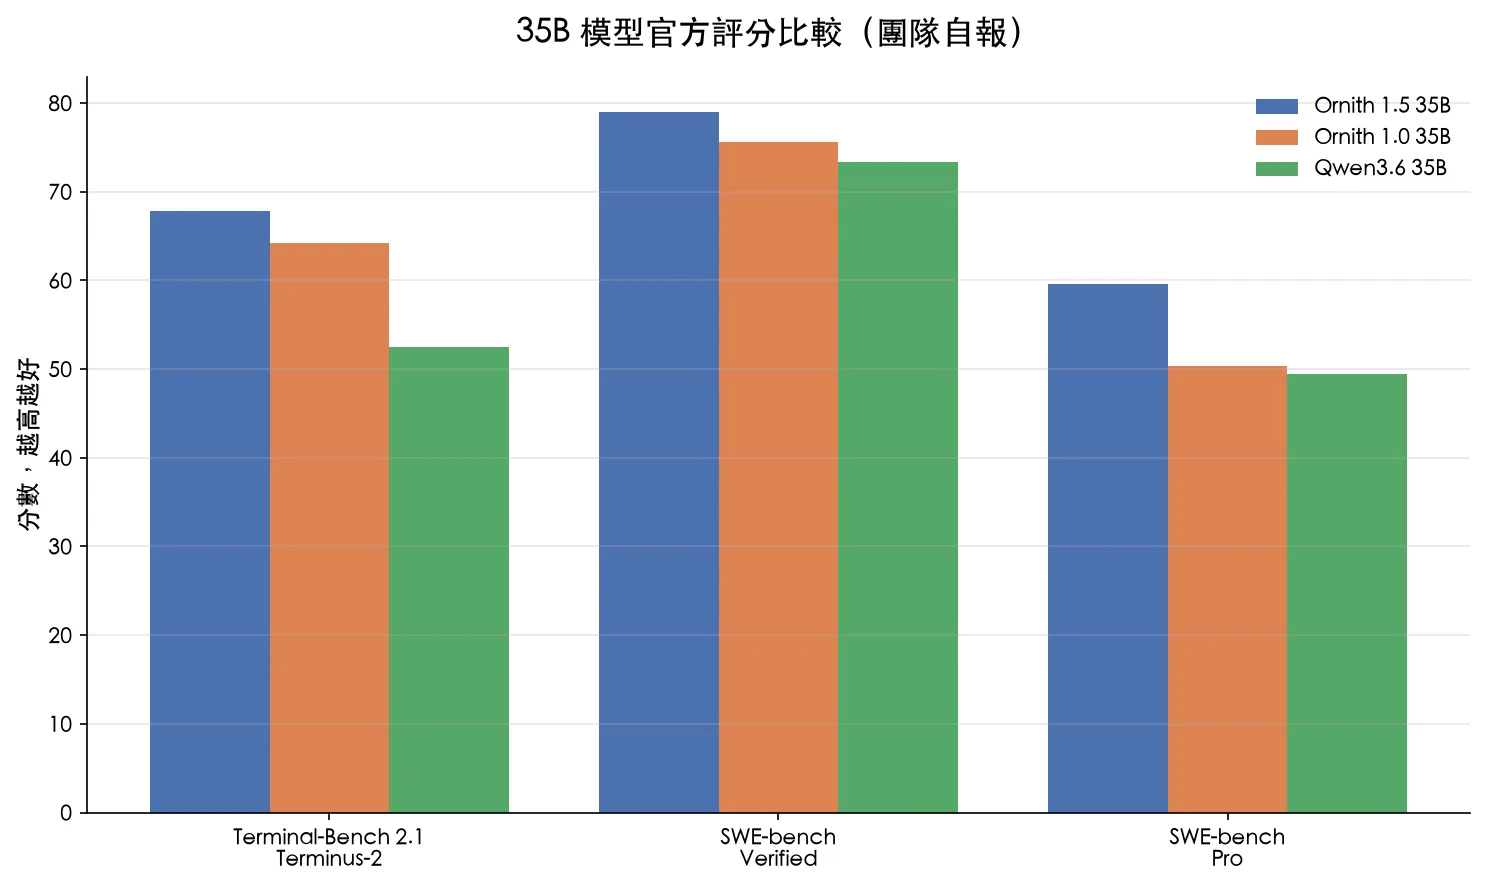 資料來源:Ornith 35B 官方模型卡。各項測試使用各自的評測設定,不能相加成通用能力分數。
Terminal-Bench 的上述結果使用 Terminus-2,SWE-bench 使用 OpenHands。工具、提示、可用時間與上下文都會影響代理表現。「追平 Claude Opus」應限於官方列出的特定 397B 比較,無法據此宣稱 35B 全面取代商用模型。
對上 Qwen3.8 27B:生成得快,整個任務卻可能更慢
DIY Smart Code 的 Benchy 本地測試使用 RX 7900 XTX 24GB、Ryzen 9、64GB 系統記憶體與 Ollama,比較兩款 Q4 模型。Ornith 測試標示 32K 上下文。這是作者自建測試集的一組案例,量化檔案與測試工具的細節限制了外部重現,不能當成通用排名。
| 同一組 Benchy 案例 | Ornith 1.5 35B | Qwen3.8 27B |
|---|
| 通過項目 | 18/21 | 20/21 |
| 生成速度 | 約 74 tok/s | 約 58 tok/s |
| 提示處理速度 | 約 850 tok/s | 約 240 tok/s |
| 整組耗時 | 約 26 分鐘 | 約 17 分鐘 |
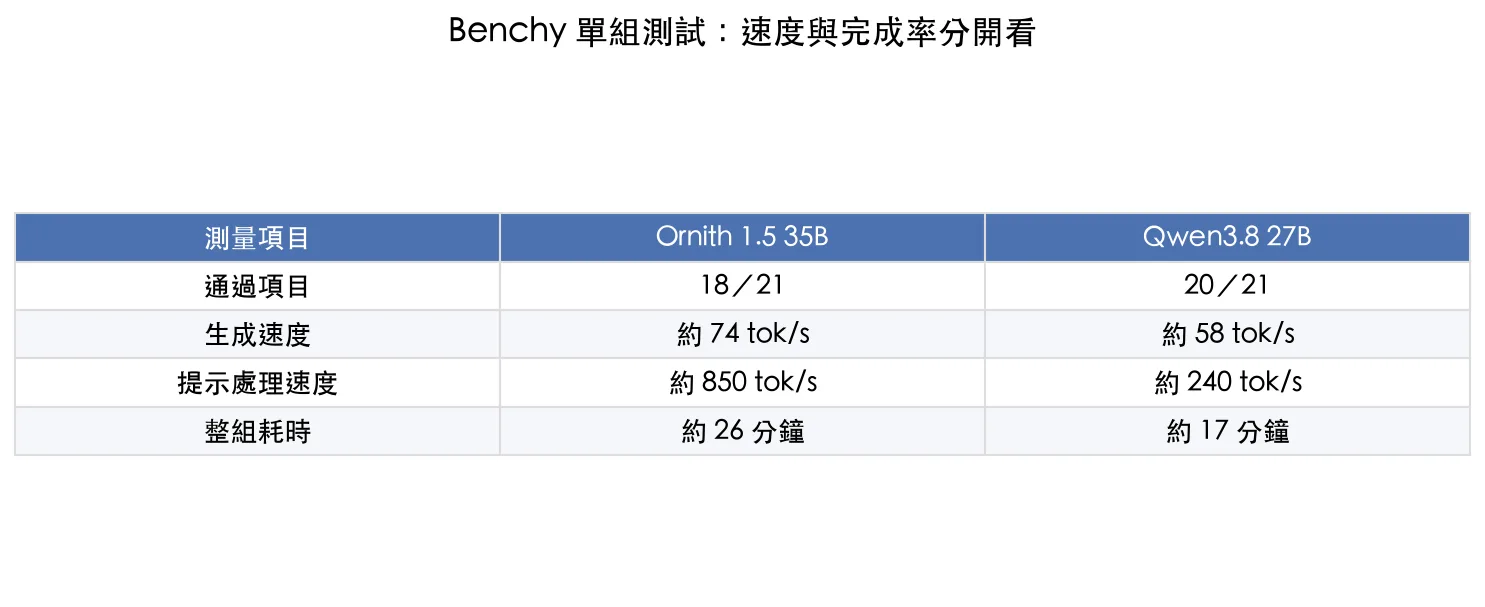 資料來源:DIY Smart Code,2026 年 8 月 22 日公開案例。數值依逐字稿約數整理,並非本文實測。
最有參考價值的是 DAG 非同步任務排程題:Ornith 花了約 18,000 個思考 token,耗盡輸出額度後沒有交出最終 Python 程式,Qwen 則完成程式並通過該題檢查。所以每秒輸出較快,仍可能因為思考與重試較多,拖長整個工作的時間。
這也不能反推成所有 MoE 都不擅長推理,或 Qwen 永遠比較穩,模型、量化、引擎與題型都不同,架構本身不能單獨解釋全部差異,要比較自己的程式任務,可參考 Qwen3.8 27B 本地部署教學,固定測試條件再重跑。
雙 GB10 的 NVFP4 實測:減少搬運,也能讓解碼加速
CyberQ 的雙 GB10 實測是在另一套硬體與 vLLM 環境中比較 BF16 與 NVFP4。它固定解碼 800 token,暖機後取三次量測中位數,因此較適合觀察格式差異,不適合直接和前面的 Ollama 成績排高低。
| 雙 GB10/TP=2 | BF16 | NVFP4 |
|---|
| 解碼吞吐量 | 48.41 tok/s | 101.86 tok/s |
| 12,001 token 提示處理 | 2,767 tok/s | 4,141 tok/s |
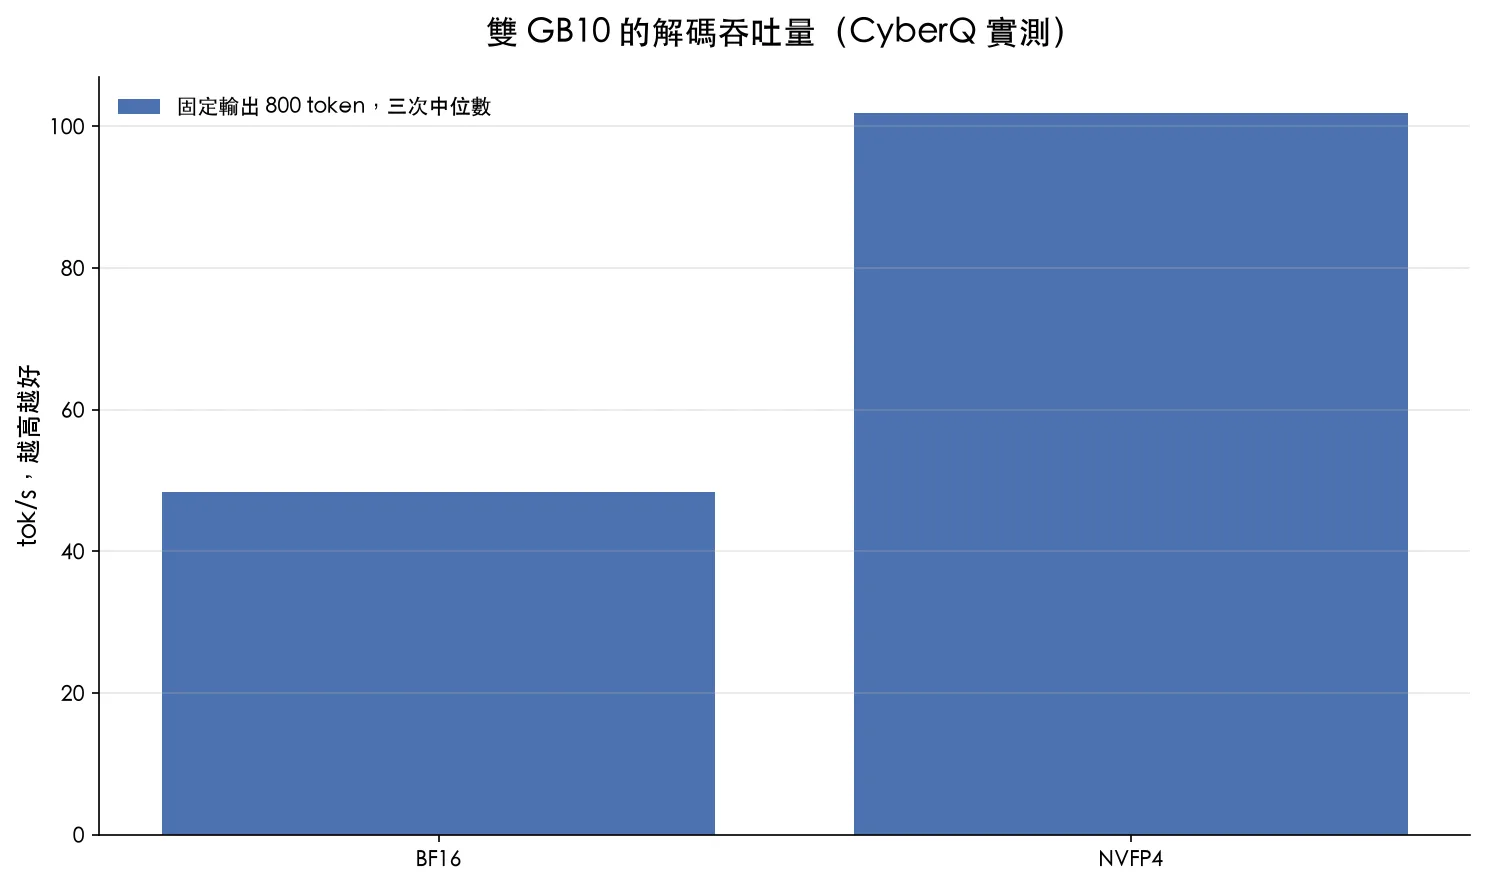 解碼約為 2.10 倍。這是特定硬體與引擎的量測結果。
該測試的 NVFP4 路徑先以低位元格式搬運權重,再反量化計算。當瓶頸是記憶體頻寬,減少搬運量就可能抵銷反量化成本。這是推論效率改善,不能解讀成硬體原生算力增加。
品質抽查中,兩種格式在 AIME 2026 都完成並答對 23/30 題,各有 7 題被輸出上限截斷。兩邊共同完成的 22 題答案一致,但答案一致不代表逐 token 的思考過程相同,也不能延伸成量化完全不損失品質。
本地部署怎麼開始?先讓短任務與工具呼叫跑通
先選權重格式與執行工具。桌面試用可從 GGUF 與 Ollama、llama.cpp 相容工具開始,伺服器則參考官方 vLLM 或 SGLang 範例。還不確定差別,可先看 本地大模型推論框架比較。
下載時認明 原始模型庫、官方 GGUF與 官方 NVFP4。另有 AtomicChat 的 GGUF 轉換版本可比較,請記錄實際檔名與量化等級,同樣寫 Q4 不表示所有檔案與執行結果完全相同。
測試時先縮短上下文、一次處理一個請求,確認記憶體與基本輸出正常,再逐步拉長。官方雖提供延伸到約 1M token 的設定,卻也提醒長上下文縮放可能影響一般長度的品質,不必第一次啟動就把視窗開到最大。
接代理前,再測試工具名稱、參數、工具結果回傳,以及模型能否繼續下一步。模型能輸出 tool_calls,只代表這段格式可用,MCP 伺服器還需要由代理程式接上。純聊天成功,不能代替完整工具流程驗收。
最後設定整個任務的時間、輸出與重試上限,並檢查所用引擎是否支援獨立思考額度。只縮小總輸出上限,可能更早截斷最終答案。日常試用可先用幾個有明確驗收條件的小任務,比較完成時間、人工修正量與失敗原因,再決定是否放入長時間自動化工作。
授權與手機部署,哪些說法還要保留?
T客邦的發布報導有助於了解系列定位,但授權敘述與官方 metadata 不一致。
本文以官方模型頁標示的 MIT 為準。
同樣地,9B-Mobile 支援行動裝置的宣稱,不能保證每一款手機都有足夠可用記憶體、支援對應模型格式,或能維持長上下文。先確認使用的 App、量化檔與裝置條件,比直接照搬桌面版的速度數字有用。
常見問題
Ornith 1.5 35B-A3B 是只有 3B 參數嗎?
不是。它是 35B 級 MoE 模型,每個 token 約啟用 3B 參數。儲存與載入仍需考慮完整權重,以及快取和引擎額外用量。
Ornith 1.5 放在本地使用會自己越來越聰明嗎?
官方的自我改進是訓練流程。下載後一般執行推論,不會因為聊天次數增加就自動更新模型權重。
24GB 顯示卡一定能跑 35B 的完整上下文嗎?
不能保證。官方 Q4_K_M 檔約 20.22GiB,還需預留引擎與快取空間。應從短上下文實測,再逐步調整。
Ornith 1.5 和 Qwen3.8 27B 該選哪個?
先用自己的任務比較。公開 Benchy 案例中 Ornith 生成較快,Qwen 通過較多項目。這組結果只適用於該測試條件。
這是美國團隊所推出的模型
Ornith 支援工具呼叫,就能直接連 MCP 嗎?
還需要代理程式與 MCP 連接層。應測試參數格式、工具執行與結果回傳的整個流程。
先看能否完成你的工作,再看分數有多高
Ornith 1.5 值得研究的地方,是它把練習題、工具安排與解法放進同一條訓練流程。而對本地使用者來說,35B-A3B 的實際價值仍要靠任務驗收:能不能在現有記憶體內跑穩、工具是否接得上,以及等待之後有沒有拿到可用成果。
先挑幾個你每週真的會做的工作,讓 Ornith 與現有模型各跑一次。保留設定、耗時與失敗紀錄,往往比看一張總排名更容易做出選擇。若想了解前述測試工具的設計,可再看 Benchy 測試工具建置說明。
by Rain Chu | 8 月 28, 2026 | AI, GGUF, Stable Diffusion, 圖型處理, 影片製作, 繪圖
LTX 2.3 把畫面、聲音、人物動作與鏡頭運動放進同一套生成流程,還能透過 ComfyUI 在本機執行,對只有 8GB 顯存的使用者來說,社群 GGUF 量化工作流確實打開了一扇門,但「能跑」不等於完整模型全放進顯存,也不代表每台電腦都能在不到一分鐘內完成。
我會把 LTX 2.3 定位成一個適合實驗同步影音、角色短片與圖生影片的本地模型,它可以成為 OpenMontage 本地 AI 影片工作流裡的生成引擎,也可以獨立放在 ComfyUI 裡反覆調整。真正要先弄清楚的,是權重版本、顯存、系統記憶體與工作流之間的關係。
LTX 2.3 改進了什麼
LTX 2.3 官方頁面把這次更新整理成幾個核心方向。新的 VAE 改善髮絲、材質與邊緣細節,較大的文字連接器能理解多主體、空間關係、動作與鏡頭指令,圖生影片減少了畫面凍結與只做平移縮放的情況,音訊也換上新的 vocoder,降低雜音、靜音缺口與突然中斷。
- 支援文生影片與圖生影片
- 能在同一個流程生成畫面與同步音訊
- 改善人物微表情、動作與鏡頭運動
- 原生支援最高 1080×1920 的直式影片
- 提供完整權重、Distilled、FP8 與社群量化方案
官方也提醒,LTX 2.3 採用新的 latent space,舊版 LoRA 不能直接當成完全相容的資產,通常需要重新訓練。這點比單純更新模型檔更重要,已經累積大量 LTX 2 工作流的人要先做相容性測試。
8GB 顯卡能跑,但要先拆掉一句話裡的誤會
官方 ComfyUI 文件把標準本地工作流的前置條件列為 32GB 以上顯存與 100GB 以上可用磁碟空間。8GB 顯卡路線使用的是社群 GGUF 量化權重、模型卸載與系統記憶體,不是把 BF16 完整權重硬塞進 8GB 顯存。
| 版本 | 適合用途 | 主要取捨 |
|---|
| BF16 Dev | 品質驗證與正式輸出 | 硬體需求最高 |
| Distilled | 快速迭代與工作流測試 | 速度優先 |
| FP8 | 較低顯存的官方量化路線 | 品質與資源需求折衷 |
| GGUF Q4 或 Q5 | 8GB 到 16GB 顯存的社群工作流 | 依賴 CPU offload、系統記憶體與相容節點 |
以 QuantStack 的 LTX 2.3 GGUF為例,Q5_K_S 檔案約 18.5GB,已經大於 8GB 顯存。能在 8GB 顯卡執行的關鍵,是工作流不要求所有資料同時留在 GPU。代價是更吃系統記憶體與資料搬移時間。想進一步理解 GGUF 與量化的角色,也可以對照站內的本地模型推理框架比較。
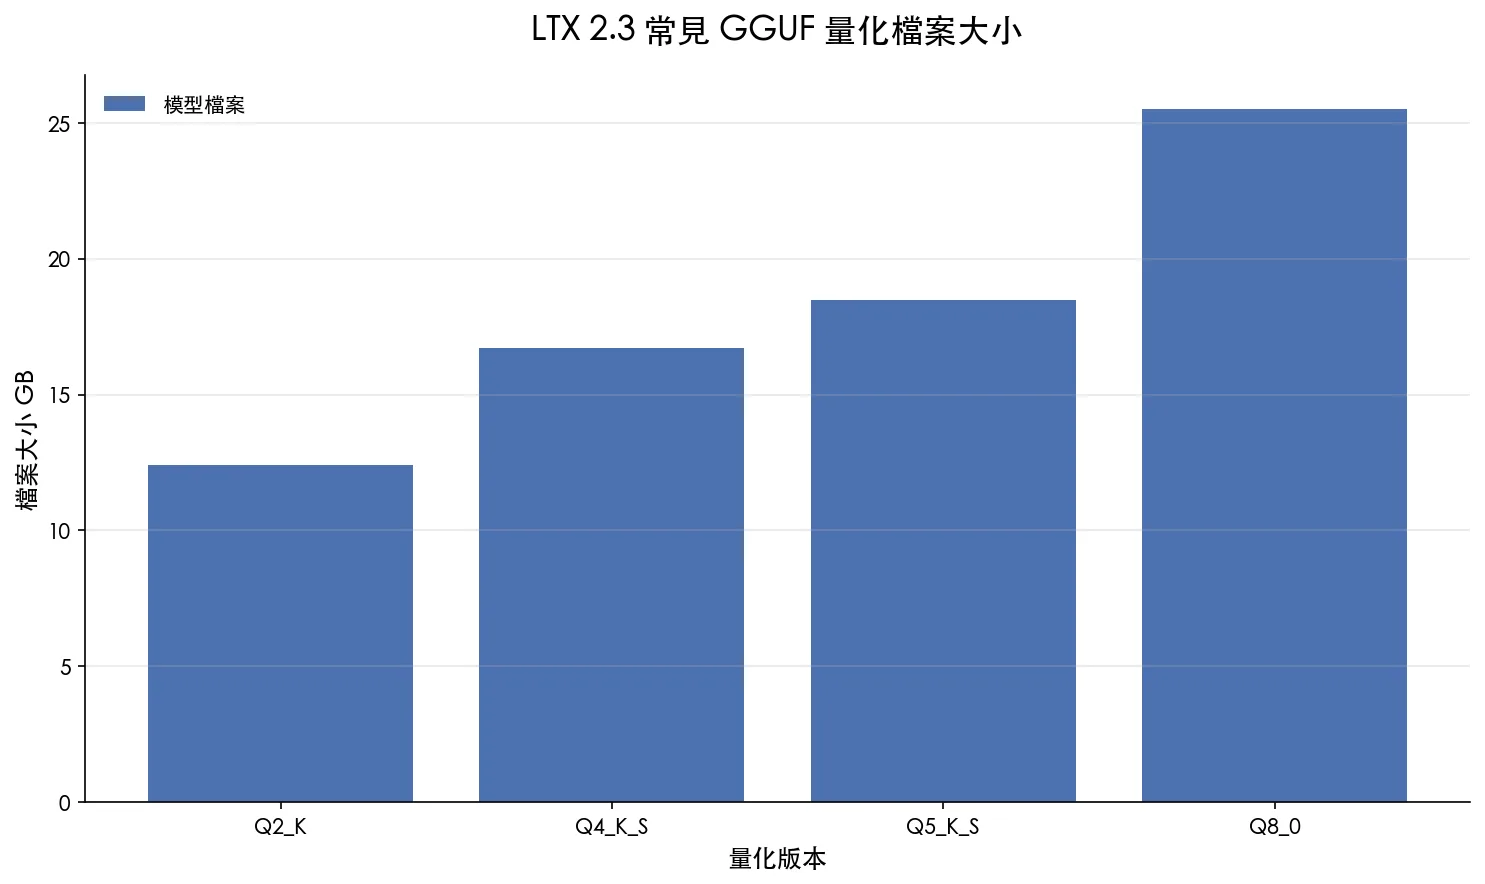 GGUF 檔案大小不等於最低顯存需求,但能直接看出為什麼 8GB 路線必須依賴卸載與系統記憶體
我的硬體建議很簡單。,GB 顯存可以從 Q4 或經驗證的低顯存工作流開始,系統記憶體最好準備 32GB 以上,12GB 到 16GB 顯存會比較有調整空間。若要使用 BF16、較高解析度、長片段或多階段放大,32GB 以上顯存才接近官方設定,實際速度還會受 GPU 架構、RAM、磁碟、解析度、影格數與節點版本影響。
最省事的安裝方法是官方模板
第一次安裝不要急著手動搬十幾個檔案,先把 ComfyUI 更新到支援 LTX 2.3 的版本,再用模板庫建立一條能正常執行的基準工作流,這和我整理 Ideogram 4 的 ComfyUI 本機部署時採用的思路一樣,先跑通官方基線,再加入量化與自訂節點。
- 開啟 ComfyUI Desktop 或現有 ComfyUI
- 完成程式與前端更新後重新啟動
- 進入 Templates 並切換到 Video
- 搜尋 LTX-2.3
- 先安裝 Image to Video 與 Text to Video 模板
- 按下 Download all 取得必要模型
- 重新啟動後先用低解析度與少量影格測試
官方建議先用 480×720 與 41 到 81 個影格確認流程,工作流穩定後,再提高解析度、片長與品質。這一步看起來保守,卻能很快分辨問題來自模型、節點、顯存,還是提示詞。
手動安裝時,模型應該放在哪裡
ComfyUI Desktop、Portable 與自行安裝版的根目錄可能不同,最穩的方法是從 ComfyUI 介面打開模型資料夾,再依下面的相對路徑放置。不要直接照抄別人的 Windows 使用者名稱。
| 檔案類型 | 建議路徑 | 用途 |
|---|
| 官方主模型 | models/checkpoints/LTX-Video | BF16、Distilled 或官方檢查點 |
| 社群 GGUF | models/unet | 交給 GGUF Loader 載入 |
| 文字編碼器 | models/text_encoders | Gemma 3 與 LTX 文字投影 |
| 視訊與音訊 VAE | models/vae | 解碼影像、聲音與預覽 |
| LTX 2.3 LoRA | models/loras/LTX-2.3 | Distilled、風格或控制能力 |
原始權重可從 LTX 2.3 Hugging Face取得。官方推理程式與訓練工具位於 Lightricks LTX-2 GitHub,ComfyUI 節點與範例工作流則在 ComfyUI-LTXVideo。
匯入工作流後出現紅色節點怎麼辦
紅色節點通常不是模型壞掉,而是工作流引用了本機尚未安裝的自訂節點。先在錯誤視窗選擇 Install Missing Custom Nodes,完成後按 Apply Changes 並重新啟動,若仍缺少 Fast Groups Bypasser 類節點,可在 Manager 搜尋並安裝 rgthree-comfy。
GGUF 權重還需要 ComfyUI-GGUF。安裝後重新啟動,在畫布空白處搜尋 GGUF Loader,把原本模型載入器的輸出改接到工作流的 model 輸入,再重新整理節點並選擇 Q4 或 Q5 檔案。
一個可以直接改寫的繁中提示詞
LTX 2.3 的提示詞不要只寫「讓照片動起來」。把人物動作、對白、聲音、鏡頭、畫質與禁止項目分開,模型比較容易理解時間順序與同步關係。
場景與動作
一名年輕女子站在安靜的室內,先看向鏡頭,再輕輕吸一口氣,以略帶緊張但自然的神情說話。嘴唇清楚說出指定的中文台詞,嘴型與發音準確同步。

聲音
自然的年輕華語女聲,語氣柔和、真實、略帶緊張,像日常交談,不要誇張。保留輕微呼吸聲與安靜室內環境音,不要配樂。

鏡頭
鏡頭緩慢推近臉部,只有很輕微的手持感。淺景深,焦點穩定,自然室內光線。

畫面品質
寫實電影感,皮膚紋理自然,眼神與微表情細膩,髮絲運動合理,動作流暢,人物身份保持一致。

避免項目
不要字幕,不要畫面文字,不要額外人物,不要旁白,不要機械聲,不要誇張表情,不要臉部變形,不要嘴唇變形,不要突然移動鏡頭。
實際使用時,把第一段換成你的角色、場景、動作與台詞即可。先固定一個鏡頭與一個主要動作,再逐步增加人物、轉場與複雜聲場。一次要求太多事件,往往比模型能力不足更容易造成身份漂移。
中文對白可用,但字幕最好留給後製
實測裡最值得記下來的缺點,是中文畫面文字仍可能出現亂碼,即使官方表示文字渲染已改善,這不代表長句中文字幕已經可靠,若提示詞要求中文對白,模型有時還會自行生成錯誤字幕。
- 提示詞明確加入「不要字幕、不要畫面文字」
- 先生成乾淨畫面與聲音
- 輸出後再用剪輯軟體或字幕工具加入繁中字幕
- 若聲音品質不穩,可把畫面生成與語音生成拆成兩條工作流
需要更細的角色音色控制時,可以搭配Qwen3-TTS 音色設計工作流,讓 LTX 2.3 專注畫面,再由語音模型與後製負責台詞品質,這通常比強迫單一模型同時把中文聲音與中文字都做到完美更務實。
本地還是雲端,差別不只在費用
本地工作流的優點是素材不必上傳第三方、模型與節點可自行調整,而且安裝完成後沒有逐秒 API 費用,缺點是模型檔很大,節點版本容易衝突,還要自己處理顯存與輸出速度。若你比較在意快速試模板與交付,也可以對照RunningHub 的雲端 ComfyUI 工作流,再決定控制權與便利性哪個重要。
解除限制版本不是品質保證
社群常用「無審查」或「解除限制」描述修改版權重。這只代表輸入限制可能不同,不代表畫質、授權、安全性或商用條件比官方版本更好。下載前要確認模型來源、授權條款與檔案雜湊,人物照片與聲音也必須取得同意。
尤其是換臉、移除人物、替換台詞與生成擬真人物時,更要避免冒用身份、未經同意的私密內容與誤導性成品。LTX 官方也有商業授權條件,企業使用前應直接閱讀最新授權,而不是只看模型能不能下載。
下載與參考資源
我的結論
如果目標是直式角色短片、圖生影片、帶環境音的短場景,LTX 2.3 很值得測,若目標是穩定中文字、長篇敘事或大量商業輸出,仍要把字幕、語音、剪輯與品質檢查拆成獨立步驟。模型負責生成,工作流負責把結果變成可以交付的作品。
FAQ
LTX 2.3 真的能在 8GB 顯卡執行嗎
可以,但通常要使用 GGUF 量化權重、CPU offload 與足夠的系統記憶體。8GB 指的是可嘗試的顯存門檻,不代表完整模型全放在 GPU,也不保證固定生成速度。
新手應該選 BF16、FP8 還是 GGUF
先用官方 Distilled 或 FP8 模板確認工作流。顯存不足再改用 GGUF。BF16 適合硬體充足並且重視品質的人,GGUF 適合願意接受卸載、速度與相容性取捨的低顯存使用者。
為什麼匯入工作流後有紅色節點
多半是缺少自訂節點或節點版本太舊。先執行 Install Missing Custom Nodes,再更新 ComfyUI、ComfyUI-LTXVideo、rgthree-comfy 與 ComfyUI-GGUF,完成後重新啟動。
中文對白為什麼會出現亂碼字幕
模型可能把對白理解成需要同步生成的畫面文字,而中文長句仍不穩定。提示詞加入不要字幕與不要畫面文字,先生成乾淨影音,再於後製加入繁中字幕最可靠。
LTX 2.3 可以離線使用嗎
模型、節點與依賴下載完成後可以在本機執行。首次安裝、更新模型或補齊節點仍需要網路,並且要預留足夠磁碟空間。
by Rain Chu | 8 月 26, 2026 | 未分類
DeepSeek V4 Flash 0731 最值得注意的,不只是模型跑得更快,而是 Agent 能力明顯補強,它可以在 Agent 框架裡撰寫程式、呼叫工具、修正錯誤,完成遊戲、互動網頁與自動化任務,這是一個 284B 總參數的 MoE 大模型,即使每次只啟用 13B 參數,完整權重仍然很大。
模型權重採 MIT 授權,可以免費下載,但本機部署並不便宜,Unsloth 的 3-bit GGUF 約 103GB,建議至少準備 110GB 可用記憶體,接近無損的 Q4 版本約 155GB,較適合 192GB 記憶體工作站或多卡伺服器,一般 16GB、32GB,甚至 64GB 電腦都不適合硬跑完整模型。
DeepSeek V4 Flash 0731 是什麼
DeepSeek V4 Flash 0731 是 V4 Flash 的正式開源版本,官方模型卡表示,新版延續 Flash DSpark 架構,加入 speculative decoding 模組,並針對 Agent 任務完成新的後訓練。模型總參數為 284B,每次推理啟用約 13B 參數,最大上下文為 1,048,576 tokens。
| 項目 | 規格 | 實際意義 |
|---|
| 總參數 | 284B | 權重檔案很大,不能用 13B 模型的硬體需求估算 |
| 啟用參數 | 13B | MoE 每次只啟用部分專家,有助降低運算量 |
| 最大上下文 | 1M tokens | 理論上可處理超長任務,但 KV cache 會大量吃記憶體 |
| 授權 | MIT | 可下載、修改與商業使用,仍需遵守授權條款 |
| 主要強項 | Agent 與工具使用 | 適合程式開發、工具呼叫與長流程自動化 |
這裡最容易誤會的是 13B 啟用參數,它代表單次前向運算只會用到部分專家,不代表只需要載入 13B 權重。完整 MoE 權重依然要放進記憶體,所以本機部署需求遠高於一般 13B 模型。
Agent 能力提升多少
官方模型卡列出的 Agent 評測顯示,0731 版比 V4 Pro Preview 進步很多,Terminal Bench 2.1 從 72.1 提升到 82.7,DeepSWE 從 12.8 提升到 54.4,Toolathlon Verified 從 55.9 提升到 70.3,AutomationBench Public 則從 12.8 提升到 25.1。
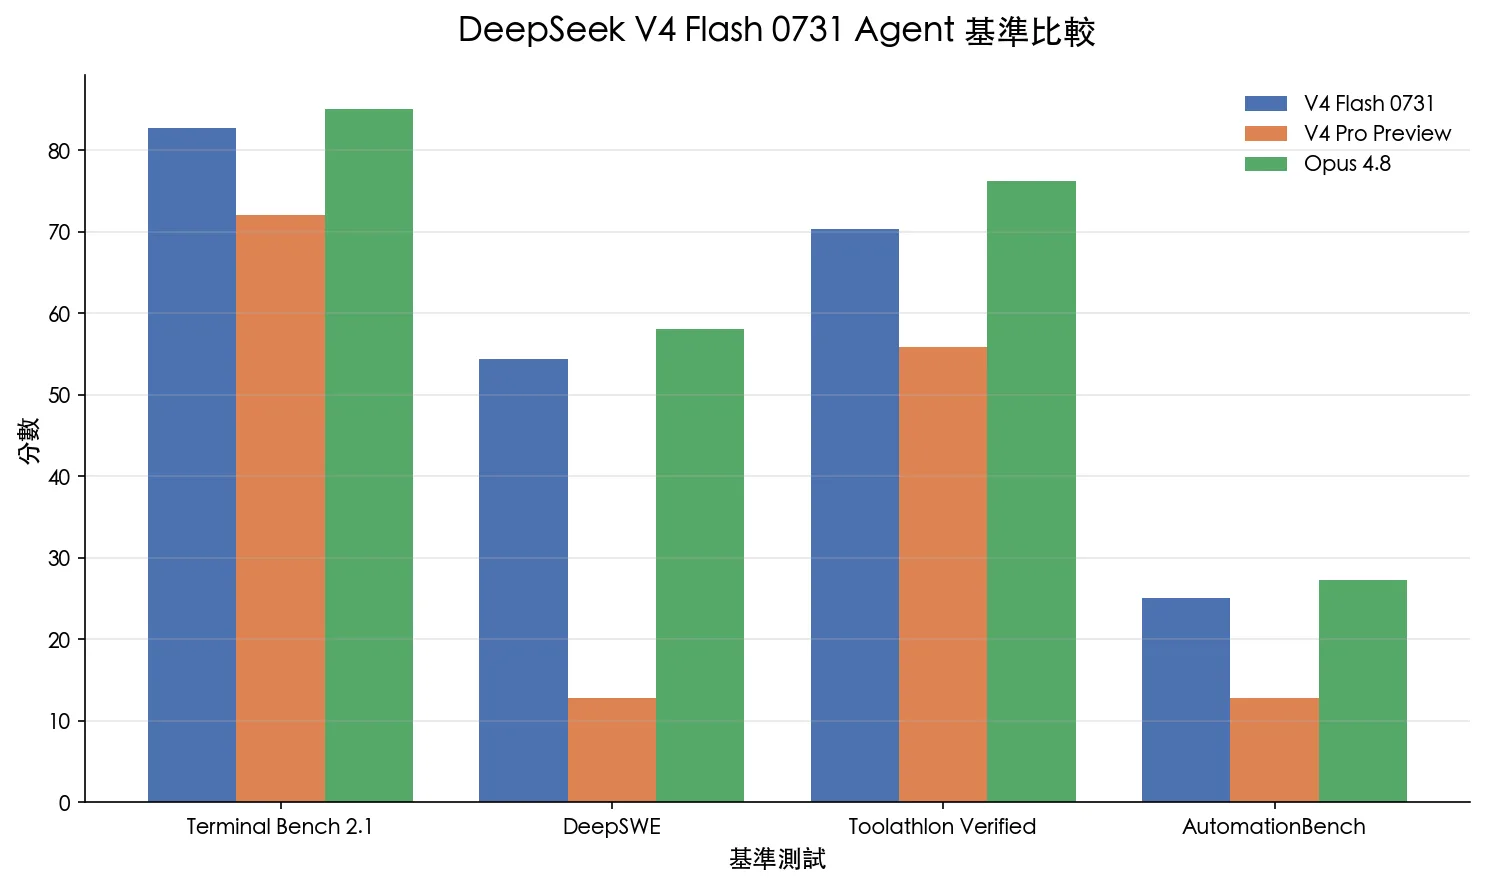 DeepSeek V4 Flash 0731 的 Agent 評測大幅領先 Preview,但多數項目仍略低於 Opus 4.8。資料來自官方模型卡。
| 評測 | V4 Flash 0731 | V4 Pro Preview | Opus 4.8 |
|---|
| Terminal Bench 2.1 | 82.7 | 72.1 | 85.0 |
| DeepSWE | 54.4 | 12.8 | 58.0 |
| Toolathlon Verified | 70.3 | 55.9 | 76.2 |
| AutomationBench Public | 25.1 | 12.8 | 27.2 |
這些分數不能直接等同於所有人的使用體驗,但是各大 AI 網紅們都給予極高的肯定,官方的程式 Agent 評測使用 DeepSeek Harness minimal mode,搭配 max reasoning、temperature 1.0 與 top_p 0.95。部分 DSBench 項目也是內部資料集,模型、Agent 框架、提示詞、工具權限和驗證流程都會影響最後結果。
為什麼能做出 2D、3D 遊戲和太陽系
實際展示涵蓋 2D 平台遊戲、3D 闖關遊戲、太陽系模擬、圖片生成與影片生成流程。這些結果證明它很適合放進 Hermes Agent 一類的工具框架,但不能解讀成模型本身具備完整視覺能力。
DeepSeek V4 Flash 0731 的核心仍是文字模型,它會產生 HTML、JavaScript、Three.js 或其他程式碼,再由 Agent 啟動瀏覽器、執行程式與呼叫外部圖片工具,若 Agent 沒有截圖回饋或視覺模型協助,它無法像多模態模型一樣直接看見成果,前端展示看起來很完整,功勞來自模型能力與 Agent 工具鏈的組合。
要評估這類展示,我會看三件事
第一是第一次產出的可用程度.
第二是 Agent 能否自行執行並找出錯誤。
第三是移除人工協助後能否重複成功。
免費到底指什麼
「免費」至少有三種不同意思,最好分開看。
- 開源權重免費:模型採 MIT 授權,可以從 Hugging Face 下載。
- 網頁聊天免費:官方網站可能提供免費額度,但服務規則可能調整。
- API 免費活動:公測或限時額度不代表永久免費,串接正式服務前應重新查價。
截至 2026 年 8 月 1 日,DeepSeek 官方 API 文件已列出 deepseek-v4-flash 的計費資訊,每百萬 input tokens 在 cache hit 時為 0.0028 美元,cache miss 為 0.14 美元,output 為 0.28 美元。價格與活動可能隨時改變,上線前應以官方定價頁為準。
本機執行雖然沒有按 token 付 API 費用,卻要負擔記憶體、GPU、儲存空間、電力與維護成本。對偶爾使用的人來說,API 可能反而比較便宜。對需要大量批次處理、資料不能離開內網,或想研究 Agent 框架的人,本機部署才更有價值。
Q4 為什麼還要約 155GB
DeepSeek V4 Flash 0731 在訓練時已採用量化感知訓練,約 96% 的 routed experts 原生使用 MXFP4,其餘權重使用 FP8 或 BF16,Q4 並不是把一個完整 BF16 模型全部壓成四分之一,而是保留原本已經是 4-bit 的專家,再量化其他張量。
這也解釋了為什麼 Unsloth 的 UD-Q4_K_XL 仍約 155.1GB,和官方參考權重 156.4GB 很接近,它的重點不是極端縮小檔案,而是在維持原生 MXFP4 專家的前提下,降低非專家張量的空間。UD-Q8_K_XL 約 161.9GB,Unsloth 將它定位為接近位元層級重建的無損版本。
| 量化版本 | 約略大小 | 建議記憶體 | 適合情境 |
|---|
| 1-bit | 約 92GB | 至少 96GB | 以能跑為優先,品質犧牲較大 |
| 2-bit | 約 102GB | 至少 110GB | 記憶體緊張的測試用途 |
| UD-IQ3_XXS | 約 103GB | 110GB 到 128GB | 128GB 裝置的實用起點 |
| UD-Q4_K_XL | 約 155GB | 建議 192GB | 接近無損品質 |
| UD-Q8_K_XL | 約 162GB | 建議 192GB 以上 | 重視精度與重現性 |
表格只算模型權重仍不夠,作業系統、llama.cpp、KV cache 與長上下文都需要額外空間,128GB 機器即使用 103GB 版本,也不應一開始就把 context 設成 1M,先從 32K 或更低開始,確認速度與記憶體餘裕,再逐步增加。
量化概念也可以參考我整理的 MXFP8、NVFP4 與不同量化格式比較,不要只看檔名裡的 Q4,還要看原始權重格式和哪些張量被量化。
用 Unsloth Studio 安裝
想用圖形介面管理模型,可以先裝 Unsloth Studio,macOS、Linux 與 WSL 使用下面的命令。
curl -fsSL https://unsloth.ai/install.sh | sh
Windows PowerShell 使用下面的命令。
irm https://unsloth.ai/install.ps1 | iex
安裝完成後啟動服務。
unsloth studio -H 0.0.0.0 -p 8888
如果只在本機使用,建議不要對外開放 8888 連接埠。需要從區域網路操作時,應搭配防火牆、反向代理與登入驗證。
用 llama.cpp 下載與執行 GGUF
Unsloth 官方文件提供 Hugging Face 直接載入方式。以下先以 UD-IQ3_S 為例。記憶體更緊張時,可在模型頁改選 UD-IQ3_XXS。
export LLAMA_CACHE="unsloth/DeepSeek-V4-Flash-0731-GGUF"

./llama.cpp/llama-cli \
  -hf unsloth/DeepSeek-V4-Flash-0731-GGUF:UD-IQ3_S \
  --ctx-size 32768 \
  --temp 1.0 \
  --top-p 1.0 \
  --min-p 0.0
若要先完整下載指定分片,可以使用 Hugging Face CLI。
hf download unsloth/DeepSeek-V4-Flash-0731-GGUF \
  --local-dir unsloth/DeepSeek-V4-Flash-0731-GGUF \
  --include "*UD-IQ3_S*"
大型 GGUF 往往分成多個檔案,下載前先確認磁碟空間與網路穩定度。不同作業系統、CPU、GPU offload 比例與記憶體頻寬都會影響速度,想比較其他引擎,可以看 vLLM、SGLang、llama.cpp、MLX 與 Ollama 推理框架比較,若使用 DGX Spark,也可參考 DGX Spark 搭配 GGUF 與 llama.cpp 的實作方式。
推理參數怎麼設
官方與 Unsloth 建議 temperature 1.0。一般對話可用 top_p 1.0,Agent 任務則可改成 top_p 0.95。Think High 是預設的深度推理模式。Think Max 需要更大的輸出與上下文空間,官方建議至少預留 384K,並不適合記憶體剛好壓線的本機環境。
- 一般對話:temperature 1.0,top_p 1.0
- Agent 任務:temperature 1.0,top_p 0.95
- 本機初次測試:context 從 16K 或 32K 開始
- 長任務:先監看記憶體與輸出速度,再增加 context
本機執行與隱私安全
把開源權重放在自己的機器上,可以降低提示詞和文件傳送到第三方服務的需求,但不代表自動安全,仍要確認模型來源、雜湊值、推理程式、下載腳本與網路連線,處理公司資料時,也要記錄哪些 Agent 工具有檔案、終端和瀏覽器權限。
Agent 會執行模型產生的程式碼,風險比單純聊天高,建議使用容器、虛擬機或權限受限的工作目錄,並在刪除檔案、安裝套件、登入網站、發送資料與付費操作前要求人工確認,模型能完成任務,不代表每個操作都值得信任。
若你希望在本機開發工具裡使用模型,可以延伸閱讀 Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境,再依自己的硬體改用 llama.cpp 或相容 API。
誰適合部署
DeepSeek V4 Flash 0731 適合擁有 128GB 以上統一記憶體工作站、多卡伺服器、DGX Spark 類設備,並且真的需要 Agent、自動化或大量私有資料處理的人,它也適合研究 MoE、推測解碼和量化感知訓練。
如果只是想體驗模型能力,先用官方網頁或 API 更合理。16GB 到 64GB 電腦不必為了完整模型勉強選極低位元量化,你會付出很長的載入時間、很慢的生成速度和明顯品質損失,最後還不一定比雲端便宜。
我的判斷
DeepSeek V4 Flash 0731 真正的進步,是從擅長回答問題,往可以在工具環境中完成工作的方向前進,Agent 評測已經逼近高階閉源模型,開源權重也讓企業有機會把資料和推理留在自己的環境。
它仍不是一般消費級電腦的輕量模型,284B 總參數決定了權重與記憶體成本,13B 啟用參數無法改變這件事,對多數人最務實的路線,是先用 API 驗證工作流,只有在使用量、隱私或客製化需求足夠明確時,再投資 128GB 到 192GB 的本機部署環境。
參考資料
FAQ
DeepSeek V4 Flash 0731 可以在 64GB 電腦執行嗎?
不建議。Unsloth 最小的實用量化仍接近 92GB,3-bit 推薦版本約 103GB,還要保留 KV cache 與系統空間。較合理的起點是 110GB 可用記憶體,128GB 裝置會比較實際。
為什麼只有 13B 啟用參數,權重卻超過 100GB?
13B 是每次推理被路由啟用的參數量。模型共有 284B 參數,完整專家權重仍要載入記憶體,因此硬體需求不能用一般 13B 模型估算。
DeepSeek V4 Flash 0731 是多模態模型嗎?
它主要是文字與程式模型。遊戲和視覺成果通常由 Agent 執行程式碼或呼叫外部工具產生。若要讓 Agent 看見並判斷畫面,還需要瀏覽器截圖回饋或另外接入視覺模型。
DeepSeek V4 Flash 0731 完全免費嗎?
模型權重採 MIT 授權,可免費下載。官方網頁可能有免費額度,API 則應依當下定價。自行部署還有硬體、電力、儲存與維護成本。
by Rain Chu | 8 月 19, 2026 | AI, GGUF, QWEN, 模型
Qwen3.8-27B 把文字、圖片、影片、程式設計與 Agent 工作流放進同一個稠密模型,對想把 AI 留在本機的人來說,這是一個能力和硬體成本相對平衡的新選擇。
16GB 顯卡不要直接選 Q4_K_M,因為 15.9 GiB 只是主模型檔案,還沒有算約 0.86 GiB 的視覺投影模型、KV Cache 與執行環境。比較實際的選擇是 Q3_K_M 或 UD-Q3_K_XL,再從 8K 上下文開始測試。8GB 顯卡雖然可以用極低位元量化搭配系統記憶體卸載,但不等於 27B 多模態模型能完整放進 8GB 顯示記憶體。
Qwen3.8-27B 是什麼
Qwen3.8-27B 官方模型採用 Apache 2.0 授權,是一個 27B 參數的稠密視覺語言模型,它不是只會聊天的純文字模型,而是原生理解圖片與影片,也把程式設計、專業工作、研究和長時間 Agent 任務列為主要能力。
- 27B 稠密模型,64 層,Hidden Dimension 為 5120
- 原生支援圖片與影片理解
- 原生上下文長度 262,144 tokens,可透過 YaRN 延伸到 1,000,000 tokens
- 支援思考與非思考模式,也能用 reasoning_effort 調整推理深度
- 訓練時加入多步 MTP,執行環境支援時可用於推測解碼
如果你正在比較本地模型,建議先看站內的Qwen 3.6 的 27B、35B、MXFP8 與 NVFP4 比較,Qwen3.8-27B 延續 27B 稠密模型的定位,但多模態、Agent 執行和思考控制都更完整。
MTP 和 noMTP 差在哪裡
MTP 是 Multi-Token Prediction,一般自迴歸模型每次產生一個 token,MTP 會另外預測後續多個候選 token,再由主模型驗證,推理框架支援推測解碼時,可以減少逐 token 等待的成本,提升生成速度。
Qwen3.8-27B 的官方架構包含 MTP,Unsloth 的 Qwen3.8 指南也提供 MTP 量化版本,noMTP 通常是社群為了相容性或降低額外負擔而移除 MTP 預測頭的版本,你的 llama.cpp 太舊、載入失敗,或記憶體非常緊時,可以把 noMTP 當作相容性選項。新版推理環境能正常使用 MTP 時,則優先保留。
16GB 顯卡該下載哪一個 GGUF
| 可用記憶體 | 建議量化 | 主模型大小 | 實際建議 |
|---|
| 8GB | UD-IQ2_XXS | 約 8.4 GiB | 仍需系統記憶體卸載,不建議當作完整多模態體驗 |
| 12GB | UD-IQ2_M 或 Q3_K_S | 約 9.6 到 11.7 GiB | 使用短上下文,接受較明顯的量化損失 |
| 16GB | Q3_K_M 或 UD-Q3_K_XL | 約 12.9 或 12.5 GiB | 最實際的平衡,先用 8K 上下文 |
| 24GB | Q4_K_M 或 Q5_K_M | 約 15.9 或 18.5 GiB | 能保留較好的品質,也有空間給視覺與 KV Cache |
| 32GB | Q6_K 或 Q8_0 | 約 21.3 或 27.1 GiB | 適合重視品質與較長上下文的使用者 |
檔案大小依 Unsloth Hugging Face 儲存庫計算,實際記憶體還要加上視覺投影模型、KV Cache 與執行環境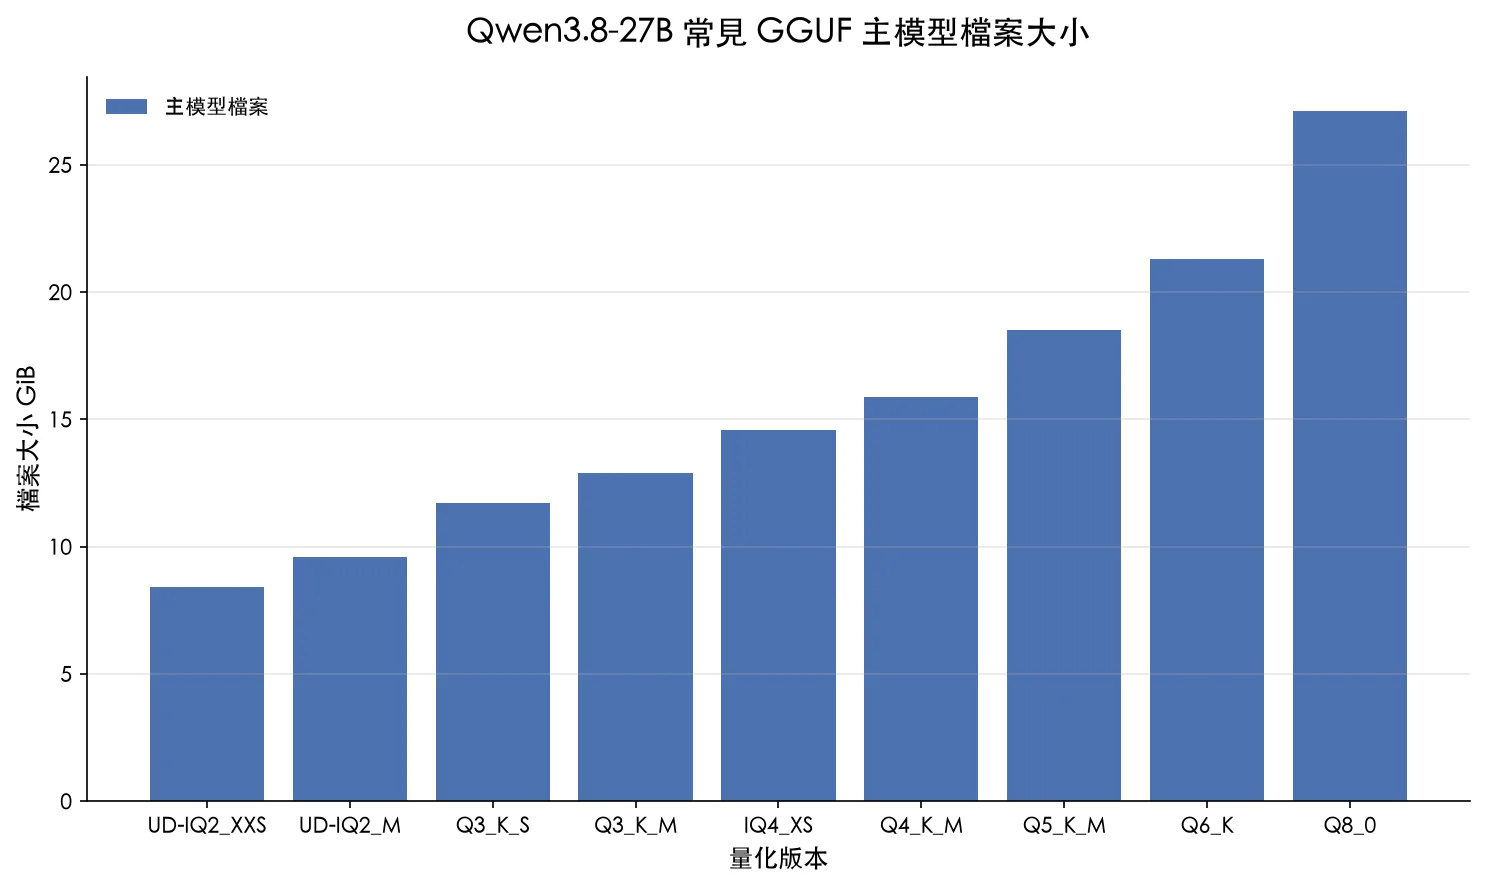 主模型從 8.4 GiB 的 2-bit 到 27.1 GiB 的 Q8_0,數字不包含額外執行記憶體
Q4_K_M 的檔案約 15.9 GiB,看起來很接近 16GB,但視覺功能還需要 mmproj-F16.gguf,檔案約 0.86 GiB,再加上 KV Cache 後,16GB 顯卡通常沒有足夠餘裕。若只跑文字、上下文很短,而且願意部分卸載到系統記憶體,IQ4_XS 可能可以啟動,但這不是我會給一般使用者的預設建議。
量化位元越低,檔案越小,但指令遵循、長文本穩定性、程式正確率和視覺判斷都可能下降。16GB 使用者如果重視穩定性,有時候選較小參數模型的 4-bit 或 8-bit,會比硬塞 27B 的 2-bit 更實用。
用 llama.cpp 在本機啟動
個人電腦要跑 GGUF,llama.cpp 仍然是很直接的底座。Windows 使用者可以從 llama.cpp Releases 下載對應版本,NVIDIA 顯卡選 CUDA,AMD 顯卡可用 Vulkan,沒有獨立顯卡則選 CPU 版本,框架定位和差異可以延伸閱讀vLLM、SGLang、llama.cpp、MLX 與 Ollama 比較。
一 下載主模型與視覺投影模型
pip install -U "huggingface_hub[cli]"

hf download unsloth/Qwen3.8-27B-GGUF \
  Qwen3.8-27B-Q3_K_M.gguf \
  mmproj-F16.gguf \
  --local-dir Qwen3.8-27B-GGUF
24GB 顯卡可以把 Q3_K_M 換成 Q4_K_M。只處理文字時可以先不載入 mmproj,等基本對話穩定後再加入視覺功能。
二 啟動 OpenAI 相容端點
llama-server \
  --model Qwen3.8-27B-GGUF/Qwen3.8-27B-Q3_K_M.gguf \
  --mmproj Qwen3.8-27B-GGUF/mmproj-F16.gguf \
  --host 127.0.0.1 \
  --port 8080 \
  --ctx-size 8192 \
  --n-gpu-layers 99 \
  --jinja \
  --chat-template-kwargs '{"reasoning_effort":"medium"}'
Windows 請把執行檔改成 llama-server.exe。若出現記憶體不足,先把上下文從 8192 降到 4096,再考慮換更小的量化。不要一開始就把 262K 全開,長上下文的 KV Cache 會快速增加記憶體需求。
三 測試 API
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen3.8-27B","messages":[{"role":"user","content":"請用繁體中文列出三個本地部署注意事項"}]}'
能收到 JSON 回應,就代表本地端點已經可以交給其他工具使用,想把開發環境完全留在本機,也可以參考Claude Code 搭配 LM Studio 與 Ollama 的零 API 成本環境。
接到 Hermes Agent
llama-server 啟動後,可以在 Hermes Agent 的模型提供方加入本地自訂端點,Base URL 填入 http://127.0.0.1:8080/v1,如果介面要求 API Key,可以填一個只供本機識別的非空字串,模型清單出現 Qwen3.8-27B 後,就能把它用在網站製作、檔案處理、程式生成與瀏覽器檢查等 Agent 任務。
本地模型接 Agent 的價值在於資料不用先送到外部 API,也能降低大量反覆呼叫的成本。不過模型一旦拿到終端機、瀏覽器和檔案權限,風險也會跟著放大。Hermes 的代理層與 LINE 整合可以延伸閱讀Hermes Proxy 與 Hermes Agent 支援 LINE。
程式、視覺與 Agent 能力怎麼看
一個單檔 HTML 飛行遊戲可以同時產生畫面、操作、儀表與聲音,代表 27B 模型已經能完成有一定複雜度的前端原型,圖片計數測試也能辨識出 25 根筷子,並區分 6 根彩色與 19 根銀色,接到 Agent 後,還能建立帶搜尋、排序與模型卡片的網站,再開啟瀏覽器檢查介面。
這些結果適合當作能力檢查,不適合直接當成通用 benchmark,單一提示、單一圖片與單一硬體都可能讓結果偏高或偏低。真正要採用前,應該用自己的程式庫、文件、圖片和 Agent 權限做一組固定測試,記錄成功率、速度與記憶體峰值。
無審查版本不是官方安全模式
所謂無審查或 Uncensored 版本通常是社群修改、微調或去除拒答傾向的衍生模型,不是 Qwen 官方提供的安全開關,它比較少拒絕,不代表答案更正確,也不代表可以放心交給有系統權限的 Agent。
- 先在沒有正式帳密與重要檔案的環境測試
- 工具採用允許清單,不要直接給完整終端機與管理員權限
- 寫檔、執行命令、付款與對外發布都要保留人工確認
- 本地 API 預設只綁定 127.0.0.1,不要直接暴露到網際網路
- 保存工具呼叫紀錄,發生異常時能回溯
如果用途只是寫作或私人角色扮演,可以把衍生模型放在沒有工具權限的聊天環境。需要操作檔案、瀏覽器或伺服器時,優先使用官方模型並限制權限,通常會更穩妥。
我的選擇建議
16GB 顯卡從 Q3_K_M、8K 上下文和官方版本開始。24GB 顯卡可選 Q4_K_M,並保留足夠空間給 mmproj 與 KV Cache。50 系列 Blackwell 顯卡如果要做正式服務,可以研究 NVFP4 與 vLLM。一般個人使用者則先用 GGUF 和 llama.cpp,把模型穩定跑起來,再決定是否需要 Hermes Agent、長上下文或 MTP。
Qwen3.8-27B 的重點不是單純追求更大模型,而是把多模態、程式能力和 Agent 執行放進個人可負擔的硬體範圍。選對量化、控制上下文、限制工具權限,才是本地部署真正能長期使用的關鍵。
FAQ
MTP 一定比較快嗎
只有推理框架正確支援推測解碼時才會發揮效果。框架版本、硬體與批次大小都會影響實際速度,不能只看檔名判斷。
可以用 Ollama 或 LM Studio 嗎
可以,只要版本已支援 Qwen3.8 架構與對應 GGUF。想控制 MTP、mmproj、KV Cache 與細部參數時,llama.cpp 通常更透明。
本地模型接 Hermes Agent 安全嗎
模型資料可以留在本機,但工具權限仍然需要管理。使用 127.0.0.1、工具允許清單、人工確認與執行紀錄,可以大幅降低風險。
參考資料
近期留言