Strata 能把 Qwen3.8-Flash-Next 分散到 GPU、系統記憶體與 SSD,在個人電腦上提供聊天、圖片理解和 Agent 使用的本地模型服務,依 v0.1.13 文件,較實際的起點是 NVIDIA RTX 30/40/50 系列、12GB 以上顯存,以及 64GB 系統記憶體。
這套工具值得研究的地方,是讓既有桌機分工承擔大型模型,而不是把所有成本變不見,安裝前,先確認顯卡支援、可用 RAM、磁碟空間與打算使用的上下文長度,會比追著最高 tokens/s 更有幫助。
本文以指定的 v0.1.13 為核對基準,案例是公開示範的整理,沒有在本文另外重跑硬體實測。
內容目錄
Strata 是什麼?模型、推理引擎與 Agent 要分開看
Qwen3.8-Flash-Next 官方模型卡列出 125B 主模型參數、每次啟用約 6B,另有 n-gram embedding 與 MTP 元件,MoE 每一步只使用部分專家,有利於分工運算,但完整權重仍要有地方保存。
Strata 負責載入與執行模型,並提供網頁介面和 API,Hermes 等 Agent 則負責規劃、操作檔案及呼叫工具。
把兩者接起來,才會從「產生一段程式碼」進入「建立專案、執行、查看錯誤、再修改」的循環。
- GPU 保留常用運算元件與熱門專家,盡量利用顯存中的資料。
- RAM 保存專家權重,CPU 處理未命中 GPU 快取的部分,與 GPU 協同運算。
- SSD 保存大型查找表,依需要讀取相關資料。
- MTP 先提出後續 token 候選,再由主模型驗證,減少逐步解碼的成本。
這是特定引擎配合特定模型的設計,不能推論任何 GGUF 都能直接換上去,想先了解候選 token 與驗證的概念,可以延伸看站內的 MTP 本地推理加速整理,Strata 的分層細節以 固定版本技術文件為準。
8GB 能跑,但有三個條件不能省略
第一,官方路線是 NVIDIA,AMD CPU 不等於 AMD 顯卡
v0.1.13 的 硬體要求寫明 12GB 以上 NVIDIA 顯卡,並註記 8GB 可以執行但較慢。
安裝程式也會透過 nvidia-smi 檢查 GPU,找不到 NVIDIA 顯卡就停止。
CPU 支援 Intel/AMD 的 x86-64 與 AVX2,這與支援 Radeon 顯卡是兩回事。
因此,這份 Windows/Linux 教學不能直接套到 AMD GPU 或 Apple Silicon。
即使底層借用了 llama.cpp 的元件,也不代表它自動繼承所有後端。
官方量測以 RTX 5070 為主,列入支援範圍的其他系列也不等於逐張完成驗證。
第二,大量 RAM 仍然必要,不能只算顯存
模型的專家權重主要留在系統記憶體。大顯卡可以減少 CPU 的工作,卻不會讓這份 RAM 需求消失。
v0.1.13 安裝程式為不同量化設定了記憶體需求值,以下是部署規劃用數字,不是本文測得的即時占用。
| 量化 | 模型下載量 | 專家記憶體約占 | 安裝程式 RAM 需求值 |
|---|---|---|---|
| Q2_0 | 66.4GB | 34.0GB | 48GB |
| IQ2_XS | 68.0GB | 35.5GB | 48GB |
| IQ3_XXS | 75.8GB | 42.9GB | 60GB |
| IQ3_S | 83.6GB | 50.3GB | 62GB |
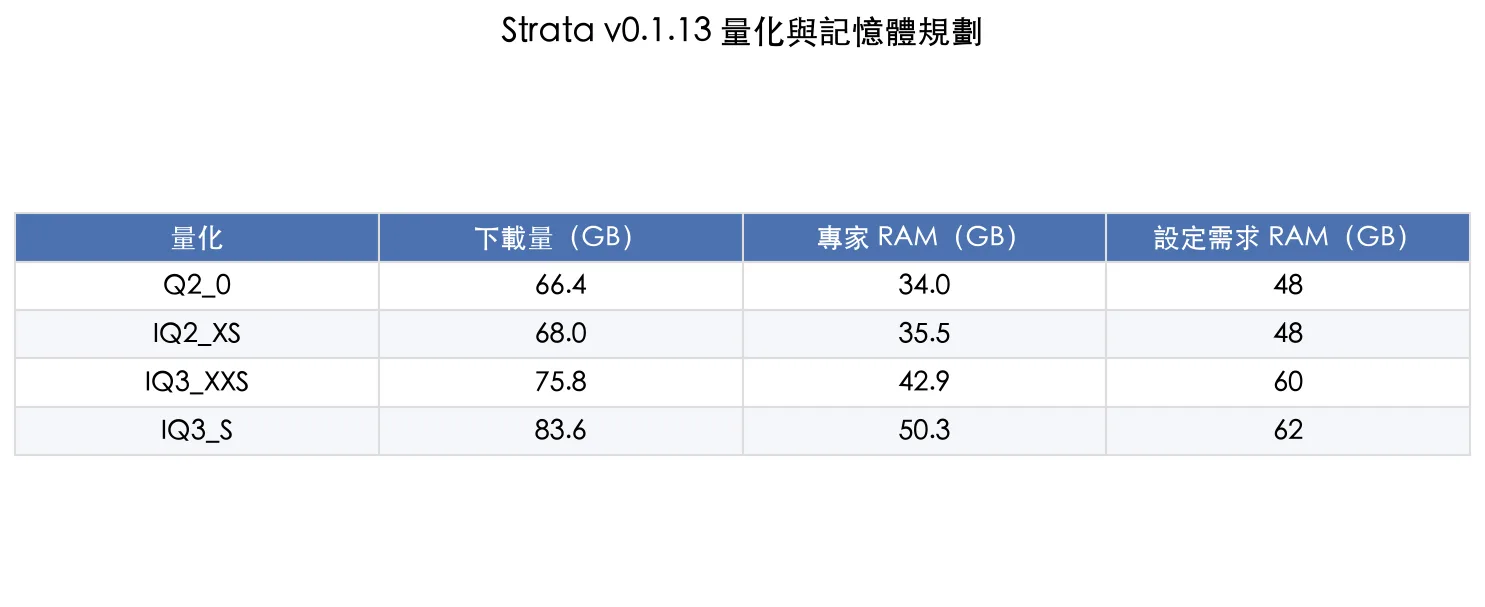
64GB RAM 是較容易規劃的配置,使用 IQ3_S 時仍要控制背景程式,模型檔之外還有引擎、MTP 與暫存,部分 Q2_0/AVX-512 組合會建立額外的專家資料副本,不能只按下載大小留磁碟。先用較小量化、較短上下文,確認實際餘裕再提高設定。
虛擬記憶體能提供位址空間與換頁機制,但不能當成同容量 RAM 的速度替代。
這個版本也會檢查實體 RAM。若已經不停讀寫磁碟、整機反應很慢,優先關閉其他程式或選較小模型,不要預期把分頁檔加大就能維持同樣吞吐量。
第三,8GB 安裝畫面不能替代 24GB 測試結果
這組公開示範先顯示 8GB 顯存與 64GB RAM 的設定,後續明確切換到 24GB 顯存,才繼續進行程式與 Agent 案例。
因此,後面的遊戲生成表現不能作為「8GB 顯卡同樣快」的證據。
評估自己的電腦時,至少要一起記錄 GPU、RAM、量化、上下文、影像開關與完整任務耗時。
安裝 Strata:先完成文字聊天,再加圖片與 Agent
1. 下載完整專案,分清原始碼與引擎壓縮檔
從 Strata v0.1.13 發行頁進入版本資料。
新手需要包含 START-HERE.bat、setup.py 等檔案的完整專案。
發行附件 strata-windows-x64.zip 是引擎,symbols 壓縮檔供除錯,不要把引擎附件誤認成完整安裝介面。
Windows 更新 NVIDIA 驅動後,解壓完整專案並執行 START-HERE.bat。
Linux 使用 ./setup.sh。
v0.1.13 文件要求驅動 580 或更新版本。安裝器會處理 Python、依賴、引擎與模型下載,沒有現成引擎可用時可能需要編譯。
需要重現版本時,還要查看啟動日誌中的 engine 版本。
v0.1.13 的安裝程式預設下載 latest 發行引擎,所以只下載舊版原始碼,不代表最後執行的一定是同一版引擎。本文沒有把後續 main 分支新增功能混入這份教學。
2. 選原版或 Swift 1.5,再選量化
Swift 1.5是 UkisAI 的微調版本,主要方向是縮短思考內容。
「較快給出答案」可能來自生成的思考 token 變少,不是每一個 token 都跑得更快。效果與授權應分別看模型頁,不能直接當成所有任務都等效的加速開關。
不確定如何選時,可從官方 README 建議的 IQ2_XS 開始。
Swift 1.5 在這個版本沒有 IQ3_S 選項,模型越小越省空間,但程式正確率、長文本與工具使用是否符合需求,仍要用自己的任務驗證。
如果 RAM 不足,Qwen3.8-27B 與 GGUF 部署整理提供另一種較小模型的評估方向,不能把兩者硬體表混用。
3. 上下文與影像功能逐步增加
v0.1.13 安裝程式會依顯存建議上下文,較小顯存通常先選 32K。長上下文會占用更多快取與工作空間,並擠壓 GPU 可保存的專家數量,KV Cache 先用建議的 8-bit,4-bit 是節省空間的選項,不是無條件提升品質與速度。
需要讀圖片時再開啟影像編碼器,官方文件列出的 GPU 影像路線會額外保留約 1.4GB 顯存,這對 8GB 顯卡尤其有感。純文字聊天還沒穩定時,先不要同時開啟最長上下文和影像功能。
4. 確認服務完成啟動
終端機顯示服務就緒後,在同一台電腦開啟 http://127.0.0.1:8080。
Chat 用於聊天,Monitor 查看 GPU、CPU、RAM 與請求狀態。
第一次載入大型權重可能很慢,先看日誌進度。
頁面顯示舊介面時可以強制重新整理,但後端已退出或記憶體不足,需要處理後端原因。
v0.1.13 快在哪裡?讀提示詞與輸出要分開看
v0.1.13 發行說明的重點是 prefill,也就是讀取提示詞的階段。
專案公布的 RTX 5070 12GB、Ryzen 5 7600、64GB DDR5 測試如下。這些是開發者的特定條件測量,不是對任意顯卡的保證。
| 32K-token 提示詞 | v0.1.12 | v0.1.13 |
|---|---|---|
| Q2_0 | 572 tokens/s | 1,290 tokens/s |
| IQ3_S | 383 tokens/s | 1,208 tokens/s |
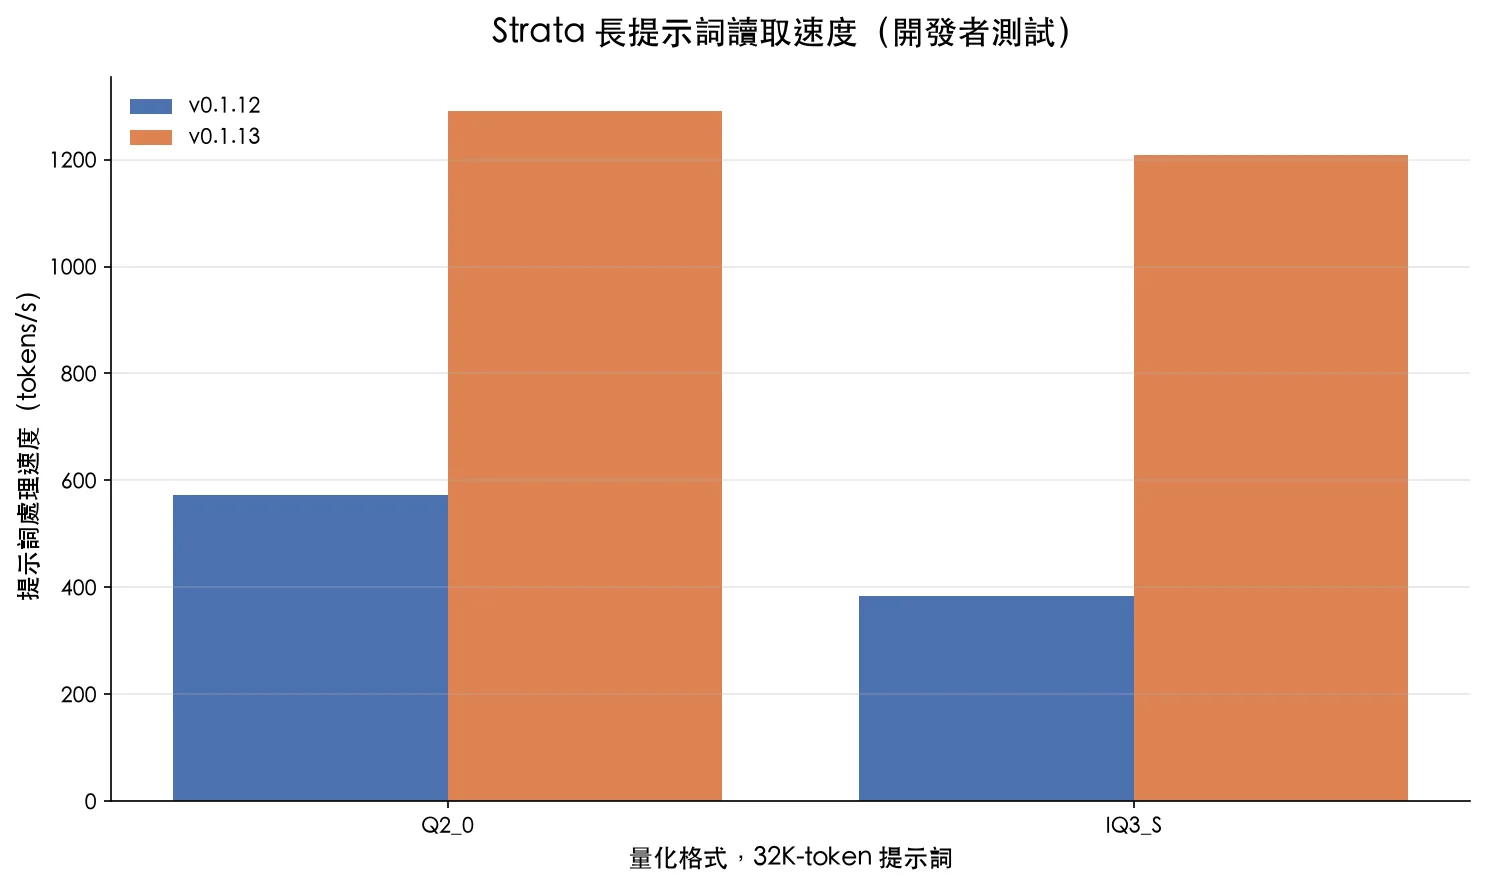
新版透過較大提示詞區塊、量化運算核心,以及資料傳輸與運算重疊等方式減少等待。
公開測試紀錄同時寫明:回答輸出路徑未改,生成速度不因此增加,不能把 1,290 tokens/s 當成聊天輸出的速度,也不應把舊 README 的讀取數字與新版測試混成一張排行榜。
實際工作感受由首次等待、思考長度、輸出長度與工具執行時間一起決定,模型每秒輸出很多 token,仍可能花很久生成大型專案。tokens/s 也不能直接換算成固定數量的中文字。
接到 Hermes Agent:先測 API,再交付長任務
在 Agent 中加入 OpenAI 相容提供方,Base URL 使用 http://127.0.0.1:8080/v1。預設本機服務若未啟用驗證,客戶端要求非空 API Key 時可填占位字串。若已設定服務密鑰,就必須使用實際密鑰。模型名稱可依 /v1/models 顯示選擇。
Base URL: http://127.0.0.1:8080/v1
Chat Completions: POST /v1/chat/completions
Model list: GET /v1/models
Health: GET /health
上述 API 路徑可在 Strata API 文件核對。先發送一句短訊息,再測一次小型工具呼叫,最後才做多檔案專案。Agent 若跑在另一台電腦或容器,127.0.0.1 指的是它自己,必須依實際網路環境調整,不能照抄位址。
本地推理可以省去外部模型 API 的逐 token 費用,硬體、電力和維護成本仍然存在。Agent 額外使用的搜尋、語音或其他雲端服務,也要分開確認。先讓工具只操作指定專案資料夾,保留變更紀錄,會比較容易找出長任務失敗的位置。
常見問題
8GB 顯存能跑 Strata 嗎?
v0.1.13 官方細節文件表示可以執行但較慢,建議 12GB 以上 NVIDIA 顯卡。仍需足夠的系統 RAM、相容 CPU 與磁碟空間,不能把 24GB 的示範速度套到 8GB。
AMD 顯卡或 Mac 可以照這篇安裝嗎?
不適用。這份 v0.1.13 安裝流程檢查 NVIDIA GPU 並使用 CUDA。支援 AMD CPU 不代表支援 AMD 顯卡,Apple Silicon 也不在這份流程的支援範圍。
32GB RAM 加大虛擬記憶體就夠嗎?
不要這樣規劃。指定版本的完整模型路線要求大量實體 RAM,最小量化的安裝需求值為 48GB。頻繁換頁會拖慢系統,較小模型通常是更實際的替代選項。
Strata 可以無限長對話嗎?
不行。請求仍受設定的上下文長度與記憶體限制。長任務成功不代表沒有上限,超出時應縮短歷史、開新對話或在硬體允許範圍內調整設定。
我的建議:先驗證日常任務,再追求最大模型
已有足夠 RAM 與相容 NVIDIA 顯卡,可以從較小量化、短上下文、純文字開始,再加入圖片與 Agent。先記錄一次真實工作從送出到完成的時間,確認成品可用,才決定是否值得投入更多硬體。
Strata 的價值是提供個人電腦執行大型模型的新方法。真正要比較的,是你的任務能不能穩定完成,而不只是參數量、瞬間速度,或某一次看起來很漂亮的展示。
資料核對日期:2026 年 9 月 29 日。安裝與量測以 v0.1.13 原始碼、文件及發行說明為基準。更新後請重新確認支援範圍、實際引擎版本與模型授權。
近期留言