by Rain Chu | 10 月 7, 2026 | AI, QWEN
Strata 能把 Qwen3.8-Flash-Next 分散到 GPU、系統記憶體與 SSD,在個人電腦上提供聊天、圖片理解和 Agent 使用的本地模型服務,依 v0.1.13 文件,較實際的起點是 NVIDIA RTX 30/40/50 系列、12GB 以上顯存,以及 64GB 系統記憶體。
這套工具值得研究的地方,是讓既有桌機分工承擔大型模型,而不是把所有成本變不見,安裝前,先確認顯卡支援、可用 RAM、磁碟空間與打算使用的上下文長度,會比追著最高 tokens/s 更有幫助。
本文以指定的 v0.1.13 為核對基準,案例是公開示範的整理,沒有在本文另外重跑硬體實測。
Strata 是什麼?模型、推理引擎與 Agent 要分開看
Qwen3.8-Flash-Next 官方模型卡列出 125B 主模型參數、每次啟用約 6B,另有 n-gram embedding 與 MTP 元件,MoE 每一步只使用部分專家,有利於分工運算,但完整權重仍要有地方保存。
Strata 負責載入與執行模型,並提供網頁介面和 API,Hermes 等 Agent 則負責規劃、操作檔案及呼叫工具。
把兩者接起來,才會從「產生一段程式碼」進入「建立專案、執行、查看錯誤、再修改」的循環。
- GPU 保留常用運算元件與熱門專家,盡量利用顯存中的資料。
- RAM 保存專家權重,CPU 處理未命中 GPU 快取的部分,與 GPU 協同運算。
- SSD 保存大型查找表,依需要讀取相關資料。
- MTP 先提出後續 token 候選,再由主模型驗證,減少逐步解碼的成本。
這是特定引擎配合特定模型的設計,不能推論任何 GGUF 都能直接換上去,想先了解候選 token 與驗證的概念,可以延伸看站內的 MTP 本地推理加速整理,Strata 的分層細節以 固定版本技術文件為準。
8GB 能跑,但有三個條件不能省略
第一,官方路線是 NVIDIA,AMD CPU 不等於 AMD 顯卡
v0.1.13 的 硬體要求寫明 12GB 以上 NVIDIA 顯卡,並註記 8GB 可以執行但較慢。
安裝程式也會透過 nvidia-smi 檢查 GPU,找不到 NVIDIA 顯卡就停止。
CPU 支援 Intel/AMD 的 x86-64 與 AVX2,這與支援 Radeon 顯卡是兩回事。
因此,這份 Windows/Linux 教學不能直接套到 AMD GPU 或 Apple Silicon。
即使底層借用了 llama.cpp 的元件,也不代表它自動繼承所有後端。
官方量測以 RTX 5070 為主,列入支援範圍的其他系列也不等於逐張完成驗證。
第二,大量 RAM 仍然必要,不能只算顯存
模型的專家權重主要留在系統記憶體。大顯卡可以減少 CPU 的工作,卻不會讓這份 RAM 需求消失。
v0.1.13 安裝程式為不同量化設定了記憶體需求值,以下是部署規劃用數字,不是本文測得的即時占用。
| 量化 | 模型下載量 | 專家記憶體約占 | 安裝程式 RAM 需求值 |
|---|
| Q2_0 | 66.4GB | 34.0GB | 48GB |
| IQ2_XS | 68.0GB | 35.5GB | 48GB |
| IQ3_XXS | 75.8GB | 42.9GB | 60GB |
| IQ3_S | 83.6GB | 50.3GB | 62GB |
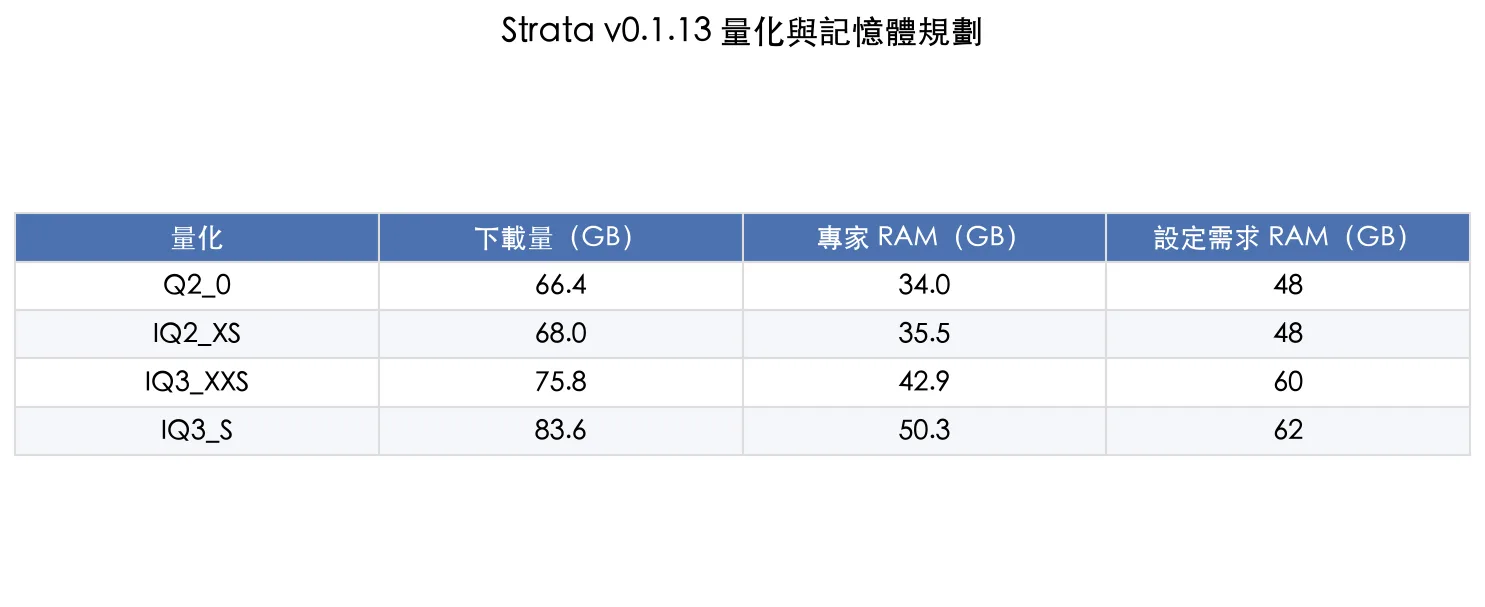 依 v0.1.13 setup.py 整理,GB 沿用原始標示。RAM 需求值不是剩餘記憶體,也不是 GPU 顯存需求。
64GB RAM 是較容易規劃的配置,使用 IQ3_S 時仍要控制背景程式,模型檔之外還有引擎、MTP 與暫存,部分 Q2_0/AVX-512 組合會建立額外的專家資料副本,不能只按下載大小留磁碟。先用較小量化、較短上下文,確認實際餘裕再提高設定。
虛擬記憶體能提供位址空間與換頁機制,但不能當成同容量 RAM 的速度替代。
這個版本也會檢查實體 RAM。若已經不停讀寫磁碟、整機反應很慢,優先關閉其他程式或選較小模型,不要預期把分頁檔加大就能維持同樣吞吐量。
第三,8GB 安裝畫面不能替代 24GB 測試結果
這組公開示範先顯示 8GB 顯存與 64GB RAM 的設定,後續明確切換到 24GB 顯存,才繼續進行程式與 Agent 案例。
因此,後面的遊戲生成表現不能作為「8GB 顯卡同樣快」的證據。
評估自己的電腦時,至少要一起記錄 GPU、RAM、量化、上下文、影像開關與完整任務耗時。
安裝 Strata:先完成文字聊天,再加圖片與 Agent
1. 下載完整專案,分清原始碼與引擎壓縮檔
從 Strata v0.1.13 發行頁進入版本資料。
新手需要包含 START-HERE.bat、setup.py 等檔案的完整專案。
發行附件 strata-windows-x64.zip 是引擎,symbols 壓縮檔供除錯,不要把引擎附件誤認成完整安裝介面。
Windows 更新 NVIDIA 驅動後,解壓完整專案並執行 START-HERE.bat。
Linux 使用 ./setup.sh。
v0.1.13 文件要求驅動 580 或更新版本。安裝器會處理 Python、依賴、引擎與模型下載,沒有現成引擎可用時可能需要編譯。
需要重現版本時,還要查看啟動日誌中的 engine 版本。
v0.1.13 的安裝程式預設下載 latest 發行引擎,所以只下載舊版原始碼,不代表最後執行的一定是同一版引擎。本文沒有把後續 main 分支新增功能混入這份教學。
2. 選原版或 Swift 1.5,再選量化
Swift 1.5是 UkisAI 的微調版本,主要方向是縮短思考內容。
「較快給出答案」可能來自生成的思考 token 變少,不是每一個 token 都跑得更快。效果與授權應分別看模型頁,不能直接當成所有任務都等效的加速開關。
不確定如何選時,可從官方 README 建議的 IQ2_XS 開始。
Swift 1.5 在這個版本沒有 IQ3_S 選項,模型越小越省空間,但程式正確率、長文本與工具使用是否符合需求,仍要用自己的任務驗證。
如果 RAM 不足,Qwen3.8-27B 與 GGUF 部署整理提供另一種較小模型的評估方向,不能把兩者硬體表混用。
3. 上下文與影像功能逐步增加
v0.1.13 安裝程式會依顯存建議上下文,較小顯存通常先選 32K。長上下文會占用更多快取與工作空間,並擠壓 GPU 可保存的專家數量,KV Cache 先用建議的 8-bit,4-bit 是節省空間的選項,不是無條件提升品質與速度。
需要讀圖片時再開啟影像編碼器,官方文件列出的 GPU 影像路線會額外保留約 1.4GB 顯存,這對 8GB 顯卡尤其有感。純文字聊天還沒穩定時,先不要同時開啟最長上下文和影像功能。
4. 確認服務完成啟動
終端機顯示服務就緒後,在同一台電腦開啟 http://127.0.0.1:8080。
Chat 用於聊天,Monitor 查看 GPU、CPU、RAM 與請求狀態。
第一次載入大型權重可能很慢,先看日誌進度。
頁面顯示舊介面時可以強制重新整理,但後端已退出或記憶體不足,需要處理後端原因。
v0.1.13 快在哪裡?讀提示詞與輸出要分開看
v0.1.13 發行說明的重點是 prefill,也就是讀取提示詞的階段。
專案公布的 RTX 5070 12GB、Ryzen 5 7600、64GB DDR5 測試如下。這些是開發者的特定條件測量,不是對任意顯卡的保證。
| 32K-token 提示詞 | v0.1.12 | v0.1.13 |
|---|
| Q2_0 | 572 tokens/s | 1,290 tokens/s |
| IQ3_S | 383 tokens/s | 1,208 tokens/s |
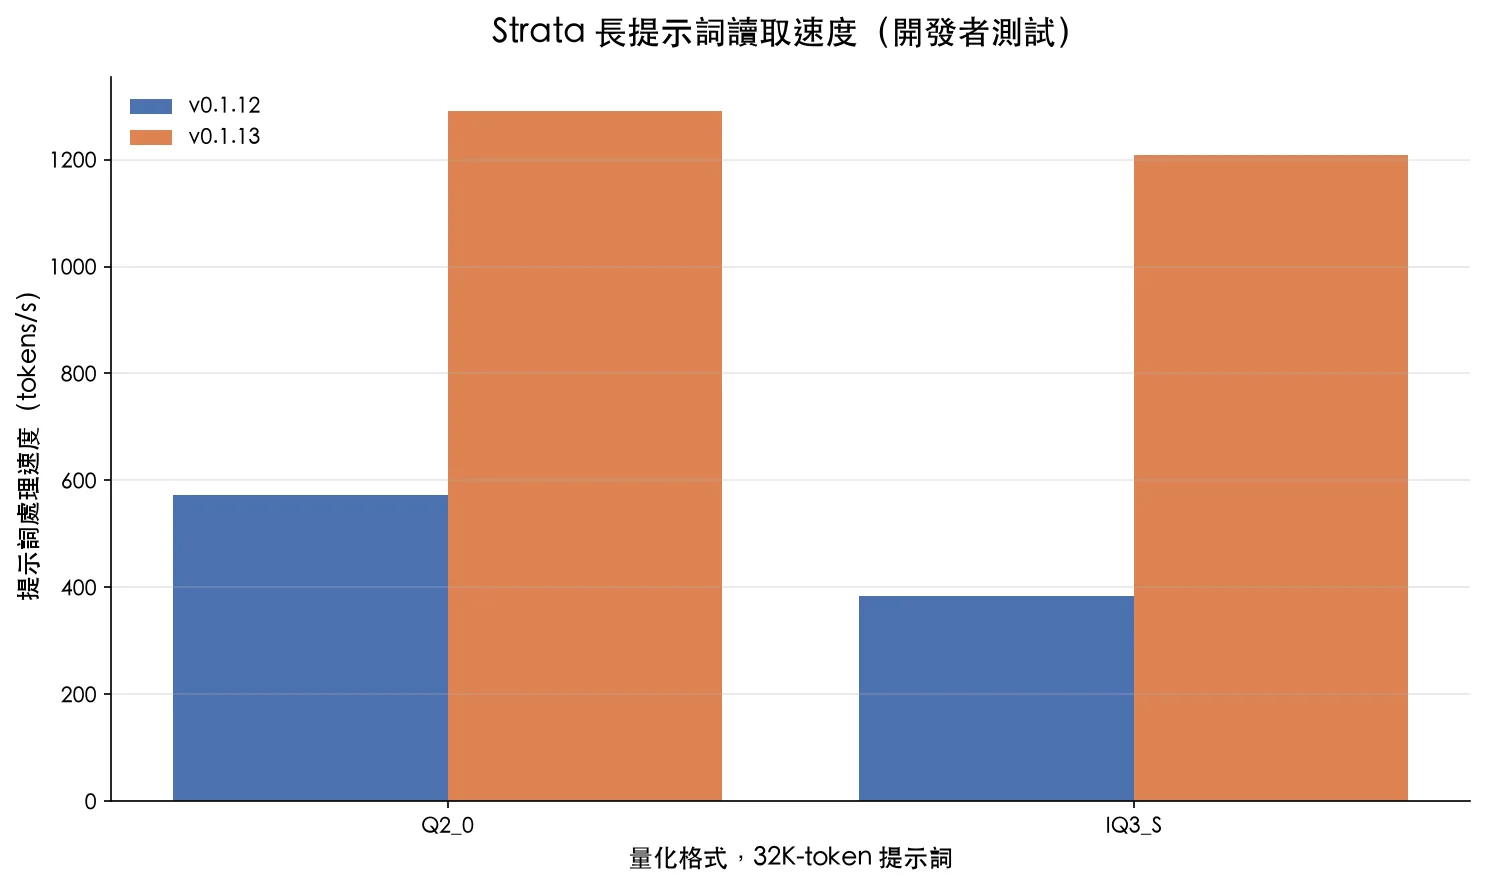 開發者公布的 prefill 測試。RTX 5070 12GB、Ryzen 5 7600、64GB DDR5。數字不是回答生成速度。
新版透過較大提示詞區塊、量化運算核心,以及資料傳輸與運算重疊等方式減少等待。
公開測試紀錄同時寫明:回答輸出路徑未改,生成速度不因此增加,不能把 1,290 tokens/s 當成聊天輸出的速度,也不應把舊 README 的讀取數字與新版測試混成一張排行榜。
實際工作感受由首次等待、思考長度、輸出長度與工具執行時間一起決定,模型每秒輸出很多 token,仍可能花很久生成大型專案。tokens/s 也不能直接換算成固定數量的中文字。
接到 Hermes Agent:先測 API,再交付長任務
在 Agent 中加入 OpenAI 相容提供方,Base URL 使用 http://127.0.0.1:8080/v1。預設本機服務若未啟用驗證,客戶端要求非空 API Key 時可填占位字串。若已設定服務密鑰,就必須使用實際密鑰。模型名稱可依 /v1/models 顯示選擇。
Base URL: http://127.0.0.1:8080/v1
Chat Completions: POST /v1/chat/completions
Model list: GET /v1/models
Health: GET /health
上述 API 路徑可在 Strata API 文件核對。先發送一句短訊息,再測一次小型工具呼叫,最後才做多檔案專案。Agent 若跑在另一台電腦或容器,127.0.0.1 指的是它自己,必須依實際網路環境調整,不能照抄位址。
本地推理可以省去外部模型 API 的逐 token 費用,硬體、電力和維護成本仍然存在。Agent 額外使用的搜尋、語音或其他雲端服務,也要分開確認。先讓工具只操作指定專案資料夾,保留變更紀錄,會比較容易找出長任務失敗的位置。
常見問題
8GB 顯存能跑 Strata 嗎?
v0.1.13 官方細節文件表示可以執行但較慢,建議 12GB 以上 NVIDIA 顯卡。仍需足夠的系統 RAM、相容 CPU 與磁碟空間,不能把 24GB 的示範速度套到 8GB。
AMD 顯卡或 Mac 可以照這篇安裝嗎?
不適用。這份 v0.1.13 安裝流程檢查 NVIDIA GPU 並使用 CUDA。支援 AMD CPU 不代表支援 AMD 顯卡,Apple Silicon 也不在這份流程的支援範圍。
32GB RAM 加大虛擬記憶體就夠嗎?
不要這樣規劃。指定版本的完整模型路線要求大量實體 RAM,最小量化的安裝需求值為 48GB。頻繁換頁會拖慢系統,較小模型通常是更實際的替代選項。
Strata 可以無限長對話嗎?
不行。請求仍受設定的上下文長度與記憶體限制。長任務成功不代表沒有上限,超出時應縮短歷史、開新對話或在硬體允許範圍內調整設定。
我的建議:先驗證日常任務,再追求最大模型
已有足夠 RAM 與相容 NVIDIA 顯卡,可以從較小量化、短上下文、純文字開始,再加入圖片與 Agent。先記錄一次真實工作從送出到完成的時間,確認成品可用,才決定是否值得投入更多硬體。
Strata 的價值是提供個人電腦執行大型模型的新方法。真正要比較的,是你的任務能不能穩定完成,而不只是參數量、瞬間速度,或某一次看起來很漂亮的展示。
資料核對日期:2026 年 9 月 29 日。安裝與量測以 v0.1.13 原始碼、文件及發行說明為基準。更新後請重新確認支援範圍、實際引擎版本與模型授權。
by Rain Chu | 10 月 5, 2026 | Agent, AI, OpenAI
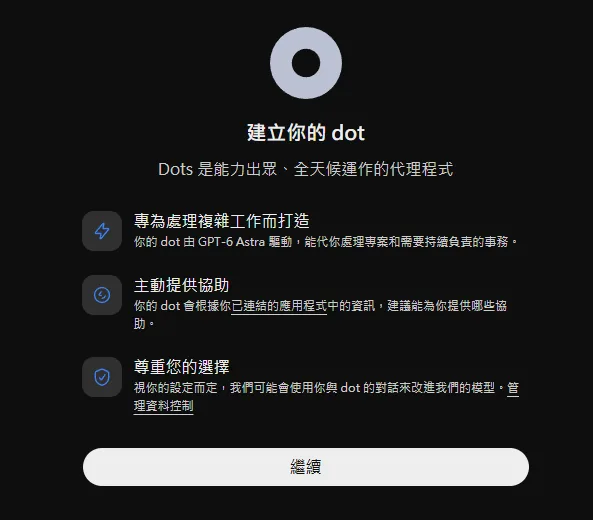
OpenAI Dots 是 ChatGPT 裡能持續追蹤工作、協調工具並交付成果的常駐 AI 代理,跟 hermes agent, openclaw 是一樣的 AI 工具,你可以用文字或語音交代目標,讓它在自己的雲端電腦上研究、整理文件、寫程式,再回來查看結果。
我會把 Dots 看成工作的協調入口。遊戲引擎、建模軟體與筆記工具本身並沒有消失,Dots 把它們接成一條可以持續修改的流程。這篇先整理建立方式與典型案例,再釐清方案、用量和電腦權限。
Dots 是什麼?讓同一個目標跨對話繼續推進
依 OpenAI 官方介紹,Dots 由 GPT-6 Astra 驅動,擁有獨立雲端電腦與瀏覽器,並透過外掛連接工作應用。
官方公布的超過 4,000 個應用,是生態系的涵蓋範圍,實際能用哪些工具仍取決於外掛、帳號、權限和執行環境。
任務與記憶文件說明,它可以分派背景工作並同步推進多個任務,你在同一段對話中補充需求或改變優先順序,Dots 再協調後續步驟,它是統籌工作的一層,不代表所有動作都由同一個對話中的模型直接執行。
若你已經用過 ChatGPT Work 與 Codex 的任務流程,可以把 Dots 理解成持續接收目標、追蹤進度與回收成果的入口,Work 和 Codex 仍負責各自任務中的執行,舊文章中的模型與方案資訊則要以目前官方文件為準。
怎麼建立第一個 Dot
先在 ChatGPT 桌面 App 或電腦網頁建立 Dot,依引導設定名稱與外觀,電子郵件、行事曆和檔案服務可以在設定時連接,也能先跳過,完整步驟可對照 官方入門指南。手機 App 的使用需等支援更新到位,目前不能在手機網頁建立或使用 Dot。
建立後,先交一件範圍小、容易確認結果的工作,例如整理指定筆記頁並回傳摘要。等它能讀到正確資料,再增加寫入或跨工具操作。名稱與動態頭像方便辨識,但實際能力仍要看它取得的資料與工具。
三種連接要分清楚
- 通訊管道:在 ChatGPT、Slack 或 Teams 聯絡同一個 Dot。
- 外掛與應用:提供特定服務的資料與操作能力。
- 本機電腦:讓任務使用該電腦上的檔案、程式與工具。
加入 Slack 並不等於同時連接 Gmail,也不等於允許它讀取你的電腦,依 電腦與應用指南,這些連接各自管理。雲端瀏覽器也有自己的登入狀態,不會自動沿用你個人 Chrome 的所有帳號。
六個工作情境:從說出需求到拿到成品
以下案例整理公開操作流程,並補上本文建議的驗收方法。它們展示的是個別任務的可行性,沒有建立大型專案成功率或長期無人值守的測試結論。
一、語音查論文
依 官方語音說明,可從 Dot 對話的電話按鈕開始通話,通話期間也能打字補充。結束通話後,已交付的工作仍可能繼續。目前不能把它當作已能主動打電話給你的助理。
二、把每日檢查存成定時任務
每日檢查專案倉庫,以及定時查看 OpenAI 是否發布新文章,是把追蹤工作保存成排程的兩種用法。設定成功只是第一步,之後是否準時執行、能否持續取得來源,以及結果是否符合條件,都需要另外確認。
接下來兩週,每個工作日上午九點,以 Asia/Taipei 時區檢查[指定來源]。整理新增或變更項目到[指定位置],沒有變更時保持安靜。遇到[需要決策的條件]才通知我。請確認保存的時間、來源與輸出位置,第一次執行後提供紀錄。
上面的指令是本文示例。排程要包含時區、期間、通知條件與交付位置。依 定時任務指南,連接 Slack 或其他來源不會自動建立監控,應請 Dot 確認已保存的工作,再到 Scheduled 檢查。
三、Blender 建 3D:模型檔和渲染圖一起交付
同一個 Dot 可以協調不同工具任務,讓需求繼續在背景執行。
模型驗收除了看渲染圖,也要打開原始檔,確認物件、材質、相機和燈光都可再修改。若要交給別人,還要檢查外部貼圖與依賴是否一同保存。漂亮圖片只能說明某個視角的效果,不能代替可編輯模型的檢查。
如果要延伸到動畫或產品視覺,可參考 Blender 與開發代理的視覺工作流程,先定義短樣本與代表畫面,再擴充整段作品。工具已經接上,仍需要清楚的設計與交付規格。
哪些方案能用?用量怎麼算
截至 2026 年 10 月 2 日,Dots 正逐步開放給符合地區條件的 Pro、Business Premium 與 Enterprise 使用者,Pro 的推出範圍排除歐洲經濟區、英國及瑞士,Enterprise 需要管理員啟用,符合資格也可能尚未輪到帳號,不能因為一時看不到入口就判定設定有問題。最新條件請查 方案與地區說明,目前不能把 Plus 當成已支援的方案。
第一個 Dot 包含在 Pro 或 Business Premium 方案內,深入工作仍有使用額度。
Dot 對話不計入 ChatGPT 用量,但它啟動或管理的 Work/Codex 任務會照常計入那些產品的限制,首月提高上限不代表永久無限,細節以帳號顯示與 官方用量說明為準。
這也影響值不值得升級的判斷。只偶爾需要一段程式碼,可以先看既有工具是否已足夠。
若你經常需要追蹤研究、跨應用更新、定期整理資料,再比較 Dots 能省下多少來回交代與驗收時間,會比只看一次展示更有用。
如何把任務交代到可以驗收
一個好任務至少要有來源、結果、限制和完成條件。下面是本文設計的起手式,可以替換方括號內容後使用。
請使用我已連接的[資料來源],完成[具體結果]。先確認你讀到的來源,再開始處理。輸出到[位置與格式],保留來源連結與修改紀錄。涉及發送、公開分享或覆蓋原始資料時,先給我確認。完成後提供成果位置與檢查結果,遇到缺少權限或資訊時說明缺少什麼。
這樣的描述方便驗收,也方便續做。若第一版錯了,指出具體段落、檔案或操作步驟,讓它修正同一件工作。單純說「做得更好」通常只會增加猜測。
雲端能繼續工作,本機仍需要連線
Dots 的雲端電腦可在你的裝置關機時持續處理雲端工作,需要你本機檔案或工具的任務,則必須先授權連接該電腦,並保持電腦上線與 ChatGPT App 開啟,目前一次只能連接一台個人電腦。
要查看雲端環境,可從 Dot 個人頁的 Computers 開啟電腦,開啟畫面後仍需選 Take over 才能接管,完成登入或確認步驟後再 Return control。
遇到網站額外驗證或雲端瀏覽器被阻擋,可能需要人工接手,不能承諾每個網站都能全程自動完成。
長期合作前,先理解記憶與權限
Dots 可以使用相關 ChatGPT 記憶,也會保存自己的工作脈絡。
這不等於它永遠保有所有歷史對話,更不等於每個被分派的任務都取得完整歷史。重要文件、決策和來源仍建議明確保存,若想把專案知識做成可維護的資料,可延伸看 Agent 共用知識庫的整理方式。
依 隱私與安全 FAQ,斷開外掛會停止後續存取,已進入 Dot 脈絡的資訊不會因此自動刪除,目前也不能逐條直接修改 Dot 的自有記憶。刪除 Dot 與管理 ChatGPT 記憶是不同操作,刪除前先保存需要的成果。
個人方案的對話與工作是否用於模型改進,依資料控制設定。Business、Enterprise 與 Edu 工作區預設不使用內容訓練。主動研究與筆記不直接拿來訓練,但資訊若被帶入符合條件的對話或任務,仍會依設定處理。
OpenAI 的安全設計包含隔離環境、私密登入與操作審查,主動研究本身使用唯讀工具,不能直接寄信、修改應用或控制電腦。已授權的任務若要採取後續動作,仍受權限與操作規則限制,把工作交給 Dots 後,重要結果一樣要檢查。
怎麼查看進度與停止工作
從個人頁的 Activity 查看進行中與委派任務,再到 Scheduled 檢查定時工作。
依 官方控制說明,暫停 Dot 主任務、停止委派任務和取消排程有不同效果,若要全面停止,必須分別檢查這些位置,關掉通話或暫停主對話不會自動取消所有後續工作。
我的建議:從一條能穩定交付的流程開始
第一次使用,我會先選「讀取指定資料、產出草稿、回傳來源」這種容易確認的工作。
確認資料與輸出都正確,再增加跨工具寫入、排程或程式開發。持續記錄完成率、修正次數與實際用量,才能知道它是否適合你的工作。
Dots 的價值在於持續協調和回收成果,短時間完成一個遊戲或模型值得參考,能否長期減少管理成本才是後續要驗證的事。
資料核對日期:2026 年 10 月 2 日。功能與案例依公開資料整理,本文未另外重跑相同測試。方案、地區與用量會更新,使用前請確認最新官方說明。
OpenAI Dots 常見問題
OpenAI Dots 是什麼?
Dots 是 ChatGPT 裡能持續追蹤目標的 AI 代理。它有自己的雲端電腦,可協調研究、文件、程式與其他工具工作,再回收成果。
ChatGPT Plus 可以使用 Dots 嗎?
截至 2026 年 10 月 2 日,官方列出的開放方案是符合條件的 Pro、Business Premium 與 Enterprise。Plus 尚未列為支援方案,實際資格也受地區、管理員設定與逐步推出影響。
Dots 會消耗 Codex 額度嗎?
Dot 對話不計入 ChatGPT 用量。它啟動或管理的 Work 與 Codex 任務,仍照常計入那些產品的用量限制,不能當成無限工作額度。
電腦關機後,Dots 還會工作嗎?
雲端電腦上的工作可以繼續。需要使用本機檔案或工具的任務,則要保持該電腦上線,並開啟已授權的 ChatGPT App。
結束通話或暫停 Dot,會取消所有排程嗎?
不會。結束通話不會自動取消已交付工作,暫停主對話也不等於停止所有委派任務與排程。請分別檢查 Activity 和 Scheduled。
by Rain Chu | 9 月 30, 2026 | AI, 程式開發
Security Guidance 是 Anthropic 提供的 Claude Code 安全審查外掛,會在 Claude 修改程式的過程中,自動提醒可能的漏洞,並把審查結果送回同一個工作階段處理,安裝後不必每次再打一段「請檢查安全性」,也不需要記住一個專門啟動它的 Skill 指令。
它適合用在 AI 協助開發網站、API、後台與自動化腳本的日常流程,尤其程式已經能跑,卻還沒確認使用者輸入、權限檢查或資料流向是否安全時,這類即時提醒可以讓問題更早被看見。
先釐清:Security Guidance 是 Skill、Hook,還是 Plugin?
正式分類是 Plugin,也就是外掛,Skill 通常是一份描述任務做法的指引,Hook 則是在特定事件發生時自動執行的程式,Security Guidance 把安全檢查程式包成外掛,透過 Hooks 接到 Claude Code 的工作流程。
所以,它的基本用法是「安裝並保持啟用,正常讓 Claude Code 工作」,目前提供的 外掛設定檔與目錄結構以 Hooks 為核心,沒有要求你建立 SKILL.md,也沒有名為 /security-guidance 的獨立操作指令。
版本提醒:截至 2026 年 9 月 28 日,官方市集頁仍以較早的寫入前提醒介紹產品,但本文核對的 GitHub 版本為 2.0.0,實際 Hook 設定已採用寫入後檢查及背景審查。下文依這份原始碼與現行使用文件說明,安裝後也應確認自己的外掛版本。
它如何運作?三個時機,三種檢查深度
第一層:檔案修改後,快速找出危險寫法
當 Claude 透過編輯或寫入工具修改檔案,外掛會比對特定字串、正規表示式與檔案路徑,例如動態執行字串的 eval()、把輸入交給 shell 的 child_process.exec()、直接寫入 HTML,以及不安全的反序列化。
這一層不需要呼叫模型,同一個工作階段裡,同一檔案的同一條規則通常只提醒一次,避免連續修改時反覆洗版,它抓到的是「需要留意的寫法」,未必代表那一行已經構成可利用的漏洞,後續仍要看輸入來源與上下文,規則可以在 內建模式清單中查到。
第二層:一個回合結束後,檢查這回合的差異
你提出一次需求,Claude 修改程式並回覆,構成一個工作回合,外掛會用 Git 狀態整理這回合產生的差異,交給另一個以安全為目標的模型審查,這能補上單純字串比對看不出的問題,例如某個查詢是否漏掉使用者權限限制。
目前 Hook 設定使用背景審查,回覆可能先完成,稍後才把發現送回 Claude,讓它繼續處理,因此不能把「已看到完成回覆」理解成安全檢查已全部結束,依 官方回合審查說明,這一層也有檔案數與連續觸發次數限制,並不是無限檢查整個專案。
第三層:Claude 提交或推送時,追查相關程式
當 Claude 透過 Bash 工具執行符合條件的 git commit 或 git push,外掛可啟動更深入的審查,這個 reviewer 能用 Read、Grep、Glob 查看呼叫端、驗證函式與相關檔案,判斷跨檔案的資料流是否存在問題。
這裡的觸發範圍是 Claude Code 內的工具操作,不是替電腦安裝全域 Git 防線,你從自己的終端機執行 Git,或使用工作階段裡的 ! shell escape,不應假定也會受到這一層審查。
目前這三層都不會阻擋寫入或提交,發現問題後,仍要由 Claude 或開發者修正。如果團隊要求檢查未通過就不能合併,應另外使用 CI 必要檢查與分支保護,不能把背景提醒當成硬性關卡,這也是 設計 AI 工作環境與驗證流程時需要先分清楚的責任。
Security Guidance 安裝方式
本文以本機終端機版 Claude Code 為主,先準備可正常使用的 Claude Code、Git 專案,以及 Python 3.10 以上與可用的 pip。這個 第一次使用時,外掛可能在 ~/.claude/security/ 下準備專用 Python 環境並安裝 Claude Agent SDK,需要網路與套件安裝能力。企業電腦若限制下載,應先核對初始化結果。
在 Claude Code 對話輸入列執行:
/plugin install security-guidance@claude-plugins-official
這是 Claude Code 裡的指令,不是直接貼到一般終端機執行的 shell 指令。
安裝畫面若詢問範圍,User 適用於這台電腦上自己的各個專案,Project 用來分享專案設定,Local 則只套用到自己在目前專案的使用。
第一次體驗,可以選 User,或用 Local 限定在測試專案。
只有在系統明確回報找不到官方 marketplace 時,才先補上:
/plugin marketplace add anthropics/claude-plugins-official
接著重試安裝。若安裝摘要提示需要啟用更新,依畫面執行 /reload-plugins,再透過 /plugin 檢查已安裝與啟用狀態。安裝範圍及重新載入方式可對照 官方外掛安裝文件。
若你使用 Claude 桌面版或 VS Code 擴充套件,外掛管理入口可能不同。
安裝後怎麼用?照常開發,再處理提醒
不必先提出安全審查要求才能觸發。你可以像平常一樣請 Claude 新增功能、修改測試或整理程式,
外掛會依事件自動工作。比較有用的工作要求,是同時讓 Claude 回報做了什麼驗證,以及安全提醒最後如何處理,例如:
請替客服後台新增留言預覽功能。
使用者輸入只需顯示純文字,不需要 HTML 格式。
完成後執行相關測試,並說明 Security Guidance 若提出提醒,你如何修正或確認。
這段提示不是外掛的專用語法,而是本文的工作要求示例。它讓功能需求與驗收方式更清楚,無須故意要求 Claude 寫出危險程式來測試外掛。
範例一:顯示留言時,避開不必要的 HTML 注入
假設功能只是顯示訪客留下的文字,卻把內容直接指定給 innerHTML,外掛的模式規則可能提出 XSS 提醒。問題不在「有 HTML 就一定錯」,而是未受信任的內容會被瀏覽器當作標記處理。
若只需要純文字,較直接的實作是:
previewElement.textContent = commentText
React 中也可以直接把文字放進 JSX 的文字位置,不必為了顯示普通留言使用 dangerouslySetInnerHTML。若功能確實需要富文字,才另外定義允許的標記與清理流程。這是在 使用 Claude Code 製作網站時,很常遇到的需求界線。
範例二:呼叫外部工具時,把參數與 shell 字串分開
假設系統要呼叫一個已知的檔案分析工具,把檔名拼進 shell 指令字串,可能讓特殊字元被當成指令語法。Security Guidance 會對 child_process.exec 這類寫法提醒檢查輸入。
可以考慮用 execFile() 直接呼叫固定程式,將檔名放進參數陣列。例如以下概念片段,前提是程式路徑固定,且已先驗證檔案確實位於允許的目錄:
import { execFile } from 'node:child_process'

execFile('/opt/myapp/bin/file-inspector', [validatedFilePath], callback)
這裡的工具路徑與變數都是示意,不能直接照貼就當成完整程式。參數陣列能避開 shell 字串解析,但目標工具本身怎麼解讀參數、檔案存取範圍與權限,仍然要檢查。外掛的提醒應該促使你看完整條資料流。
範例三:修改 GitHub Actions,先看資料如何進入腳本
編輯 .github/workflows/ 裡的 YAML 檔案時,外掛可依路徑給出提醒。這不表示整份 workflow 已被判定有漏洞,而是這類檔案可能使用儲存庫權限、執行 shell 或接觸機密,值得額外檢查。
例如只想印出 Issue 標題,可以先把事件資料放到環境變數,再於 shell 使用帶引號的變數,而不是把外部文字直接插進腳本原始碼:
env:
  ISSUE_TITLE: ${{ github.event.issue.title }}
run: printf '%s\n' "$ISSUE_TITLE"
這只是 workflow 中的一個步驟片段,用來示範安全處理文字,不代表整份流程已經安全。
還要看 job 權限、第三方 action、事件來源與 secrets 是否使用得當。若尚不熟悉分支與提交,可以先讀 AI 開發時的 GitHub 版本管理,把修改留在可檢查、可回復的範圍。
加入自己的專案規則,讓提醒更貼近實際需求
用 Markdown 說明團隊規範
在專案建立 .claude/claude-security-guidance.md,寫下模型不會自行知道的要求,以下是本文設計的多租戶後台示例,可依自己的函式名稱與資料表調整:
# 本專案安全規則

- 所有 /admin 路由必須先通過 requireAdmin,再讀取業務資料。
- 查詢租戶資料時,tenant_id 必須來自已驗證的工作階段,不可信任請求直接提供的值。
- 日誌不得包含存取權杖、密碼或完整的付款資料。
- 訪客留言預設以純文字顯示,富文字必須使用專案核准的清理函式。
規則應寫出「哪裡需要什麼條件」,比單純要求「遵守最佳安全實務」更容易被檢查,不要把 API key、真實權杖或正式客戶資料放進檔案,因為內容可能被加入模型審查的提示。
也可以把個人通用規則放在 ~/.claude/claude-security-guidance.md,或用 .claude/claude-security-guidance.local.md 保存不打算共用的專案設定,官方目前對不同審查路徑載入規則的說明仍有版本差異,因此至少要確認回合差異審查有載入,不能只因為檔案存在就推定所有路徑都生效。
用 JSON 加入可重現的文字提醒
如果某個舊函式不應再出現在新程式裡,可以建立 .claude/security-patterns.json。以下示例看到 legacyUnsafeRenderer( 就提醒改用專案的新介面:
{
  "patterns": [
    {
      "rule_name": "legacy_renderer",
      "substrings": [
        "legacyUnsafeRenderer("
      ],
      "paths": [
        "**/src/**"
      ],
      "reminder": "這個舊介面不應用於新程式,請改用專案的安全文字顯示函式,並確認輸入來源。"
    }
  ]
}
這裡的函式名稱是示例,不是內建 API。paths 用來限制檔案範圍,比對的是完整路徑,因此專案相對位置前面使用 **/。JSON 不需要額外的 YAML 解析套件,比第一次就加入正規表示式更容易確認設定是否正確。
這類自訂規則是補充提醒,並不會刪除內建規則,也不是程式碼執行權限設定。其格式與載入行為可對照 自訂規則實作。
怎麼確認真的有啟用?用無害的測試標記
最容易誤會的是「沒有出現警告,所以一切正常」。沒有警告,也可能是沒有符合模式、這個工作階段已提醒過、背景審查還沒結束,或環境缺少必要元件。
想確認自訂模式有載入,可以在可丟棄的測試分支中,讓 Claude 用編輯工具新增 src/security-guidance-demo.js,內容只放下面這行註解,然後觀察是否收到 legacy_renderer 的提醒:
// 示範字串 legacyUnsafeRenderer(,僅供規則比對,不執行任何函式
字串規則可能連註解也會匹配,正好可以用來測試,不必真的執行危險程式。
需要排查時,先看 ~/.claude/security/log.txt 的活動與錯誤,再確認專案有 Git、Python 與 SDK 初始化成功,以及所選模型與服務供應商可用。若沒有 Git 儲存庫,仍可能有逐次編輯提醒,但以 Git 差異為基礎的審查無法照常工作。
費用與資料流向:不要把它當成完全離線檢查
模式比對本身不呼叫模型,回合差異與提交審查則會額外使用模型額度,深入審查可能讀取更多檔案、進行多輪判斷,因此不能把外掛安裝後的使用成本視為零。
核對版本的預設審查模型為 Claude Opus 4.7。SECURITY_REVIEW_MODEL 用於差異審查,SG_AGENTIC_MODEL 用於 agentic 審查。若改用 Bedrock、Vertex 或其他端點,模型識別名稱應依供應商設定,不宜直接複製別人的環境變數。
執行模型審查時,變更路徑、差異與相關程式內容會傳到設定的模型端點,深入審查還可能讀取其他相關檔案
。使用公司程式碼時,應沿用組織允許的端點與資料政策。這是此工具的運作條件,不能把「Hook 在本機執行」解讀成程式碼永遠不會離開本機。
它和 /security-review、Claude Security 有什麼不同?
- Security Guidance:跟著 Claude Code 的開發過程自動提醒與審查,適合日常修改。
- /security-review:由使用者主動提出的一次性安全檢查,與自動 Hook 的觸發方式不同。
- Claude Security 外掛:提供更深入的程式庫或差異掃描與修補工作流,是另一個工具,不能只因名稱都有 Security 就視為同一套功能。
如果需求是檢查既有的整個網站,或確認某個版本能否上線,還要搭配人工審查、依賴套件掃描、測試與 CI。Security Guidance 能把部分問題提前到開發當下,但「沒提醒」不是安全認證。
Security Guidance 常見問題
只要把 SKILL.md 放進專案就能用嗎?
不能等同。Security Guidance 是包含 Hook 設定與程式的外掛,應透過官方外掛流程安裝,單獨放一份 Skill 指引不會啟動它的檢查。
它會阻止有漏洞的程式被提交嗎?
目前三層都是提醒或背景審查,不會阻擋寫入與提交。需要強制把關時,應另外設定 CI 必要檢查與分支保護。
所有安全提醒都必須照單全收嗎?
先核對輸入是否可被外部控制、既有驗證是否有效,以及實際影響。若確定是誤報,應保留具體理由,不能只用一句「這是安全的」取代證據。
從小型專案開始,把提醒接到修正與驗證
第一次使用,先選一個可回復修改的 Git 專案,確認外掛啟用,再讓 Claude 完成小功能。看到提醒後檢查原因、修正程式並跑相關測試,最後再決定是否提交。習慣這個流程後,再加入團隊規則,效果會比一開始塞進大量抽象要求更容易評估。
Security Guidance 的實際價值,在於把安全問題放回寫程式的當下,讓你更早知道哪裡需要檢查。它能協助縮短發現問題到修正的距離,最後的驗收仍要回到程式行為與測試結果。
by Rain Chu | 9 月 28, 2026 | AI, 影片製作
FaceFusion 的價值,是把換臉、人臉修復、遮罩與影片輸出放在同一套本地工具裡,可以控制素材與處理流程,也能逐項調整效果。但想讓成品自然,關鍵通常不是把所有增強功能打開,而是先選對素材、選對要處理的人,再修正最明顯的問題。
這篇從第一次安裝與圖片換臉開始,接著處理多人畫面、側臉穿幫、影片閃爍及音源錯誤,最後說明如何透過 Cpolar 遠端操作。
先用自己的照片,或已取得同意的素材練習,做出一小段穩定成果,再擴大到整支影片。
FaceFusion 是什麼?換臉、修臉與換頭先分清楚
FaceFusion是一套可在本機執行的人臉處理平台,支援圖片與影片,它不是單一換臉模型,而是把不同模型與處理器整合起來,讓你依需求選擇換臉、表情還原、人臉增強、畫面增強或唇形同步。
最容易搞混的是「換臉」與「換整個頭部」,一般 face_swapper 主要替換臉部身份特徵,不應預期它會把頭髮、耳環、整個頭型與所有化妝細節一起重建,若目標是改髮型或重做角色造型,通常還需要其他影像編輯步驟,可以搭配多圖參考與圖像編輯工作流理解不同工具的分工。
如果需求偏向即時鏡頭,而非事後處理影片,也可比較站內的Deep Live Cam 即時換臉介紹
下載前官方專案
官方原始碼位於 facefusion/facefusion,可自行下載安裝,官方也提供付費的 Windows 與 macOS 安裝器,協助處理環境設定。
本地安裝:先把環境與推論後端配好
手動安裝需要 Git、Conda 與 FFmpeg。官方安裝文件分別提供 Windows、macOS 與 Linux 的準備方式。先完成所用平台的環境與加速器設定,再建立獨立環境,避免與其他 AI 工具的套件互相影響。
conda init --all
conda create --name facefusion python=3.12 pip=25.0
conda activate facefusion
git clone https://github.com/facefusion/facefusion
cd facefusion
接著只選一種符合環境的安裝方式。CPU 或 macOS CoreML 路徑使用 default,已備妥對應 CUDA 環境的 NVIDIA 電腦可依官方範例選 cuda@12。Windows DirectML、Linux MIGraphX 與 OpenVINO 則各有對應選項,請按平台文件確認支援條件。
# CPU 或 macOS 路徑
python install.py default

# NVIDIA CUDA 路徑,擇一使用
python install.py cuda@12
完成後重新啟用環境,再啟動操作頁面。
conda deactivate
conda activate facefusion
python facefusion.py run --open-browser
較舊教學常出現 python install.py --onnxruntime cuda,但官方從 3.7.0 起改用位置參數,後續也區分 CUDA 版本。
遇到參數無法識別時,先執行 python install.py --help,對照目前安裝的程式,不要把不同年代的指令混在一起,更新紀錄可用來追查這類差異。
啟動成功後,依終端機顯示的本機網址開啟介面,常見範例是 http://127.0.0.1:7860。
首次選用模型可能需要下載檔案,預覽暫時沒有結果時,先看下載與載入紀錄。
顯示記憶體與速度:先跑通,再追求高畫質
官方 FAQ把 8GB 顯示記憶體列為最低建議,並表示 12GB 起通常較合適。
推論後端應依硬體與已安裝套件選擇,NVIDIA 可用 CUDA,Apple Silicon 可確認 CoreML,其他平台則視支援情況選擇 DirectML、MIGraphX 等,CPU 可以作為排錯與基本測試路徑,但不代表長影片處理會很快。Execution 設定列出了後端與執行緒選項。
不要只因顯示記憶體較大,就直接把執行緒拉高,比較可靠的方式是固定一小段素材,先記錄預設值的耗時,再只改一個設定。速度沒有改善,或記憶體開始吃緊,就回到原本設定。
第一次換臉:只開必要功能,先完成一張圖片
1. 放對 Source 與 Target
Source 是提供臉部身份的來源照片,Target 是要被修改的圖片或影片。初次練習選一張光線均勻、五官清楚、沒有被頭髮或手遮住的正面照,搭配只有一個人的目標圖片。先避免大幅側轉、模糊與極端表情,較容易判斷是哪個環節出了問題。
2. 先保留 face_swapper
第一次只啟用換臉需要的 face_swapper,先確認來源臉與目標臉都能被辨識,不要一開始就同時啟用唇形同步、人臉增強與整幅畫面增強,否則一旦失敗,很難看出是哪個處理器造成的。
3. 先預覽,再增加修復
先看臉部位置是否正確,再看身份相似度、嘴部、眼睛、下巴與髮際線。若換對人但細節不足,再加 face_enhancer。frame_enhancer 處理的是整幅畫面,會增加計算量,並非每次換臉都必須開啟。過強的修復也可能讓皮膚變得過度平滑,需要保留原始版本比較。
模型怎麼選?用同一段素材比較最有用
官方 Face Swapper 文件列有 HyperSwap、GHOST、INSwapper、SimSwap 等選項。
可以先用目前版本的預設模型做基準,再換另一個模型,觀察身份相似度、表情保留、輪廓接合與連續畫面的穩定度。
Pixel Boost 是換臉處理的解析度選項,也不等於整支影片直接升級成高品質 4K。調高前先確認它是否真的改善臉部細節,以及增加多少處理時間。
多人畫面與遮擋:先決定處理誰,再決定處理哪裡
多人同框時,先使用參考臉方式指定目標人物,並檢查不同時間點是否仍選到同一個人。
Face Selector控制人物選擇與參考匹配,模型本身並不能代替這個步驟。人物交錯、遠近變化或離開畫面再出現,都值得單獨檢查。
遮罩則決定臉部哪些位置參與合成,Face Masker提供 box、occlusion、area 與 region 等方式,遇到手、眼鏡或頭髮擋住臉,可以先測試遮擋遮罩,並檢查嘴部、下巴與髮際線的邊界。模糊邊緣只能改善接合,無法補回素材中根本看不到的臉部資訊。
檢查影片時,不只停在最好看的一格,應挑出正面、轉頭、張嘴、遮擋與人物交錯的片段,再連續播放,新版追蹤功能可協助補足部分漏偵測,但仍要逐段確認,不能當成「完全不閃爍」的保證。
一直要求選擇音源檔?先檢查 lip_syncer
單純把照片中的臉換到影片上,不代表你一定要另外提供音訊,如果啟動後出現「請選擇音源檔案」,先看是不是同時勾選了 lip_syncer。這個處理器是讓嘴形配合音訊,與基本換臉不同。
本次核對官方 lip_syncer 程式,它在前置檢查時確實要求來源檔中有音訊,若只要換臉,先取消 lip_syncer,再用 face_swapper 測試。若需要重新配音與對嘴,才加入合適的音源,並另外驗收聲畫同步。
用 Cpolar 遠端操作:運算仍在家中的電腦
FaceFusion 在本機跑穩後,才需要考慮遠端入口,Cpolar可以把本地 Web 服務透過隧道提供給外部裝置,手機瀏覽器只是操作介面,真正的換臉運算仍由原本的電腦執行,電腦休眠、FaceFusion 關閉或隧道中斷,都會讓遠端入口失效。
基本順序是安裝並登入 Cpolar,在本機管理頁建立 HTTP 隧道,把本地地址填成 FaceFusion 實際使用的連接埠,再從在線隧道列表取得網址,常見的 7860 是 FaceFusion 服務範例,9200 則是 Cpolar 管理頁,兩者用途不同,不要把管理頁當成要分享的換臉入口。
固定網址與登入保護也要分開設定,依Cpolar 官方文件,保留固定二級子網域需要基礎方案或以上,不能把它寫成所有免費帳號都能永久保留,官方也提供 HTTP Basic Auth。對外使用時,應使用 HTTPS 入口與存取驗證,並先測試沒有登入的人是否確實無法進入。
站內的本地 AI 遠端連線教學可協助理解「服務在哪台機器跑」與「從哪個入口連入」的差別。
免費取得,不代表每個模型都適合商業專案
FaceFusion 官方標示軟體採 OpenRAIL-AS,模型則各有授權,官方授權清單目前把 HyperSwap 列為 ResearchRAIL,INSwapper 與 AlphaFace 列為 Non-Commercial,GHOST 列為 Apache 2.0。這些是不同資產的標示,不能只看主程式名稱就推定整套流程可商用。
如果要用在客戶影片,請把實際使用的換臉、偵測、增強與其他模型一起列出,逐一核對條款及素材使用同意。某個換臉模型的授權較寬鬆,也不會自動涵蓋其他模型或照片中人物的使用權利。
常見問題
FaceFusion 可以免費使用嗎?
官方原始碼可自行取得與安裝,官方安裝器及部分服務另外收費。模型與其他資產仍有各自的授權條件。
FaceFusion 換臉會連髮型一起更換嗎?
一般 face_swapper 主要處理臉部身份,不應預期它會完整重建頭髮、頭型與飾品。換整個頭部通常需要其他編輯流程。
為什麼影片換臉要求選擇音源?
先檢查是否啟用了 lip_syncer。純換臉可先取消它,只保留 face_swapper 測試,需要對嘴時才加入音訊。
FaceFusion 側臉穿幫或閃爍怎麼辦?
先比較來源與目標的角度,再檢查人物選擇、遮擋遮罩與不同模型。用轉頭、張嘴與遮擋片段測試,不能只驗收單張預覽。
手機能透過 Cpolar 使用 FaceFusion 嗎?
可以透過瀏覽器操作已建立的遠端入口,但運算仍在原本電腦上。需要維持主機與服務在線,並設定存取驗證。
先把一小段做好,再把流程擴大
FaceFusion 的可調空間很大,也因此更需要固定測試方式。先用單張圖片確認身份與輪廓,再挑包含轉頭或遮擋的短片段驗收。只有當模型、遮罩與輸出設定穩定後,再加入增強、批次處理與遠端入口。
當你開始串接更多素材整理與輸出步驟,也可參考本地 AI 影片工作流的部署方式。真正省時間的,是知道每個步驟為什麼存在,以及出了問題要回頭檢查哪裡。
by Rain Chu | 9 月 27, 2026 | Agent, AI, 程式開發
Pi Agent 非常適合想自己決定 AI 寫程式流程的人,它把讀檔、寫檔、修改與執行命令放在小巧的核心裡,再透過擴充與模型設定增加能力,真正有用的地方,是你可以在同一段工作裡切換模型,回到先前的對話節點,重新探索另一種方案。
但輕量不代表不用設定,也不保證每次都比較省錢,要先分清楚擴充程式、專案規則、對話紀錄與檔案版本各自負責什麼,後續才不會把對話切回去了,卻以為程式碼也自動還原。
Pi Agent 是什麼?先理解它負責哪一層
Pi Agent是一套以終端機為主的 AI Coding Agent,也常被稱為 Agent Harness。
你可以把 Harness 理解成模型的工作環境,負責把請求、上下文、工具呼叫與執行結果串起來。模型決定下一步,Pi 則讓它能接觸專案檔案與工具。
預設核心工具是 read、write、edit 與 bash。計畫模式、子代理與 MCP 整合不是核心預設配備,可以再用擴充或套件補上。因此,適合的起手式是先用基本能力完成小任務,再增加確實需要的功能。
Pi 也提供不同的接入方式,日常操作用互動終端介面,單次自動化可用 print 或 JSON 輸出,需要其他程式控制時可走 RPC,想嵌入自己的應用則使用 SDK。
RPC 文件與SDK 文件適合留到需要整合時再看。
安裝 Pi Agent:使用目前官方套件名稱
截至 2026 年 9 月 12 日,官方快速入門採用的 npm 套件名稱是 @earendil-works/pi-coding-agent。較舊教學可能使用不同命名,請以官網當下的指令為準。
目前套件設定要求 Node.js 22.19.0 以上,安裝前先確認環境。
node --version
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi --version
--ignore-scripts 會停用安裝期間的套件生命週期腳本,官方說明一般 npm 安裝不需要這些腳本。看到版本資訊後,切換到要處理的專案目錄,再啟動 Pi。
cd /path/to/your-project
pi
上面的專案路徑要換成自己的資料夾,第一次練習可使用測試專案,先請它整理目錄、說明啟動方式與現有檢查項目,確認理解正確後再開始改程式。這樣也比較容易看出模型是否能正確使用工具。
模型接入:登入、API Key 與自訂端點分開處理
進入 Pi 後,先用 /login 設定模型服務,再用 /model 選擇模型,服務商文件列有訂閱登入與 API Key 兩種主要方式,可用選項取決於服務商、帳號與目前版本。
常用設定位於 ~/.pi/agent/。auth.json 保存驗證資料,models.json 用來加入自訂模型或端點,settings.json 管理偏好,sessions/ 保存對話。
專案自己的偏好放在 .pi/settings.json,有助於把個人習慣和團隊設定分開。
如果模型服務使用支援的相容 API,可依自訂模型文件填入端點、API 類型與模型 ID。
以下是設定結構範例,網址與模型名稱都是待替換值,不是可直接連線的服務。
{
  "providers": {
    "my-provider": {
      "baseUrl": "https://your-provider.example/v1",
      "api": "openai-completions",
      "apiKey": "$MY_PROVIDER_API_KEY",
      "models": [
        {
          "id": "your-model-id"
        }
      ]
    }
  }
}
將真正的金鑰放進 MY_PROVIDER_API_KEY 環境變數,設定檔保留變數參照即可。修改 models.json 後重新開啟 /model,Pi 會重新讀取。模型沒出現時,依序檢查 JSON 格式、驗證資料、模型 ID 與 API 類型。端點能聊天,也不一定代表工具呼叫完全相容。
Extension、Skill 與 Package 差在哪裡?
Extension 是會執行的擴充程式,通常以 TypeScript 撰寫,可以註冊工具、加入斜線命令、監聽事件、調整終端介面,或改變工具執行方式,例如,替特定命令增加確認流程,就是執行時的能力。
擴充文件提供 API 與範例。
Skill 是可重複使用的工作方法。它把說明與相關資源整理成一個任務單元,適合審稿、部署檢查或特定程式庫的使用流程,Pi 先讓模型知道有哪些技能,需要時再讀取完整內容。,看如何把方法寫成可重用流程,可以延伸閱讀站內的diagram-design 技能教學,再對照Pi 的技能載入規則調整。
Package 是安裝與分享的容器。它可以同時包含 Extension、Skill、提示詞範本與主題,也可以只有其中一種。
Pi Package 文件規定資源可在 package.json 的 pi 欄位宣告,或使用約定目錄。
Extension 和 Package 因此不是二選一的替代品。
安裝前先看套件作者、原始碼與支援版本,pi install 預設寫入個人設定,加上 -l 則用於專案範圍。可以用 pi list 檢查已安裝套件,資源修改後用 /reload 重新載入。
AGENTS.md 怎麼分層?override 只取代同層檔案
Pi 會在啟動時載入全域、父目錄與目前目錄的上下文檔案。全域的 ~/.pi/agent/AGENTS.md 可放常用語言與共通習慣,專案的 AGENTS.md 則放技術選擇、執行方式與驗收條件。
啟動畫面會列出已載入的檔案,可先核對是否符合預期。
依官方使用說明,同一個目錄若有 AGENTS.override.md,Pi 會改讀它,取代該目錄的 AGENTS.md 或 CLAUDE.md。
其他目錄的上下文仍會一起載入。這不能簡化成「有 override 就清空全部規則」,也不宜只靠一句優先級口訣管理互相矛盾的要求。
以賽車遊戲為例,專案規則可以寫得很具體,先限制第一版的範圍,再定義怎樣算完成。
# 專案工作規則

- 使用現有專案的技術,不另換框架
- 第一版先完成操作、碰撞、計時與重新開始
- 相機視角需先確認,再實作渲染方式
- 修改後執行專案既有檢查
- 回報改動、驗證結果與尚未解決的問題
這些是給模型讀取的指示,不是作業系統的權限限制。
若還有跨專案的知識要保存,可參考讓不同 Agent 共用專案知識的方式,避免把所有背景資料塞進每次啟動都載入的檔案。
專案信任不等於沙箱,pi-sandbox 也有適用範圍
Pi 的專案信任機制,決定是否載入專案內的設定、技能、套件與擴充,單純建立空的 .pi 目錄,不一定會出現信任提示,拒絕信任後,受保護的專案資源會略過,但 AGENTS.md 等上下文仍可能載入。
官方安全文件明確說明,這套機制不是沙箱。
Pi 本身會以啟動帳號的權限讀寫檔案與執行命令。若需要執行隔離,應依工作情境選擇容器、虛擬機或作業系統層的沙箱,只在提示詞裡要求「不要碰其他檔案」,不能取代這些限制。
carderne 的 pi-sandbox是一個可選的第三方擴充,為檔案工具加入規則,並透過 sandbox runtime 控制 Bash 的檔案與網路存取。它會在部分被擋下的操作上顯示授權提示。確認作者與套件名稱後,可依其文件安裝。
pi install npm:pi-sandbox
這個套件的 macOS 與 Linux 說明要求環境能找到 rg,設定位置包含全域的 ~/.pi/agent/sandbox.json 與專案的 .pi/sandbox.json。不同同名專案的格式不一定相同,不要混用範例。
Session Tree:保留探索路徑,也要另外保存程式碼
Pi 將對話存成樹狀 JSONL,預設放在 ~/.pi/agent/sessions/,並按工作目錄整理。每筆紀錄透過 ID 與父節點連接,因此可以在同一段對話裡保留不同嘗試。Session 文件對分支與選取行為有完整說明。
pi -c
pi -r
pi --name "racing-game-prototype"
上面三行是不同的啟動方式,依需要擇一。
pi -c 延續最近的對話,pi -r 選擇歷史紀錄,--name 則為啟動的對話設定名稱。進入 Pi 後,也可以用 /session 查看目前紀錄。
/tree 在同一份對話檔案內切換路徑,選取先前的使用者訊息時,原文字會回到編輯區,修改後送出就能展開另一條分支。若想從先前某個問題建立獨立對話,用 /fork,若要複製目前整條使用中的分支,則可用 /clone。
對話樹保存的是討論歷史,不能視為程式碼快照,切回舊節點時,磁碟上的檔案仍可能保留後續修改,要比較兩種實作,應另外使用 Git commit、分支、worktree 或獨立副本保存成果,再確認目前工作目錄和所選對話相符。
切換分支時,Pi 可以摘要離開的路徑,將重要資訊帶到新位置,若是同一需求的改良版,可保留問題與結論。若要獨立比較方案,則要留意摘要是否把原方案的假設帶了過去,長對話也可用 /compact 整理上下文,但摘要會取捨資訊,關鍵規格仍適合寫回專案文件。
用賽車原型練習:先計畫、再審查、最後驗收
一個好練習,是讓 Pi 先規劃俯視賽車原型,再嘗試固定追尾視角。重點不是一次做出完整遊戲,而是讓需求變動時,仍能追溯決策與保留可用版本。
第一步:先把驗收條件講清楚
先要求它列出操作方式、相機位置、碰撞、計時與重新開始等最小功能,暫時不要實作。把「做一個好玩的遊戲」改成可以檢查的條件,例如按鍵方向一致、失敗後能重新開始、相機不因轉彎而失去方向感。
第二步:切換模型審查計畫
用 /model 切到另一個模型,請它檢查計畫中缺少的條件、技術風險與需要確認的選項。這是同一段對話中的模型交接,不是同時啟動多個代理。分工可以是較快的模型整理方案、另一個模型審查關鍵設計,但是否更划算,需要用自己的任務驗證。
第三步:跑起來,檢查可操作性
程式生成後,要實際啟動並檢查操作、碰撞與視角。能開啟頁面,只代表基本流程可執行,不代表遊戲已完成。若俯視版本相機不穩,先保存檔案版本,再用 /tree 回到需求確認點,提出固定追尾視角的新方案。
執行途中想補充方向,可以送出 steering 訊息。想等目前工作完成後再追加任務,則使用 follow-up。預設快捷鍵分別是 Enter 與 Alt+Enter,實際可用 /hotkeys 確認。排隊訊息不是撤銷已執行操作的功能,緊急停止與後續修正仍要分開處理。
Pi 和 Hermes 怎麼選?先看你想完成哪種工作
Pi 適合想掌握本地開發流程、逐步組裝能力,或把 Agent 嵌入自己應用的使用者,Hermes Agent則提供記憶、技能累積、通訊平台接入與排程等較完整的個人助理能力。這是產品方向的差異,不足以直接推論哪一個寫程式一定比較強。
如果需求是從通訊軟體交辦長期工作,可以先看看站內的Hermes 與通訊平台整合,如果主要工作是對著專案反覆改程式,Pi 的對話樹與可擴充介面值得試用,偏好圖形工作台的人,也可比較OpenWork 本地 Agent 工作台的操作方式。
成本方面,不能只比較初始系統提示詞的長度,完整帳單還受模型價格、工具輸出、重試次數、快取與最後是否完成任務影響,Pi 顯示的用量和費用適合追蹤趨勢,自訂模型的價格設定也要正確,結算仍以服務商帳單為準。
常見問題
Pi Agent 是模型嗎?
不是。Pi 是讓模型讀寫檔案、呼叫工具與管理對話的工作環境,需要另外接入可用的模型服務。
Pi Agent 的 Extension 和 Package 有什麼不同?
Extension 是執行時的擴充程式,Package 是安裝與分享資源的容器,可以包含擴充、技能、提示詞與主題。
AGENTS.override.md 會取代所有規則嗎?
不會。它取代同一目錄的 AGENTS.md 或 CLAUDE.md,其他目錄的上下文仍會載入。
Pi 的 /tree 會還原專案檔案嗎?
不能把 /tree 當成檔案還原工具。它切換對話路徑,程式碼版本需要另外用 Git 或其他快照方式保存。
第一次使用,先完成一個能驗收的小任務
先接通一個模型,寫一份精簡的專案規則,請 Pi 完成小修改並說明驗證結果。熟悉之後,再加入真正需要的擴充,練習模型交接與對話分支。當每次嘗試都有清楚的需求、可追溯的討論與獨立保存的檔案版本,這套輕量工具才會成為可靠的開發流程。
by Rain Chu | 9 月 26, 2026 | AI, 圖型處理, 影片製作
想讓電腦桌面多一個會揮手、坐下、開口說話的角色,可以先做一段 AI 影片,再把影片設為動態桌布,我們可以用 ComfyUI 負責串接生成流程,MiniMax H3 產生影像與聲音,桌布軟體負責播放,把這三件事分開理解,製作時就比較不會卡在錯的地方。
這篇教學的成品是預先生成、循環播放的桌面角色。角色看似對著你說話,台詞其實已經寫在影片裡。
未來的目標是「我問一句,她能即時回答」,還需要另外建立對話系統。
先分清楚:會動的桌布,和能聊天的 AI 角色
動態桌布的核心是一個影片檔,角色何時眨眼、說哪一句話、什麼時候坐下,都在生成或剪輯時決定,播放時不會因為你突然發問,就改變下一句台詞,這種做法適合桌面裝飾、角色展示,以及固定內容的迎賓畫面。
即時互動則多了收音、語音辨識、語言模型、語音合成與嘴型同步。滑鼠互動或視線追蹤也要額外設計程式,不能只靠換一段提示詞。如果你要的是能接話的數位人,可以接著看本地 AI 數位人與語音互動流程。
第一步:先準備乾淨的場景與人物素材
準備一張適合當桌布的背景,以及一張有使用權的人物圖片。
人物若有透明背景,合成時比較容易調整大小與位置。建議先使用單一成年角色、簡單服裝與固定場景,讓第一輪生成只處理一個動作。
背景可以是沙發、房間或書桌,人物要有足夠空間完成動作。
放在桌面上時,還要避開常用圖示的位置。不要把真實桌面圖示與工作列一起烙進背景影片,否則 Windows 原本的圖示疊上去,會出現兩層圖示,後續改位置也容易露餡。
接下來要決定素材怎麼送進模型,使用圖生影片的 I2V 工作流時,最好先做成一張完整首幀,讓人物真的站在房間裡。把人物圖與背景圖左右並排後直接丟進 I2V,模型可能把拼貼版面也當成場景的一部分。
若希望分別提供人物、場景等參考素材,應改用支援參考輸入的 R2V 工作流,按模板指定的位置連接素材。
I2V 與 R2V 的輸入用途不同,不能只換檔名就當作同一件事。需要整理多張素材時,可參考ComfyUI 多圖參考與圖片編輯的處理思路。
第二步:從官方模板開始,模型檔案不要混用
先從ComfyUI 官方網站取得軟體,更新到支援 MiniMax H3 的版本,再從模板庫的影片分類找到 MiniMax H3,也可以下載 Comfy-Org 的 I2V 範例工作流,依畫面上的缺少模型提示補齊檔案。
桌面角色從一張完成的場景圖出發,可先用 I2V。若要改用多素材參考,再看官方 R2V 模板,先把一套官方範例跑通,再接作者自訂節點,排錯會容易很多。
以下是本次核對的官方 I2V 模板所使用的檔案配置。檔名可能隨模板更新調整,實際下載時以當前模板與 Comfy-Org 模型頁為準。
ComfyUI/models/
├── diffusion_models/
│   └── minimax_h3_fl2va_pruned_int8_convrot.safetensors
├── text_encoders/
│   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
├── loras/
│   └── minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors
└── vae/
    ├── minimax_h3_video_vae_fp16.safetensors
    └── minimax_h3_audio_vae_fp32.safetensors
主模型負責生成,文字編碼器處理提示內容,影片與音訊 VAE 則各有用途。不要只下載最大的模型檔,就以為其餘元件可以省略。官方模型頁也區分量化格式與執行環境,應照自己的環境選擇,不能把所有較小的檔案都視為可互換版本。
H3 的本地部署還牽涉系統記憶體與模型載入方式,不能只看顯卡名稱。進一步的環境整理可接著看MiniMax H3 本地部署與記憶體配置,再對照你實際載入的模型與模板版本。
第三步:先做一段短動作,不要一開始就塞滿劇情
第一輪可以用橫向構圖、固定鏡頭與較低的預覽解析度,先生成一段約 6 秒的動作。這裡的 6 秒是起步設定示例,並非效能保證。先確認角色外觀、動作與音訊都正常,再增加畫質與情節。
MiniMax H3 官方模型卡標示的生成時長為 4~15 秒。想做 30 秒的完整演出,可以先拆成數段鏡頭再剪輯,或另外研究延伸工作流,不能把 30 秒當作標準模板必然支援的單段設定。
解析度也要跟著模板的選擇器走。ComfyUI 的 H3 教學提醒,尺寸有對齊與像素量限制。初次嘗試不要任意輸入螢幕的完整高解析度,也不要把 API 提供的高解析度處理能力,直接套用到本地開放權重工作流。
提示詞示例:讓角色自然揮手,再回到休息姿勢
下面是為本文撰寫的起步提示詞,未經本機生成實測,重點是場景、動作與鏡頭都簡單,而且首尾姿勢接近,方便後續整理成循環影片。
固定鏡頭,橫向構圖,柔和的室內日光。
一名穿著藍綠色針織衫的成年女性坐在深灰色沙發上,人物外觀與參考圖一致。
她先自然地看向鏡頭,接著微笑並輕輕揮一次手,最後把手放回膝上,恢復安靜坐姿。
整段只有一位角色,背景保持穩定,動作平緩。
輕微室內環境聲,無對白、無背景音樂、無字幕。
先生成無對白版本,能比較容易看出畫面本身的問題。
等角色穩定後,再加一句短台詞,並參照官方提示詞指南處理說話者、台詞與發聲時機。不要在第一輪同時要求換裝、走路、坐下、唱歌與密集字幕,否則很難判斷是哪一項條件讓結果失控。
若需要字幕,建議在影片確認後再用剪輯軟體加入,把字幕直接交給影片模型生成,仍可能出現字形錯誤或時間不準,後製文字也比較容易修改。
第四步:確認加速 LoRA 真的有進入生成路徑
下載加速 LoRA,只完成了準備工作。還要確認載入節點選到正確檔案、節點沒有被略過,並且輸出確實接到後面的模型與採樣流程。若節點被停用或旁路,硬碟裡有那個檔案也不會自動產生加速效果。
H3 的工作流與任務模式有對應關係,加速設定也有自己的採樣配置。
先依官方原生工作流文件保留一整套相容設定,不要只因為想更快,就把不同任務的 LoRA、步數與模型任意混搭。加速後仍需重新檢查動作與聲音品質。
第五步:輸出影片,再用 Lively 設成動態桌布
生成完成後,先用一般播放器打開輸出的影片,檢查人物是否變形、背景有沒有漂移、聲音是否正常,以及片尾接回片頭時會不會突然跳動,如果首尾差異很大,可以縮短片段、重新安排動作,或在剪輯時做適度轉場。
Windows 使用者可以用免費開放原始碼的 Lively Wallpaper播放影片桌布。
從官方專案提供的管道安裝後,開啟 Lively,把輸出的 MP4 拖進程式建立桌布,再套用到指定螢幕。多螢幕配置可依官方入門說明調整。這是把成品落地到桌面的補充做法。
套用後,Windows 的圖示仍由作業系統顯示,影片只負責背景。
若桌布會反覆播放台詞,日常使用可能很干擾,建議先保留安靜版本,需要展示時再切換有聲版本。
跑不動、沒有聲音、下載要付費,怎麼判斷?
記憶體不足與藍畫面要分開處理
顯示記憶體不足時,先縮短影片、降低預覽解析度,並把批次數維持在 1。再確認是否載入了比預期更大的模型,以及系統記憶體是否也接近用滿。相同顯卡在不同模型格式、卸載策略與工作流下,結果可能差很多。
若整台電腦出現藍畫面,單憑這個現象無法判定就是顯示記憶體不足。先記錄錯誤代碼與當時設定,再檢查驅動、記憶體及系統穩定性。沒有完成實測之前,不應把某張 8GB 或 16GB 顯卡寫成一定可跑、一定不會當機的保證。
影片有畫面,卻沒有預期的聲音
先確認提示詞本來是否要求聲音,再檢查音訊 VAE、音訊相關節點及輸出是否接好。也要用播放器確認檔案音軌與靜音設定。最後才檢查桌布程式的音量,避免把生成端與播放端的問題混在一起。
先完成一段能穩定播放的短片
第一個里程碑可以很小:一張乾淨的場景圖、一個簡單動作、一段能順利輸出的影片。把它設成桌布後,再回頭調整畫質、循環接點與聲音。這樣每次只增加一個變因,比一開始追求長篇對話、換裝與高解析度更容易找到問題。
常見問題
桌面 AI 女友可以直接聽懂我說話嗎?
本文做法是播放預先生成的影片,不能即時接話。真正的語音互動還需要語音辨識、語言模型、語音合成與嘴型同步等元件。
MiniMax H3 可以用標準工作流一次生成 30 秒嗎?
官方模型卡標示的生成時長是 4~15 秒。30 秒成品可拆成多段再剪輯,額外的延伸工作流則要另外核對,不能視為標準模板的保證。
有 16GB 顯示記憶體就一定能跑嗎?
不能只憑顯示記憶體容量保證。模型格式、影片長度、解析度、系統記憶體與卸載方式都會影響結果,應先用短片及較低的預覽設定測試。
做好影片後,怎麼放到 Windows 桌面?
可以把輸出的 MP4 加入 Lively Wallpaper,再套用到指定螢幕。套用前先檢查首尾循環與音量,並避免把桌面圖示烙進影片背景。
近期留言