by Rain Chu 9 月 30, 2026 | AI , 程式開發
Security Guidance 是 Anthropic 提供的 Claude Code 安全審查外掛,會在 Claude 修改程式的過程中,自動提醒可能的漏洞,並把審查結果送回同一個工作階段處理 ,安裝後不必每次再打一段「請檢查安全性」,也不需要記住一個專門啟動它的 Skill 指令。
它適合用在 AI 協助開發網站、API、後台與自動化腳本的日常流程,尤其程式已經能跑,卻還沒確認使用者輸入、權限檢查或資料流向是否安全時,這類即時提醒可以讓問題更早被看見。
先釐清:Security Guidance 是 Skill、Hook,還是 Plugin?
正式分類是 Plugin,也就是外掛 ,Skill 通常是一份描述任務做法的指引,Hook 則是在特定事件發生時自動執行的程式,Security Guidance 把安全檢查程式包成外掛,透過 Hooks 接到 Claude Code 的工作流程。
所以,它的基本用法是「安裝並保持啟用,正常讓 Claude Code 工作」,目前提供的 外掛設定檔 與目錄結構以 Hooks 為核心,沒有要求你建立 SKILL.md,也沒有名為 /security-guidance 的獨立操作指令。
版本提醒: 截至 2026 年 9 月 28 日,官方市集頁 仍以較早的寫入前提醒介紹產品,但本文核對的 GitHub 版本為 2.0.0,實際 Hook 設定 已採用寫入後檢查及背景審查。下文依這份原始碼與現行使用文件說明,安裝後也應確認自己的外掛版本。
它如何運作?三個時機,三種檢查深度
第一層:檔案修改後,快速找出危險寫法
當 Claude 透過編輯或寫入工具修改檔案,外掛會比對特定字串、正規表示式與檔案路徑,例如動態執行字串的 eval()、把輸入交給 shell 的 child_process.exec()、直接寫入 HTML,以及不安全的反序列化。
這一層不需要呼叫模型,同一個工作階段裡,同一檔案的同一條規則通常只提醒一次,避免連續修改時反覆洗版,它抓到的是「需要留意的寫法」,未必代表那一行已經構成可利用的漏洞,後續仍要看輸入來源與上下文,規則可以在 內建模式清單 中查到。
第二層:一個回合結束後,檢查這回合的差異
你提出一次需求,Claude 修改程式並回覆,構成一個工作回合,外掛會用 Git 狀態整理這回合產生的差異,交給另一個以安全為目標的模型審查,這能補上單純字串比對看不出的問題,例如某個查詢是否漏掉使用者權限限制。
目前 Hook 設定使用背景審查,回覆可能先完成,稍後才把發現送回 Claude,讓它繼續處理,因此不能把「已看到完成回覆」理解成安全檢查已全部結束,依 官方回合審查說明 ,這一層也有檔案數與連續觸發次數限制,並不是無限檢查整個專案。
第三層:Claude 提交或推送時,追查相關程式
當 Claude 透過 Bash 工具執行符合條件的 git commit 或 git push,外掛可啟動更深入的審查,這個 reviewer 能用 Read、Grep、Glob 查看呼叫端、驗證函式與相關檔案,判斷跨檔案的資料流是否存在問題。
這裡的觸發範圍是 Claude Code 內的工具操作 ,不是替電腦安裝全域 Git 防線,你從自己的終端機執行 Git,或使用工作階段裡的 ! shell escape,不應假定也會受到這一層審查。
目前這三層都不會阻擋寫入或提交 ,發現問題後,仍要由 Claude 或開發者修正。如果團隊要求檢查未通過就不能合併,應另外使用 CI 必要檢查與分支保護,不能把背景提醒當成硬性關卡,這也是 設計 AI 工作環境與驗證流程 時需要先分清楚的責任。
Security Guidance 安裝方式
本文以本機終端機版 Claude Code 為主,先準備可正常使用的 Claude Code、Git 專案,以及 Python 3.10 以上與可用的 pip。這個 第一次使用時,外掛可能在 ~/.claude/security/ 下準備專用 Python 環境並安裝 Claude Agent SDK,需要網路與套件安裝能力。企業電腦若限制下載,應先核對初始化結果。
在 Claude Code 對話輸入列執行:
/plugin install security-guidance@claude-plugins-official這是 Claude Code 裡的指令,不是直接貼到一般終端機執行的 shell 指令。
安裝畫面若詢問範圍,User 適用於這台電腦上自己的各個專案,Project 用來分享專案設定,Local 則只套用到自己在目前專案的使用。
第一次體驗,可以選 User,或用 Local 限定在測試專案。
只有在系統明確回報找不到官方 marketplace 時,才先補上:
/plugin marketplace add anthropics/claude-plugins-official接著重試安裝。若安裝摘要提示需要啟用更新,依畫面執行 /reload-plugins,再透過 /plugin 檢查已安裝與啟用狀態。安裝範圍及重新載入方式可對照 官方外掛安裝文件 。
若你使用 Claude 桌面版或 VS Code 擴充套件,外掛管理入口可能不同。
安裝後怎麼用?照常開發,再處理提醒
不必先提出安全審查要求才能觸發。你可以像平常一樣請 Claude 新增功能、修改測試或整理程式,
外掛會依事件自動工作。比較有用的工作要求,是同時讓 Claude 回報做了什麼驗證,以及安全提醒最後如何處理,例如:
請替客服後台新增留言預覽功能。
使用者輸入只需顯示純文字,不需要 HTML 格式。
完成後執行相關測試,並說明 Security Guidance 若提出提醒,你如何修正或確認。
這段提示不是外掛的專用語法,而是本文的工作要求示例。它讓功能需求與驗收方式更清楚,無須故意要求 Claude 寫出危險程式來測試外掛。
範例一:顯示留言時,避開不必要的 HTML 注入
假設功能只是顯示訪客留下的文字,卻把內容直接指定給 innerHTML,外掛的模式規則可能提出 XSS 提醒。問題不在「有 HTML 就一定錯」,而是未受信任的內容會被瀏覽器當作標記處理。
若只需要純文字,較直接的實作是:
previewElement.textContent = commentTextReact 中也可以直接把文字放進 JSX 的文字位置,不必為了顯示普通留言使用 dangerouslySetInnerHTML。若功能確實需要富文字,才另外定義允許的標記與清理流程。這是在 使用 Claude Code 製作網站 時,很常遇到的需求界線。
範例二:呼叫外部工具時,把參數與 shell 字串分開
假設系統要呼叫一個已知的檔案分析工具,把檔名拼進 shell 指令字串,可能讓特殊字元被當成指令語法。Security Guidance 會對 child_process.exec 這類寫法提醒檢查輸入。
可以考慮用 execFile() 直接呼叫固定程式,將檔名放進參數陣列。例如以下概念片段,前提是程式路徑固定,且已先驗證檔案確實位於允許的目錄:
import { execFile } from 'node:child_process'

execFile('/opt/myapp/bin/file-inspector', [validatedFilePath], callback)
這裡的工具路徑與變數都是示意,不能直接照貼就當成完整程式。參數陣列能避開 shell 字串解析,但目標工具本身怎麼解讀參數、檔案存取範圍與權限,仍然要檢查。外掛的提醒應該促使你看完整條資料流。
範例三:修改 GitHub Actions,先看資料如何進入腳本
編輯 .github/workflows/ 裡的 YAML 檔案時,外掛可依路徑給出提醒。這不表示整份 workflow 已被判定有漏洞,而是這類檔案可能使用儲存庫權限、執行 shell 或接觸機密,值得額外檢查。
例如只想印出 Issue 標題,可以先把事件資料放到環境變數,再於 shell 使用帶引號的變數,而不是把外部文字直接插進腳本原始碼:
env:
  ISSUE_TITLE: ${{ github.event.issue.title }}
run: printf '%s\n' "$ISSUE_TITLE"
這只是 workflow 中的一個步驟片段,用來示範安全處理文字,不代表整份流程已經安全。
還要看 job 權限、第三方 action、事件來源與 secrets 是否使用得當。若尚不熟悉分支與提交,可以先讀 AI 開發時的 GitHub 版本管理 ,把修改留在可檢查、可回復的範圍。
加入自己的專案規則,讓提醒更貼近實際需求
用 Markdown 說明團隊規範
在專案建立 .claude/claude-security-guidance.md,寫下模型不會自行知道的要求,以下是本文設計的多租戶後台示例,可依自己的函式名稱與資料表調整:
# 本專案安全規則

- 所有 /admin 路由必須先通過 requireAdmin,再讀取業務資料。
- 查詢租戶資料時,tenant_id 必須來自已驗證的工作階段,不可信任請求直接提供的值。
- 日誌不得包含存取權杖、密碼或完整的付款資料。
- 訪客留言預設以純文字顯示,富文字必須使用專案核准的清理函式。
規則應寫出「哪裡需要什麼條件」,比單純要求「遵守最佳安全實務」更容易被檢查,不要把 API key、真實權杖或正式客戶資料放進檔案,因為內容可能被加入模型審查的提示。
也可以把個人通用規則放在 ~/.claude/claude-security-guidance.md,或用 .claude/claude-security-guidance.local.md 保存不打算共用的專案設定,官方目前對不同審查路徑載入規則的說明仍有版本差異,因此至少要確認回合差異審查有載入,不能只因為檔案存在就推定所有路徑都生效。
用 JSON 加入可重現的文字提醒
如果某個舊函式不應再出現在新程式裡,可以建立 .claude/security-patterns.json。以下示例看到 legacyUnsafeRenderer( 就提醒改用專案的新介面:
{
  "patterns": [
    {
      "rule_name": "legacy_renderer",
      "substrings": [
        "legacyUnsafeRenderer("
      ],
      "paths": [
        "**/src/**"
      ],
      "reminder": "這個舊介面不應用於新程式,請改用專案的安全文字顯示函式,並確認輸入來源。"
    }
  ]
}
這裡的函式名稱是示例,不是內建 API。paths 用來限制檔案範圍,比對的是完整路徑,因此專案相對位置前面使用 **/。JSON 不需要額外的 YAML 解析套件,比第一次就加入正規表示式更容易確認設定是否正確。
這類自訂規則是補充提醒,並不會刪除內建規則,也不是程式碼執行權限設定。其格式與載入行為可對照 自訂規則實作 。
怎麼確認真的有啟用?用無害的測試標記
最容易誤會的是「沒有出現警告,所以一切正常」。沒有警告,也可能是沒有符合模式、這個工作階段已提醒過、背景審查還沒結束,或環境缺少必要元件。
想確認自訂模式有載入,可以在可丟棄的測試分支中,讓 Claude 用編輯工具新增 src/security-guidance-demo.js,內容只放下面這行註解,然後觀察是否收到 legacy_renderer 的提醒:
// 示範字串 legacyUnsafeRenderer(,僅供規則比對,不執行任何函式字串規則可能連註解也會匹配,正好可以用來測試,不必真的執行危險程式。
需要排查時,先看 ~/.claude/security/log.txt 的活動與錯誤,再確認專案有 Git、Python 與 SDK 初始化成功,以及所選模型與服務供應商可用。若沒有 Git 儲存庫,仍可能有逐次編輯提醒,但以 Git 差異為基礎的審查無法照常工作。
費用與資料流向:不要把它當成完全離線檢查
模式比對本身不呼叫模型,回合差異與提交審查則會額外使用模型額度,深入審查可能讀取更多檔案、進行多輪判斷,因此不能把外掛安裝後的使用成本視為零。
核對版本的預設審查模型為 Claude Opus 4.7。SECURITY_REVIEW_MODEL 用於差異審查,SG_AGENTIC_MODEL 用於 agentic 審查。若改用 Bedrock、Vertex 或其他端點,模型識別名稱應依供應商設定,不宜直接複製別人的環境變數。
執行模型審查時,變更路徑、差異與相關程式內容會傳到設定的模型端點,深入審查還可能讀取其他相關檔案
。使用公司程式碼時,應沿用組織允許的端點與資料政策。這是此工具的運作條件,不能把「Hook 在本機執行」解讀成程式碼永遠不會離開本機。
它和 /security-review、Claude Security 有什麼不同?
Security Guidance:跟著 Claude Code 的開發過程自動提醒與審查,適合日常修改。
/security-review:由使用者主動提出的一次性安全檢查,與自動 Hook 的觸發方式不同。
Claude Security 外掛:提供更深入的程式庫或差異掃描與修補工作流,是另一個工具,不能只因名稱都有 Security 就視為同一套功能。
如果需求是檢查既有的整個網站,或確認某個版本能否上線,還要搭配人工審查、依賴套件掃描、測試與 CI。Security Guidance 能把部分問題提前到開發當下,但「沒提醒」不是安全認證。
Security Guidance 常見問題
只要把 SKILL.md 放進專案就能用嗎?
不能等同。Security Guidance 是包含 Hook 設定與程式的外掛,應透過官方外掛流程安裝,單獨放一份 Skill 指引不會啟動它的檢查。
它會阻止有漏洞的程式被提交嗎?
目前三層都是提醒或背景審查,不會阻擋寫入與提交。需要強制把關時,應另外設定 CI 必要檢查與分支保護。
所有安全提醒都必須照單全收嗎?
先核對輸入是否可被外部控制、既有驗證是否有效,以及實際影響。若確定是誤報,應保留具體理由,不能只用一句「這是安全的」取代證據。
從小型專案開始,把提醒接到修正與驗證
第一次使用,先選一個可回復修改的 Git 專案,確認外掛啟用,再讓 Claude 完成小功能。看到提醒後檢查原因、修正程式並跑相關測試,最後再決定是否提交。習慣這個流程後,再加入團隊規則,效果會比一開始塞進大量抽象要求更容易評估。
Security Guidance 的實際價值,在於把安全問題放回寫程式的當下,讓你更早知道哪裡需要檢查。它能協助縮短發現問題到修正的距離,最後的驗收仍要回到程式行為與測試結果。
by Rain Chu 9 月 27, 2026 | Agent , AI , 程式開發
Pi Agent 非常適合想自己決定 AI 寫程式流程的人,它把讀檔、寫檔、修改與執行命令放在小巧的核心裡,再透過擴充與模型設定增加能力,真正有用的地方,是你可以在同一段工作裡切換模型,回到先前的對話節點,重新探索另一種方案。
但輕量不代表不用設定,也不保證每次都比較省錢,要先分清楚擴充程式、專案規則、對話紀錄與檔案版本各自負責什麼,後續才不會把對話切回去了,卻以為程式碼也自動還原。
Pi Agent 是什麼?先理解它負責哪一層
Pi Agent 是一套以終端機為主的 AI Coding Agent,也常被稱為 Agent Harness。
你可以把 Harness 理解成模型的工作環境,負責把請求、上下文、工具呼叫與執行結果串起來。模型決定下一步,Pi 則讓它能接觸專案檔案與工具。
預設核心工具是 read、write、edit 與 bash。計畫模式、子代理與 MCP 整合不是核心預設配備,可以再用擴充或套件補上。因此,適合的起手式是先用基本能力完成小任務,再增加確實需要的功能。
Pi 也提供不同的接入方式,日常操作用互動終端介面,單次自動化可用 print 或 JSON 輸出,需要其他程式控制時可走 RPC,想嵌入自己的應用則使用 SDK。
RPC 文件 與SDK 文件 適合留到需要整合時再看。
安裝 Pi Agent:使用目前官方套件名稱
截至 2026 年 9 月 12 日,官方快速入門 採用的 npm 套件名稱是 @earendil-works/pi-coding-agent。較舊教學可能使用不同命名,請以官網當下的指令為準。
目前套件設定 要求 Node.js 22.19.0 以上,安裝前先確認環境。
node --version
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi --version
--ignore-scripts 會停用安裝期間的套件生命週期腳本,官方說明一般 npm 安裝不需要這些腳本。看到版本資訊後,切換到要處理的專案目錄,再啟動 Pi。
cd /path/to/your-project
pi
上面的專案路徑要換成自己的資料夾,第一次練習可使用測試專案,先請它整理目錄、說明啟動方式與現有檢查項目,確認理解正確後再開始改程式。這樣也比較容易看出模型是否能正確使用工具。
模型接入:登入、API Key 與自訂端點分開處理
進入 Pi 後,先用 /login 設定模型服務,再用 /model 選擇模型,服務商文件 列有訂閱登入與 API Key 兩種主要方式,可用選項取決於服務商、帳號與目前版本。
常用設定位於 ~/.pi/agent/。auth.json 保存驗證資料,models.json 用來加入自訂模型或端點,settings.json 管理偏好,sessions/ 保存對話。
專案自己的偏好放在 .pi/settings.json,有助於把個人習慣和團隊設定分開。
如果模型服務使用支援的相容 API,可依自訂模型文件 填入端點、API 類型與模型 ID。
以下是設定結構範例,網址與模型名稱都是待替換值,不是可直接連線的服務。
{
  "providers": {
    "my-provider": {
      "baseUrl": "https://your-provider.example/v1",
      "api": "openai-completions",
      "apiKey": "$MY_PROVIDER_API_KEY",
      "models": [
        {
          "id": "your-model-id"
        }
      ]
    }
  }
}
將真正的金鑰放進 MY_PROVIDER_API_KEY 環境變數,設定檔保留變數參照即可。修改 models.json 後重新開啟 /model,Pi 會重新讀取。模型沒出現時,依序檢查 JSON 格式、驗證資料、模型 ID 與 API 類型。端點能聊天,也不一定代表工具呼叫完全相容。
Extension、Skill 與 Package 差在哪裡?
Extension 是會執行的擴充程式 ,通常以 TypeScript 撰寫,可以註冊工具、加入斜線命令、監聽事件、調整終端介面,或改變工具執行方式,例如,替特定命令增加確認流程,就是執行時的能力。
擴充文件 提供 API 與範例。
Skill 是可重複使用的工作方法。 它把說明與相關資源整理成一個任務單元,適合審稿、部署檢查或特定程式庫的使用流程,Pi 先讓模型知道有哪些技能,需要時再讀取完整內容。,看如何把方法寫成可重用流程,可以延伸閱讀站內的diagram-design 技能教學 ,再對照Pi 的技能載入規則 調整。
Package 是安裝與分享的容器。 它可以同時包含 Extension、Skill、提示詞範本與主題,也可以只有其中一種。
Pi Package 文件 規定資源可在 package.json 的 pi 欄位宣告,或使用約定目錄。
Extension 和 Package 因此不是二選一的替代品。
安裝前先看套件作者、原始碼與支援版本,pi install 預設寫入個人設定,加上 -l 則用於專案範圍。可以用 pi list 檢查已安裝套件,資源修改後用 /reload 重新載入。
AGENTS.md 怎麼分層?override 只取代同層檔案
Pi 會在啟動時載入全域、父目錄與目前目錄的上下文檔案。全域的 ~/.pi/agent/AGENTS.md 可放常用語言與共通習慣,專案的 AGENTS.md 則放技術選擇、執行方式與驗收條件。
啟動畫面會列出已載入的檔案,可先核對是否符合預期。
依官方使用說明 ,同一個目錄若有 AGENTS.override.md,Pi 會改讀它,取代該目錄的 AGENTS.md 或 CLAUDE.md。
其他目錄的上下文仍會一起載入。 這不能簡化成「有 override 就清空全部規則」,也不宜只靠一句優先級口訣管理互相矛盾的要求。
以賽車遊戲為例,專案規則可以寫得很具體,先限制第一版的範圍,再定義怎樣算完成。
# 專案工作規則

- 使用現有專案的技術,不另換框架
- 第一版先完成操作、碰撞、計時與重新開始
- 相機視角需先確認,再實作渲染方式
- 修改後執行專案既有檢查
- 回報改動、驗證結果與尚未解決的問題
這些是給模型讀取的指示,不是作業系統的權限限制。
若還有跨專案的知識要保存,可參考讓不同 Agent 共用專案知識的方式 ,避免把所有背景資料塞進每次啟動都載入的檔案。
專案信任不等於沙箱,pi-sandbox 也有適用範圍
Pi 的專案信任機制,決定是否載入專案內的設定、技能、套件與擴充,單純建立空的 .pi 目錄,不一定會出現信任提示,拒絕信任後,受保護的專案資源會略過,但 AGENTS.md 等上下文仍可能載入。
官方安全文件 明確說明,這套機制不是沙箱。
Pi 本身會以啟動帳號的權限讀寫檔案與執行命令。若需要執行隔離,應依工作情境選擇容器、虛擬機或作業系統層的沙箱,只在提示詞裡要求「不要碰其他檔案」,不能取代這些限制。
carderne 的 pi-sandbox 是一個可選的第三方擴充,為檔案工具加入規則,並透過 sandbox runtime 控制 Bash 的檔案與網路存取。它會在部分被擋下的操作上顯示授權提示。確認作者與套件名稱後,可依其文件安裝。
pi install npm:pi-sandbox這個套件的 macOS 與 Linux 說明要求環境能找到 rg,設定位置包含全域的 ~/.pi/agent/sandbox.json 與專案的 .pi/sandbox.json。不同同名專案的格式不一定相同,不要混用範例。
Session Tree:保留探索路徑,也要另外保存程式碼
Pi 將對話存成樹狀 JSONL,預設放在 ~/.pi/agent/sessions/,並按工作目錄整理。每筆紀錄透過 ID 與父節點連接,因此可以在同一段對話裡保留不同嘗試。Session 文件 對分支與選取行為有完整說明。
pi -c
pi -r
pi --name "racing-game-prototype"
上面三行是不同的啟動方式,依需要擇一。
pi -c 延續最近的對話,pi -r 選擇歷史紀錄,--name 則為啟動的對話設定名稱。進入 Pi 後,也可以用 /session 查看目前紀錄。
/tree 在同一份對話檔案內切換路徑,選取先前的使用者訊息時,原文字會回到編輯區,修改後送出就能展開另一條分支。若想從先前某個問題建立獨立對話,用 /fork,若要複製目前整條使用中的分支,則可用 /clone。
對話樹保存的是討論歷史,不能視為程式碼快照 ,切回舊節點時,磁碟上的檔案仍可能保留後續修改,要比較兩種實作,應另外使用 Git commit、分支、worktree 或獨立副本保存成果,再確認目前工作目錄和所選對話相符。
切換分支時,Pi 可以摘要離開的路徑,將重要資訊帶到新位置,若是同一需求的改良版,可保留問題與結論。若要獨立比較方案,則要留意摘要是否把原方案的假設帶了過去,長對話也可用 /compact 整理上下文,但摘要會取捨資訊,關鍵規格仍適合寫回專案文件。
用賽車原型練習:先計畫、再審查、最後驗收
一個好練習,是讓 Pi 先規劃俯視賽車原型,再嘗試固定追尾視角。重點不是一次做出完整遊戲,而是讓需求變動時,仍能追溯決策與保留可用版本。
第一步:先把驗收條件講清楚
先要求它列出操作方式、相機位置、碰撞、計時與重新開始等最小功能,暫時不要實作。把「做一個好玩的遊戲」改成可以檢查的條件,例如按鍵方向一致、失敗後能重新開始、相機不因轉彎而失去方向感。
第二步:切換模型審查計畫
用 /model 切到另一個模型,請它檢查計畫中缺少的條件、技術風險與需要確認的選項。這是同一段對話中的模型交接,不是同時啟動多個代理。分工可以是較快的模型整理方案、另一個模型審查關鍵設計,但是否更划算,需要用自己的任務驗證。
第三步:跑起來,檢查可操作性
程式生成後,要實際啟動並檢查操作、碰撞與視角。能開啟頁面,只代表基本流程可執行,不代表遊戲已完成。若俯視版本相機不穩,先保存檔案版本,再用 /tree 回到需求確認點,提出固定追尾視角的新方案。
執行途中想補充方向,可以送出 steering 訊息。想等目前工作完成後再追加任務,則使用 follow-up。預設快捷鍵分別是 Enter 與 Alt+Enter,實際可用 /hotkeys 確認。排隊訊息不是撤銷已執行操作的功能,緊急停止與後續修正仍要分開處理。
Pi 和 Hermes 怎麼選?先看你想完成哪種工作
Pi 適合想掌握本地開發流程、逐步組裝能力,或把 Agent 嵌入自己應用的使用者,Hermes Agent 則提供記憶、技能累積、通訊平台接入與排程等較完整的個人助理能力。這是產品方向的差異,不足以直接推論哪一個寫程式一定比較強。
如果需求是從通訊軟體交辦長期工作,可以先看看站內的Hermes 與通訊平台整合 ,如果主要工作是對著專案反覆改程式,Pi 的對話樹與可擴充介面值得試用,偏好圖形工作台的人,也可比較OpenWork 本地 Agent 工作台 的操作方式。
成本方面,不能只比較初始系統提示詞的長度,完整帳單還受模型價格、工具輸出、重試次數、快取與最後是否完成任務影響,Pi 顯示的用量和費用適合追蹤趨勢,自訂模型的價格設定也要正確,結算仍以服務商帳單為準。
常見問題
Pi Agent 是模型嗎?
不是。Pi 是讓模型讀寫檔案、呼叫工具與管理對話的工作環境,需要另外接入可用的模型服務。
Pi Agent 的 Extension 和 Package 有什麼不同?
Extension 是執行時的擴充程式,Package 是安裝與分享資源的容器,可以包含擴充、技能、提示詞與主題。
AGENTS.override.md 會取代所有規則嗎?
不會。它取代同一目錄的 AGENTS.md 或 CLAUDE.md,其他目錄的上下文仍會載入。
Pi 的 /tree 會還原專案檔案嗎?
不能把 /tree 當成檔案還原工具。它切換對話路徑,程式碼版本需要另外用 Git 或其他快照方式保存。
第一次使用,先完成一個能驗收的小任務
先接通一個模型,寫一份精簡的專案規則,請 Pi 完成小修改並說明驗證結果。熟悉之後,再加入真正需要的擴充,練習模型交接與對話分支。當每次嘗試都有清楚的需求、可追溯的討論與獨立保存的檔案版本,這套輕量工具才會成為可靠的開發流程。
by Rain Chu 9 月 25, 2026 | AI , claude , 程式開發
Claude Opus 5.5 值得關注的地方,是把需求轉成可操作作品的能力。
同樣交給 AI 一段描述,成果可以是動畫、原生 App、可走進去的 3D 房屋,也可以是帶有武器切換與戰鬥互動的遊戲。真正要問的,是這些作品做到哪裡,以及哪些地方仍需要人檢查。
這次整理把公開案例分成動畫、應用程式、空間、遊戲、介面與機械六個方向。
Opus 5.5、Claude Code、Claude Design,分別負責什麼?
Anthropic 於 2026 年 9 月 22 日推出 Claude Opus 5.5 ,官方 Claude Code 文件 說明了這些操作能力,單純在聊天視窗請模型寫一段程式,與讓它在完整專案裡編譯、測試,是不同的工作方式。
Claude Design 則偏向視覺設計與互動原型,它適合探索頁面、版型和設計方向,但畫面上的按鈕可以切換,不代表會員、金流、資料庫與部署已經接好。選工具前,先決定要的是設計提案、可執行專案,還是正式服務。
動畫案例:蝴蝶、水墨與中子星,要分別驗收
蝴蝶生命週期:連續動作比單張漂亮畫面更重要
蝴蝶案例串起卵、幼蟲吃葉成長、結蛹、羽化與展翅飛行,成蝶剛離開蛹時,翅膀仍處於折疊狀態,之後才逐步展開,這種任務同時考驗形態變化與時間節奏,不能只看某一幀像不像蝴蝶,若用於教學,還要檢查各階段的順序與說明是否正確。
需求可以寫成「每個階段停留到足以辨認,再進入下一段,提供暫停與重播」。這比只要求畫面華麗更容易驗收,也能讓模型把時間軸與互動控制一起規劃。
國風水墨:觀察暈染與轉場是否連續
水墨案例在 Claude Design 中完成,從墨色在宣紙上暈染開始,接著帶出層疊山脈、日輪、飛鳥、水面與小船,再轉到荷葉荷花、梅樹,最後以多色墨跡旋轉交織收尾。它把抽象風格落到連續的動態規則,包含擴散速度、留白、筆觸密度與前後景層次。
要延伸成品牌片或教學動畫,可以先做一小段品質樣本,再擴充完整分鏡。站上的Claude Code 與 Remotion 動畫工作流 提供了分鏡、工具分工與逐幀檢查的方法,適合把一次展示整理成可重複修改的製作流程。
中子星:視覺化與物理模擬是兩種交付
另中子星動畫展示,透過自動播放與不同角度呈現天文題材。這段口述的模型名稱與全片主題不完全一致,因此本文只把它當成視覺化題材示例,不作單獨的版本比較依據。若要作為科學教材,還須說清楚哪些是示意,哪些參數有資料依據,畫面有說服力並不會自動證明物理模型正確。
原生 App:macOS 音樂播放器與 iOS 背單字工具
macOS 音樂播放器:介面之外,播放流程才是重點
音樂播放器案例採取接近 Apple Music 的介面方向,在 Xcode 開啟專案後執行,展示匯入音樂、播放、暫停與調整音量,也能建立播放清單、瀏覽歌曲、專輯與歌手,並叫出迷你播放器。這讓驗收從靜態畫面進一步走到檔案與媒體操作。
如果要延伸成日常使用的工具,我會再檢查取消匯入、無法辨識的檔案、重複歌曲、播放進度與重新啟動後的資料保留。這些都是下一步的驗收項目,不能因為正常播放一次,就推定全部都已完成。
3D 房屋:從平面圖走進空間,也要檢查還原程度
把一張平面圖轉成能探索的三維房屋,是這組案例很直觀的亮點。操作包含切換一樓與二樓俯視圖,再進入屋內探索客廳、臥室、廚房、洗手間與書房。門會在靠近與離開時自動開關,也能沿樓梯上樓,從臥室走到陽台。
我會把驗收拆成兩部分。第一部分是空間對應,房間的位置、連通關係與樓層是否符合原圖。第二部分是互動,能不能正常進出、是否穿牆、樓梯是否可走。建模結果適合空間溝通或概念展示,不能直接視為具有尺寸與結構驗證的施工模型。
Claude Design:鍵盤詳情頁與宇宙探索 App 原型
鍵盤詳情頁:漂亮版型要能支持產品資訊
鍵盤產品頁展示不同視覺方向,包含深色主題,用產品圖像、留白與版面安排呈現較俐落的風格。若要從設計展示變成電商頁,還要確認規格、選項、價格與購買路徑,並測試手機版是否仍容易操作。
可以搭配Claude Code 網站製作工作流 ,把設計方向、元件、動效與正式網站需求分開規劃,減少外觀已完成、功能仍空白的落差。
宇宙探索 App:探索體驗與內容可信度分開檢查
宇宙探索原型提供不同風格,能切換探索、太陽系與星空等頁面,拖曳查看行星,打開木星、地球等天體詳情,並比較行星大小。它展示了導覽與資訊卡片如何串接,但天體數據、比例與描述仍需另行核對,不能把可點擊的原型當成已驗證的天文資料庫。
Claude Opus 5.5 價格:單價降低,不代表每個任務固定省多少
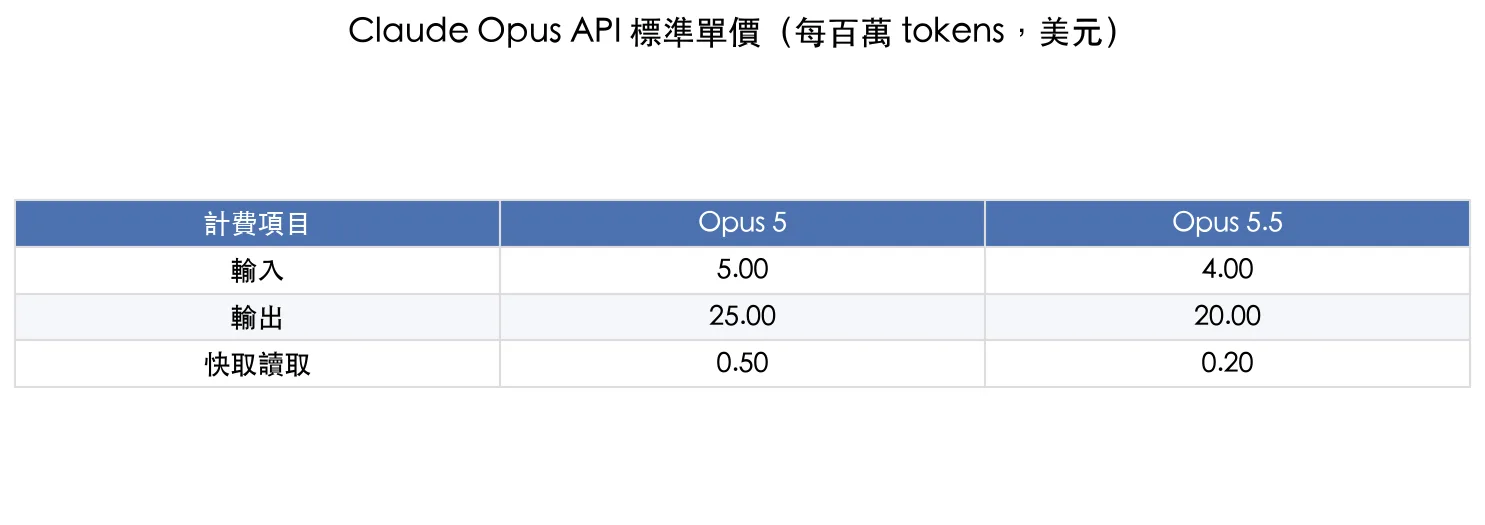
依官方 Opus 價格資訊 ,標準 API 單價如下。這是按 tokens 計費的價格,不是 Claude 訂閱月費。
每百萬 tokens,美元 Opus 5 Opus 5.5 輸入 5.00 4.00 輸出 25.00 20.00 快取讀取 0.50 0.20
2026 年 9 月 23 日核對的標準 API 單價,不含 Fast mode 或其他服務費用。 任務總成本還取決於輸入量、輸出量、快取命中、重試次數與工具使用。官方對典型工作負載的節省估計,不能直接套用成每個專案的保證。想比較模型,最好給相同需求與驗收條件,同時記錄費用和修改次數。
把案例用到自己的專案:先做一條完整流程
在 Claude Code 中,可依官方模型設定說明 指定 claude-opus-5-5。帳號可用性與額度仍以實際介面為準,不要只憑模型自稱的版本判斷是否切換成功。
如果要開始嘗試,可以先選一個範圍小、結果清楚的任務。播放器先完成匯入與播放,單字 App 先完成一輪學習與保存,3D 房屋先完成一個房間與一扇門。把這條流程做對,再增加視覺細節與次要功能。
開工前可先用需求訪談的方式 釐清使用者、裝置、資料來源與驗收標準。不要只交付「做得漂亮」,而要列出哪些操作必須成功,以及失敗時應該發生什麼。
專案開始修改前也要留好版本。依Vibe Coding 版本管理方法 分階段保存,出現問題才有辦法知道改了哪裡、回到哪一版。模型變強,並不會讓版本管理與驗收失去必要性。
想延伸研究,可從作者的公開 GitHub 專案入口 查找相關工具,但不能據此假定本次所有展示都有提供原始碼。重現案例前,應先確認有沒有完整專案、依賴與執行方式。
Claude Opus 5.5 常見問題
Claude Opus 5.5 可以直接做出可上架 App 嗎?
它能協助產生與修改原生 App 專案,但可執行原型和正式上架不同。仍需檢查功能、資料保存、權限、簽署與發行流程。
Claude Code 和 Claude Design 要怎麼選?
要編輯專案、執行工具與測試,可使用 Claude Code。要探索視覺方向和互動原型,可使用 Claude Design。兩者都需要清楚的需求與驗收標準。
Opus 5.5 API 多少錢?
標準 API 每百萬 tokens 的輸入為 4 美元、輸出為 20 美元、快取讀取為 0.20 美元。訂閱方案、Fast mode 與其他服務費用另計。
Opus 5.5 的知識更新到什麼時候?
官方支援文件列出訓練資料截至 2026 年 6 月。即時問題仍應透過可靠來源查證,不能只相信模型自述。
by Rain Chu 9 月 19, 2026 | AI , 程式開發
用 AI 做網站或小工具,最讓人緊張的時刻,往往是原本正常的功能突然壞掉,請它修一下,又改出更多問題,最後連哪個版本能用都說不清楚。
Vibe Coding 想要改得放心,先要有能確認的版本紀錄, Git 負責保存程式變更,GitHub 提供遠端儲存庫與協作流程。你不必先背熟指令,但要能回答改動存在哪裡、是否進入主分支,以及復原會影響哪些內容。
這篇 GitHub 入門指南以能讀寫專案檔案的 AI 開發工具為情境,若使用 Lovable 這類 AI App Builder ,也要先確認平台的版本紀錄、GitHub 同步與部署各由誰管理,避免把不同系統的「已儲存」當成同一件事。
Git 和 GitHub 差在哪?先分清楚存檔與提交
Git 是版本控制工具,可以在自己的電腦上運作,GitHub 則是託管 Git 儲存庫的平台,讓程式可以放到遠端、比較修改內容,再透過 Pull Request 討論與合併,使用 Git 不一定要使用 GitHub,也可以搭配其他託管平台。
按下編輯器的儲存,只代表檔案寫入磁碟,commit 才是建立一筆 Git 提交紀錄 ,通常記錄的是放入暫存區的內容,也就是這次選定要提交的變更,尚未加入版本控制、被忽略,或還沒選入暫存區的修改,不會因為做了一次 commit 就全部被保存,細節可參考 Git 官方的變更記錄說明 。
因此,第一次請 AI 接手專案,可以先讓它檢查是否已有 Git 紀錄、目前在哪個分支,以及有哪些未提交的檔案,接著在功能確認正常後建立一筆容易辨識的提交,例如「完成登入表單驗證」,再開始下一輪修改。
先檢查這個專案的 Git 狀態,列出目前分支、最新提交,以及已修改和未追蹤的檔案。說明這次應保存哪些內容,排除密碼與無關檔案,再建立一筆清楚描述功能狀態的提交。
Commit、push、PR、merge,是不同的完成狀態
commit 留在本機,不代表遠端已有相同內容,push 把提交送到指定的遠端分支,也不代表改動已進入主分支,PR 是提出合併變更的請求,merge 才會把變更整合到目標分支。
採用 PR 流程時,要檢查 PR 指向哪個目標分支、狀態是 Open、Closed 還是 Merged,Closed 只表示請求關閉,不能直接理解成已合併,部分專案允許直接推送主分支,因此 PR 是一種協作與審查流程,不是所有 Git 專案的必經步驟,可參考 GitHub 的 Pull Request 說明 。
還有一個容易漏掉的狀況:PR 已合併後,又把新提交推到原來的功能分支,push 可能成功,但後來的提交不會自動補進那次已完成的合併,要另外確認是否需要新 PR,或依專案流程再次整合。
儲存庫更新與網站上線也要分開驗收 ,GitHub 上看得到程式,不代表正式網站正在執行那一版,部署平台可能使用另一個分支,也可能建置失敗。像 用 Claude Code 製作網站的完整工作流 ,最後仍要回到實際網址確認功能與畫面。
上傳前檢查機密,補上 .gitignore 不會抹掉歷史
API 金鑰、資料庫密碼、含憑證的設定檔,不應直接放進提交,請 AI 同時檢查檔案清單與即將提交的內容,並依專案需要設定 .gitignore。私有儲存庫也應避免存放這些機密。
.gitignore 主要處理尚未追蹤的檔案,已經被 Git 追蹤的檔案,不會因為新增忽略規則就自動停止追蹤,既有提交中的內容也仍然存在,這是 Git 官方文件 明確區分的行為。
如果金鑰已經外洩,第一步是到服務提供者那裡撤銷或更換金鑰,再處理儲存庫內容與歷史,只把目前檔案刪掉,不能讓舊金鑰失效。歷史清理還可能影響協作者,應依 GitHub 的機密資料處理指引 安排。
換電腦與同步協作,clone 和 pull 各做什麼?
從 GitHub 下載 ZIP,取得的是某個版本的檔案快照,要延續既有 Git 開發流程,通常會用 clone 取得儲存庫與版本歷史,讓本機能追蹤遠端。只拿到 ZIP,不能直接假設原來的 Git 設定和提交紀錄也都在。
已有本機儲存庫後,pull 會抓取遠端變更,再依設定整合到目前分支,例如使用 merge 或 rebase,它不只是把遠端檔案下載覆蓋過來,同步前先確認分支、遠端,以及本機尚未提交的內容是否妥善保存,操作語意可查 git pull 官方文件 。
發生衝突時,讓 AI 說明兩邊原本要保留的行為,再決定如何整合,即使沒有出現文字衝突,也可能發生功能上的衝突。例如一邊調整登入流程,另一邊改了權限判斷,合併成功後仍要把兩個情境都測過。
兩個 AI 同時改專案,先分開實際工作目錄
同時開兩個 AI 視窗,不等於它們各有一份檔案。如果都在同一個工作目錄,一方存檔、切換分支或整理暫存內容,仍可能干擾另一方。只有不同任務名稱或分支名稱,也不足以證明工作檔案已隔離。
Git worktree 可以讓同一個儲存庫擁有多個工作目錄,分別檢出不同分支。 例如一份處理登入,一份調整版面,完成後再逐一審查與合併。它們有各自的工作檔案與部分狀態,但仍共享儲存庫資料及部分參照,不能把它當成完全獨立的安全沙箱。詳見 Git worktree 官方文件 。
要確認的,是每個 AI 實際使用的 worktree 根目錄與分支,若測試會共用資料庫、輸出位置或服務連接埠,也要另外安排。想把這套分工放進操作介面,可以延伸閱讀 Orca ADE 的多 Agent 與 worktree 工作方式 。
開始平行開發前,請列出每個任務的實際 worktree 根目錄、分支及修改範圍,確認彼此不會寫入同一份工作檔案,並檢查測試資料庫、輸出資料夾與連接埠是否共用。完成後逐一提交、驗證與合併。
AI 改壞了怎麼復原?先辨認改動在哪個階段
先暫停繼續修改,保留目前差異,再確認錯誤改動是否已提交、推送或合併。直接對 AI 說「全部還原」,容易連原本想保留的工作也一起丟掉。
restore 用來恢復指定檔案的內容,但來源要說清楚 ,未指定來源時,一般工作目錄還原預設取自暫存區,不一定是最後一次提交,使用 --staged 則是調整暫存區,預設來源為 HEAD,並不等於刪除工作檔案,會覆蓋工作目錄的還原操作可能丟失未提交修改,執行前要確認路徑、來源與備份。參考 git restore 官方文件 。
revert 則是用新的提交,抵銷指定舊提交帶來的變更 ,它保留既有歷史,常用在已分享的提交,但可能遇到衝突,也不代表整個專案必然回到某個舊時間點,若要修正遠端主分支,新的復原提交仍需依流程推送、合併與部署。參考 git revert 官方文件 。
檔案突然不見,也不能立刻認定永久刪除,可以先查是否切到別的分支、內容是否被放進 stash,或是否有提交紀錄與編輯器備份,不過,從未提交也沒有其他備份的內容,Git 並不保證能救回。
先不要執行會丟棄修改的操作,請查明問題改動是否已提交、推送與合併,保留目前差異,列出建議復原的檔案、來源版本及會失去的內容,再說明應使用檔案還原、復原提交或其他方法,並列出復原後的驗證項目。
Diff 要看什麼?先問比較的是哪兩個版本
看到大量新增或刪除行數,先確認比較範圍,GitHub PR 採用三點差異比較,從共同祖先到功能分支目前版本,重點是這個分支引入了什麼,直接比較兩個分支的最新狀態,得到的內容可能不同,尤其主分支已經往前更新時,參考 GitHub 的分支差異說明 。
行數只是定位問題的線索,格式調整、自動產生的檔案或重新命名,都可能讓變動看起來很大。
更實際的檢查是:改動是否符合這次需求、是否碰到無關檔案,以及重要功能有沒有測過。
把「完成了嗎」改成一份可查證的交付回報
對非工程背景的人來說,最有用的習慣,是要求 AI 在每次交付時附上可以追查的狀態。下
面這段可以直接加入日常任務:
請用非工程師看得懂的方式回報這次交付,列出本機分支與最新提交、遠端分支是否已包含這次變更、PR 連結與合併狀態.若有多個 AI,列出各自的實際工作目錄。說明差異比較的基準、改了哪些檔案,以及哪些測試或操作情境已通過。若涉及網站上線,另附部署結果與實際驗證網址。沒有完成的步驟請明確標出。
從下一次小修改開始,先保存已確認正常的狀態,再讓 AI 動手。完成後看差異、驗證功能,最後確認遠端與部署狀態。這套習慣建立起來,才能在出錯時知道從哪裡查,而不必每次都靠重做。
GitHub 與 Vibe Coding 常見問題
不會寫程式,也需要學 Git 嗎?
使用 AI 修改專案時,至少應理解提交、分支、遠端與復原的差別,指令可以交給工具執行,但仍要能確認保存了什麼,以及哪些步驟尚未完成。
Commit 成功就代表已上傳 GitHub 嗎?
不代表。commit 建立本機提交,push 才會把提交送到指定遠端分支,是否合併到主分支,以及是否部署成功,都要另外確認。
PR 已合併後,再 push 就會更新主分支嗎?
不會自動更新。推到原功能分支的新提交,不會追加到先前已完成的合併,應依專案流程建立新 PR 或再次整合,確認新變更已進入目標分支。
Restore 和 revert 有什麼不同?
restore 恢復指定位置的檔案內容,必須確認來源與是否覆蓋未提交修改。revert 以新提交抵銷舊提交的變更,保留歷史,但可能需要處理衝突。
Worktree 可以完全避免兩個 AI 互相干擾嗎?
不能保證。不同 worktree 可分開工作檔案,但仍共享部分 Git 資料,外部資料庫、服務與輸出位置也可能共用,應確認目錄、分支與執行環境的分工。
by Rain Chu 9 月 8, 2026 | Agent , AI , Apple , Mac , 程式開發
買 Mac 跑本地 AI,我會先考慮以下三件事:
模型能不能放進記憶體,送出長篇資料後要等多久,以及開始回答後每秒能生成多少 token。這三件事分別牽涉容量、運算能力與記憶體頻寬,不能只看晶片名稱裡的數字。
同一台電腦,短問短答很順,換成讀程式碼、查工具、反覆執行任務的 Agent 卻很慢,並不矛盾。
聊天介面讓你注意到的是持續輸出的速度,Agent 更容易暴露長輸入、多輪推理與工具等待的成本。
模型載入成功,只代表跨過容量門檻,還不代表這台機器適合你的工作流。
本文於 2026 年 9 月 6 日核對規格。Apple 已公布新款 Mac mini 與 Mac Studio,官方標示 9 月 22 日開始供貨。以下會把官方規格、推理原理與選購判斷分開,未取得的新機實測不會用推估值冒充。供貨資訊可查 Mac mini 公告 與 Mac Studio 官網 。
先分清 Prefill 與 Decode,才知道慢在哪裡
Prefill,預填充 ,是模型處理輸入內容、建立後續推理狀態的階段,系統提示詞、聊天記錄、工具定義、檢索文件與程式碼都可能算進輸入,並非只有你剛打的那一句話。長輸入通常有較大的矩陣運算需求。
Decode,解碼生成 ,則是在已有上下文狀態上逐步產生 token,單一請求、低批次的生成常受記憶體資料搬運限制,所以記憶體頻寬很重要,Token 不是固定的一個中文字,不能把 tokens/s 直接當成每秒中文字數。
觀察體感時,我會同時記錄 TTFT,也就是送出後到第一個 token 的時間,以及生成階段的 tokens/s,TTFT 還可能包含排隊、模型載入與服務端處理,不能把所有等待都歸因於 Prefill,Apple 的 MLX 與 M5 技術說明 也分別討論提示詞處理與生成效能,兩個階段應分開比較。
記憶體容量,是門票而不是速度保證
Apple Silicon 的 CPU 與 GPU 共用統一記憶體,跑較大模型時不必完全受限於一張獨立顯示卡的顯存容量,在這規格表上的 32GB 或 128GB 並不等於模型可以獨占同樣的空間,macOS、瀏覽器、開發工具、KV cache 和推理暫存都需要預算。
估算可以從權重開始:參數數量乘上每個參數的位元數,再除以 8,以約 27B 參數、理想化 4-bit 權重計算,純權重約 13.5GB,這只是十進位容量的粗估,還沒加入量化分組資訊、部分高精度權重與執行時開銷。
32GB 能否跑某個 27B 模型,答案是「有機會,但要指定量化檔、上下文長度與框架」。只拿 27B 這個名字,無法保證長上下文與多 Agent 都順暢。先核對實際模型檔大小,再測一個完整任務,會比只看成功載入的畫面更有用。
如果想先理解不同推理工具的定位,可以參考 MLX、llama.cpp、Ollama 與其他本地推理框架比較 ,格式、核心實作與快取策略都會影響同一台硬體的表現。
記憶體頻寬,影響持續輸出但不是萬用答案
可以把容量想成能放多少資料,頻寬則是每秒能把多少資料送到運算單元。當低批次生成需要反覆讀取大量權重,而硬體運算能力足夠時,頻寬往往成為主要限制。
但「頻寬加倍,速度就一定加倍」只適合當理想化的直覺,實際還有量化解碼、注意力、KV cache 存取、核心效率、批次大小與模型架構,MoE 也不是每個 token 都動用全部專家權重,所以不能把所有模型都套進同一條簡單公式。
M5、M6 規格怎麼看,先看配置再看名稱
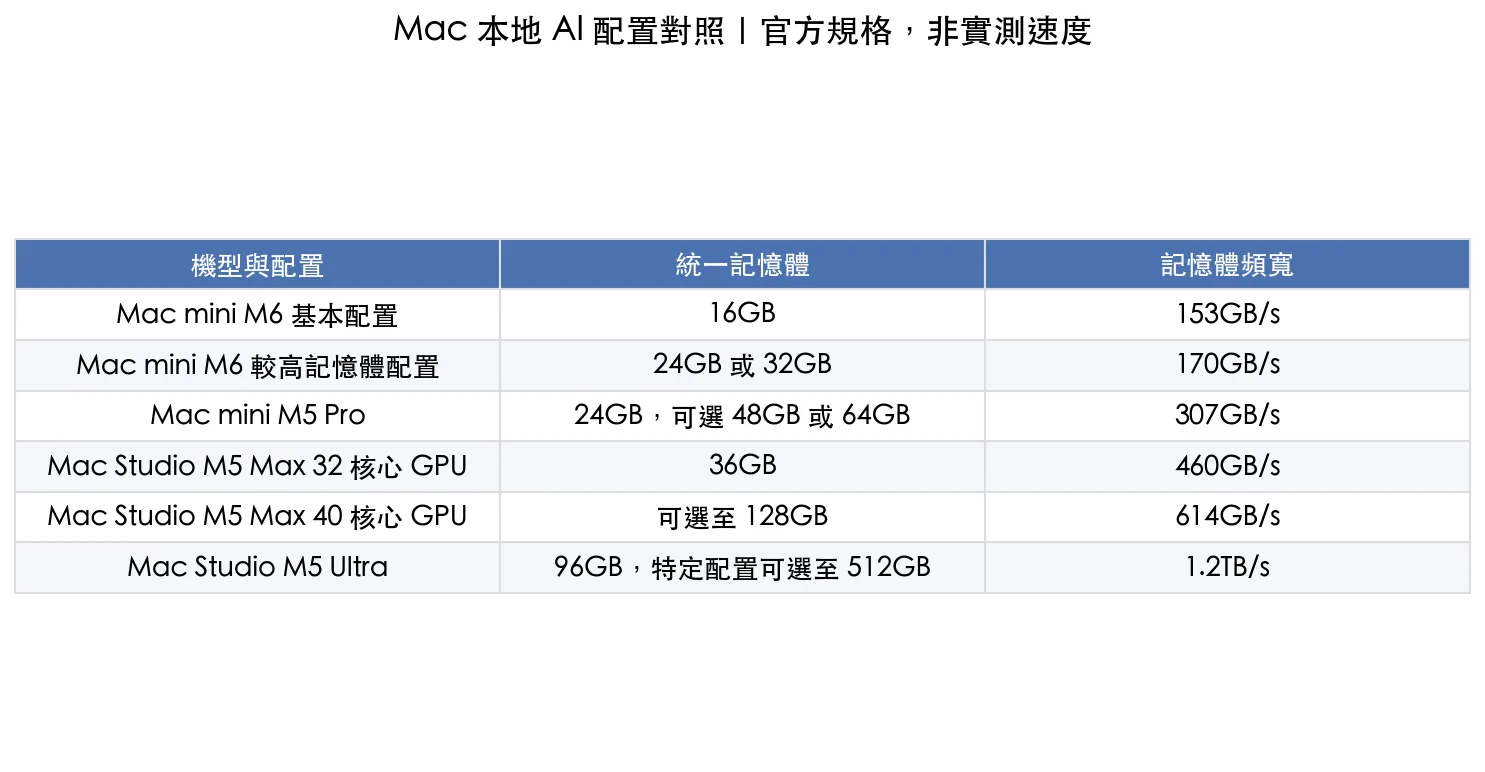
以下整理 Mac mini 技術規格 與 Mac Studio 技術規格 中,和本地模型最直接相關的容量與頻寬。這是規格對照,不是速度排名,也不是實測 tokens/s。
機型與配置 統一記憶體 記憶體頻寬 Mac mini M6 基本配置 16GB 153GB/s Mac mini M6 較高記憶體配置 24GB 或 32GB 170GB/s Mac mini M5 Pro 24GB,可選 48GB 或 64GB 307GB/s Mac Studio M5 Max 32 核心 GPU 36GB 460GB/s Mac Studio M5 Max 40 核心 GPU 可選至 128GB 614GB/s Mac Studio M5 Ultra 96GB,特定配置可選至 512GB 1.2TB/s
2026 年 9 月 6 日核對,容量與頻寬不等同實測生成速度 M5 Max 的 32 核心與 40 核心 GPU 版本不只差核心數,頻寬與可選記憶體也不同,M5 Ultra 的 256GB、512GB 選項綁定更高階晶片配置,升級容量的成本可能同時包含晶片升級。選購時應核對最後的完整配置,不要把某個系列的最高值套到入門款。
供貨時間也要分開看。依 Apple 台灣的新款 Mac Studio 公告 ,一般配置自 9 月 22 日起供貨,512GB 統一記憶體配置則預計 10 月底推出,需要立即交付工作的團隊,應再確認實際可下單配置與交貨日期。
跑 Agent 為什麼更容易卡在等待
一個程式碼 Agent 可能先讀專案規則,再讀檔案,接著呼叫工具,最後把工具輸出帶回模型繼續判斷,每一輪都可能增加輸入,輸出卻只有一小段指令,讓「先讀懂,再動作」的成本更加明顯。
「每開一個子代理,就一定完整重算一次全部上下文」並不精確,是否能重用相同前綴,取決於服務端的 prompt cache、請求路由、模型支援與上下文是否一致,MLX LM 官方專案 就提供 prompt caching 功能,實際 Agent 框架有沒有用到,仍要另外確認。
把長期不變的規則放在穩定前綴,減少每輪重新排列內容
只提供當前任務需要的檔案與工具,避免把整個專案一次塞進提示詞
先測單 Agent,再逐步增加並行數,觀察排隊與記憶體壓力
同時記錄模型等待、工具執行與重試時間,避免把外部服務延遲算到 GPU 頭上
如果任務需要很長的推理輸出,Decode 仍可能占大部分時間,真正值得比較的是完成同一項工作要多久、成功率如何,而不只是某個階段的峰值數字。選擇 Agent 模型與本機部署方式 時,也應把工具呼叫品質一起放進評估。
M5 的加速器,要配合軟體才能發揮
M5 GPU 的 Neural Accelerators 是 GPU 內的矩陣運算加速能力,不應和晶片上另一個 Neural Engine 混為一談,對長輸入這類運算密集的工作,支援相應路徑的框架與核心可以帶來收益。
買到新晶片不代表任何模型、量化格式和舊版工具都會自動得到相同比例的加速,我會連同 macOS、MLX 或 llama.cpp 的版本一起記錄,並查看執行時使用的後端。Apple 早期公布的 M5 測試可以用來理解方向,但不能直接當成新款 M6 或 M5 Ultra 的實測成績。
MoE 為什麼值得看,但不能只看啟用參數
Mixture of Experts,混合專家模型,會依 token 選用部分專家,降低每步需要參與計算的參數量,它讓「保存很多知識容量」和「每一步動用多少運算」有機會分開,這和大容量統一記憶體的特性很搭。
以 Qwen 官方的 Qwen3-30B-A3B 為例,30B 指總參數量,3B 指啟用參數量,不能因為看到 A3B,就用一個 3B 稠密模型的記憶體需求來估算,通常仍要保存更大的整體權重。這是用來解釋命名與架構的例子,不代表它是目前唯一或最適合的選擇。
MoE 的速度還受專家路由、量化、核心最佳化與批次大小影響,也不保證同樣容量下的工具使用品質一定勝過稠密模型,我的做法是準備一組真實任務,用完成品質與總耗時一起決定。
三種使用情境,我會這樣安排預算
主要使用雲端 AI,優先顧好日常工作
如果主要運算都在雲端,Mac 更多是在跑瀏覽器、編輯器與本地工具,無須只為遠端模型購買超大記憶體。16GB 到 32GB 可以作為一般工作起點,但大型專案編譯、虛擬機與剪輯仍可能需要更多。這是用途判斷,不是所有人的最低規格。
本地聊天、寫程式與剪輯混用,先看 48GB 到 128GB 的實際需求
先列出最常用的兩三個模型,再加上平常同時開啟的軟體。M5 Pro 和 M5 Max 各有不同容量與頻寬選項,能否容納模型加上真實工作環境,比只追求最大 GPU 核心數更重要。若以 Agent 為主,要優先找長提示詞與連續工具呼叫測試,而不是只看短聊天跑分。
目標是超大模型,再考慮 Ultra 與多機
當權重、長上下文或多請求確實超出較小容量,才有充分理由看 256GB、512GB 或分散式部署。先問自己是否需要那個模型能力,以及它能否在可接受時間內完成任務,不要為了「裝得下最大模型」而買一台長期等待的電腦。
AI 生圖與生影片,要另做一份評估
剪輯影片和用生成模型產生影片,是不同的運算工作,ProRes 編解碼能力強,不能直接推論擴散模型也會很快。ComfyUI 官方支援 Apple Silicon ,但你的模型、量化與自訂節點是否支援 Mac,以及完整生成一段內容要多久,仍需逐項確認。
若主要目的是高頻率生影片,我會拿實際工作流比較 NVIDIA GPU、本地 Mac 與雲端方案,再把等待時間與每次產出的成本算進去。可從 LTX 2.3 的 ComfyUI 影音工作流 理解需要核對哪些模型與節點,不應只拿文字模型的速度替影音生成下結論。
不過可以肯定的是現在要生圖還是首選 Nvidia 畢竟 pyTouch 還沒有完整支援 MAC
DGX Spark 加 Mac Studio,是分工不是魔法加總
EXO 的異質推理示範 把 Prefill 放在 DGX Spark,再把 KV cache 傳給 Mac Studio 進行 Decode,並透過逐層傳輸,讓通訊與運算時間部分重疊。這說明不同硬體可以各做擅長的階段。
但 EXO 示範的是特定模型、輸入長度、硬體與網路,不能外推成任何組合都會同倍率變快。兩台 256GB 也不必然優於一台 512GB,模型如何分片、互連頻寬、框架支援與並行方式都會改變結果。多機還增加設定與維護成本,應以整個任務的實測決定。
對多機部署有興趣,可以接著看 雙機 EdgeXpert 與大模型工作負載 ,把單機容量、網路傳輸和軟體支援一起考慮。
購買前怎麼測,至少分開短提示詞與長提示詞
請測試者提供完整模型名稱、量化檔、框架版本、系統版本、上下文長度與 GPU 配置,相同模型換一種量化,或把長輸入改成一句問候,都足以改變結果。
已有 llama.cpp 與本地 GGUF 模型時,可參照 llama-bench 官方說明 使用下列命令。把路徑改成自己已下載的模型,這裡的參數是測試設定,不是我在新機上測出的數字。
llama-bench -m /absolute/path/model.gguf -p 512,8192 -n 128 -r 3 -o json這會分別測試不同長度的 prompt processing 與文字生成,輸出中的 pp 與 tg 對應不同階段。合成測試適合比較核心效能,不能直接當成真實 Agent 的 TTFT 或任務總耗時。還要補一輪實際工具呼叫流程,並分別記錄冷啟動、快取命中和未命中的狀態。
同一份短問答,觀察穩定生成速度
同一份長文件,觀察首個 token 等待時間
同一個修改程式任務,觀察工具呼叫與完成率
同樣的並行數,觀察尖峰記憶體、swap 與排隊
若要生圖或生影片,使用完全相同的模型、尺寸、步數與節點
FAQ
32GB Mac 可以跑 27B 模型嗎
部分量化版本有機會,但要加上 KV cache、推理暫存、macOS 與其他程式的需求。能載入不等於長上下文或多 Agent 都能流暢使用。
M6 一定比 M5 Max 適合本地 AI 嗎
不一定。要比較完整配置的容量、頻寬、運算後端與實際工作負載,不能只用世代數字排序。
為什麼聊天很快,Agent 卻很慢
Agent 可能反覆處理長上下文並等待工具,瓶頸不只在生成速度。應同時檢查 Prefill、快取、排隊、工具時間與任務重試。
MoE 的啟用參數少,記憶體也只要那麼少嗎
不是。啟用參數主要描述每步參與計算的部分,通常仍要保存全部專家權重,容量估算不能只看 A 後面的數字。
我的選購順序:先定工作,再定模型,最後選配置
先確定主要工作是在雲端還是本地,再決定模型與上下文需求。容量不足先解決容量,等待第一個字太久就看輸入處理與快取,開始輸出後仍然慢才進一步比較頻寬與生成核心。用這個順序選 M5、M6 或 Ultra,比追規格表上最大的數字更能把錢花在真正的瓶頸上。
by Rain Chu 7 月 11, 2026 | Agent , AI , 程式開發
如果把 Lovable 只看成「用 AI 幫你寫程式」的工具,會低估它真正有趣的地方。它更像是一種產品代理人,把想法、介面、資料庫、登入、部署和迭代放到同一個工作流裡,讓原本要跨過工程門檻的人,可以直接從需求開始往產品推進。
我會把 Lovable 放在跟 Manus AI 與 OpenManus 這類 AI 代理工具 相近的位置來看。差別在於,Manus 更像是可以被交辦任務的通用代理人,Lovable 則更專注在把一個產品想法變成可以看、可以試、可以部署的 web app。
Lovable 真正賣的是產品速度
Lovable 官方文件把自己定義為 full-stack AI development platform,它不是只產生前端畫面,而是用自然語言建立、迭代、部署 web app,並且可以把前端、後端、資料庫、驗證與整合放進同一個工作流裡,對非工程背景的人來說,這件事的意義很直接。你不用先學完整開發流程,才有資格驗證一個產品想法。
這也是為什麼 Lovable 這類工具會和一般 no-code 平台不同,no-code 過去常常卡在模板與元件限制,AI app builder 則把入口改成對話,使用者先描述要做什麼,再透過一次次回饋修出接近產品的樣子,這個方向也和 Vibe Coding 工具正在重新定義開發流程 的趨勢一致,只是 Lovable 把目標族群拉得更寬,從開發者延伸到創辦人、產品經理、設計師、行銷和小團隊。
從最小可行產品,走向最小讓人喜愛的產品
我最喜歡的不是「AI 可以幫你做 app」這句話,而是創辦人談到的產品觀。不要只停在 minimum viable product,也就是最小可行產品,而是往 minimum lovable product MLP 靠近,這個差異很關鍵。
MVP 的精神是用最少成本驗證假設,它很有效,但也很容易被誤用成「只要勉強能用就好」,MLP 則多問了一層問題,這個東西有沒有小到可以快速交付,同時又好到讓第一批使用者真的願意留下來、推薦它、甚至開始依賴它。
AI 工具讓做出 MVP 的成本下降,反而讓「可行」變得不夠稀缺,以前做出能跑的產品就值得驚訝,現在使用者可能一天看過十個 AI 做出來的 demo,真正有差異的,是誰能更快找到讓人喜歡的細節,例如流程順不順、介面是否一眼懂、錯誤狀態是否貼心、資料是否真的能解決工作裡的麻煩。
Lovable 跟 Manus AI 像在哪裡
Lovable 和 Manus AI 都不是單純聊天機器人。它們的共同點是把「理解需求」和「執行任務」接起來。差別只是在任務邊界不同。
面向 Lovable Manus AI 類工具 主要任務 把產品想法變成 web app 把複雜任務拆解並執行 輸出型態 網站、SaaS、內部工具、可部署應用 報告、研究、網頁、資料分析、流程結果 使用入口 用自然語言描述產品需求並迭代 交辦目標,讓代理人規劃步驟 適合場景 創業驗證、產品原型、內部工具 研究、營運、分析、自動化任務 核心價值 縮短從 idea 到可用產品的距離 縮短從任務到成果的距離
從這個角度看,Lovable 不是要取代所有工程師,而是把產品探索的前段變得非常快。當需求還不穩、方向還在找、使用者還沒給出明確反饋時,用完整團隊慢慢打磨可能太重。Lovable 的價值是在這段模糊期中,讓更多人有能力把想法變成可以被使用者碰到的東西。
為什麼 MLP 比 MVP 更適合 AI 時代
AI 時代最大的變化,不只是生產速度變快,而是原型數量暴增。當每個人都能很快做出一個看起來像產品的東西,市場會更快對粗糙作品失去耐心。這時候,產品判斷會從「能不能做出來」移到「能不能讓人想用第二次」。
MLP 的思考可以拆成三個問題。
它是否小到可以快速完成,不會卡在過度設計。
它是否完整到足以處理一個真實情境,不只是展示用 demo。
它是否有一個讓人喜歡的瞬間,讓使用者願意繼續互動。
這三件事剛好也是 AI app builder 的強項。它能快速生成,也能快速修改。創辦人或產品負責人可以把時間從「如何把東西做出來」轉到「這個東西為什麼值得被喜歡」。這一點比單純追求開發效率更重要。
給創辦人的使用方式
如果要用 Lovable 驗證產品,我不會建議一開始就把它當成完整 SaaS 工廠,而是當成產品假設測試器。你可以先把需求寫得非常具體,例如目標使用者是誰、他現在用什麼替代方案、最痛的流程是哪一步、成功狀態長什麼樣子。
接著用 Lovable 做出第一個可互動版本,找少數真正有痛點的人試用。重點不是問他們「你覺得如何」,而是觀察他們是否願意把自己的資料放進去、是否願意第二天再打開、是否願意為了這個工具改變原本流程。這比一句稱讚更有價值。
如果要再往工程落地走,還是需要開發紀律,像 用 Superpowers 建立 AI 開發紀律 這類方法提醒的是,AI 生成速度越快,越需要規格、測試、版本控制和驗收,Lovable 官方也強調可同步 GitHub,這代表它不是只能停在玩具原型,也可以接回工程流程。
這類產品會把 AI 代理帶到更實際的位置
AI 代理最怕的是太抽象。大家都說代理人可以幫你完成任務,但真正有價值的產品,通常會先鎖定一個高頻、具體、有付費意願的任務。Lovable 鎖定的是 app builder。這讓它比泛用代理人更容易被理解,也更容易產生可見成果。
這也能連到最近 Codex 與 ChatGPT Work 走向 AI 代理 的方向。未來的競爭不一定是誰的模型最會聊天,而是誰能把模型、工具、權限、部署、記憶和工作流包成一個讓人放心交付任務的產品。Lovable 在產品開發這個垂直場景裡,已經把這條路講得很清楚。
我的結論
Lovable 最值得看的,不是它能不能用一句 prompt 變出網站,而是它把產品開發的問題重新排序了。以前先問能不能做,現在更該問能不能讓人喜歡。以前 MVP 是驗證市場的低成本方法,現在 MLP 會變成 AI 時代更重要的產品標準。
因為能做出來的東西會越來越多,真正稀缺的會是判斷力。知道該做多小,知道哪裡不能省,知道哪個細節會讓使用者留下來。Lovable 這類工具的價值,不是讓每個人都變成工程師,而是讓更多人有機會更早面對真正的產品問題。
延伸資源
FAQ
Lovable 是什麼?
Lovable 是一個 AI app builder,可以用自然語言建立、迭代和部署 web app。它的重點不是只產生程式碼,而是把產品想法推進到可互動、可測試、可部署的狀態。
Lovable 跟 Manus AI 有什麼不同?
兩者都接近 AI 代理產品。Manus AI 偏向通用任務執行,Lovable 則聚焦在 web app 和產品開發,把想法、介面、資料庫、部署與迭代串在一起。
為什麼最小讓人喜愛的產品比 MVP 更重要?
AI 讓做出可行原型的成本下降,市場上會出現更多相似 demo。這時候只是能用不夠,產品還要有讓使用者願意留下來的體驗和價值。
近期留言