Graphify 是什麼?把專案變成 AI 可查詢知識圖譜
Graphify 最有價值的地方,是把「讀專案」這件事從一次性的上下文塞爆,改成可以重複查詢的知識圖譜, Codex、Claude Code、OpenCode、Cursor、Gemini CLI 這類 AI coding assistant 來說,最大的浪費常常不是寫程式,而是每次都重新理解同一個 codebase。
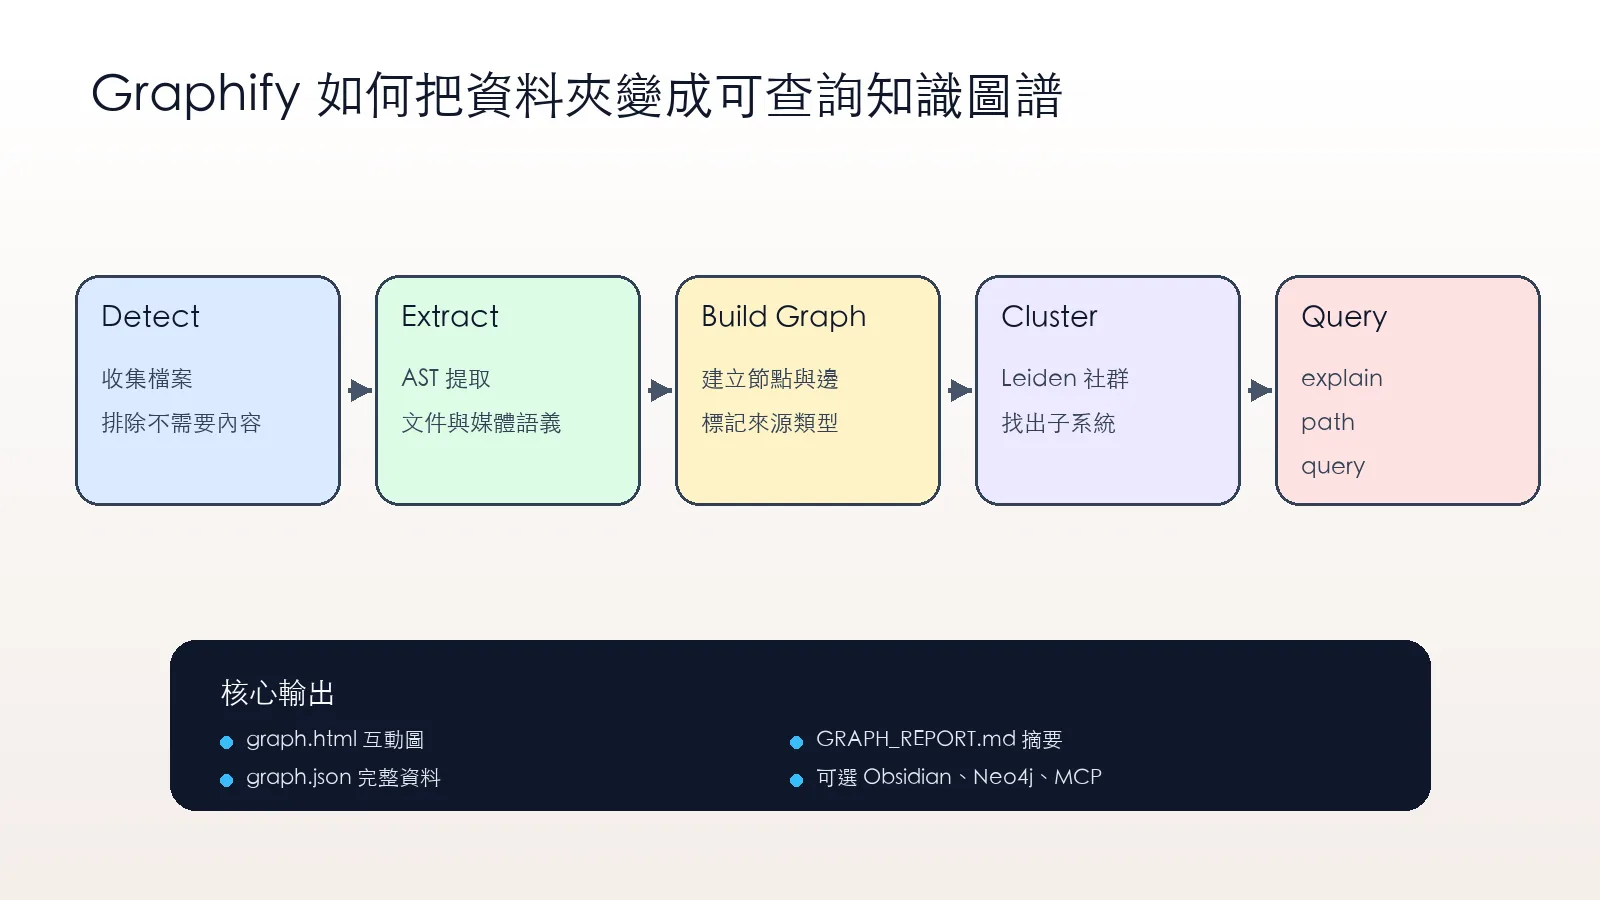
如果 OpenWiki 解決的是 Agent wiki 和文件記憶,Graphify 更像是把整個資料夾編譯成一張可追蹤的圖,它可以處理程式碼、SQL schema、R script、shell script、文件、論文、圖片,甚至影片和音訊,最後輸出 `graph.html`、`GRAPH_REPORT.md` 和 `graph.json`。
先講結論
Graphify 不是向量資料庫,也不是單純 RAG。官方說得很直接,它不用 embeddings,也不放 vector store,而是建立一張可以 traverse 的真實 graph,你可以問一個概念是什麼,也可以追兩個概念之間的 shortest path,或要求它回答某個問題時只返回相關 subgraph。
這對 coding agent 很重要,因為大型專案裡的關係不是只有語意相似,還有 import、call、inherit、mix in、schema、設定檔、文件註解和設計決策,Graphify 把這些關係轉成節點和邊,讓 Agent 不必每次都用 grep 或全文讀取重新猜。
Graphify 是什麼
Graphify 是一個 AI coding assistant skill,安裝後可以在支援的平台裡輸入 `/graphify .`,Codex 則使用 `$graphify`。它會掃描當前資料夾,把程式碼、文件、PDF、圖片和影片整理成知識圖譜。
官方快速開始很短,重點是 PyPI 套件名稱叫 `graphifyy`,不是 `graphify`。這點要記住,因為 README 特別提醒其他 `graphify*` 套件不是官方套件。
uv tool install graphifyy      # install the CLI (or: pipx install graphifyy)
graphify install               # register the skill with your AI assistant
之後在 AI assistant 裡執行。
/graphify .
為什麼它不是一般 RAG
一般 RAG 常見做法是切 chunk、做 embedding、進 vector store,再用語意相似度找片段。這對文件問答很好用,但對程式碼架構不一定夠。因為程式碼最重要的線索常常是顯式關係,例如某個 class 被誰繼承,某個 function 被哪裡呼叫,某個 schema 影響哪個 API。
Graphify 對 code maps 採 local-first。程式碼透過 tree-sitter AST 解析, deterministic,不需要 LLM,也不會把程式碼送出本機。文件、PDF、圖片和影片這類語義 pass 才會使用 assistant model 或你設定的 API key。
EXTRACTED 和 INFERRED 是關鍵
Graphify 很值得學的一點,是它會標記每條邊的來源。`EXTRACTED` 代表關係明確存在於來源裡,`INFERRED` 代表由 Graphify 推導出來。這比單純把答案講得很肯定更重要,因為 Agent 常犯的錯不是沒有答案,而是不知道哪些是看到的,哪些是猜的。
aivi 的整理還提到第三類 `AMBIGUOUS`,代表不確定的關係要留給人工審查。這種設計很適合放進團隊工作流,因為架構理解不該只追求自動化,也要保留可審計性。
輸出檔案怎麼看
一次執行後,最核心的是三個檔案。
| 檔案 | 用途 | 我會怎麼用 |
|---|---|---|
| graph.html | 互動式圖譜 | 快速看社群、節點和跨模組關係 |
| GRAPH_REPORT.md | 摘要報告 | 讓 Agent 先讀專案重點和建議問題 |
| graph.json | 完整圖資料 | 後續 query、path、explain 不必重讀所有檔案 |
最適合哪些場景
我會優先用在三種情境。
第一,接手陌生 codebase,需要先知道核心節點和模組邊界。
第二,專案同時有 app code、database schema、infra script 和文件,單純全文搜尋很難看出關係。第
三,研究資料夾裡有論文、截圖、筆記和實驗程式,需要把概念關係串起來。
這和我前面整理的 OpenWiki 可以搭配。OpenWiki 偏向替 Agent 建立 wiki 記憶,Graphify 偏向把來源資料拆成可查詢 graph。兩者放在一起,就是文件記憶加關係推理。
Benchmark 怎麼解讀
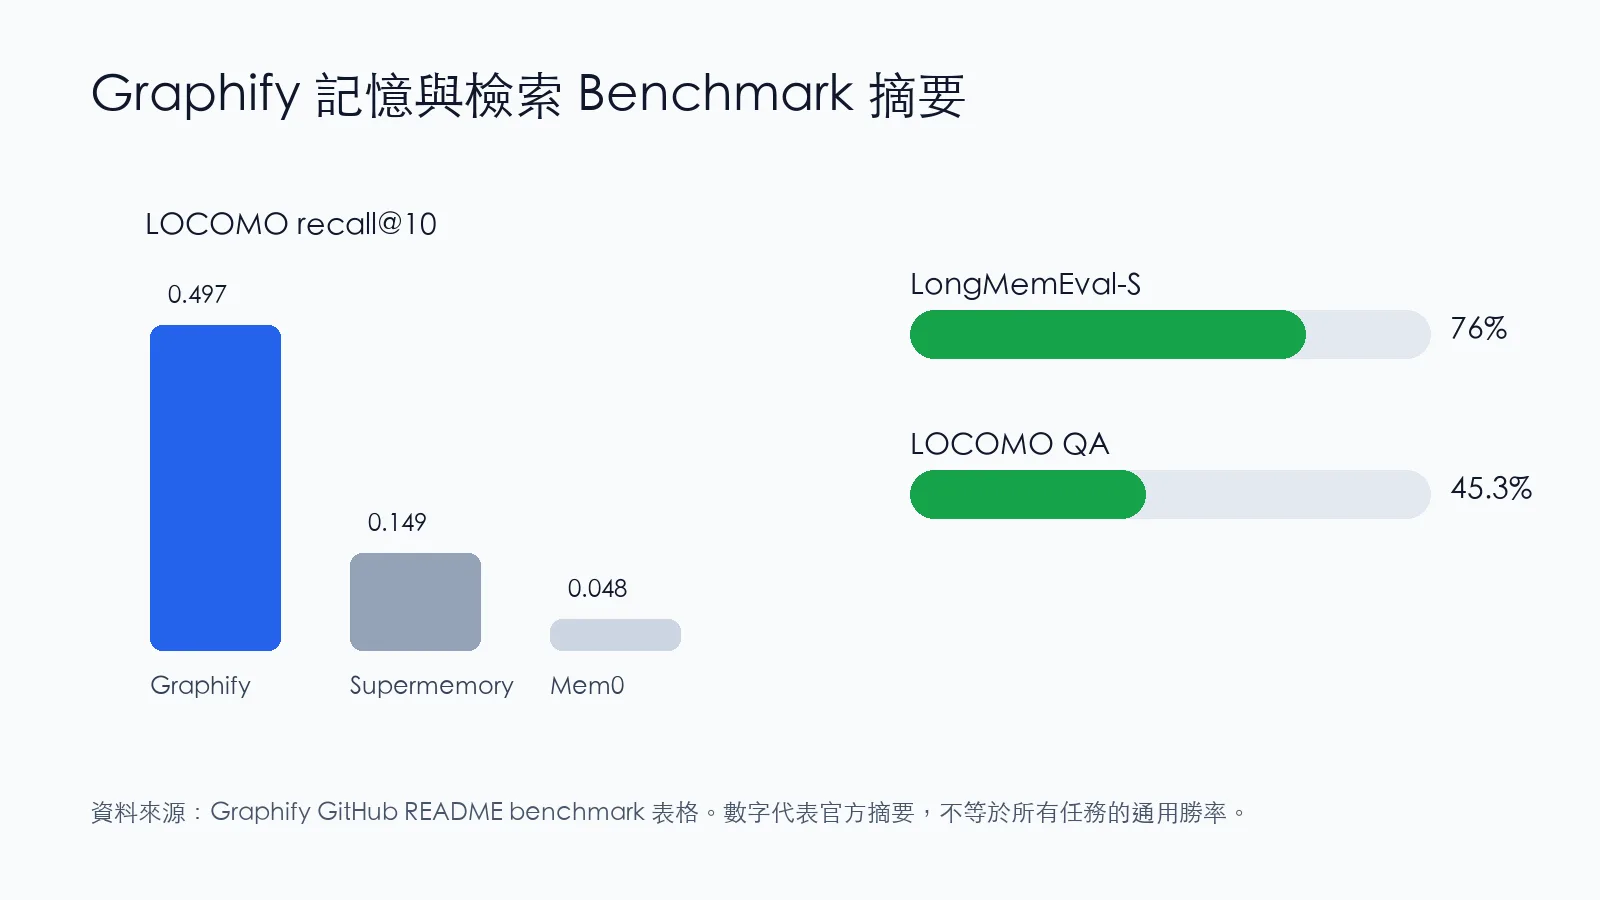
官方 README 摘要裡列了幾個 benchmark。LOCOMO recall@10 是 0.497,對照 mem0 的 0.048 和 supermemory 的 0.149,差距很大。LOCOMO QA accuracy 是 45.3%,低於 supermemory 的 49.7%,但高於 mem0 的 27.3%。LongMemEval-S QA accuracy 則是 76%,官方標註和 dense RAG tied。
Codex 使用要注意什麼
Graphify 支援 20 個以上 assistant 平台。對 Codex 使用者來說,官方特別提到 Codex 用 `$graphify`,不是 `/graphify`。另外如果要做 parallel extraction,需要在 `~/.codex/config.toml` 的 `[features]` 下設定 `multi_agent = true`。
這點和 Codex 作為 AI 代理 的方向很搭。Codex 如果只靠當下上下文,很容易在大型 repo 裡反覆找檔案。Graphify 可以先把核心結構整理好,讓後續任務更像查地圖,而不是每次重新探路。
可以匯出到 Obsidian、Neo4j 和 MCP
aivi 的整理提到 Graphify 有很多可選輸出,包括 Obsidian、SVG、GraphML、Neo4j Cypher、直接推送 Neo4j、MCP server 和 wiki 風格 Markdown。這代表它不是只服務某一個 assistant,而是可以把 graph 變成團隊知識資產。
如果你已經有 GraphRAG 使用本地 Ollama 的經驗,可以把 Graphify 看成更偏工程專案的知識圖譜入口。它不是取代 GraphRAG,而是把 repo、文件與工程關係先整理成一個可操作的圖。
我會怎麼導入
第一步只跑 code。因為 code map 是 local-first,不需要 LLM token,風險最低。
第二步打開 `graph.html` 看社群是否合理,再讀 `GRAPH_REPORT.md`,確認 god nodes 和 surprising connections 是否真的有幫助。
第三步才把 docs、PDF、圖片或影片加進來,並明確估算語義 pass 會用到哪個模型和多少成本。
如果是私有專案,我會先禁用媒體語義分析,只讓 tree-sitter 解析程式碼。等到確定 graph 有價值,再逐步開文件和圖片。這樣比較符合安全直覺,也不會一開始就把整個公司資料夾丟進模型。
我的判斷
Graphify 的核心價值不是炫酷的圖,而是讓 Agent 對大型專案有可追溯的結構記憶。它把「讀懂專案」變成一個可重複、可更新、可查詢的輸出,而不是每次都靠模型臨場發揮。
我會把它放進 AI coding 工作流的前置步驟。陌生 repo 先 Graphify,需求進來前先看 graph report,修改前查 path,修改後用 hook 或 watch 更新圖譜。這樣 Agent 比較不會只看局部檔案就亂改。
延伸資源
FAQ
Graphify 和 RAG 有什麼不同?
RAG 常用向量相似度找片段,Graphify 建立可 traversal 的知識圖譜。它更重視 import、call、inherit、文件引用和設計決策這類關係。
Graphify 會把程式碼送到雲端嗎?
程式碼 map 是 local-first,透過 tree-sitter AST 解析,不需要 LLM。文件、PDF、圖片和影片的語義分析才會使用 assistant model 或你設定的 backend。
Codex 可以用 Graphify 嗎?
可以。官方支援 Codex,並提醒 Codex 使用 `$graphify`。若要 parallel extraction,需要在 Codex config 啟用 `multi_agent = true`。
Graphify 適合私有專案嗎?
適合先從程式碼圖譜開始,因為 code parsing 可以本地完成。若要分析文件、圖片或影片,建議先確認使用的模型和資料外送邊界。
近期留言