by Rain Chu | 4 月 24, 2026 | Agent, AI
在過去,AI 只是工具
現在,AI 正在變成你的「員工」
而未來,你的團隊中——
真正工作的,可能不再是人類
🧠 什麼是 Multica?
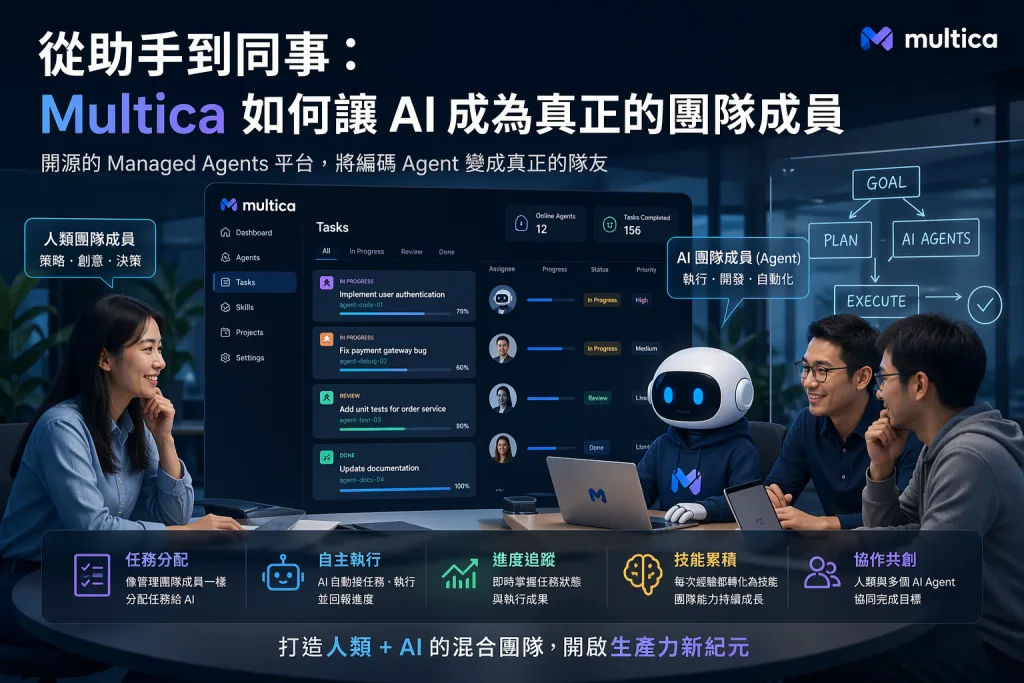
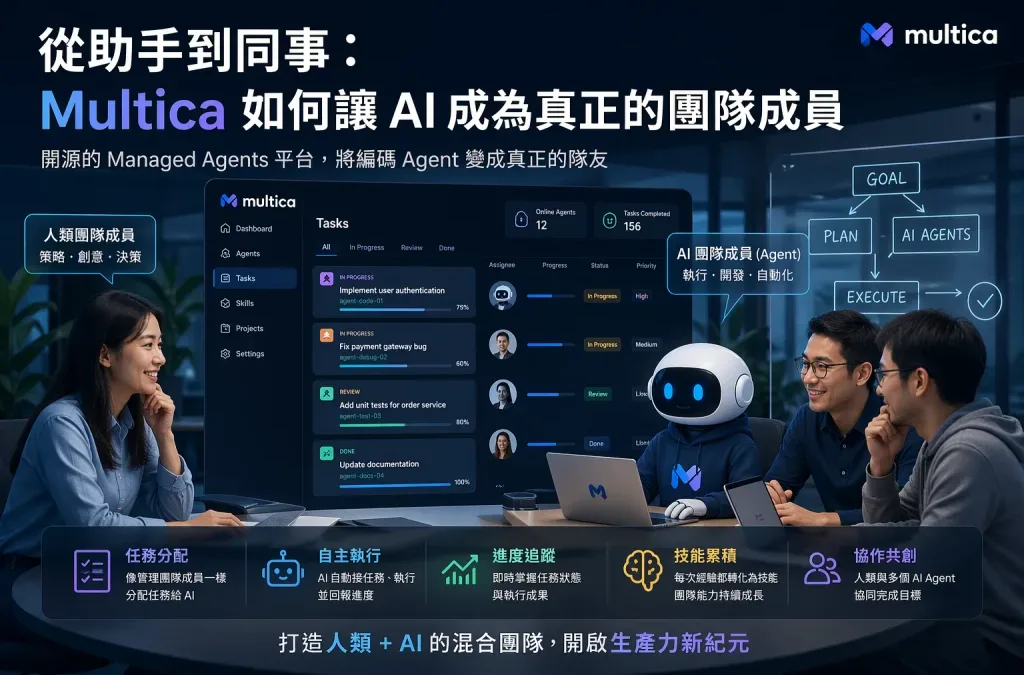
Multica 是一個開源的 Managed Agents(智能體管理)平台,核心概念非常直接:
把 AI 編碼 Agent,變成真正的「隊友」
不像傳統 AI 工具需要你手動下 prompt、盯著結果,
Multica 讓 AI:
- 自己接任務
- 自己執行工作
- 自己回報進度
- 自己累積能力
👉 就像你真的聘請了一個工程師。
根據官方說明,它的目標是打造「人類 + AI 的混合團隊」基礎設施。
💥 核心理念:AI 不再是工具,而是「員工」
傳統 AI:
Multica 的 AI:
👉 這是從「工具」到「組織角色」的巨大轉變。
⚙️ Multica 的核心功能
1️⃣ Agent 即隊友
你可以像在 Jira 或 Linear 一樣:
- 指派任務給 AI
- AI 會自動認領
- 在看板上更新進度
- 主動回報問題
👉 AI 成為專案管理的一等公民
2️⃣ 全自動任務執行
AI 會:
- 排隊 → 接任務 → 執行 → 完成 / 失敗
- 全程自動運作
- 即時回報進度(WebSocket)
👉 不需要再「盯著 AI 跑」
3️⃣ 技能累積(最關鍵)
每一次任務:
➡️ 都會變成「可重用技能」
例如:
- 部署流程
- DB migration
- Code review
👉 團隊能力會「越用越強」
4️⃣ 多 Agent 協作
你可以同時:
- 跑 10 個 AI 任務
- 多個 Agent 協同工作
- 平行處理專案
👉 等於一個 AI 工程團隊
5️⃣ 統一運行與算力管理
- 本地 + 雲端 runtime
- 自動偵測 CLI 工具
- 統一控制台管理
👉 不用自己拼基礎設施
🧩 為什麼這件事重要?
現在 AI 最大的問題是:
- 每個人用自己的 Agent
- 知識無法共享
- 工作流程碎片化
Multica 解決的是:
👉 AI 協作的「組織問題」
它讓:
👉 這就是「AI 組織化」的開始
🏢 這其實是「AI HR 系統」
如果用一句話形容:
Multica = AI 員工管理系統
它提供:
- 任務分配(像 HR)
- 進度追蹤(像 PM)
- 能力累積(像培訓系統)
👉 AI 不只是會做事,還會「成長」
🔮 未來趨勢:公司將變成「人類 + AI 混合組織」
你可以想像未來公司長這樣:
| 類型 | 角色 |
|---|
| 人類 | 決策 / 創意 / 策略 |
| AI Agent | 開發 / 測試 / 自動化 / 文書 |
甚至:
- 一個人帶 10 個 AI 工程師
- 一個團隊管理 100 個 Agent
👉 生產力直接提升 10 倍(甚至更多)
⚔️ Multica vs 傳統 AI 工具
| 比較 | 傳統 AI | Multica |
|---|
| 使用方式 | Prompt | 任務分配 |
| 工作模式 | 單次互動 | 長時間運行 |
| 協作 | 無 | 多 Agent |
| 記憶 | 無 | 技能累積 |
| 管理 | 人盯 | 自動化 |
👉 本質差異:
工具 → 組織系統
🧠 結論:你該開始思考的事
這不是未來,而是現在正在發生的事。
by Rain Chu | 4 月 14, 2026 | AI, google, 模型
在 AI 模型快速演進的時代,由 Google 推出的 Gemma 系列模型 一直備受關注,但對許多進階開發者來說,官方版本的限制(安全策略、回應過濾)往往成為發揮模型潛力的瓶頸,有了越獄版本,模型就再也不會回答你說「這個問題我不能回答了」。
這篇文章將帶你深入了解——
👉 越獄版本 Gemma 4(Gemma-4-31B-JANG_4M-CRACK)是什麼?
👉 它如何突破限制?是否值得使用?
👉 在本地 AI 架構(如 Ollama)中的實戰價值
🧠 什麼是 Gemma 4 越獄版?
所謂「越獄版」或「Crack 版」,指的是:
👉 移除或弱化模型原本的安全限制(alignment / guardrails)
這個版本來自 Hugging Face 上的開源模型:
👉 Hugging Face 社群釋出的
Gemma-4-31B-JANG_4M-CRACK
並可透過:
👉 Ollama 直接部署本地推論
⚙️ 越獄版 vs 官方版差異
| 項目 | 官方 Gemma 4 | 越獄版 Gemma 4 |
|---|
| 安全限制 | 高(嚴格過濾) | 低(大幅放寬) |
| 回答自由度 | 中 | 非常高 |
| 敏感內容處理 | 拒答或模糊 | 直接回答 |
| 適合用途 | 商業應用 | 研究 / 測試 / 私有 AI |
| 風險 | 低 | 高 |
💣 為什麼有人需要「越獄模型」?
對你這種在做 AI Agent / 本地 LLM 架構的人來說,關鍵原因只有一個:
👉「控制權」
1️⃣ 做 AI Agent(LangChain / AutoGen)
👉 尤其是:
🧪 越獄版的核心改動(技術面)
這類模型通常做了以下處理:
🔹 1. 去除 RLHF 對齊限制
🔹 2. 訓練資料調整(JANG_4M)
- 加入大量 unrestricted instruction data
- 強化「服從 prompt」能力
🔹 3. Prompt Injection 抗性降低
👉 反而變成「完全服從」
🚀 在 Ollama 中部署
你可以直接用:
ollama run SiliconBasedWorld/Gemma-4-31B-JANG_4M-CRACK
⚠️ 建議設定(for 128G)
export OLLAMA_NUM_PARALLEL=4
export OLLAMA_MAX_LOADED_MODELS=3
export OLLAMA_KEEP_ALIVE=-1
export OLLAMA_FLASH_ATTENTION=1
Hermes Agent 完整實測:自我進化 AI Agent 架構,全面取代 OpenClaw! – 雨
by Rain Chu | 4 月 10, 2026 | AI, google
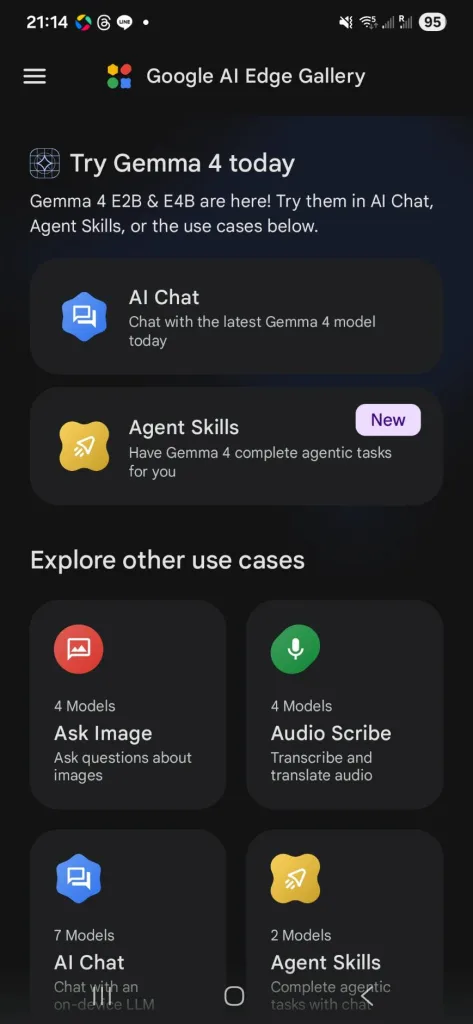
近年 AI 發展幾乎都依賴雲端,但現在 Google 正在顛覆這一切,透過最新的 Google AI Edge Gallery App,你已經可以在手機上「離線」直接運行 Gemma 4 大模型,不只文字對話,還能做到圖片理解、語音應用,甚至 AI Agent。
👉 換句話說:
你的手機,正在變成一台隨身 AI 伺服器。
📱 什麼是 Google AI Edge Gallery?
Google AI Edge Gallery 是 Google 推出的開源應用,讓使用者可以:
- 在手機上下載 AI 模型
- 完全「離線」執行
- 不需要連網、不上傳資料
👉 也就是「On-device AI(裝置端 AI)」
📌 重點特色:
- 🔒 完全隱私(資料不離開手機)
- 📡 完全離線(無網路也能用)
- ⚡ 低延遲(不用等雲端回應)
這款 App 主打「直接在硬體上運行生成式 AI」,讓手機具備高效 AI 推理能力
🧠 Gemma 4 是什麼?為什麼這麼強?
Gemma 4 是 Google 最新開源大模型,基於 Gemini 技術打造。
👉 核心重點:
- 支援多種尺寸(可跑在手機)
- 強化推理能力與邏輯能力
- 可本地執行(Edge AI)
目前部分版本(如 E2B / E4B)已經可以在手機透過 AI Edge Gallery 直接跑
👉 簡單講:
| 類型 | 傳統 AI | Gemma 4 |
|---|
| 運算位置 | 雲端 | 本地(手機) |
| 隱私 | 低 | 高 |
| 延遲 | 高 | 低 |
| 成本 | 訂閱制 | 免費 |
🖼️ 不只是聊天:圖片+語音也能搞定
這次最關鍵的不是「能聊天」,而是👇
🔍 多模態能力(Multimodal)
Gemma 4 + Edge AI 已經可以支援:
- 📷 圖片理解(Image Recognition)
- 🎤 語音相關應用(Speech)
- 🧾 OCR / 文件理解
- 🤖 Agent 自動任務
👉 代表未來:
手機 AI 可以直接「看圖、聽聲音、做決策」
⚙️ 實際運作方式
👉 關鍵技術:
- 模型量化(Quantization)
- 邊緣推論(Edge Inference)
- NPU 加速
這也是為什麼現在手機能跑 AI 的核心原因。
🧪 實測重點
✔ 優點
- 不用網路也能用 AI
- 資料完全私密
- 速度比雲端更即時
- 免費使用
❌ 缺點
- 模型體積大(2GB~5GB)
- 手機會發熱
- 功能還在成長中
🤖 AI Agent 能力(未來最可怕的地方)
AI Edge Gallery 還支援「Agent Skills」:
- 可接工具(如地圖、知識庫)
- 可自動完成任務
- 可擴展插件
👉 官方甚至強調:
AI 可以從單純聊天變成「主動助理」
🌍 這代表什麼?(重點分析)
這不只是 App,而是產業轉折點👇
1️⃣ AI 從「雲端」走向「個人設備」
- ChatGPT → 雲端 AI
- Gemma 4 → 個人 AI
2️⃣ AI 成為手機標配(像相機一樣)
未來:
- 每支手機都有 AI
- AI 常駐本地運行
- 即時處理所有需求
3️⃣ 新創機會爆炸(你可以做)
結合你現在在做的 AI Agent / LangChain:
👉 你可以做:
- 本地 AI 房仲助理
- 離線 AI CRM
- 私有 AI 商業分析工具
- Edge AI SaaS(超有機會)
🧭 實際使用流程(超簡單)
- 安裝 App(Play Store / iOS)
- 下載模型(Gemma 4)
- 開始使用(Chat / Image / Voice)
👉 約 5 分鐘內完成
🏁 結論:AI 正在「回到你手上」
Google 這一步很關鍵:
👉 AI 不再只是雲端服務
👉 而是變成「你手機的一部分」
未來 3 年:
每個人都會有一個「離線 AI 助理」
而你現在就可以先卡位。
官方網頁
https://play.google.com/store/apps/details?id=com.google.ai.edge.gallery&pli=1
https://github.com/google-ai-edge/gallery?tab=readme-ov-file
by rainchu | 12 月 18, 2025 | AI, 圖型處理, 影片製作
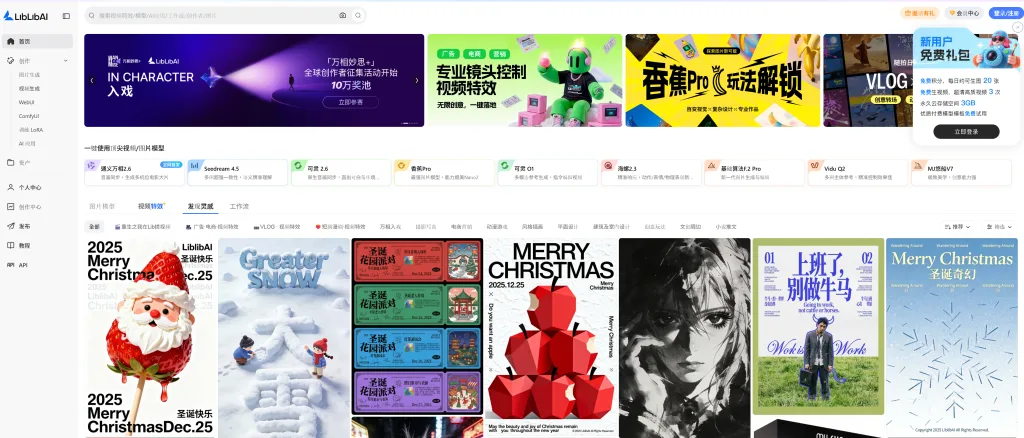
眾多 AI 創作平台之中,Liblib 憑藉其高度整合的功能、生態完整度以及對中文使用者的極致友善設計,迅速成為中國最領先的 AI 創作平台之一。
一站式 AI 影像與視頻創作平台
Liblib 不僅僅是一個圖片生成網站,而是一個超級齊全的 AI 創作平台,涵蓋:
- AI 圖片生成
- AI 視頻特效與動畫
- 模型管理與分享
- 視覺化工作流(Workflow)
- LoRA 訓練與應用
透過雲端化的設計,使用者無需自行架設環境,即可直接在瀏覽器中使用高階 AI 生成能力。
深度整合 WebUI 與 ComfyUI
對於熟悉 Stable Diffusion 生態的使用者而言,Liblib 最大的優勢之一,在於它同時支援:
- WebUI:操作直覺、上手快速,適合大多數創作者
- ComfyUI:節點式工作流,適合進階用戶進行複雜控制與自動化生成
這種雙軌並行的設計,讓初學者與專業用戶都能在同一平台中找到最適合自己的創作方式。
強大的 LoRA 訓練能力
Liblib 在 LoRA 訓練方面表現尤為突出,提供完整且視覺化的訓練流程:
- 上傳資料集即可開始訓練
- 支援多種風格與角色 LoRA
- 訓練完成後可直接套用於生成
- 社群分享與模型市集機制
這讓創作者能快速打造專屬風格模型,大幅降低 AI 模型訓練的門檻。
中文使用者極度友善
相較於許多國外 AI 平台對中文支援不足,Liblib 在以下方面明顯優於同類產品:
- 完整繁體與簡體中文介面
- 中文 Prompt 理解度高
- 中文模型與 LoRA 資源豐富
- 適合華語創作者的社群內容
對中文內容創作者來說,這是一個真正「為中文而生」的 AI 創作平台。
工作流與創作效率全面升級
Liblib 內建的 工作流系統(Workflow),讓使用者可以:
- 將複雜生成流程模組化
- 重複使用高品質生成邏輯
- 快速套用他人分享的創作流程
- 大幅提升商業與批量創作效率
這對於需要大量產出視覺內容的團隊與個人創作者而言,是極具價值的功能。
為什麼 Liblib 是中國最領先的 AI 創作平台?
綜合來看,Liblib 的核心優勢包括:
- ✅ 視頻特效 + 圖片模型完整整合
- ✅ WebUI 與 ComfyUI 同時支援
- ✅ 強大且易用的 LoRA 訓練
- ✅ 中文高度友善,資源豐富
- ✅ 從新手到專業用戶皆適用
這不僅是一個工具,更是一個完整的 AI 創作生態系。
官方網站
👉 Liblib 官方平台
https://www.liblib.art/
by Rain Chu | 4 月 26, 2025 | 3D, AI
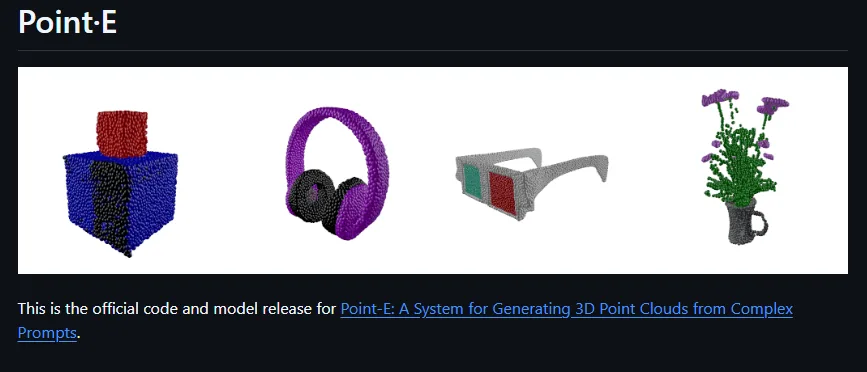
OpenAI 推出了兩款開源的 3D 建模工具:Point-E 和 Shap-E,分別專注於從文字或圖片生成 3D 模型,接下來介紹這兩個模型的核心特性、技術架構、使用方法,並比較它們的優缺點,協助您選擇最適合的工具。
🔍 Point-E:快速生成 3D 點雲的 AI 工具
📌 核心特點
- 輸入類型:支援文字描述或 2D 圖片。
- 輸出格式:生成彩色點雲(point cloud),可轉換為網格(mesh)。
- 處理速度:在單張 GPU 上約需 1–2 分鐘。
- 技術架構:採用兩階段擴散模型,先生成合成視圖,再生成點雲。
- 應用場景:快速原型設計、教育用途、遊戲開發等。
🧪 使用方法
- 安裝:
生成點雲:
🧠 Shap-E:生成高品質 3D 隱式模型的 AI 工具
📌 核心特點
- 輸入類型:支援文字描述或 2D 圖片。
- 輸出格式:生成隱式函數,可渲染為帶紋理的網格或神經輻射場(NeRF)。
- 處理速度:在單張 GPU 上可於數秒內生成。
- 技術架構:先訓練編碼器將 3D 資產映射為隱式函數參數,再訓練條件擴散模型生成 3D 模型。
- 應用場景:高品質 3D 資產創建、AR/VR 應用、3D 列印等。
🧪 使用方法
- 安裝:
生成 3D 模型:
- 使用
sample_text_to_3d.ipynb 或 sample_image_to_3d.ipynb 範例筆記本。
- 可將生成的模型導出為常見的 3D 格式,供進一步編輯或列印。
⚖️ Point-E 與 Shap-E 的比較
| 特性 | Point-E | Shap-E |
|---|
| 輸入類型 | 文字、圖片 | 文字、圖片 |
| 輸出格式 | 彩色點雲,可轉為網格 | 隱式函數,可渲染為網格或 NeRF |
| 處理速度 | 約 1–2 分鐘 | 數秒內 |
| 模型架構 | 兩階段擴散模型 | 編碼器 + 條件擴散模型 |
| 輸出品質 | 中等,適合快速原型設計 | 高品質,適合精細 3D 資產創建 |
| 應用場景 | 快速原型、教育、遊戲開發 | 高品質 3D 資產、AR/VR、3D 列印等 |
🧩 適用場景建議
- Point-E:適合需要快速生成 3D 模型的場景,如教育、初步設計、遊戲開發等。
- Shap-E:適合對 3D 模型品質要求較高的場景,如 AR/VR 應用、3D 列印、動畫製作等。
🔗 資源連結
參考資訊
近期留言