Stable Diffusion 的基本做法,是從隨機雜訊開始,在文字條件引導下反覆更新潛在表示,最後解碼成圖片。
輸入「一隻卡通柴犬」,模型便逐步生成符合描述的輪廓、色彩與細節。雜訊裡並沒有藏著一張等待被找回的柴犬照片。
理解這個流程,可以分別看 UNet 怎麼學習預測雜訊、CLIP 怎麼處理文字,以及 VAE 為何能減少運算負擔。負
向提示詞與 CFG,則是在生成過程中調整方向的工具。
本文以經典 SD 1.x 的架構為主,不同版本會更換文字編碼器、預測目標或去噪網路,不能把同一套零件規格套到所有模型。
例如 Stable Diffusion 3 採用 Transformer 架構與 rectified flow,若還沒接觸過這類工具,可先看站內早期的 Stable Diffusion 繪圖示例,其中舊服務的額度與介面以當前官方資訊為準。
內容目錄
UNet 怎麼學畫圖?先學習估計加進去的雜訊
把一張柴犬照片加入高斯雜訊,就能得到模糊、顆粒很多的版本。訓練程式知道原始資料、抽到的雜訊與時間步,因此有明確的答案可以用來評估模型。
- 先用 VAE 把訓練圖片編碼成潛在表示。
- 抽取時間步與高斯雜訊,按照排程把雜訊加進潛在表示。
- 把帶噪潛在表示、時間步與文字條件送進 UNet。
- 比較 UNet 預測的雜訊與實際加入的雜訊,更新模型參數。
這裡採用經典的雜訊預測訓練目標,DDPM 論文 說明了前向加噪與反向生成的關係,而 CompVis 原始實作 將去噪工作放進潛在空間,並以文字條件引導。把訓練過程說成「看帶噪圖片,猜出雜訊」容易理解,但實際送進經典 SD UNet 的資料並非 RGB 像素。
從雜訊生成柴犬,為什麼需要反覆更新?
文字生圖時沒有原圖可還原,起點是一份隨機潛在雜訊,UNet 先估計目前狀態中的雜訊,再由 scheduler/取樣器依排程計算下一個狀態,重複後才得到可以解碼的結果。
所以,UNet 的單次輸出不應直接理解成「完成降噪的新圖片」。
預測與更新是兩個步驟。Hugging Face 的流程解說 將 UNet、取樣器與最後的 VAE 解碼分開呈現,有助於看懂 ComfyUI 的節點分工。
示範若把中途結果依序解碼,可能看到柴犬輪廓逐漸清楚。這不代表每一輪都必須經過 VAE,也不代表所有模型都固定需要相同的步數。
CLIP 的工作:把提示詞轉成可用的文字特徵
「卡通柴犬」和「動畫風格的小黃狗」不是同一句話,卻可能描述相近的畫面。
文字編碼器把提示詞轉成數值特徵,讓去噪網路能利用描述中的資訊,相近語意可能得到相關表示,但不同寫法不保證生成同一張圖片。
CLIP 原始研究 使用圖文配對做對比式學習,讓匹配的影像與文字表示更相近,並區分不匹配的組合,拿柴犬照片與汽車照片,分別和「a Shiba Inu」比較,就是直觀的教學案例。這種相似度是表示之間的相對關係,不能直接當成辨識正確率。
在經典文字生圖流程中,主要使用 CLIP 的文字編碼器,透過 cross-attention 把條件交給 UNet,CLIP 的影像編碼器並不是每個去噪步驟都要使用的零件。這也不表示所有圖像生成應用都不需要影像編碼器,加入參考圖的其他管線可能另有設計。
VAE 的工作:在較小的表示中生成,再還原成圖片
VAE 包含 encoder 與 decoder。前者把圖片編碼成潛在表示,後者把潛在表示重建成可見圖片。訓練與圖生圖會需要影像編碼,從純雜訊開始的標準文字生圖則主要在最後使用解碼器。
Latent Diffusion 原始論文 的關鍵,是把反覆進行的擴散運算移到較低維度的表示中,兼顧運算成本與視覺細節。這是經過學習的表示,和把照片縮成小張的縮圖不同。
1024 × 1024 的影像,為什麼會出現 1/48 和 1/12?
以寬、高各縮小 8 倍、潛在通道數為 4 的經典 VAE 為例,可做以下尺寸計算。這只說明表示大小,不表示 SD 1.x 原生訓練解析度就是 1024 × 1024。
| 表示方式 | 寬 × 高 × 通道 | 數值個數 |
|---|---|---|
| RGB 影像 | 1024 × 1024 × 3 | 3,145,728 |
| VAE 潛在表示 | 128 × 128 × 4 | 65,536 |
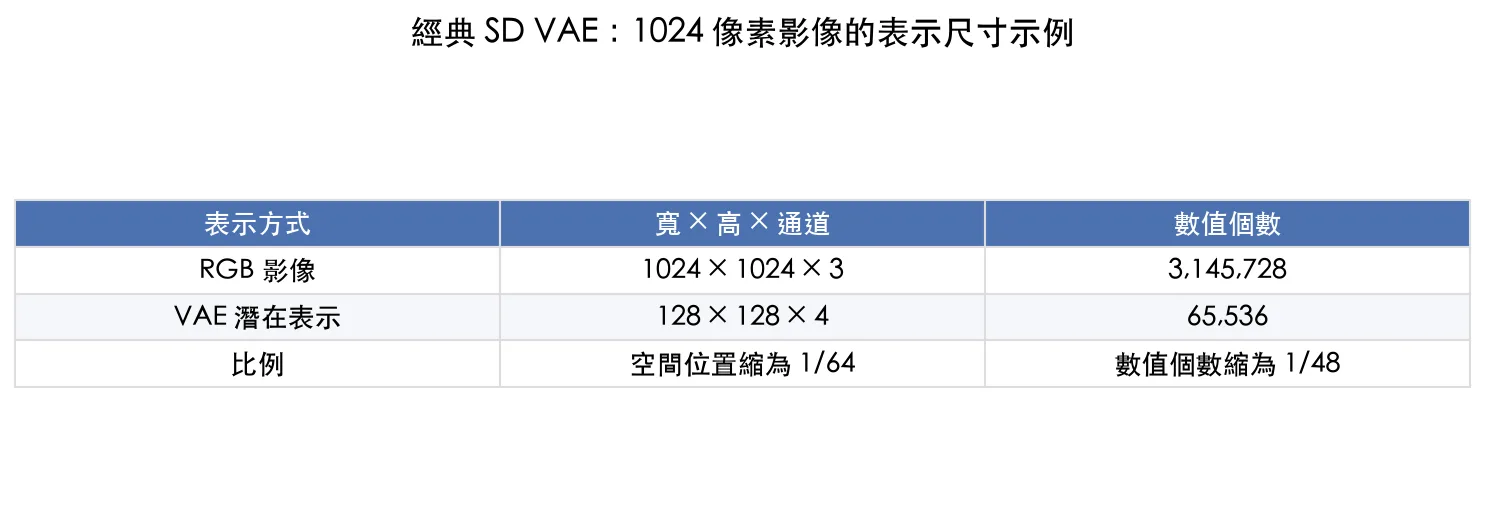
只比數值個數,比例是 1/48。如果原始 RGB 每個數值用 1 byte,而潛在表示使用每個數值 4 bytes 的 FP32,則是 3 MiB 對 256 KiB,資料儲存量才是 1/12,兩個比例用了不同的比較基準,不能混為一談。實際顯存還包括模型權重、中間運算與其他元件,不會直接照這個比例下降。
反覆重建與旋轉潛在表示,能看出什麼?
把同一張圖重複編碼、解碼,可以觀察有損重建造成的細節變化。但單張示例不能證明每次都會以相同程度劣化,也不能把 VAE 訓練簡化成只有一項逐像素比對。VAE 的原始方法 還包含對潛在分布的約束,實際影像自編碼器也可能使用感知與對抗式目標。
負向提示詞怎麼用?以不戴墨鏡的柴犬為例
想要一隻不戴墨鏡的柴犬,可以先把正向提示詞寫成 a Shiba Inu, clear eyes,負向提示詞填 sunglasses。這是方便測試的起點,不是保證成功的固定配方。
把「不戴墨鏡」整句放在正向提示詞裡,可能無法穩定排除墨鏡。較準確的說法是,這類模型對否定與複雜語意關係的遵循有限,不能推論 CLIP 永遠只懂肯定句,Diffusers 的負向提示詞說明 把它定位為讓生成方向遠離不想要的內容或特徵。
CFG 調整的是兩份預測之間的差異
在支援負向條件的常見 CFG 實作中,模型會估計正向條件與負向條件下的雜訊預測,再依下式組合,沒有填負向詞時,通常使用空文字條件作為基準。
引導後預測 = 負向預測 + CFG ×(正向預測 − 負向預測)
這裡相減的是雜訊預測張量,不是把一張「戴墨鏡的狗」從圖片上剪掉,也不是對文字做算術,基礎概念來自 Classifier-Free Guidance 研究,正負條件的組合方式可對照 Diffusers 管線實作。
CFG 提高會加強兩份預測的差異,但數值過高可能出現失真或不自然的色彩。若負向詞寫得太廣,也可能干擾想保留的元素。先用少量具體詞彙測試,比整串貼上負向詞更容易判斷哪個設定有效。
把完整流程接起來,就能看懂主要設定
- 提示詞先經 tokenizer 與文字編碼器,形成文字條件。
- seed 參與決定初始隨機雜訊,作為生成的起點。
- UNet 接收潛在表示、時間步及文字條件,估計雜訊。
- 依需要使用 CFG,取樣器再更新潛在表示,反覆進行到設定步數。
- 最後以 VAE decoder 轉成 RGB 圖片。
想測提示詞效果,先固定模型、seed、尺寸、取樣器與步數,每次只改一個條件,相同 seed 有助於比較,但跨軟體版本、硬體或不同管線,不保證逐像素重現,步數也不是越高越好,應依所用模型與取樣器的設計調整。
下載模型時,還要分清主模型、文字嵌入與附加權重,站內的 Stable Diffusion 模型類型整理 可用來辨認常見檔案類型,實際相容性仍以各模型說明為準。
LoRA 與蒸餾,和去噪有什麼不同?
LoRA 是調整模型參數的方法。LoRA 論文 以低秩更新減少需要訓練的參數。用在擴散模型時,它可能調整去噪網路或其他部分的行為,但 LoRA 本身不等於一次去噪,也不是另一種取樣器。想觀察權重怎麼影響風格,可延伸看 LoRA 權重與分層設定,留意文中外掛與模型版本的適用範圍。
蒸餾則是利用教師模型的訊號訓練學生。在圖像生成裡,目標之一是讓學生以較少步數完成生成,例如 Adversarial Diffusion Distillation。這需要額外訓練,不能靠把一般模型的步數直接調低就獲得同樣效果,也不一定讓參數量變少。站內 模型蒸餾原理整理 說明了更廣泛的教師與學生關係,圖像模型的具體訓練目標仍要另外看。
Stable Diffusion 原理常見問題
Stable Diffusion 是從雜訊中找回原本的圖片嗎?
標準文字生圖從隨機雜訊開始,沒有一張特定原圖等待還原。模型依文字條件與訓練中學到的規律,逐步生成潛在表示,再解碼成圖片。
UNet、CLIP、VAE 分別做什麼?
在經典 SD 架構中,UNet 預測雜訊,CLIP 的文字編碼器提供文字條件,VAE 負責圖片與潛在表示之間的轉換。取樣器另行決定每一步怎麼更新。
負向提示詞可以保證排除指定物件嗎?
不能保證。它會影響生成方向,但效果取決於模型、正負條件、CFG 與其他設定。應使用具體詞彙逐項測試,而非把它當成物件刪除指令。
VAE 會讓圖片變模糊嗎?
VAE 重建有損,細節與色彩可能改變。是否明顯取決於模型與圖片,反覆編碼解碼也可能累積差異。它不是一般圖片縮放或完全無損壓縮。
生成步數越多,圖片一定越好嗎?
不一定。超過適合的範圍,增加步數可能只有額外耗時。蒸餾模型也可能針對少步數設計,應使用該模型建議的取樣方式與設定。
從一個可比較的小實驗開始
用同一個模型生成柴犬,固定其他設定,依序比較正向描述、負向詞與 CFG 的變化。知道每個元件在做什麼之後,調整設定就能帶著問題進行,不必只靠反覆抽圖。
近期留言