Select Page
Open Notebook 是什麼?自架版 NotebookLM 工具解析

Open Notebook 是什麼?自架版 NotebookLM 工具解析

如果你常把 PDF、論文、產業報告或內部文件丟進 AI 工具整理,Google NotebookLM 確實很方便;但只要資料牽涉商業機密、未公開研究、客戶內容或公司內部知識庫,雲端上傳與模型選擇限制就會變成真正的門檻,Open Notebook 的定位,正是把 NotebookLM 類型的文件理解、問答、摘要與 Podcast 生成,搬到更可控、更可自訂的開源工作流裡。

Open Notebook 私有 AI 研究工作流示意封面圖
圖:Open Notebook 私有 AI 研究工作流示意

Open Notebook 解決的是什麼問題?

傳統文件型 AI 助手最容易卡在兩件事:資料放在哪裡,以及模型能不能換。對個人研究來說,把公開文章交給雲端 AI 問答通常沒什麼壓力;但對企業團隊、顧問、研究員或寫作者來說,資料可能包含未公開策略、訪談紀錄、合約、財務數據或客戶文件。這時候,能否自架、能否控制資料歸屬、能否選用自己的模型,就不只是偏好,而是能不能導入的前提。

Open Notebook 的優勢在於,它不是只做一個聊天視窗,而是把「文件匯入、知識庫整理、跨文件問答、來源引用、Podcast 生成、模型配置」串成一套私有 AI 研究工作流。官方 GitHub 專案 lfnovo/open-notebook 目前採 MIT 授權,官方說明也把它定位為一個 privacy-focused alternative to Google NotebookLM,截至 2026-07-07,GitHub API 顯示約 35K stars,最新 release 為 v1.10.0。

核心亮點一:資料主權回到自己手上

Open Notebook 最吸引人的地方,是它把資料控制權從平台端拉回使用者端。你可以把文件、音訊、多媒體檔案、網頁等素材放進自己掌控的環境,再用 AI 做摘要、檢索與問答。對需要處理敏感研究、公司內部文件或客戶資料的人來說,這比「功能多一點」更重要。

這也讓 Open Notebook 很適合搭配文件前處理工具。例如需要先把 PDF、Word、PPT 轉成 AI 更容易讀的文字格式時,可以參考我之前寫過的 MarkItDown 教學,先把原始文件整理成更乾淨的資料,再交給知識庫系統分析。

核心亮點二:模型不再被單一供應商綁住

NotebookLM 的好處是省事,但限制也很明顯:使用者基本上跟著 Google 的模型與產品設計走。Open Notebook 則主打 18+ AI provider,官方 README 提到支援 OpenAI、Anthropic、Ollama、LM Studio 等供應商。這代表同一套知識庫可以依任務切換模型:便宜模型做初步整理,強模型做深入推理,本地模型處理敏感資料。

如果你的工作流已經開始用 Ollama 或本地模型,Open Notebook 的價值會更明顯。它可以成為文件層的操作介面,而模型層則交給你自己的 AI server,想走本地端路線的人,也可以延伸看 GraphRAG 使用本地端的 OllamaOllama 遠端連線教學,把模型部署與文件分析分開思考。

核心亮點三:Podcast 生成更像內容製作工具

Podcast 生成是 NotebookLM 很受歡迎的功能,但固定雙人對談也限制了內容形式。Open Notebook 的方向更偏向內容製作工具:可以做 1 到 4 位 speaker,並調整角色設定與對話形式。這讓它不只適合做「兩人解說」,也能做單人旁白、三人圓桌、多人辯論或不同角色的知識導覽。

對自媒體、研究型內容創作者或企業內訓來說,這點很實用。你可以先把一批文件整理成知識庫,再把其中的核心結論轉成 Podcast 腳本,甚至為不同聽眾設計不同敘事角色。它不是單純把文字念出來,而是把文件理解、腳本結構與音訊內容生產接在一起。

核心亮點四:Ask 模式更適合跨文件研究

Open Notebook 的 Ask 模式適合處理「不是問單一文件,而是要整合一批資料」的任務。例如你有 20 份產業報告,真正想問的不是某一頁寫了什麼,而是不同報告之間是否有共同趨勢、矛盾、缺口與可引用依據。這時候,單純的檢索式問答會不夠,需要能跨文件整理、比對與引用來源的研究流程。

這也是 RAG 類工具接下來會越來越重要的原因:文件不是只被「搜尋」,而是要被組織成可以反覆推理的知識庫。Open Notebook 提供的是比較完整的操作層;而像 GraphRAG、向量資料庫、本地模型與文件轉換工具,則是可以接在底下的技術層。把這些組起來,才會形成真正可重複的 AI 工作流

Open Notebook 和 NotebookLM 怎麼選?

比較面向Open NotebookNotebookLM
資料控制可自架,資料在自己掌控的環境以 Google 雲端服務為主
模型選擇可接多家 provider,也可接 Ollama / LM Studio主要使用 Google 模型
Podcast 形式可做 1-4 位 speaker 與自訂角色以固定形式為主
部署方式Docker、雲端或本地部署直接使用雲端產品
適合對象重視隱私、模型自由、工作流整合的人重視上手速度、不想部署的人

簡單說,如果你要的是「馬上可以用」,NotebookLM 仍然很省事;如果你要的是「資料可控、模型可換、流程可自訂」,Open Notebook 會更有想像空間。它不是每個人都需要的工具,但對研究、顧問、內容團隊與企業知識庫來說,很值得放進評估清單。

導入前要先確認的限制

Open Notebook 的自由度比較高,但也代表它不是完全零門檻。最基本的前提是你要能接受 Docker 或自架環境;如果公司電腦不能裝 Docker,或 IT 政策不允許本機服務,導入就會比較麻煩

Docker 新手可以先看 如何使用 Docker 跟用 command line 一樣,先把容器概念補起來。

算力也要看你的模型選擇。如果只是用雲端 provider,主要成本會落在 API;如果想完全本地跑模型,就要準備足夠的 GPU、記憶體與模型部署能力。換句話說,Open Notebook 降低的是資料與模型綁定,不是把所有基礎設施成本變成零。

誰最適合用 Open Notebook?

  • 研究員:需要整理大量論文、報告、訪談與來源引用。
  • 內容創作者:需要把資料轉成腳本、長文、Podcast 或系列內容。
  • 學生與知識工作者:需要把課堂筆記、PDF、網頁資料統一管理。
  • 企業團隊:需要建立內部知識庫,又不希望敏感文件全部交給外部雲端。

Open Notebook 適合把 AI 研究流程變成私有工作台

Open Notebook 的價值,不只是「開源版 NotebookLM」這麼簡單。它真正有意思的地方,是把資料主權、模型自由、Podcast 生成、跨文件研究與自架部署放在同一個工作台裡。對只想偶爾整理公開資料的人來說,它可能稍微重了一點;但對需要長期累積知識庫、處理敏感文件、或把 AI 研究流程變成團隊基礎設施的人來說,它是一個值得測試的選項。

Open Notebook Github

FAQ

Open Notebook 是 NotebookLM 的替代品嗎?

它可以被視為 NotebookLM 的開源替代方案,但重點不只是功能相似,而是提供自架、模型選擇、資料控制與更多自訂能力。

Open Notebook 一定要很強的電腦才能用嗎?

不一定。如果使用雲端模型,主要需要 Docker 與 API 設定;如果要完全本地跑大型模型,才需要更強的 GPU、記憶體與部署能力。

Open Notebook 適合企業內部知識庫嗎?

適合放進評估清單,尤其是重視資料控制、模型彈性與自架部署的團隊。不過正式導入前,仍要評估權限管理、備份、資安政策與維運成本。

RTX PRO 6000 Blackwell 值得買嗎? 96GB AI 顯卡選購全解析

RTX PRO 6000 Blackwell 值得買嗎? 96GB AI 顯卡選購全解析

RTX PRO 6000 Blackwell 正成為本地 AI 推理工作站的熱門選項。

如果你最近在看本地 AI 部署或企業工作站,很可能也被 RTX PRO 6000 Blackwell 的行情嚇到,這張卡原本是工作站專業卡,卻因為 96GB 大顯存、Blackwell 架構,以及能單卡容納 70B 量化模型的能力,被市場一路推成「算力理財產品」,它的矛盾也很明顯:不是最適合訓練的資料中心卡,卻成了企業做 AI 推理、RAG、知識庫問答與專業渲染時很難忽視的選項。

這篇文章會從規格、推理能力、價格結構與部署限制出發,幫你判斷 RTX PRO 6000 Blackwell 到底強在哪裡、為什麼漲價、適合哪些使用情境,以及工作站版、Max-Q 版、伺服器版和中國特供版應該怎麼選。

RTX PRO 6000 Blackwell 的核心定位

RTX PRO 6000 Blackwell 是 NVIDIA 在 2025 年 GTC 發布的專業工作站顯卡,定位不是遊戲,而是 AI 推理、3D 渲染、科學模擬、8K 內容製作與企業級工作負載,如果你已經在看 NVIDIA DGX Spark 這類本地 AI 硬體,它會是同一條部署思路下更高階的工作站選項。它與 RTX 5090 同屬 GB202 核心,但核心用途完全不同:RTX 5090 是消費級高階卡,RTX PRO 6000 則是拿來「幹活」的專業卡。

規格上,這張卡的重點包括:約 24,064 個 CUDA 核心、96GB GDDR7 顯存、512-bit 位寬、約 1,792GB/s 頻寬、ECC 顯存,以及最高約 4,000 TOPS 的 AI 算力。真正讓 AI 圈關注的,是 96GB 顯存搭配低精度推理時,可以讓 70B 量化大模型不用複雜多卡部署就塞進單卡。

對本地 AI 部署來說,能用單卡容納 70B 量化模型,往往比單純追求峰值算力更實際。

它能不能平替 H200?

如果拿 RTX PRO 6000 與 H200 相比,答案要務實一點:在主流 70B 模型 4-bit 推理場景下,RTX PRO 6000 的性能大約可達 H200 的 75% 到 80%。差距主要來自顯存頻寬與多卡互連能力。H200 是資料中心級方案,單卡價格也高很多;RTX PRO 6000 則更像工作站裡的 AI 推理加速器。

換句話說,如果你要從零訓練千億參數模型,RTX PRO 6000 不是最佳選擇;但如果你的需求是把 70B 模型部署到本地,用於程式碼生成、知識庫問答、RAG 或企業內部推理服務,它的成本結構會比 H200 方案更容易讓人接受。這類需求通常也會搭配 Ollama 遠端連線或內部 API 服務,讓團隊不必每個人都直接碰工作站。

最大的限制:沒有 NVLink

RTX PRO 6000 的一個關鍵限制,是不支援 H200 那種高速 NVLink 互連,如果兩張 PRO 6000 進行多卡推理,資料交換主要依靠 PCIe 5.0 x16,理論頻寬約 128GB/s,實務上還會受軟體堆疊影響;而 H200 的 NVLink 卡間頻寬可到約 900GB/s,這會直接影響需要頻繁交換 KV cache 或進行大規模模型並行的工作負載。

所以部署策略很清楚:單卡能搞定,就盡量不要上雙卡。RTX PRO 6000 的優勢在於單卡大顯存與本地推理,而不是多卡無損通信或大規模訓練。

為什麼價格一路上漲?

漲價原因可以歸納成三點。

第一,96GB GDDR7 顯存本身成本高。

第二,Blackwell 架構產能優先供給資料中心,工作站卡供應被壓縮。

第三,AI 本地部署需求太強,企業、科研機構、設計公司都在搶現貨。

這張卡發布初期的官方定價約 8,000 美元,但國內現貨價已經衝破 42 萬台幣,這種價格波動讓它不只是一張顯卡,更像企業算力採購裡的稀缺資源。

ECC、FP4 與 96GB 顯存的真正價值

對一般玩家來說,ECC 顯存可能只是「比較穩」。但在金融風控、醫療影像、科學計算或企業模型推理場景,一個 bit 翻轉就可能造成結果偏差,RTX PRO 6000 的 96GB GDDR7 全部支援 ECC,這也是它和遊戲卡之間很大的分水嶺。

另一個關鍵點是 FP4 原生支援。當模型採用 4-bit 量化時,顯卡是否原生支援低精度計算,會影響實際推理效率,這也是 RTX PRO 6000 在 70B 模型本地部署上特別有吸引力的原因。如果你主要在比較本地模型格式與量化選項,也可以先從 Ollama + Qwen 模型選擇這類實務問題回頭推硬體需求。

版本怎麼選?

RTX PRO 6000 Blackwell 可以分成幾個主要版本來看:工作站版、Max-Q 版、伺服器版,以及中國特供版 RTX PRO 6000D。選擇邏輯不是誰規格最高就買誰,而是看你要放在什麼機器裡、用幾張卡、散熱與供電條件是否撐得住。

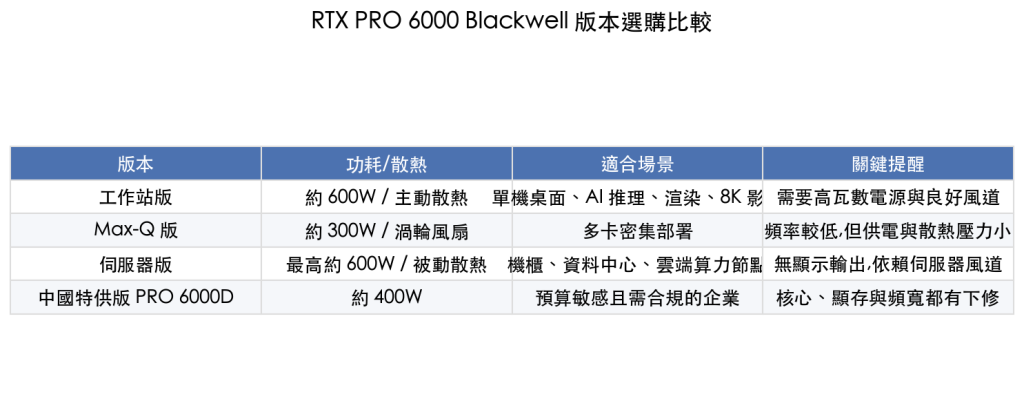
不同版本的 RTX PRO 6000 Blackwell,選購重點不只看性能,也要看散熱、供電與部署密度。
版本適合對象注意事項
工作站版單機桌面、AI 推理、渲染、8K 內容製作約 600W 功耗,需要高瓦數電源與良好風道
Max-Q 版多卡密集部署功耗較低,較適合多卡機箱
伺服器版機櫃、資料中心、雲端算力節點被動散熱、無顯示輸出,依賴伺服器風道
中國特供版 PRO 6000D預算敏感且需合規的企業核心、顯存與頻寬下修,但價格較低

工作站該怎麼配?

600W 等級的顯卡不是隨便塞進一般機箱就能穩定運作,電源至少要抓 1200W,更穩妥是 1500W 以上;若考慮峰值功耗或未來擴充,2000W 白金電源會更安心,主板則建議支援 PCIe 5.0 x16,並選擇 PCIe 通道充足的工作站平台,例如 Threadripper Pro 或 Xeon W 等級平台。

散熱方面,工作站版雖然有主動散熱,但機箱風道仍然非常重要。

多卡部署更建議考慮水冷或 Max-Q 版本。CPU 不能太弱,因為推理工作仍需要 CPU 處理資料預處理、API 調度與周邊工作。記憶體建議 128GB 起跳,若有 RAG、向量資料庫或多模型服務,256GB 會更寬裕。

現在該不該買?

我的判斷會比較直接:如果你是個人開發者或小團隊,有 AI 推理、RAG 或微調需求,且預算足夠,可以考慮入手;如果不急,可以等產能釋放後價格回落,但不要期待回到早期官方定價,若是做大模型訓練,也應該看 H100/H200 這類資料中心方案。

總結來說,RTX PRO 6000 Blackwell 的價值不在於「全能」,而在於它把 96GB 大顯存、ECC、FP4、Blackwell 架構和工作站可部署性放在同一張卡上。它不完美,沒有 NVLink、訓練能力有限、價格也高;但在本地 AI 推理、企業工作站、專業渲染和 4K 內容製作場景裡,確實是一張很有競爭力的卡。


FAQ

RTX PRO 6000 Blackwell 適合訓練大模型嗎?

不太適合大規模訓練。它更適合本地 AI 推理、RAG、知識庫問答、專業渲染與工作站應用。若要做大規模多卡訓練,應優先考慮 H100/H200 等資料中心方案。

RTX PRO 6000 能平替 H200 嗎?

不能完全平替。在 70B 4-bit 推理場景下,它大約可達 H200 約 75% 到 80% 的性能,但 H200 在顯存頻寬與 NVLink 多卡互連上仍有明顯優勢。

RTX PRO 6000 為什麼適合 70B 模型?

關鍵在 96GB 顯存與低精度推理支援。70B 量化模型可以在單卡容納,降低多卡部署複雜度,也避免多卡通信帶來的延遲。

Dify Agent

Dify Agent

Dify AI 是一個開放靈活的生成式 AI 應用開發框架,提供了一個全方面的解決方案,讓開發者能夠輕鬆構建和運營生成式 AI的 原生應用。平台的核心技術包括 AI 工作流程編排、RAG 檢索、模型管理等功能。Dify AI 支持從 Agent 建立到工作流程編排的完整開發過程,讓使用者可以專注於創造應用的核心價值,此外,它提供的工具包括 Prompt IDE、Enterprise LLMOps 和 BaaS 等解決方案,可以大幅度的提升開發效率並優化應用性能,可以先去Dify的GitHUB看看。

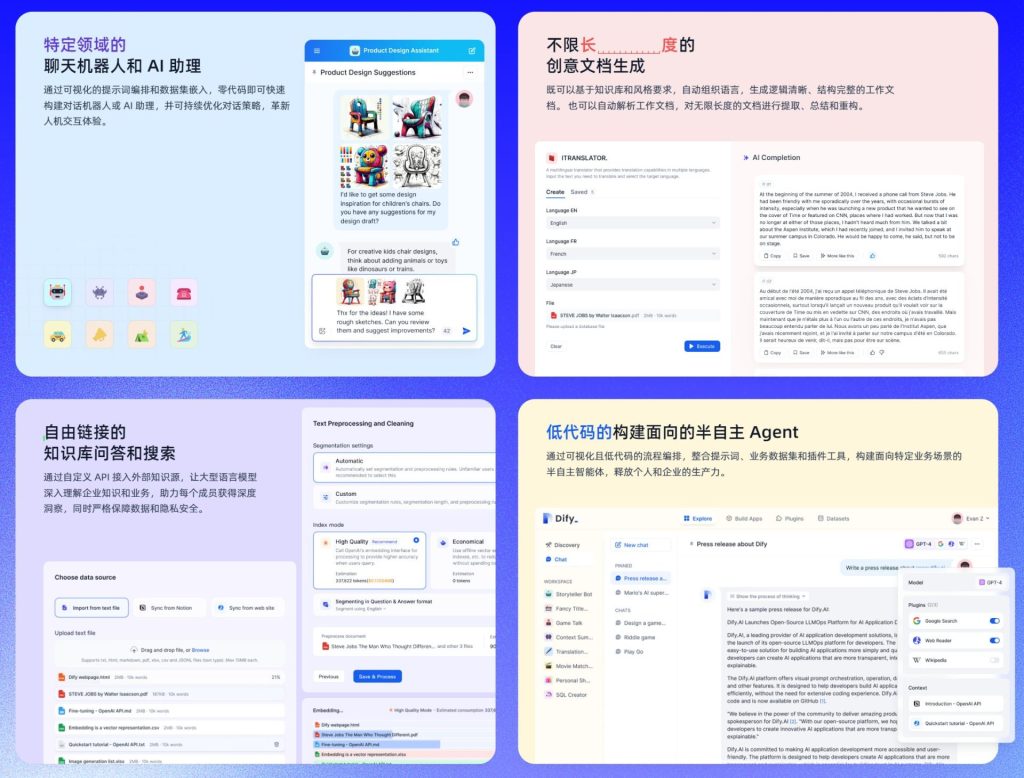
特色介紹

公司內部私有化的知識庫和AI助理

Dify AI 允許企業將內部知識庫整合到平台中,並創建專屬的AI助理,來高效地管理和利用企業知識。

公司內部可以控管的紀錄

企業可以通過Dify AI平台對所有操作和數據進行詳細記錄和管控,確保數據安全和合規性。

AI工作流自動化

Dify AI 提供連結公司內部資訊系統的能力,幫助企業自動化處理各種業務流程,提升運營效率。

零代碼創建 AI Agent

平台支持用戶在無需編寫代碼的情況下,創建和部署個性化的 AI Agent,滿足各類業務需求。

支持多種大語言模型

Dify AI 支持全球各種主流的大語言模型(LLM),為企業提供靈活的選擇,以滿足不同場景的應用需求。

開發以及運營的支持

利用 Docker 安裝

先把專案抓下來

git clone https://github.com/langgenius/dify.git

然後可以用下面的指令安裝

cd docker
cp .env.example .env
docker compose up -d
安裝完成後,利用瀏覽器看 http://localhost/install ,按照步驟設定即可

使用線上服務

https://cloud.dify.ai/apps

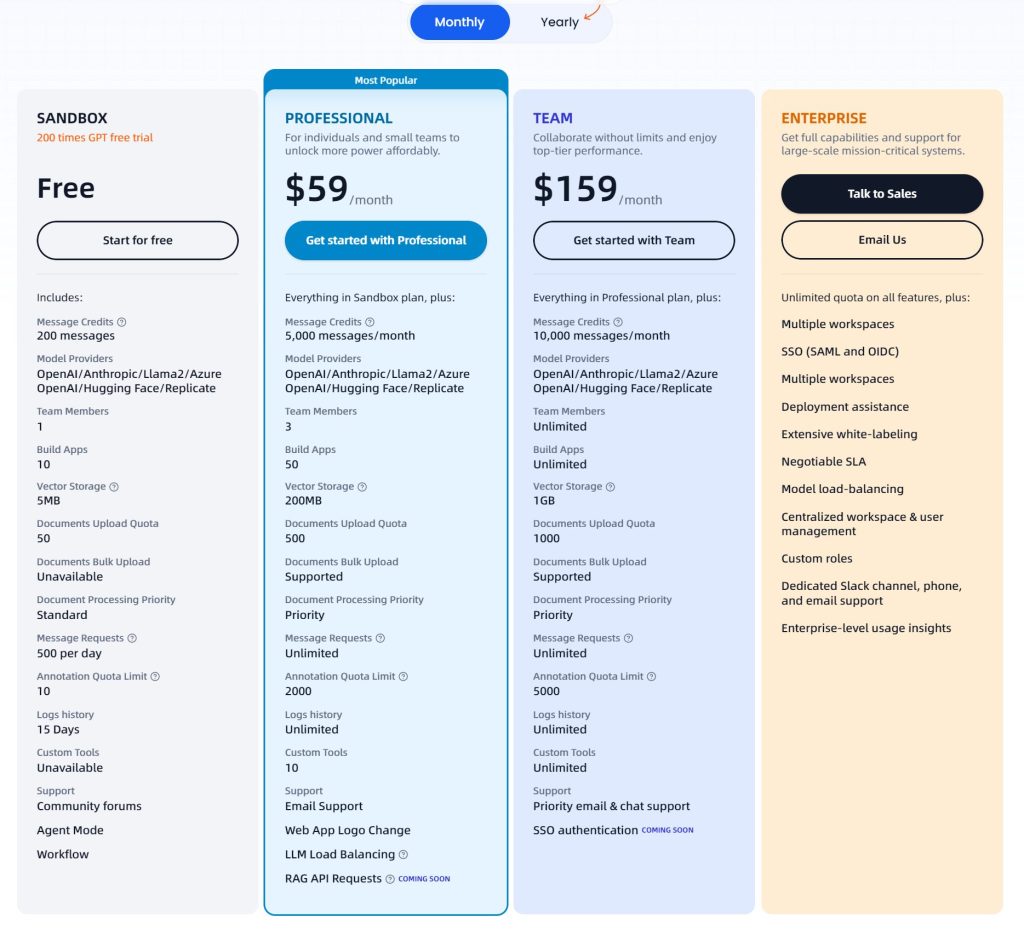
價格表

您可以在 Dify AI 官網 上了解更多詳情。

參考資料:

將你的Python程式碼改成 web api

現在AI的時代,實在是離不開python,有時候想要快速的驗證程式設計,並且對外服務,給外部的人測試,這時候可以考慮把在 CLI 執行的 python code ,改成 web api,讓外部的人測試看看,改法如下

步驟 1: 安裝 Flask

pip install Flask

步驟 2 : 建立一個 Web APP

可以建立一個名為 webapi.py 的檔案,並且輸入以下程式碼,這樣就可以簡單地把 GraphRAG 的服務對外

from flask import Flask, request, jsonify
import subprocess
import shlex

app = Flask(__name__)

@app.route('/query', methods=['POST'])
def query():
    # 获取请求中的问题
    data = request.json
    question = data.get('question')
    
    if not question:
        return jsonify({'error': 'No question provided'}), 400
    
    # 构建 CLI 命令
    command = f"python -m graphrag.query --root ./ragtest --method local \"{question}\""
    # 安全地处理命令
    args = shlex.split(command)
    
    # 执行命令
    try:
        result = subprocess.run(args, check=True, stdout=subprocess.PIPE, stderr=subprocess.PIPE, text=True)
        response = result.stdout
        # 假设输出中包含 "SUCCESS:" 和我们需要的答案
        if "SUCCESS:" in response:
            answer = response.split("SUCCESS:")[1].strip()  # 取得成功后的文本作为答案
            return jsonify({'answer': answer})
        else:
            return jsonify({'error': 'Failed to get a valid response from the CLI tool'}), 500
    except subprocess.CalledProcessError as e:
        return jsonify({'error': str(e)}), 500

if __name__ == '__main__':
    app.run(debug=True, port=5000)

步驟 3 : 開啟服務

python webapi.py

步驟 4 : 使用 API

curl -X POST http://localhost:5000/query -H "Content-Type: application/json" -d "{\"question\": \"新修正之勞工特別休假日數有多少?\"}"

延伸閱讀