Krea2 圖像編輯怎麼玩?ComfyUI 多圖參考與 4K 工作流整理
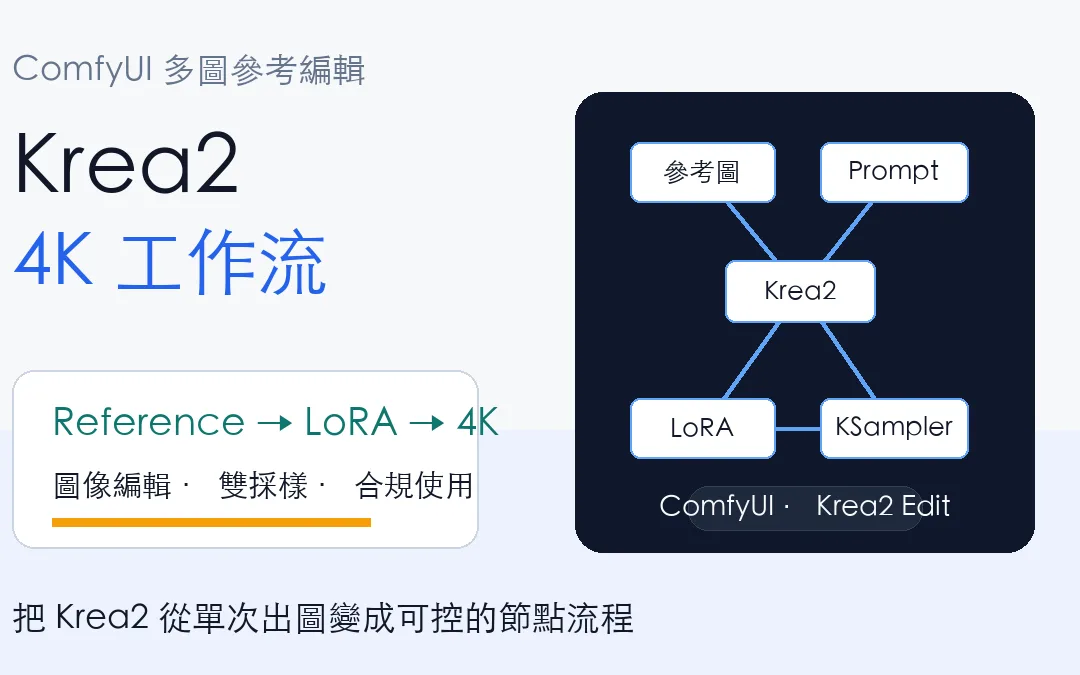
Krea2 開始變得有趣,不只是因為它能做漂亮的圖,而是因為它正在被接進 ComfyUI 的節點工作流。當圖像編輯、多圖參考、LoRA、KSampler 和 4K 出圖放在同一張節點圖裡,Krea2 就不只是單次生成工具,而是可以被拆解、調參、複用的內容生產流程。
我會把這次重點整理成三件事。
第一,Krea2 edit LoRA 的 ComfyUI 節點怎麼理解。
第二,私模與社群模型要怎麼分開看。
第三,4K 工作流不是單純放大,而是先控制訓練尺寸,再用 latent 放大與第二次採樣補細節。
Krea2 圖像編輯的真正重點
Krea2 圖像編輯最吸引人的地方,是它把「參考圖」和「提示詞」放到同一個生成條件裡,這比單純丟一張圖做 img2img 更細,因為參考圖可以被視覺編碼器理解,再和 prompt 一起影響模型輸出。
ComfyUI-Krea2-Ostris-Edit 這個節點包就是關鍵之一,它的 README 說明,這套節點是為了執行用 AI Toolkit 訓練的 Krea 2 edit LoRA,安裝方式是放到 ComfyUI 的 `custom_nodes` 目錄,重新啟動後節點會出現在 `ostris/krea2` 類別。
它不是模型本體,而是讓 ComfyUI 能正確吃進 Krea2 edit LoRA 的橋,這點很重要,因為很多人看到節點就以為模型已經包含在裡面,實際上模型、LoRA、節點和工作流是四個不同層次。
多圖參考不是把圖片塞進去就好
Krea2 Ostris Edit 的文字編碼節點可以接受 prompt,也可以接受 `image1` 到 `image3` 這類參考圖。GitHub 說明裡提到,參考圖會透過 Krea2 的 Qwen3-VL text encoder 編碼,並用 Krea 的 conditioning template 加入 `Picture N:` 這類視覺 placeholder。
換句話說,多圖參考的重點不是「圖片有沒有接上節點」,而是參考圖有沒有被正確轉成 conditioning。若接了 VAE,參考圖也會被 VAE 編碼成 reference latents,再交給 model patch 節點使用。這也是為什麼工作流裡會看到 Text Encode、Model Patch、VAE、KSampler 連在一起。
- Text Encode Krea 2 Ostris Edit 負責把 prompt 與參考圖一起編碼
- Krea 2 Ostris Edit Model Patch 讓模型真的消化 reference latents
- 如果文字編碼 checkpoint 沒有 Qwen3-VL vision weights,參考圖就無法被正確編碼
- 如果 conditioning 沒有 reference latents,patch 後的模型會像原本的 Krea2 一樣運作
這也是我會把它歸類為進階 ComfyUI 工作流,而不是單純的模型推薦,若你對節點式 AI 生產平台還不熟,可以先看我整理過的 RunningHub 與 ComfyUI 工作流平台,會比較容易理解為什麼同一個模型放進工作流後,價值會完全不一樣。
私模、社群模型與合規使用要分清楚
這次素材裡有一個很值得注意的提醒:老白訓練的 Krea2 亞洲女性私模不是開源模型,它是投入大量訓練步數與算力成本做出來的商業模型,這類模型能不能商用、能不能轉售、能不能放到平台上提供他人使用,都要看授權條款。
所以我會把工作流和模型分成兩條線來看。工作流可以學,節點可以研究,參數邏輯也值得整理,但私模本身不是「看到連結就能自由拿來用」的資源。若只是想理解 Krea2 工作流,可以先從社群模型、公開節點和 RunningHub 上的示範流程開始。
另外,Krea2 的圖像編輯能力很容易碰到肖像、換裝、仿真與身份一致性問題。越是接近真人或商業素材,越需要確認素材來源、肖像權、授權和平台規範。技術可以做到,不代表每個場景都適合做。
4K 工作流的核心不是暴力放大
這套 4K 思路有一個實用點:先用接近訓練尺寸的長邊出圖,再在 latent 空間放大,最後用第二次採樣補細節。以這次整理的參數來看,長邊 1536 是一個被反覆提到的基準,因為後面還要做倍率放大。
第一個 KSampler 會用比較高的 denoise,例如 `denoise 1`,步數可以抓 8 到 10 步。這一步不是最後成品,而是建立整體構圖與質感。接著在 latent 空間放大,例如 2.5 倍,再進入第二個 KSampler。第二次採樣通常要更保守,避免把第一輪已經穩定的畫面重新打亂。
| 階段 | 用途 | 重點 |
|---|---|---|
| 第一輪採樣 | 建立構圖與主要質感 | 可用較高 denoise,步數約 8 到 10 |
| latent 放大 | 把畫面放到更高解析度 | 倍率要配合原始長邊與顯存 |
| 第二輪採樣 | 補細節與穩定質感 | 採樣器與 denoise 要保守,避免重新洗圖 |
這個思路和傳統 Stable Diffusion 的高解析修復很像,但放到 Krea2 和 LoRA 組合後,更需要注意模型本身的訓練尺寸與美學方向。你如果常玩本機模型部署,也可以對照我之前寫的 ComfyUI 本機部署 AI 繪圖模型,兩者都在處理「模型能力」和「工作流控制」之間的平衡。
LoRA 權重不是越高越好
這次工作流裡多次出現 LoRA 疊加。單獨使用某個風格 LoRA 時,權重可以先從 0.8 附近測。若兩個 LoRA 一起用,總權重抓在 0.9 到 1.0 比較容易控制,例如一個 0.5,另一個 0.4。
這不是死規則,而是避免模型過度偏移的起點。Krea2 本身的細節與光影已經很強,LoRA 的目的應該是加強風格或概念,而不是把底模原本的結構感整個蓋掉。若出現臉部變形、姿勢不穩、材質變髒,第一個要檢查的通常不是 prompt,而是 LoRA 權重和第二輪採樣是否太激進。
Krea2 工作流適合誰
我覺得 Krea2 這類流程比較適合三種人。第一種是已經熟悉 ComfyUI,想要把參考圖、LoRA、放大與後處理串成固定模板的人。第二種是需要穩定產出社群圖像、封面、人像素材或商品視覺的人。第三種是想研究圖像編輯模型訓練方向的人,因為 Krea2 edit LoRA 的節點設計能看出參考圖 conditioning 的實作脈絡。
如果只是偶爾修圖,可能用線上工具會比較快。如果要長期做工作流、批量產圖、測 LoRA 權重,ComfyUI 仍然比較有彈性。也可以用 AIX Studio 這類 AI 繪圖平台 做比較,看看自己需要的是封裝好的產品,還是可拆解的節點流程。
實作前可以先檢查這幾件事
- 確認 Krea2 模型與 LoRA 來源,尤其是授權和商用限制
- 安裝 ComfyUI-Krea2-Ostris-Edit 節點後再重啟 ComfyUI
- 確認 text encoder checkpoint 含有 Qwen3-VL vision weights
- 多圖參考要檢查 VAE reference latent 是否真的接進 conditioning
- 第一輪採樣先穩構圖,第二輪採樣再補細節
- LoRA 疊加時總權重不要一開始就拉太高
- 真人、換裝、仿真、商業圖像要先確認合規與授權
若你想直接在線上試工作流,可以看 RunningHub 的 Krea2 Realism Engineer v2 工作流頁面。若人在海外,RunningHub 也有海外站。這類平台的好處是不用先處理本地顯卡和節點衝突,但缺點是工作流可控性和資料隱私要自己評估。
結論
Krea2 圖像編輯真正值得看的,不只是單張效果圖,而是它如何被拆成 ComfyUI 裡的節點、conditioning、model patch、LoRA 權重和雙採樣流程。這讓它從「好看的模型」變成「可調整的生產系統」。
我的建議是先從公開節點和可取得的工作流開始,把參考圖進 conditioning 的路徑搞懂,再去看私模或商業模型是否值得投入。尤其是人像與商業素材,合規使用要放在技術嘗試前面。能生成不是終點,能穩定、可控、可授權地生成,才是 Krea2 工作流真正能落地的地方。
近期留言