VibeVoice 是什麼?Microsoft ASR、即時 TTS 與 CPU 部署指南
VibeVoice 現在不能只理解成一個文字轉語音模型,它已經變成 Microsoft 的開源語音模型家族,包含長音訊語音辨識、即時串流 TTS、長篇多人 TTS,以及最新的 CPU 量化辨識版本,值得注意的地方,不只是能把文字念出來,而是它開始把「聽懂一小時內容」與「收到文字後立刻開口」做成兩條可以獨立部署的路線。
先講我的結論。如果要做會議轉錄、訪談整理或字幕,先看 VibeVoice-ASR。如果只有一般電腦,優先測試 VibeVoice-ASR-BitNet。如果要讓 Agent 邊產生答案邊說話,選 VibeVoice-Realtime-0.5B,至於能合成 90 分鐘、最多四人對話的 VibeVoice-TTS-1.5B,目前官方快速體驗仍標示為停用,不能把社群整合包的功能直接當成官方現況。
VibeVoice 四個版本怎麼選
| 模型 | 主要工作 | 適合場景 | 部署重點 |
|---|---|---|---|
| VibeVoice-ASR-7B | 長音訊轉文字 | 會議、訪談、字幕、多人對話 | 可一次處理最長 60 分鐘,完整模型需要較多 GPU 記憶體 |
| VibeVoice-ASR-BitNet | CPU 語音辨識 | 桌機、Mac、邊緣設備、離線轉錄 | 模型約 1.58 GB,不需要 GPU |
| VibeVoice-Realtime-0.5B | 即時文字轉語音 | 語音 Agent、即時旁白、串流回應 | 單一說話人,英文為主要目標,其他語言仍屬實驗 |
| VibeVoice-TTS-1.5B | 長篇多人語音合成 | Podcast、有聲內容、多人對話 | 原始能力可達 90 分鐘與四位說話人,但官方程式與快速體驗目前停用 |
VibeVoice 的核心不是單純縮小模型
VibeVoice 使用聲學與語意連續語音 tokenizer,運作頻率只有 7.5 Hz,這代表模型不需要把長音訊展開成極密集的離散 token,處理長序列時比較節省,生成端再用 next-token diffusion,把語言模型負責的文字脈絡與對話流程,交給 diffusion head 補上聲學細節。
這個架構帶來兩個很實際的能力。ASR 可以在 64K token 長度內一次接收最長 60 分鐘音訊,輸出誰在什麼時間說了什麼。
Realtime TTS 則採用交錯的視窗設計,一邊接收新增文字,一邊延續前文產生聲音,讓 LLM 不必等完整答案寫完才開始說話。
如果正在組本地語音 Agent,可以把它放進 speech-to-speech 的 VAD、STT、LLM、TTS 管線。VibeVoice-ASR 負責聽,Realtime 負責說,中間的 LLM 可以換成本地模型。這比把整套功能綁死在單一 App 裡更容易維護。
ASR 不只是逐字稿,還會分辨說話人
一般 Whisper 工作流常要再接一套 speaker diarization,才能把不同說話人分開。VibeVoice-ASR 把語音辨識、說話人分離與時間戳放進同一個輸出,直接得到 Who、When、What 的結構。對會議記錄、Podcast 整理、客服通話和長篇訪談,這比單純吐出一整段文字更有用。
它也支援自訂 hotwords,可以先提供人名、產品名、技術術語與背景資料,減少專有名詞被聽錯的機率。官方 Transformers 版本支援超過 50 種語言,也能處理語句內與語句間的語言切換。這讓 Python 整合不必依賴特定 WebUI。
VibeVoice 真的比 Whisper 快又準嗎
答案不是單純的「是」,Microsoft 公布的 CPU BitNet 測試中,在 AMD EPYC 7V13 上使用三條 CPU 執行緒時,RTF 為 0.77,已經快於即時播放速度,四條執行緒降到 0.63。Apple M4 使用四條執行緒的 RTF 為 0.43。這些結果證明 CPU 即時辨識成立,但不同處理器、音訊長度與編譯方式都會影響速度。
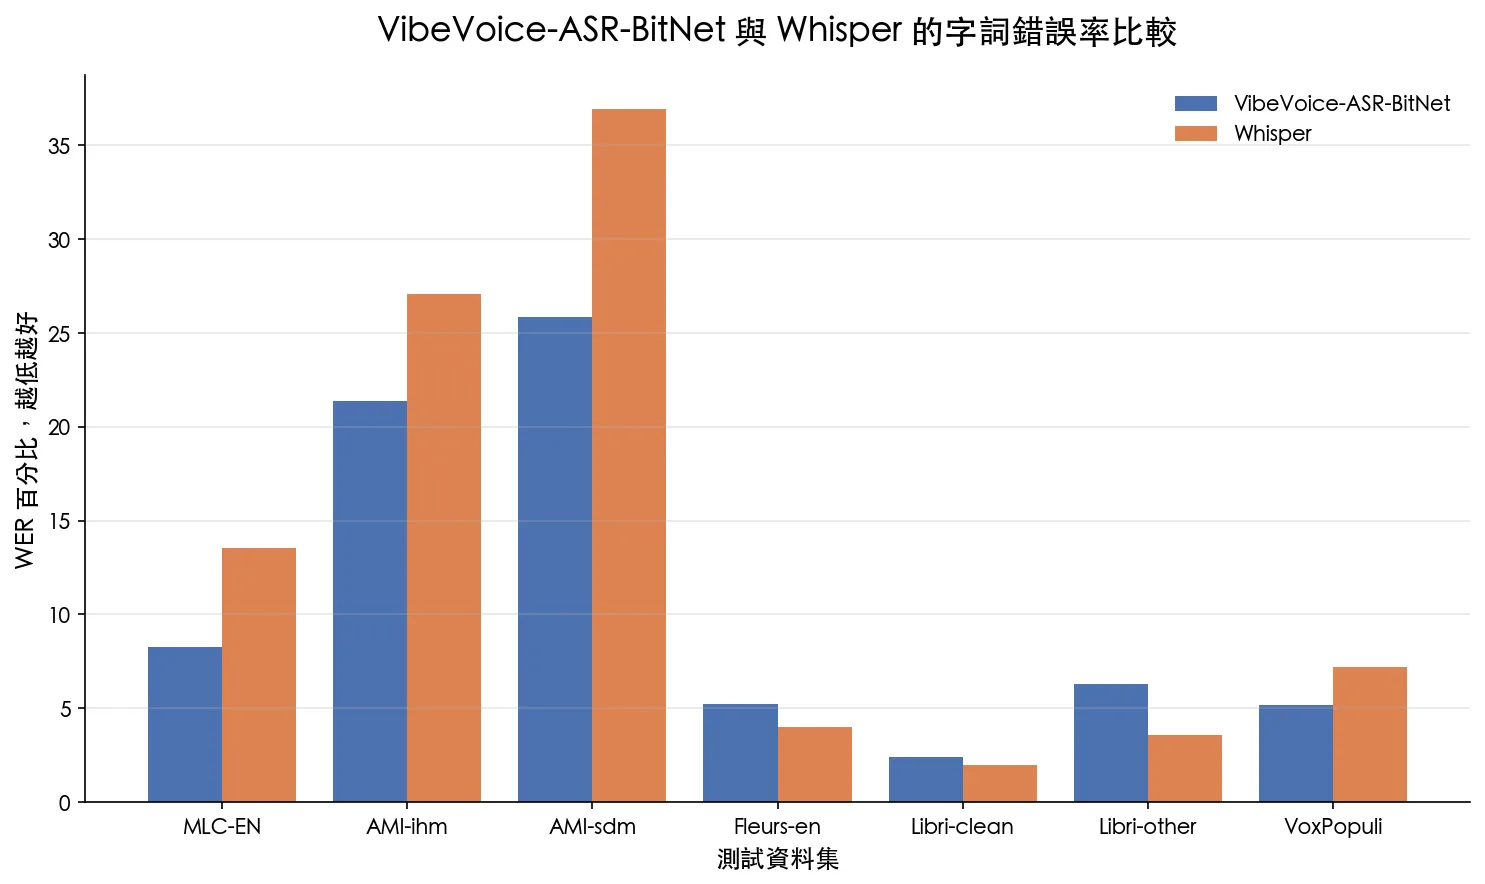
準確率也要分資料集看。BitNet 在 MLC-EN、AMI-ihm、AMI-sdm 與 VoxPopuli 的 WER 低於 Whisper,但在 Fleurs-en、Libri-clean 與 Libri-other 則是 Whisper 較低。所以比較正確的說法是,VibeVoice-ASR-BitNet 在多說話人與部分長音訊測試很有競爭力,不能直接延伸成所有語言、所有錄音條件都勝過 Whisper。
如果目前的工作流已經大量使用 Whisper,可以先看我整理的 Whisper 本地語音辨識,再拿自己的中文會議、多人訪談與背景噪音資料做同一套測試。真正有意義的是自己的素材,不是只看單一排行榜。
最省硬體的做法,用 VibeASR.cpp 跑 BitNet
只想在 CPU 上完成轉錄,官方的 VibeASR.cpp 是目前最直接的路線。需要 Python 3.9 以上、CMake 3.14 以上,以及 GCC 或 Clang。Windows 需要 MinGW-w64,MSVC 目前不支援。
git clone --recursive https://github.com/microsoft/VibeASR.cpp.git
cd VibeASR.cpp
pip install -r requirements.txt
python setup_env.py
準備一個 WAV 音檔後,用四條 CPU 執行緒開始轉錄。
./build/bin/asr_infer \
  --vae-model models/vibeasr/vibeasr-vae-encoder-i8_s.gguf \
  --lm-model models/vibeasr/vibeasr-lm-i2_s-embed-q6_k.gguf \
  --audio input.wav -t 4
模型頁也提供 Ollama 的啟動方式。這條命令適合先快速取得模型,若要穩定處理音訊檔與調整執行緒,VibeASR.cpp 的 CLI 參數會更清楚。
ollama run hf.co/microsoft/VibeVoice-ASR-BitNet:Q6_K
用 Transformers 在 Python 呼叫 ASR
需要接進自己的 Python 程式時,使用 Transformers 5.3.0 以上的官方模型最乾淨。完整 ASR 權重較大,先確認顯卡記憶體與磁碟空間,不要把 Realtime 0.5B 的硬體需求套過來。
python -m venv .venv
source .venv/bin/activate
pip install transformers==5.3.0 accelerate soundfile
from transformers import AutoProcessor, VibeVoiceAsrForConditionalGeneration

model_id = "microsoft/VibeVoice-ASR-HF"
processor = AutoProcessor.from_pretrained(model_id)
model = VibeVoiceAsrForConditionalGeneration.from_pretrained(
    model_id,
    device_map="auto"
)

inputs = processor.apply_transcription_request(
    audio="input.wav"
).to(model.device, model.dtype)

output_ids = model.generate(**inputs)
generated_ids = output_ids[:, inputs["input_ids"].shape[1]:]
result = processor.decode(generated_ids, return_format="parsed")[0]

for item in result:
    print(item)
如果要讓多人共用,官方還提供 vLLM 外掛,對外開出 OpenAI 相容的 /v1/chat/completions 端點,並支援串流、長音訊、hotwords、資料平行與張量平行。這條路比較適合公司內部的集中式轉錄服務。
啟動 Realtime 0.5B 即時 TTS
Realtime 版本的價值是讓 LLM 還在產生文字時就開始發聲。官方資料寫的是約 200 毫秒產生第一段聲音,但實際聽到的時間還會加上網路與播放緩衝。官方測試中 NVIDIA T4 與 Mac M4 Pro 可以達到即時速度,這不代表每一台 Mac 或每張 6GB 顯卡都一定相同。
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
python -m venv .venv
source .venv/bin/activate
pip install -e ".[streamingtts]"
python demo/vibevoice_realtime_demo.py \
  --model_path microsoft/VibeVoice-Realtime-0.5B
Realtime 0.5B 目前只支援單一說話人,英文仍是主要目標。德文、法文、義大利文、日文、韓文、荷蘭文、波蘭文、葡萄牙文與西班牙文屬於實驗音色。中文長篇多人合成若來自社群分支或整合包,應分開標示版本與來源。想比較更偏聲音克隆的方案,可以延伸看 dots.tts 的 3 秒聲音復刻架構,若重點是音色設計,則可以看 Qwen3-TTS 的音色控制。
文字正規化是長篇 TTS 的必做前處理
長篇語音最常見的問題不是音色,而是日期、金額、百分比、網址與特殊符號被念錯。輸入「2026/7/28」與輸入「二零二六年七月二十八日」,模型收到的任務並不相同。正式生成前應先清理 Markdown、程式碼、罕見符號與過度複雜的標點,再把數字轉成預期的口語形式。
pip install wetext
from wetext import Normalizer

normalizer = Normalizer(lang="zh", operator="tn")
text = normalizer.normalize("2026年7月28日,版本 1.0")
print(text)
WeText 可以做中文、英文與日文的 TN 和 ITN。它不是萬能修正器,品牌名、縮寫與人名仍要自行建立字典。這一步也適合放在 Voicebox 本地 AI 語音工作室這類批次工作流前面,避免同一個錯誤被大量生成。
安裝時最容易卡住的地方
- PyTorch 裝成 CPU 版:先用
python -c "print(__import__('torch').cuda.is_available())"檢查,再依自己的 CUDA 版本重裝官方 PyTorch 套件。 - 把所有版本當成同一套需求:ASR-7B、Realtime-0.5B 與 BitNet 的模型大小和執行後端完全不同。
- 把社群功能當成官方保證:自訂音色、中文多人 TTS 與一鍵整合包要確認來源、commit 與安全性。
- 忽略 FFmpeg:Gradio 與長音訊服務通常需要 FFmpeg 解碼,先確認
ffmpeg -version能正常執行。 - 直接丟進正式產品:Microsoft 明確把目前版本定位在研究與開發用途,正式商用前要自行測試準確率、延遲、授權與風險。
我會怎麼選
VibeVoice 最有價值的不是某一個模型贏過所有對手,而是它把語音工作拆成幾個明確層級。只有 CPU 就用 BitNet。需要長音訊、說話人與時間戳,就用完整 ASR。需要 Agent 邊想邊說,就用 Realtime。需要中文音色克隆與更強的角色控制,則把 dots.tts、Qwen3-TTS 或其他本地 TTS 放進比較名單。
我特別喜歡 BitNet 這次的方向。它不是叫使用者為了語音辨識再買一張顯卡,而是透過量化與專用 CPU runtime,把模型帶回一般電腦。這種改進比單純把參數做大更接近真正能落地的本地 AI。
官方資源
- VibeVoice GitHub
- VibeVoice 專案網站
- VibeVoice-ASR-HF 模型
- VibeVoice-ASR-BitNet 模型
- VibeASR.cpp CPU 推理工具
- WeText 文字正規化工具
FAQ
VibeVoice 可以完全離線使用嗎
可以。模型與依賴下載完成後,VibeASR.cpp、Transformers ASR 與 Realtime TTS 都可以在本地執行。第一次安裝與下載權重仍需要網路。
6GB 顯存可以跑所有 VibeVoice 模型嗎
不可以。6GB 是特定 TTS 或 Realtime 組合的實測條件,完整 ASR 權重需要更多資源。只有一般電腦時,CPU 版 BitNet 是更合理的起點。
VibeVoice-Realtime 支援中文嗎
官方目前仍把英文列為主要目標,另提供九種實驗語言,名單不含中文。社群版本可能加入中文或自訂音色,但要分開看待。


近期留言