by Rain Chu | 9 月 18, 2026 | AI, 模型
模型蒸餾,是用教師模型提供的學習訊號訓練學生模型,讓學生在指定任務上學會更好的判斷與回應。常見目標是把能力轉移到較容易部署的小模型,降低使用時的資源需求。它需要新的訓練過程,效果取決於教師、學生本身的能力,以及準備了什麼資料。
理解這件事,最有用的起點是分清楚兩種做法:讓學生學教師的機率分布,以及讓學生學教師產生的完整答案。這也能解釋為什麼同樣叫蒸餾,有的需要取得模型內部輸出,有的只靠生成文字就能進行。
模型蒸餾是什麼?教師提供訊號,學生更新參數
Hinton、Vinyals 與 Dean 的知識蒸餾論文提出用大型模型或模型集成的預測分布,訓練另一個容易部署的模型。學生學習的是教師在不同輸入下的行為,不必照抄教師的架構,也不是把教師權重直接截取一部分。
一般離線蒸餾會先準備好教師,再固定教師的參數,由學生反覆預測、計算差距、更新自己的參數。完成訓練後,學生可以獨立推論。若產品另外設計了雲端備援,那是部署流程的選擇,並非蒸餾必然要求。
軟標籤:除了正確答案,還學選項之間的關係
以辨識貓、狗與汽車為例,人工標籤可能只寫「貓」。教師除了選出貓,還會對其他類別給出機率。狗的可能性高於汽車,透露出這張照片在模型眼中更接近哪類事物。這種帶有相對關係的訊號,就是軟標籤的價值。這裡是概念示例,並非實測數據。
經典做法會調整 softmax 的溫度,讓機率分布更平滑,使原本很小的機率差異更容易參與學習。溫度過高也會讓分布過於平均,因此仍需驗證。它不是「溫度越高,學生就越聰明」的設定。
PyTorch 官方教學示範把兩種訓練目標加權:一種要求學生接近教師分布,另一種要求學生符合真實標籤。分布差距可透過 KL divergence 等目標衡量。訓練時仍應保留正確答案的約束,教師的自信不等於答案一定正確。
實作時,直接比對逐 Token 分布通常還需要處理詞彙表、Tokenizer 與序列位置的對齊。光是教師和學生都能生成中文,並不足以保證它們的機率陣列可以直接相減。
回答蒸餾:把教師輸出變成學生的訓練資料
另一條路徑是先讓教師回答問題,整理成「輸入與目標回答」的資料集,再用監督式微調訓練學生。學生逐步學習如何產生這些答案,不需要拿到教師的全部權重。若服務只提供文字輸出,也可能採用這種方式,前提是取得與使用資料的條件允許。
Sequence-Level Knowledge Distillation在機器翻譯研究中,探討把整段生成序列作為蒸餾訊號。放到語言模型的應用裡,資料可以包含回答格式、分類結果、解題步驟與工具使用範例,但具體要教什麼,仍由資料與訓練目標決定。
例如,希望學生整理客服工單,就應準備真實會遇到的問法,要求教師產生正確分類、摘要與缺漏欄位,再經規則或人工檢查。只收集漂亮、流暢的回答,未必能教會學生處理錯字、矛盾敘述與資訊不足。這是本文用來說明資料設計的應用示例。
DeepSeek-R1 的蒸餾模型,為什麼會叫 Qwen 或 Llama?
DeepSeek-R1 官方模型卡說明,Distill 系列以 Qwen 與 Llama 的既有模型為基礎,使用 DeepSeek-R1 生成的樣本進行微調。名稱同時反映了提供訓練訊號的來源,以及學生採用的基礎模型。
因此,DeepSeek-R1-Distill-Qwen 不是把完整 R1 的參數切小,也不能直接當成 R1 的量化版。挑選時應確認學生模型、適用任務、Tokenizer 設定與部署需求。官方基準測試能提供參考,但不能推論小模型在所有領域都等同教師。
蒸餾、微調、量化與剪枝,各自在改什麼?
微調著重於用資料更新既有模型。蒸餾著重於知識訊號來自教師,兩者可以同時成立。用教師生成的答案微調學生,就是常見的交集。LoRA則是透過低秩更新降低需要訓練的參數量,是微調方法之一,本身不代表模型已完成蒸餾,也不等於把基礎模型縮成更少參數。
量化著重於數值表示的精度。Hugging Face 量化文件說明,較低精度的權重表示能降低記憶體需求,並盡量保留準確度。參數量可以不變,但每個權重佔用的空間減少。量化後是否更快,還要看硬體、運算支援與實際負載。
剪枝著重於移除或遮蔽部分權重與結構。PyTorch 剪枝教學展示了不同剪枝方式。權重變成零,不保證一般推論程式就會自動跳過運算。要換成實際加速,仍需相應的結構或稀疏運算支援。
這些方法可以組合,例如先訓練出合用的學生,再評估量化部署。想把概念接到本機環境,可延伸閱讀Qwen 本地部署與 GGUF 設定,但不同模型與硬體的需求要分別核對。
API 已經夠方便,什麼情況還值得蒸餾?
判斷方式是先看工作量與限制。若需求經常改變、使用量不大,直接使用現成模型可能更省事。若每天反覆處理相近任務,而且對回應時間、併發量、離線使用有明確要求,才值得把學生模型列入比較。這是部署規劃上的判斷,並非固定的成本結論。
比較時要把整段使用週期算進去,包括教師生成資料、資料審查、訓練、評估、硬體、維運,以及學生失敗後的重試或轉接。單次推論便宜,不能代表整個專案一定便宜。反過來,網路速度很好,也不會消除資料處理範圍與服務可用性的需求。
開始訓練前,先測未蒸餾的小模型是否已經夠用。如果簡單提示詞或現成模型就能完成工作,便沒有必要為了使用蒸餾而建立訓練管線。需要測試不同本地與雲端模型時,可參考LibreChat 與 Ollama 的整合方式,用同一批任務比較實際結果。
本地蒸餾模型的隱私,要沿著資料流檢查
學生在本機推論,確實可以減少把使用者輸入送往外部服務的需要。不過,隱私取決於整個系統如何傳遞與保存資料,不能只看模型檔案放在哪裡。
先看訓練前的資料準備。如果把內部文件送給雲端教師生成範例,資料在這一步就已經離開本機。再看實際使用時,是否另有雲端搜尋、遠端 Embedding、外部工具、遙測或日誌服務。最後看備援路徑,學生答不好時若自動轉給雲端大模型,轉交的問題、文件與歷史對話仍可能外傳。
有資料不外傳的要求時,應設計為本地處理、明確拒答或交由內部人員處理。允許混合部署時,則應先定義可外傳的資料範圍,並告知使用者何時轉交。把「本地模型」當作隱私保證,容易漏掉真正的資料出口。
實作蒸餾,先定義任務,再決定要不要訓練
以下是依前述方法整理的實務流程,適合用來規劃第一個小型試驗,不代表所有專案都需要同一套訓練參數。
先建立基準與驗收題目
選一個邊界清楚的任務,例如工單分類或固定欄位擷取。先測現成學生模型和教師各自的表現,定義正確率、格式完整性、回應時間與可接受的失敗方式。測試題目應與訓練資料分開,也要包含少見與資訊不足的情況。
生成範例後,先檢查品質
教師輸出需要去重、檢查事實、移除敏感內容,並確認符合任務規格。對答案可直接驗證的題目,優先使用程式規則或單元檢查。若蒸餾的是解題步驟,也不能只檢查最後答案正確,就認定中間推導全部可靠。
選擇訓練訊號,保留比較組
只有教師文字輸出時,可從回答資料微調開始。能取得分布且處理好對齊時,再評估軟標籤蒸餾。進一步的GKD 方法會讓學生在自己生成的序列上取得教師回饋,處理訓練資料與學生實際生成行為之間的差異。方法更複雜,並不代表每個任務都需要採用。
驗證泛化能力,再測實際部署
The False Promise of Imitating Proprietary LLMs在其研究設定下發現,模仿模型可以學到很像教師的回答風格,卻未必同步取得相同的事實能力。這項結果提醒我們,應檢查資料覆蓋之外的任務,不能只以流暢程度驗收,也不宜把該研究解讀成所有蒸餾都無效。
完成離線評估後,還要用目標硬體測記憶體、延遲與同時請求的表現。如果任務需要查詢經常更新的內部資料,可考慮讓模型搭配檢索,而非每次更新文件都重新蒸餾。站內的CrewAI 與 RAG 概念整理可作為理解工具與檢索分工的延伸閱讀。
模型蒸餾常見問題
模型蒸餾就是把大模型壓縮成小檔案嗎?
蒸餾是用教師訊號訓練學生,模型檔案大小取決於學生架構與數值精度。若只改變權重精度以縮小檔案,通常是在做量化。
只有教師模型的 API,也能做蒸餾嗎?
若 API 提供的輸出及使用條件允許,可以收集教師回答來微調學生。這與取得完整機率分布後進行的軟標籤蒸餾不同。
蒸餾後的小模型一定和大模型一樣強嗎?
不一定。效果受學生原本能力、資料覆蓋與任務影響,必須使用獨立題目評估,不能只看回答是否流暢。
Token 成本低,還需要自己蒸餾嗎?
未必。先比較現成模型是否夠用,再看使用量、延遲與離線需求。成本需要包含資料準備、訓練和維運,不能只看單次推論。
把小模型用在能驗收的任務上
蒸餾最值得關注的成果,是學生能否在你的任務上穩定達到要求,同時讓部署更容易。先建立現成模型的基準,找出缺口,再決定要準備什麼教師資料。當品質、速度與整體成本都有實際驗證,才能判斷這次訓練是否值得。
by Rain Chu | 9 月 17, 2026 | AI, 模型
Ornith 1.5 把本地 AI 的一個老問題攤得很清楚:每秒吐出多少 token,和最後有沒有把工作做完,是兩回事,35B-A3B 版本靠 MoE 架構降低每個 token 的運算量,在公開實測中展現速度優勢,也出現思考太久、額度用完卻沒交出程式碼的案例。
如果你想找一顆接在本地程式代理後面的模型,Ornith 1.5 35B 值得列入測試,評估時要一起看量化格式、記憶體餘裕、工具相容性與任務完成率,下面先拆開「自我改進」的意思,再看官方評分、兩組不同硬體的實測,以及實際上手順序。
Ornith 1.5 更新了什麼?先分清楚三種模型
Ornith 1.5 家族包含 9B Dense、35B MoE 與 397B MoE。手機部署的主角是 9B-Mobile 量化版本,與旗艦商用模型比較的宣傳則主要圍繞 397B。本文聚焦中間的 35B-A3B,不能把另外兩款的部署條件或成績直接套過來。版本資訊可從 官方模型集合查看。
如果你看過 Ornith 1.0 的自我拆解任務方式,這次最主要的延伸是把「生成訓練任務」也納入改善流程。
自我改進發生在訓練期間,下載後不會自動改寫權重
依照 Ornith 官方技術說明,模型在訓練中依序扮演三個角色:先根據程式庫與過去解題紀錄出題,再安排工具、指令與拆解方法,最後嘗試解題。結果回饋到強化學習流程,讓題目、執行安排與解法一起改善。
出題也有條件:題目要能驗證、難度合適,而且不能一直重複,官方把目標成功率設在約 20%,讓模型練習有挑戰但仍可能解出的題目。這個百分比是訓練課程的設計目標,不是產品的答題正確率。
可以把它想成練習寫程式時,不只修答案,也回頭調整練習題與測試方式。
下載回來的則是訓練後的模型權重,日常對話、保存記憶或反覆提示,不代表權重正在持續更新。
AlphaLab 對自我改進邊界的分析也提醒,環境與評分規則仍由人設計,分數上升還要確認是否真的學會解題。
35B-A3B 的 A3B,不是記憶體只要放下 3B
MoE 每次只選部分專家參與計算,但其他專家的權重仍要有地方存放。活躍參數主要影響每一步的運算量,總權重與快取才是估算記憶體的起點。官方 35B 模型頁列出約 3B 活躍參數,BF16 權重約 70GB,原生上下文為 262,144 token,模型規格與啟動範例可作為設定依據。
以目前 官方 GGUF 檔案清單為例,Q4_K_M 單一模型檔約 21.71GB,換算約 20.22GiB,這還沒加上推論引擎、上下文快取或視覺投影檔,因此「有 24GB 顯示記憶體」只能作為測試起點,不能直接承諾長上下文與多個並行任務都放得下。
12GB 或 16GB 顯示卡若想跑這個 Q4 檔,通常還得規劃部分權重放在系統記憶體,或改用其他量化版本,能載入模型、能順利對話、能在長任務中維持速度,應分開驗收。Mac 使用統一記憶體,也要預留系統空間,可搭配 本地 AI 的記憶體與頻寬選擇理解這個差別。
官方評分顯示程式能力進步,但要連測試框架一起看
以下是官方模型卡中同尺寸模型的部分成績。
Ornith 1.5 的結果為團隊自報的五次執行平均,並非本文重跑,也不等於所有電腦都會得到相同結果。
| 測試 | Ornith 1.5 35B | Ornith 1.0 35B | Qwen3.6 35B |
|---|
| Terminal-Bench 2.1/Terminus-2 | 67.8 | 64.2 | 52.5 |
| SWE-bench Verified | 79.0 | 75.6 | 73.4 |
| SWE-bench Pro | 59.6 | 50.4 | 49.5 |
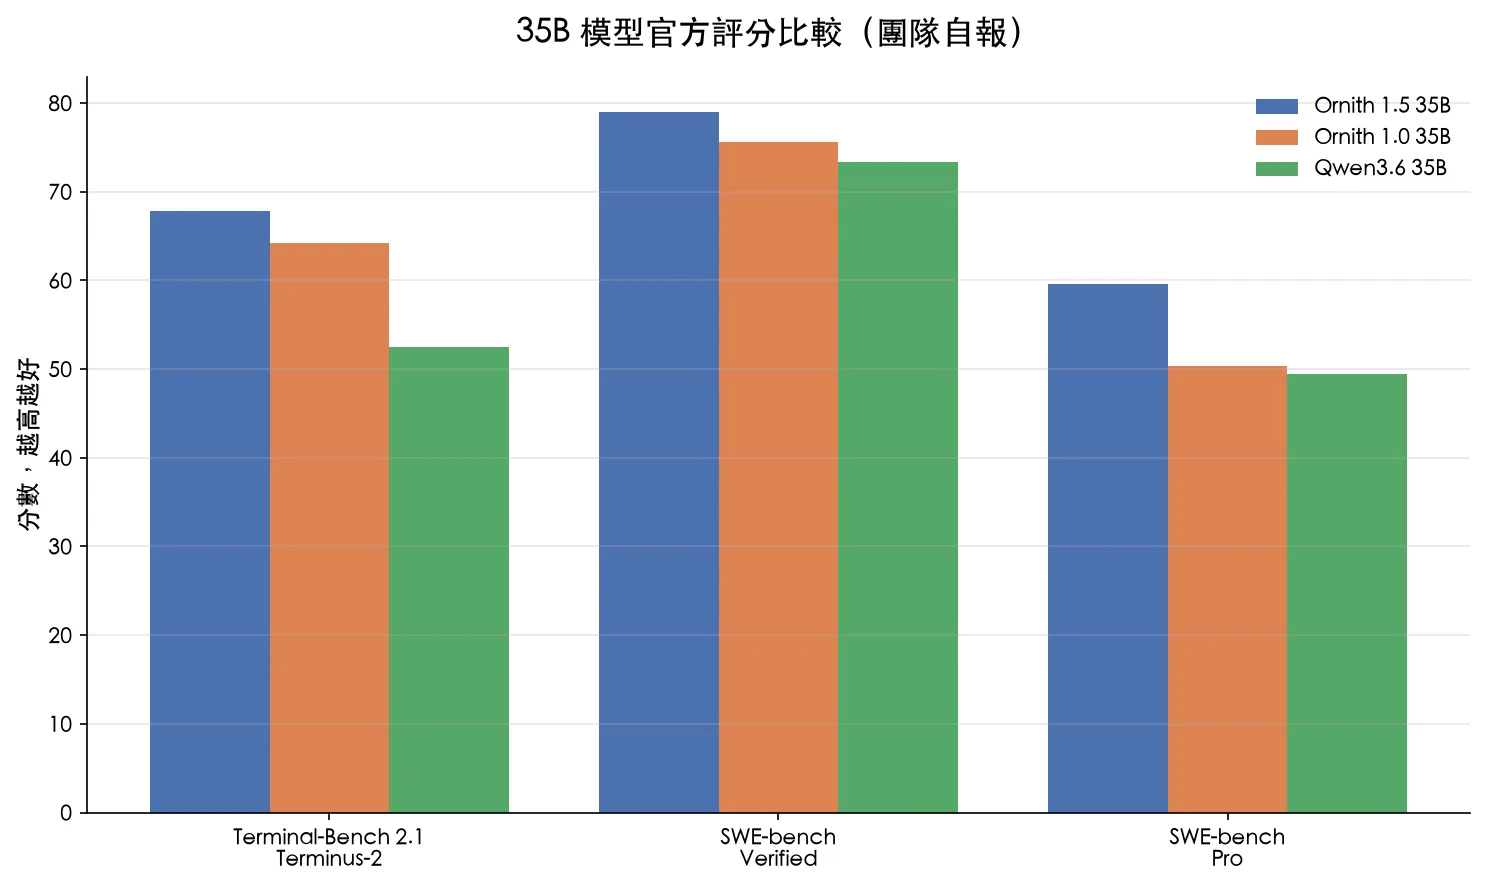 資料來源:Ornith 35B 官方模型卡。各項測試使用各自的評測設定,不能相加成通用能力分數。
Terminal-Bench 的上述結果使用 Terminus-2,SWE-bench 使用 OpenHands。工具、提示、可用時間與上下文都會影響代理表現。「追平 Claude Opus」應限於官方列出的特定 397B 比較,無法據此宣稱 35B 全面取代商用模型。
對上 Qwen3.8 27B:生成得快,整個任務卻可能更慢
DIY Smart Code 的 Benchy 本地測試使用 RX 7900 XTX 24GB、Ryzen 9、64GB 系統記憶體與 Ollama,比較兩款 Q4 模型。Ornith 測試標示 32K 上下文。這是作者自建測試集的一組案例,量化檔案與測試工具的細節限制了外部重現,不能當成通用排名。
| 同一組 Benchy 案例 | Ornith 1.5 35B | Qwen3.8 27B |
|---|
| 通過項目 | 18/21 | 20/21 |
| 生成速度 | 約 74 tok/s | 約 58 tok/s |
| 提示處理速度 | 約 850 tok/s | 約 240 tok/s |
| 整組耗時 | 約 26 分鐘 | 約 17 分鐘 |
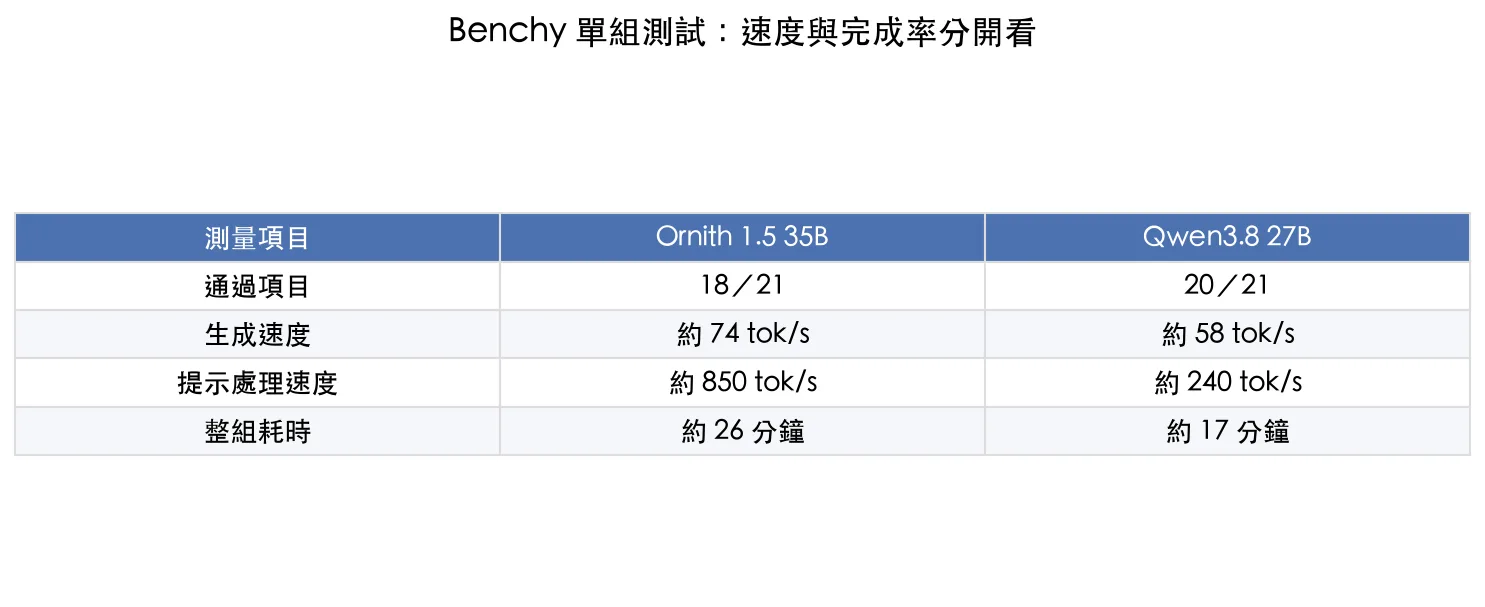 資料來源:DIY Smart Code,2026 年 8 月 22 日公開案例。數值依逐字稿約數整理,並非本文實測。
最有參考價值的是 DAG 非同步任務排程題:Ornith 花了約 18,000 個思考 token,耗盡輸出額度後沒有交出最終 Python 程式,Qwen 則完成程式並通過該題檢查。所以每秒輸出較快,仍可能因為思考與重試較多,拖長整個工作的時間。
這也不能反推成所有 MoE 都不擅長推理,或 Qwen 永遠比較穩,模型、量化、引擎與題型都不同,架構本身不能單獨解釋全部差異,要比較自己的程式任務,可參考 Qwen3.8 27B 本地部署教學,固定測試條件再重跑。
雙 GB10 的 NVFP4 實測:減少搬運,也能讓解碼加速
CyberQ 的雙 GB10 實測是在另一套硬體與 vLLM 環境中比較 BF16 與 NVFP4。它固定解碼 800 token,暖機後取三次量測中位數,因此較適合觀察格式差異,不適合直接和前面的 Ollama 成績排高低。
| 雙 GB10/TP=2 | BF16 | NVFP4 |
|---|
| 解碼吞吐量 | 48.41 tok/s | 101.86 tok/s |
| 12,001 token 提示處理 | 2,767 tok/s | 4,141 tok/s |
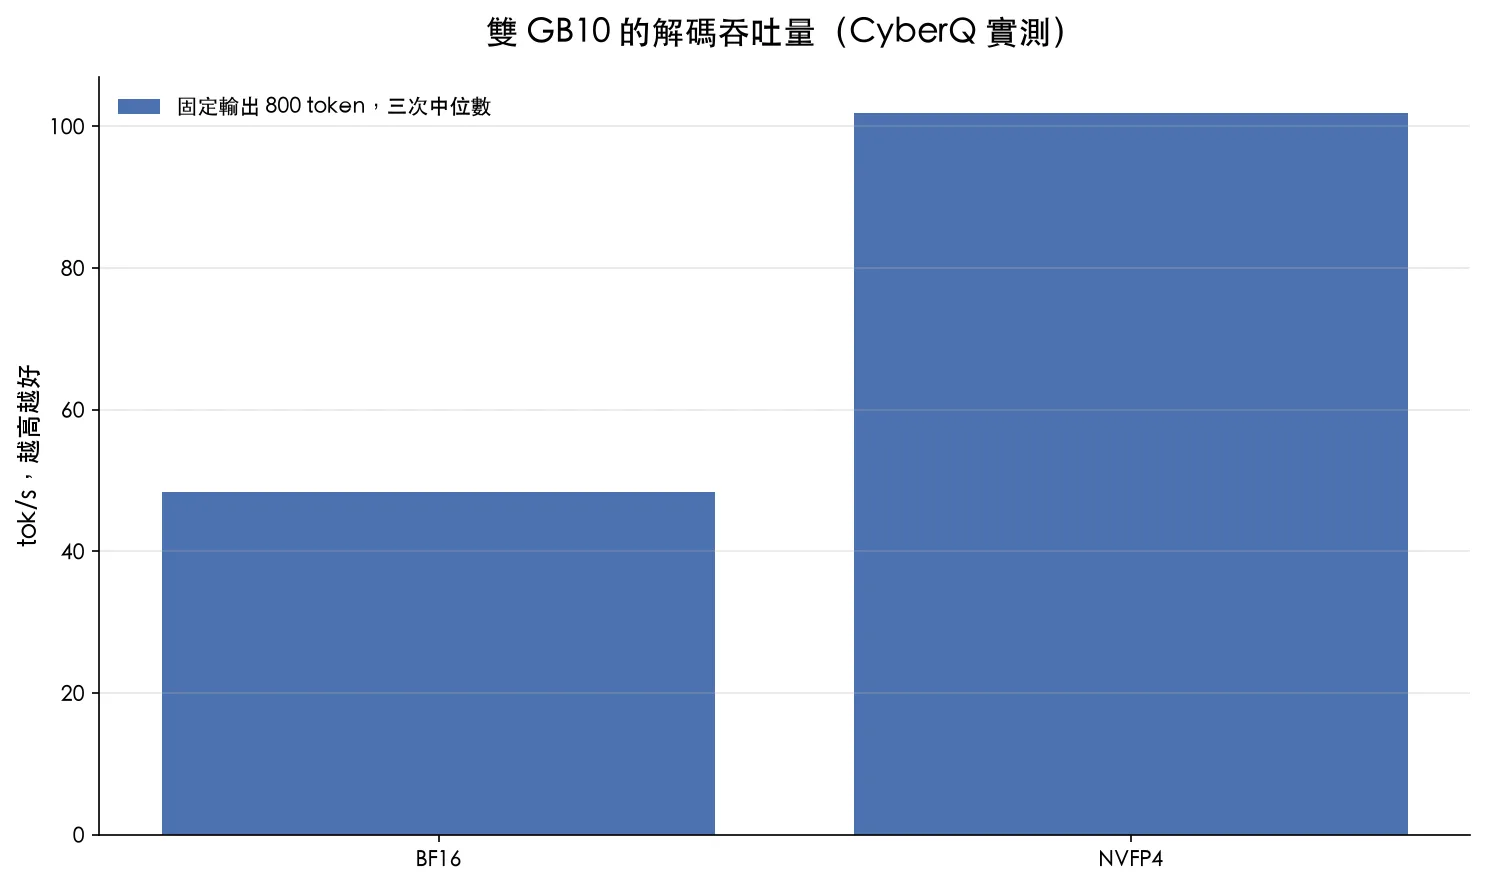 解碼約為 2.10 倍。這是特定硬體與引擎的量測結果。
該測試的 NVFP4 路徑先以低位元格式搬運權重,再反量化計算。當瓶頸是記憶體頻寬,減少搬運量就可能抵銷反量化成本。這是推論效率改善,不能解讀成硬體原生算力增加。
品質抽查中,兩種格式在 AIME 2026 都完成並答對 23/30 題,各有 7 題被輸出上限截斷。兩邊共同完成的 22 題答案一致,但答案一致不代表逐 token 的思考過程相同,也不能延伸成量化完全不損失品質。
本地部署怎麼開始?先讓短任務與工具呼叫跑通
先選權重格式與執行工具。桌面試用可從 GGUF 與 Ollama、llama.cpp 相容工具開始,伺服器則參考官方 vLLM 或 SGLang 範例。還不確定差別,可先看 本地大模型推論框架比較。
下載時認明 原始模型庫、官方 GGUF與 官方 NVFP4。另有 AtomicChat 的 GGUF 轉換版本可比較,請記錄實際檔名與量化等級,同樣寫 Q4 不表示所有檔案與執行結果完全相同。
測試時先縮短上下文、一次處理一個請求,確認記憶體與基本輸出正常,再逐步拉長。官方雖提供延伸到約 1M token 的設定,卻也提醒長上下文縮放可能影響一般長度的品質,不必第一次啟動就把視窗開到最大。
接代理前,再測試工具名稱、參數、工具結果回傳,以及模型能否繼續下一步。模型能輸出 tool_calls,只代表這段格式可用,MCP 伺服器還需要由代理程式接上。純聊天成功,不能代替完整工具流程驗收。
最後設定整個任務的時間、輸出與重試上限,並檢查所用引擎是否支援獨立思考額度。只縮小總輸出上限,可能更早截斷最終答案。日常試用可先用幾個有明確驗收條件的小任務,比較完成時間、人工修正量與失敗原因,再決定是否放入長時間自動化工作。
授權與手機部署,哪些說法還要保留?
T客邦的發布報導有助於了解系列定位,但授權敘述與官方 metadata 不一致。
本文以官方模型頁標示的 MIT 為準。
同樣地,9B-Mobile 支援行動裝置的宣稱,不能保證每一款手機都有足夠可用記憶體、支援對應模型格式,或能維持長上下文。先確認使用的 App、量化檔與裝置條件,比直接照搬桌面版的速度數字有用。
常見問題
Ornith 1.5 35B-A3B 是只有 3B 參數嗎?
不是。它是 35B 級 MoE 模型,每個 token 約啟用 3B 參數。儲存與載入仍需考慮完整權重,以及快取和引擎額外用量。
Ornith 1.5 放在本地使用會自己越來越聰明嗎?
官方的自我改進是訓練流程。下載後一般執行推論,不會因為聊天次數增加就自動更新模型權重。
24GB 顯示卡一定能跑 35B 的完整上下文嗎?
不能保證。官方 Q4_K_M 檔約 20.22GiB,還需預留引擎與快取空間。應從短上下文實測,再逐步調整。
Ornith 1.5 和 Qwen3.8 27B 該選哪個?
先用自己的任務比較。公開 Benchy 案例中 Ornith 生成較快,Qwen 通過較多項目。這組結果只適用於該測試條件。
這是美國團隊所推出的模型
Ornith 支援工具呼叫,就能直接連 MCP 嗎?
還需要代理程式與 MCP 連接層。應測試參數格式、工具執行與結果回傳的整個流程。
先看能否完成你的工作,再看分數有多高
Ornith 1.5 值得研究的地方,是它把練習題、工具安排與解法放進同一條訓練流程。而對本地使用者來說,35B-A3B 的實際價值仍要靠任務驗收:能不能在現有記憶體內跑穩、工具是否接得上,以及等待之後有沒有拿到可用成果。
先挑幾個你每週真的會做的工作,讓 Ornith 與現有模型各跑一次。保留設定、耗時與失敗紀錄,往往比看一張總排名更容易做出選擇。若想了解前述測試工具的設計,可再看 Benchy 測試工具建置說明。
by Rain Chu | 9 月 16, 2026 | Docker, MIS
學 Docker 時,很容易先記住一串指令,等到遇上「明明 build 成功,服務卻沒有更新」,才發現還有一些觀念需要釐清。
這篇從一條常見的建置指令出發,記錄映像、標籤、建置範圍與快取的關係,再整理部署時值得注意的七件事。範例使用通用的 Python API 專案名稱,方便套用到自己的環境。
一、先看懂這條指令
假設專案根目錄叫做 my-project,在該目錄執行:
docker build -t demo-api:1 -f api/Dockerfile .
| 指令片段 | 意義 |
|---|
docker build | 依照 Dockerfile 建立映像 |
-t demo-api:1 | 將映像命名為 demo-api,標籤設為 1 |
-f api/Dockerfile | 指定要使用的 Dockerfile |
. | 以目前目錄作為建置範圍,也就是 build context |
docker build:依照配方製作映像
Dockerfile 描述建置步驟;image(映像)是產物;container(容器)則是由映像建立、可以啟動的執行個體。
常見指令包括:
FROM:選擇基礎映像,開始一個建置階段。RUN:在建置過程執行命令,例如安裝套件。COPY:將檔案複製到映像內。CMD:設定容器啟動時預設執行的命令。
映像由多個檔案系統層組成,但不能把「每條 Dockerfile 指令」都當成「新增一層檔案」。例如 CMD、ENV 主要記錄設定;FROM 則引入基礎映像。可參考 Dockerfile 官方說明。
-t demo-api:1:給映像一個容易引用的名稱
demo-api 是映像名稱,1 是 tag(標籤)。標籤由使用者自行命名,Docker 不會因為寫了 1,就自動幫你維護版本歷史。
如果再次使用同一標籤建出不同映像,demo-api:1 會改為指向新映像。舊映像若沒有其他標籤,可能顯示為 <none>;若仍被容器引用,就不能直接當作可清除的垃圾。
已存在的容器不會因為 tag 改指向新映像,就自動換版本。
實際發布時,可以改用 demo-api:1.0.1 這類明確標籤,並約定不覆寫已發布版本,讓追蹤與回復更容易。標籤本身是可變的引用,詳見 Docker image tag。
-f api/Dockerfile:選擇配方的位置
在本文這種本機目錄建置方式中,未指定 -f 時,Docker 預設使用 context 根目錄下的 Dockerfile。
-f api/Dockerfile 表示使用子目錄內的檔案,不代表把 build context 改成 api/。
.:決定 COPY 能從哪裡拿檔案
假設專案包含以下內容:
| 路徑 | 用途 |
|---|
api/Dockerfile | 建置配方 |
api/main.py | API 程式 |
api/requirements.txt | Python 套件清單 |
shared/ | 共用模組 |
compose.yaml | 服務設定 |
.dockerignore | 建置時要排除的檔案 |
Dockerfile 可以寫:
COPY api/main.py /app/main.py
COPY shared/ /app/shared/
這裡一般 COPY 的來源路徑,是從 build context 根目錄算起,不是從 Dockerfile 所在的目錄算起。COPY --from 則是另一種情境,可從其他階段或指定來源複製。
因此,在專案根目錄執行:
docker build -t demo-api:1 -f api/Dockerfile .
如果已經進入 api/,也可以明確把 context 指回上一層:
docker build -t demo-api:1 -f Dockerfile ..
重點是最後的路徑包含哪些檔案。詳見 Build context。
二、建置與部署時要注意的七件事
1. 控制 context 大小,避免帶入不需要的檔案
專案裡可能放著資料集、備份、套件目錄與環境設定。這些東西通常不需要拿來建置。
可以在 context 根目錄放入 .dockerignore:
.git/
.env
.env.*
!.env.example
.venv/
node_modules/
**/__pycache__/
**/*.pyc
data/
backups/
*.tar
*.tar.gz
請依專案調整:如果建置真的需要 data/ 中的檔案,就不能整個排除。
現代 Docker 常使用 BuildKit,能跳過未使用的檔案,並減少重複傳輸。因此,「整個目錄一定會先全部打包送出」並不是通用的描述。但明確排除無關檔案,仍能減少負擔,也避免 COPY . . 把環境設定或備份帶進映像。參考 BuildKit 與 .dockerignore 說明。
2. 安裝套件可能需要網路,離線部署要事先準備
以下建置步驟通常需要連到套件來源:
RUN apt-get update \
    && apt-get install -y --no-install-recommends curl \
    && rm -rf /var/lib/apt/lists/*

RUN pip install --no-cache-dir -r requirements.txt
基礎映像若尚未存在,也可能需要下載。使用內部套件庫或已備妥的離線套件時,做法則會不同。
若部署環境無法上網,一種常見方式是在可上網、且目標平台相容的準備機建好映像,再匯出:
docker image save -o demo-api_1.tar demo-api:1
把檔案搬到目標主機後載入:
docker image load -i demo-api_1.tar
save 和 load 處理的是映像;Compose 設定、環境變數、掛載檔案與資料庫資料,需要另外準備。若有多個服務,也要備齊各服務使用的映像。參考 docker image save 與 docker image load。
此外,同一份 Dockerfile 在不同日期重新建置,不一定得到完全相同的套件。需要可重現的版本時,應管理套件鎖定檔、基礎映像 digest 與建置來源。參考 Docker 建置最佳實務。
3. Cache 能加速建置,但不會主動檢查套件是否更新
Docker 會依指令、前面的建置狀態與相關輸入,判斷是否能重用快取。
以常見的單階段 Dockerfile 為例,調整順序可以減少重做的工作:
WORKDIR /app

COPY api/requirements.txt ./requirements.txt
RUN pip install --no-cache-dir -r requirements.txt

COPY api/main.py ./main.py
COPY shared/ ./shared/
這樣只修改程式碼時,前面的套件安裝步驟通常仍能使用快取;修改套件清單時,才需要重新安裝。參考 快取最佳化。
但 RUN apt-get update ... 或 RUN pip install ... 若命中快取,就不會實際執行,也不會上網確認是否有新版。一般 COPY 的內容或相關檔案中繼資料改變,則可能讓快取失效;只改檔案修改時間並不足以觸發。參考 快取失效規則。
需要停用建置快取時:
docker build --no-cache -t demo-api:1 -f api/Dockerfile .
如果也要嘗試更新基礎映像,可加上 --pull:
docker build --pull --no-cache -t demo-api:1 -f api/Dockerfile .
--no-cache 與 --pull 用途不同。另外,Dockerfile 裡的 pip --no-cache-dir 只控制 pip 的下載快取,不會關閉 Docker 的建置快取。Docker 旗標可參考 Buildx build 說明。
4. 定期看磁碟使用量,再決定清理範圍
多次建置後,可能累積舊映像與 build cache。因為映像之間可以共享層,磁碟占用不一定是每建一次就增加一份完整映像大小。
先查看:
docker system df
docker image ls
若要清除未被容器引用的 dangling 映像,可以執行:
這個命令會先要求確認;加上 -f 才會省略確認。-a 會把清理範圍擴大到所有未被容器引用的映像,包含有標籤、可能留作回復用途的版本。
映像清理也不等於清空 build cache,不必把兩者混為一談。參考 docker image prune 與 Build cache 管理。
5. Build 成功後,還要讓服務使用新映像
假設 compose.yaml 中有以下服務:
services:
  api:
    image: demo-api:1
    ports:
      - "127.0.0.1:8000:8000"
此設定假設應用程式在容器內監聽 0.0.0.0:8000,並將主機端連線限制在本機。api 是 Compose 服務名稱,demo-api:1 是映像名稱,兩者用途不同。
建置完成後,在 Compose 檔案所在目錄執行:
Compose 偵測到映像或設定變更時,通常會重建容器。如果希望明確要求重建,即使沒有偵測到變更,也可以用:
docker compose up -d --force-recreate api
所以,--force-recreate 是強制重建的選項,不是更新映像唯一的方法。參考 docker compose up。
docker compose restart api 則是重新啟動既有容器,不能用來切換到剛建好的映像。參考 docker compose restart。
重建之前,也要知道資料放在哪裡:
| 資料位置 | 重建容器時要注意的事 |
|---|
| 容器可寫層 | 刪除舊容器時,裡面的資料會一併失去 |
| 具名 volume | 重新掛載相同 volume 可沿用資料;刪除 volume 另當別論 |
| 主機 bind mount | 資料保留在主機路徑,需確保仍掛載相同位置 |
| 外部資料庫或儲存服務 | 需確認連線設定及新版程式的資料相容性 |
沒有掛載 volume,不代表重建一定安全。 上傳檔案、SQLite 或日誌若只存在容器內,就可能遺失。參考 Docker 儲存說明。
更新後可查看:
docker compose ps
docker compose logs --tail=100 api
接著實際呼叫 API 或檢查健康狀態。容器正在執行,與應用程式已正常提供服務,是兩件需要分別確認的事。
6. 搬映像之前,確認 CPU 架構
常見平台包括 linux/amd64(一般 x86-64 主機)與 linux/arm64(ARM64 主機)。
未特別指定時,建置平台通常跟隨 builder 的預設平台。不同架構的單一平台映像,不能假設能在另一台主機原生執行。
可以先檢查映像:
docker image inspect demo-api:1 --format '{{.Os}}/{{.Architecture}}'若 builder 已具備跨平台建置能力,可明確指定目標:
docker buildx build --platform linux/amd64 --load -t demo-api:1 -f api/Dockerfile .
這裡 --load 會將單一平台建置結果載入本機映像儲存區。跨平台的 RUN 步驟可能需要模擬器、原生節點或其他支援,基礎映像與套件也必須支援目標平台。
遇到 exec format error 時,架構不符是排查方向之一,也要檢查執行檔與腳本格式。跨平台原理與前提可參考 Multi-platform builds。
7. 建置時做基本自檢,讓問題早點出現
假設程式需要 requests 套件與 curl 指令,可以在安裝完成後加入:
RUN python -c "import requests" && command -v curl
這種自檢可以提早發現套件漏裝或命令不存在。命令回傳非零狀態時,該次建置會失敗。
但自檢只能涵蓋實際檢查的項目,不能保證部署環境中的資料庫、網路、權限或完整功能都正常。建置時也應避免匯入會立刻連線正式服務的模組。
還有一個容易忽略的地方:這次 build 失敗,之前的同名映像可能仍然存在。 不要只看 docker image ls 有沒有該 tag,就認為這次建置成功。
三、把日常更新整理成固定步驟
以下假設位於專案根目錄,使用前面的 Compose 設定,而且既有容器也是由同一個 Compose 專案建立。
先建置:
docker build -t demo-api:1 -f api/Dockerfile .
確認成功後,再更新服務:
查看狀態與日誌,再驗證實際功能:
docker compose ps
docker compose logs --tail=100 api
如果使用 Bash 自動串接建置與更新,可以使用 &&,確保前一步成功才繼續:
docker build -t demo-api:1 -f api/Dockerfile . && docker compose up -d api
若原本使用 docker compose -p demo ... 指定專案名稱,後續操作也要維持相同的 -p demo,避免操作到另一組服務。
這次學習後,我會在每次更新時依序確認:建置用了哪些檔案、產出了哪個映像、服務是否已使用新映像,以及資料是否放在能持續保存的位置。把這幾件事分開檢查,就比較容易找出更新流程卡在哪一步。
by Rain Chu | 9 月 16, 2026 | Raspberry Pi, RaspberryPI, 硬體
在網路上看到一個很適合小朋友們學習機器人的專案,想推薦給大家,要把 AI 放進機器人,和在電腦上跑一個聊天模型,是兩種很不同的實作。程式可以重新執行,但舵機方向裝反、電壓接錯,或姿態感測器固定不牢,機器人不會靠多問幾次提示詞就自己修好。
Microduck 是一個小型雙足機器人專案,透過 3D 列印結構、Dynamixel 舵機、姿態感測器與預先訓練的行走策略,將模擬中的控制能力帶到實機。AI-FanGe 整理的建置版本提供原始碼與預建系統映像,讓第一次組裝不必同時從零處理作業系統、依賴套件和強化學習訓練。
我認為這個專案最適合拿來學習的,是機械、電控、感測與模型之間怎麼配合。先把同一個版本穩定復刻,再談換舵機或增加功能,會比一開始就把所有零件都改成便宜替代品更容易成功。
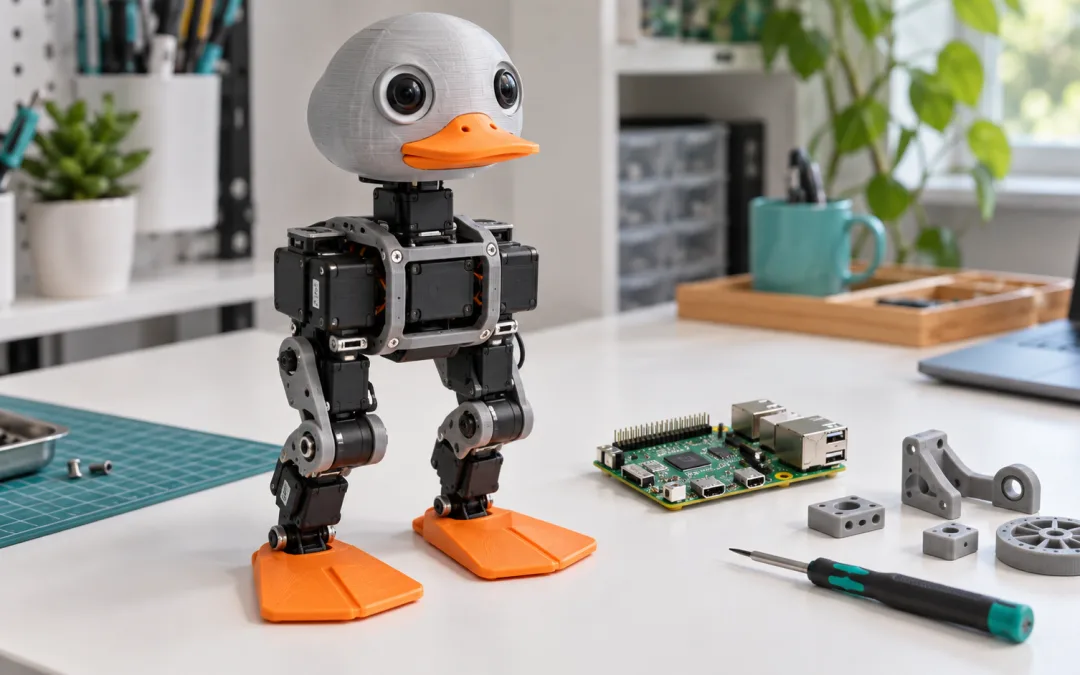
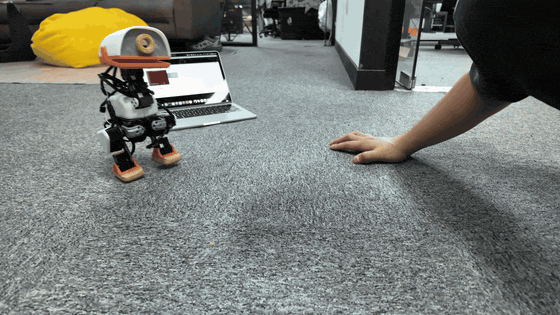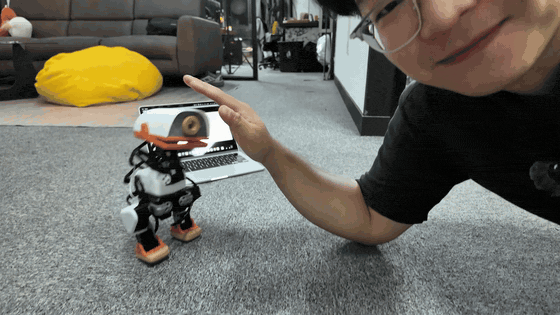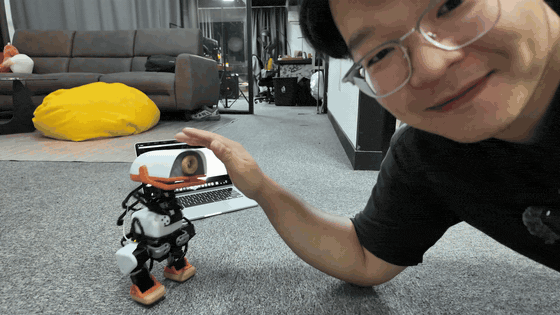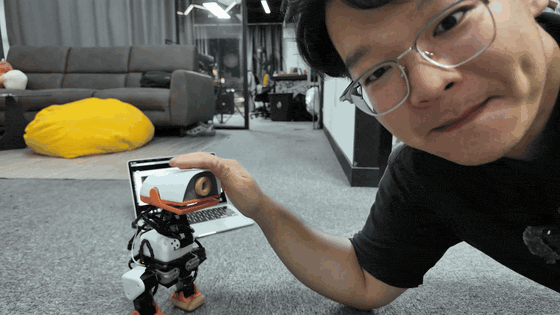 實機展示素材來自 AI-FanGe 教學專案,不是本文自行組裝的測試成果。封面另為 AI 生成概念圖,不作為零件外觀或接線依據。
先看懂架構:Pi 負責推論,舵機負責動作
Microduck-build-tutorial把軟體分成兩個主要目錄。microduck/是在 Raspberry Pi Zero 2 W 上執行的部署程式,mjlab_microduck/則是 MuJoCo/MjLab 強化學習訓練環境。兩者不要混為一談。
- 感測:IMU 提供姿態與角速度,舵機回報關節狀態。
- 指令:鍵盤或藍牙手把提供前進、後退與轉向需求。
- 推論:Pi 載入
walk.onnx,根據目前狀態與指令產生關節目標。
- 執行:Pi 經 USB 連到 OpenRB-150,再透過 Dynamixel 通訊總線控制舵機。
- 回授:下一輪讀取新的姿態與關節狀態,持續修正動作。
這裡的 AI 是行走控制策略,不是大型語言模型在即時逐句指揮每一顆馬達。預建映像已包含策略,第一次復刻不需要先訓練。若之後改變結構、重量或致動器特性,才需要重新評估原本模型能不能沿用。
本次復刻的範圍是運動模組,不包含攝影機與語音對話。會走路、會轉頭,不代表已經能看懂環境或和你聊天,這些功能需要另外加上感測硬體與軟體。
想比較不同開源機器人的學習方向,可以接著看站內的 HopeJR 機器人與手臂控制介紹。機械操作與雙足步態的目標不同,但都需要把感測、驅動與控制策略一起考慮。
採購前先對版本,別把兩份 BOM 混在一起
截至 2026 年 9 月 8 日查核,這份教學採用 Pi Zero 2 W 與 OpenRB-150。完整機械配置可裝 15 顆舵機,但目前 README 與行走程式實際控制的是 14 顆 XL330-M288-T,對應雙腿 10 顆、頭頸 4 顆。嘴部 ID 15 是額外的開合關節,不是目前行走策略必要的關節。採購時先決定是否要裝嘴部,別把「15 顆機械結構」誤認為「行走模型一定需要 15 顆」。
但 microduck/docs/bom.md仍可看到包含 19 顆舵機、RPI Robot HAT 與另一種電池配置的資料。這代表文件中存在不同配置,不能拿舊清單的數量、電源接法與目前部署程式隨意拼在一起。本文以本次教學的根目錄 README 與目前程式為主。
| 零件 | 數量 | 用途 |
|---|
| Pi Zero 2 W | 1 | 執行控制與行走策略 |
| OpenRB-150 | 1 | 連接舵機通訊總線 |
| XL330-M288-T | 14 + 選配 1 | 雙腿 10、頭頸 4、嘴部 1 |
| BNO08x IMU | 1 | 量測姿態與角速度 |
| microSD | 1 | 16GB 起,32GB 較寬裕 |
| 3D 列印結構件 | 1 套 | 依本版本模型製作 |
| 供電與開關 | 1 套 | 電壓、電流另行核對 |
| 螺絲與線材 | 依裝配 | 固定、通訊與供電 |
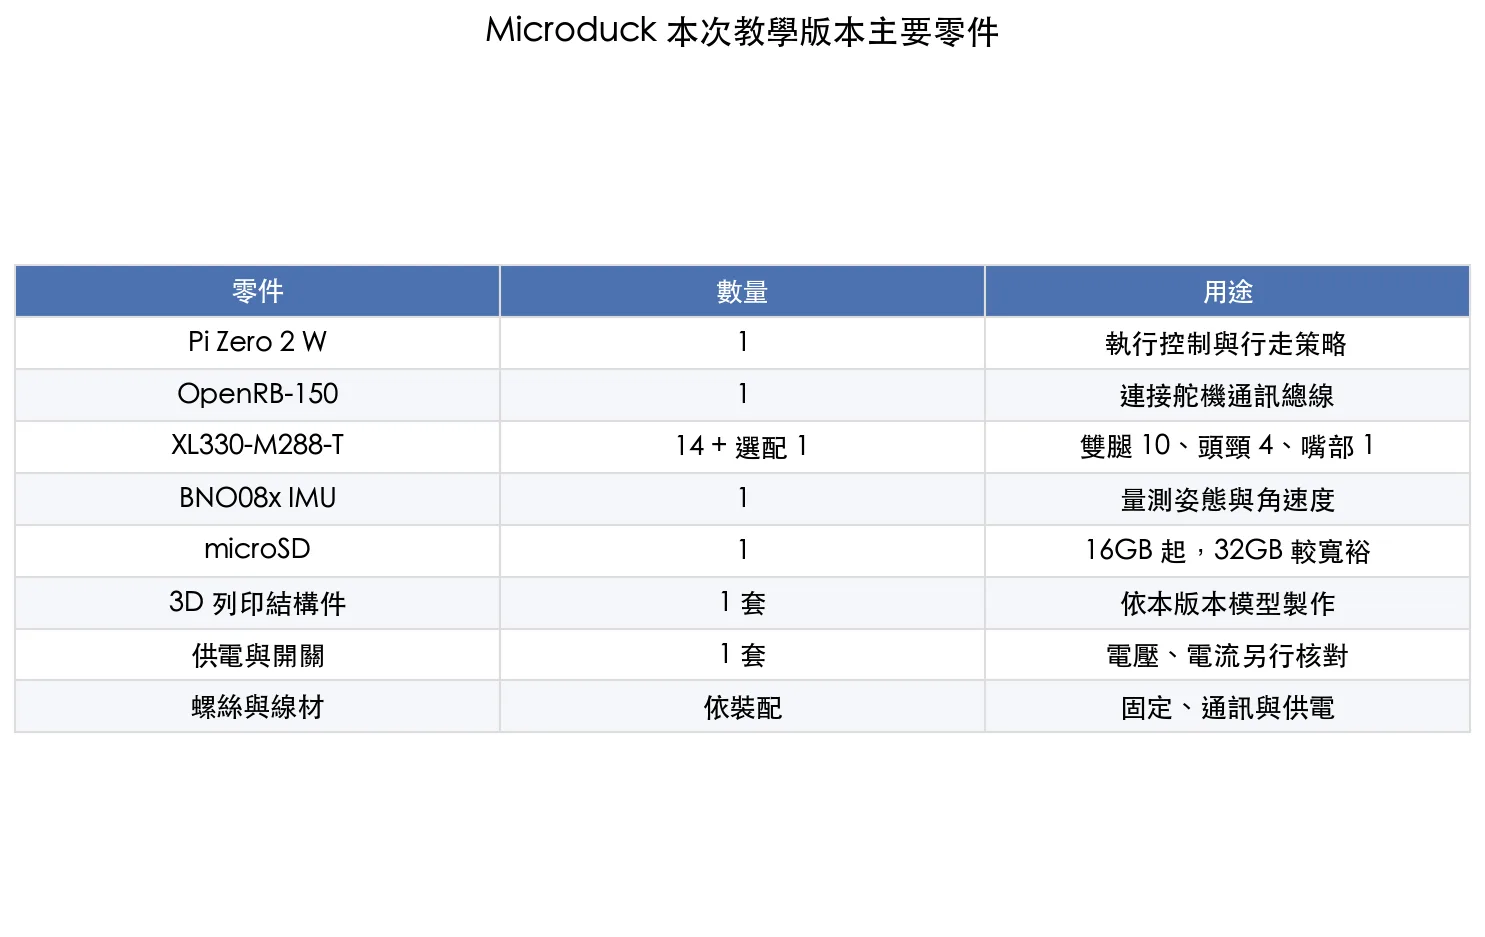 主要零件速查,數量依本次教學配置,不是所有 Microduck 版本通用的採購單。
另外還需要能進行列印或代印的管道、合適螺絲起子、電表,以及必要的線材處理工具。電池、穩壓、保險與線徑不能只照名稱採購,必須依實際電壓、峰值電流與接頭規格確認。
舵機為什麼不能只看價格,直接換成便宜的?
DIY 不一定比買成品便宜,尤其多顆智慧舵機容易成為主要支出。除了馬達本身,還要計入列印失敗、接頭、工具、運費與備品,因此我不會把不同版本、不同地區的舊價格直接加總,當成今天一定能買到的總預算。
替代舵機需要比對的,也不只是扭力。外殼尺寸、固定孔、輸出軸、重量、速度、間隙、通訊協定、回授資料與控制延遲都可能不同。機械上裝得進去,不代表控制程式相容,更不代表原本的行走策略還能保持平衡。
如果真的要更換,應先確認結構能否固定,再處理驅動介面與關節校正,接著檢查模擬中的致動器參數,必要時重新訓練。並非每次更換都必須從零重做,但也不能預設只改一個型號名稱就能走。若只是想先學機器人組裝,也可以參考站內的 Pupper 開源機器狗實作,比較四足與雙足平台的學習需求,舊文價格則不應當作目前報價。
下載原始碼與列印檔,先完成不通電的裝配
原始碼可從 GitHub 專案頁下載 ZIP,或在開發電腦使用 Git。這一步只取得檔案,不會操作機器人。
git clone https://github.com/AI-FanGe/Microduck-build-tutorial.git
cd Microduck-build-tutorial
根目錄提供 microduck3D打印.3mf,microduck/cad/也有 CAD 相關檔案。先確認檔案與目前採用的裝配版本一致,不要把不同版本的腿、頭部與電源艙混印。PLA 可以作為起點,但方向、支撐、孔位與配合公差仍須依實際零件確認。
- 先整理左右腿與頭頸零件,確認沒有鏡像裝反。
- 檢查螺絲長度,避免頂住舵機內部或穿透結構。
- 預留關節活動所需線長,但不要讓線材垂進齒輪或夾點。
- 先對好舵機中立位置與零點,再固定輸出端,不能只憑外觀鎖緊。
- 首次通電前再確認所有固定件、極性與絕緣,調整接線時先斷電。
組裝可以分成腳部與左右腿、軀幹支架、頸部、頭部,再合體整理線材。先鎖好之後會被其他零件擋住的螺絲孔,再裝覆蓋其上的舵機。從動盤與支撐環也要檢查轉動阻力,不能用過度鎖緊來換取表面上的穩固。電池尺寸與控制板位置會影響空間和重心,別以強塞方式固定。
供電是最重要的關卡,不要靠關閉保護解決問題
教學 README 寫的是成品 6V 電池方案,但「標示 6V」不代表充飽後、空載時或負載變化時都恰好是 6.0V。必須量測實際輸出,並確認整條供電路徑符合零件規格。
依 ROBOTIS XL330-M288-T 原廠文件,輸入範圍為 3.7 至 6.0V,建議電壓為 5.0V。不要把超過上限的電池直接接到 XL330,也不要為了讓機器繼續動就取消輸入電壓錯誤保護。如果電壓不穩,應先處理電源、線材與負載問題。
另外,OpenRB-150 原廠規格的板子輸入範圍,不等於舵機也能承受同樣電壓。原廠也列出 DYNAMIXEL 埠電流限制,14 顆舵機同時動作時,不能假設一條 USB 線或板載電源路徑一定足夠。Pi 應有穩定的 5V 供電,舵機電源、分配方式與共地則要依控制板文件設計,不能把板上的小電流 5V 腳當成整機電源。
這次實作的關鍵,是把舵機的大電流供電與控制板通訊分開,舵機有獨立的配電路徑,Pi 則由穩壓後的 5V 供電。這與 README 中較簡化的電源流程描述並不完全相同,因此不能只看總線連線就認定所有電力都經過 OpenRB。若採外部舵機配電,須核對 VDD 隔離、共地、線徑與保護,不讓外部電源反灌控制板,也不要照著線色猜接法。
程式中的電壓模型參數也不是硬體額定值,不能看到模擬常數就照著供電。沒有電路與電池經驗時,先請熟悉硬體的人檢查,不建議把自行製作電池組當成第一次實作。測試時使用支架或安全吊掛,手指遠離活動關節,並保留能立即切斷動力的方式。
設定舵機 ID 與 IMU,讓軟體認得實際裝配
舵機最好在正式串接前逐顆設定與標記。OpenRB-150 可以搭配 DYNAMIXEL Wizard 2.0,原廠預設提供 usb_to_dynamixel韌體。若板子曾被改刷其他程式,需先確認它仍處於可用的 USB 通訊橋接模式。
目前教學使用 Protocol 2.0 與 1Mbps。ID 必須和程式一致,線在總線上的實際排列不等於 ID 會自動依序產生。
在 Wizard 中先只接一顆舵機,Scan 找到裝置後設定 ID 與通訊速度,再依目前設定核對 Return Delay Time。確認周圍無干涉後,才啟用扭矩讓它回到中立位置,接著斷電再裝配。未設定的舵機可能都是相同 ID,一次全部串上會難以分辨。不要把操作示範中的保護關閉動作視為必要步驟。
- 右腿 ID 1 至 5:右踝、右膝、右髖俯仰、右髖橫滾、右髖偏航。
- 左腿 ID 6 至 10:左踝、左膝、左髖俯仰、左髖橫滾、左髖偏航。
- 頭頸 ID 11 至 14:頭部俯仰、頸部俯仰、頭部偏航、頭部橫滾。
- ID 15:選配嘴部,不能假設目前行走程式會驅動它。
IMU 使用 BNO080/BNO085/BNO086 系列模組,依模組標示確認電源,I2C 的 SDA 對應 GPIO2,SCL 對應 GPIO3。安裝方向與固定方式會影響姿態解讀,不能把感測器旋轉後仍沿用未確認的設定。
目前 constants.py還包含右膝與左膝的相反方向零點偏移,這些是特定裝配的校正,不是通用數值。若一啟動就往奇怪方向扭,先停機檢查 ID、零點、方向與 IMU,不要靠提高增益硬撐。
系統安裝:使用預建映像,先跑通第一次開機
1. 從正式 Release 取得映像
先到 image.v1 發布頁,下載 microduck.img.xz。這是教學作者提供的第三方映像,不是 Raspberry Pi 官方原版映像,寫入前應確認來源。
下載完成後計算 SHA256。macOS 使用第一段,Linux 使用第二段。
shasum -a 256 microduck.img.xz
sha256sum microduck.img.xz
本次查核 image.v1 資產的 GitHub SHA256 為下列值。未來若作者重新發布檔案,應以當次 Release 的值為準。校驗一致代表檔案符合發布資產,不等於已完成安全稽核。
096885dc32fb5b1db2ad69ba6bea868d8ab988f2b47c0d884eb63ba0dfdcb5c4
2. 寫入 microSD
安裝 Raspberry Pi Imager,裝置選 Raspberry Pi Zero 2 W,作業系統選自訂映像,再指定剛下載的檔案與 microSD。寫入會清除所選儲存裝置,務必確認不是電腦內部磁碟。
這份自訂映像的教學要求在 OS customization 提示選擇 No,使用它自己的初始化方式。不要把這個做法誤套成所有 Raspberry Pi 映像都應該關閉自訂設定。寫入與驗證完成後,才把卡放進 Pi。
3. 連上 2.4GHz Wi-Fi
Pi Zero 2 W 的無線網路是 2.4GHz。可依 README 在 bootfs 的 network-config修改 Wi-Fi,或接上 mini HDMI 螢幕與鍵盤,在 Pi 終端設定,鍵盤需要合適的 USB OTG 轉接。第一次啟動需要等待分區擴展完成,期間不要隨意拔電。
使用本次映像的預設帳號 user與密碼 password登入後,立刻執行 passwd換掉預設密碼。不要把 SSH 直接開放到公網。下面命令是在 Pi 上執行,依 nmcli 官方說明,--ask會互動詢問 Wi-Fi 密碼,避免將密碼直接寫在命令列。
passwd
nmcli device wifi list
sudo nmcli --ask device wifi connect "你的WiFi名稱"
hostname -I
先查看連線設定名稱,再將實際使用的設定開啟自動連線。下列的名稱是連線設定名稱,不一定和 Wi-Fi 名稱完全相同。
nmcli -f NAME,TYPE,AUTOCONNECT connection show
sudo nmcli connection modify "你的連線設定名稱" connection.autoconnect yes
如果平常用的是 wpa_cli 管理 Linux 無線網路,這裡要留意工具不同。本次映像的教學使用 NetworkManager/nmcli,不要在沒有確認管理方式前,混用另一套設定流程。
4. 從電腦用 SSH 連線
ssh [email protected]
若名稱找不到,到路由器查看 Pi 的 IP,再改用該 IP 連線。若出現主機金鑰變更警告,先確認是不是自己重新刷過同一台 Pi,並核對裝置,不能遇到警告就直接刪除紀錄繼續。
首次執行:先會停止,再讓它走
先將機器人安全支撐,確認關節周圍沒有人手。程式開始時就會啟用扭矩並回到中立姿態,不是等你按前進才會動。也不要同時啟動多個控制程式爭用舵機總線。
以下是在 SSH 登入 Pi 後執行的命令。預建映像已提供部署目錄、虛擬環境與行走模型。
cd ~/microduck
PYTHONPATH=src .venv/bin/python src/main.py
v:切換行走。- 方向鍵上/下:前進與後退。
- 方向鍵左/右:轉向。
x:速度指令歸零,不是硬體急停。i:顯示或隱藏 IMU 資訊。q:結束控制迴圈。
需要從另一個 SSH 視窗要求停止時,使用以下命令。它是軟體停止機制,不應取代測試區的實體斷電措施。
cd ~/microduck
PYTHONPATH=src .venv/bin/python src/stop.py
一般結束使用,先停止控制並支撐好機器人,再正常關閉 Pi。等待關機完成後,才關閉主電源。若有冒煙、異味或機構卡死等危險狀況,應立即切斷動力,不要為了正常關機而延誤。
sudo shutdown -h now
藍牙手把模式:為什麼一連上就斷 SSH?
預建映像包含無頭手把服務,可以不開電腦終端就啟動控制。第一次配對,可在 Pi 上開啟 bluetoothctl,再執行下列互動命令,把範例 MAC 換成掃描到的手把位址。
bluetoothctl
power on
agent on
scan on
pair XX:XX:XX:XX:XX:XX
trust XX:XX:XX:XX:XX:XX
connect XX:XX:XX:XX:XX:XX
scan off
quit
配對前先讓手把進入配對模式,看到確認要求時核對裝置後再接受。不同手把的按鍵映射可能不同,以下以本次教學的映射為準。
- 按住 START 約 2 秒:啟動控制迴圈。
- A:切換行走。
- 左搖桿:前後與左右速度。
- 右搖桿左右:轉向。
- B:停止控制迴圈。
- 同時按住左右扳機約 2 秒:要求正常關機。
這個版本的背景服務會在手把連線後關閉 Wi-Fi,以改善 2.4GHz 藍牙連線穩定性。因此 SSH 中斷不一定是 Pi 當機,先關閉手把,等 Wi-Fi 恢復後再連線。這是本專案的服務設計,不是所有 Raspberry Pi 藍牙連線都會這樣。
常用維護命令:分清楚在電腦還是 Pi 執行
前面的 Python 命令是在 Pi 上跑。下面的 Makefile 命令則是在開發電腦的 Microduck-build-tutorial/microduck目錄執行,需要可用的 make、rsync 與 SSH 環境,Windows 使用者可採 WSL。明確指定 [email protected],避免預設 SSH 別名或帳號不符。
cd Microduck-build-tutorial/microduck
make sync [email protected]
make voltage [email protected]
make imu [email protected]
make sync會把本機程式同步到 Pi,因此只應在確認本機版本正確、已備份 Pi 上個人修改後使用。部分檢查目標也會先同步,不是完全不改動遠端檔案的只讀診斷。若只是第一次使用預建映像,先用前面的 SSH 操作即可。
修改依賴後,才執行以下同步與依賴更新命令。
make setup [email protected]
需要啟動控制時,先做好安全支撐,再執行下面這一行。它會先同步程式,接著讓機器人進入控制流程。
make run [email protected]
需要停止時,在另一個終端機執行下面這一行,並注意失去扭矩後機器人可能倒下。
make stop [email protected]
控制停止、機器人已支撐妥當後,才執行正常關機。
make shutdown [email protected]
訓練環境負責產生可部署策略,但重新訓練不是第一次開機的必要步驟。目前匯出腳本產生的檔名為 policy.onnx,部署端則讀取 src/agents/walk.onnx。不能只把任意 ONNX 改名就認為能用,仍須核對觀測、關節順序、動作尺度與模型版本。替換前保存可用的舊模型,再進行受控測試。
遇到問題,先查這四個地方
- 找不到 Pi:確認 2.4GHz Wi-Fi、首次啟動是否完成、路由器是否分配 IP,以及手把服務是否暫時關閉 Wi-Fi。
- 舵機不回應:先檢查供電和極性,再查 OpenRB USB 裝置、韌體、舵機 ID、波特率與插頭。不要帶電拔插舵機線。
- 一啟動就倒或關節扭錯:停止後核對左右腿 ID、膝部零點、關節方向、IMU 固定與安裝方向,別急著換模型。
- 程式無法啟動或總線被占用:先確認背景控制是否已執行,查看服務狀態與日誌,不要用多開程序的方式重試。
在 Pi 上可以用以下命令查看背景服務的狀態與近期日誌。這些命令不會啟動行走。
systemctl status microduck-gamepad.service
journalctl -u microduck-gamepad.service -n 80 --no-pager
常見問題
Microduck 一定要先訓練 AI 才能走嗎?
不需要。本次預建映像包含 walk.onnx 行走策略,第一次復刻先完成裝配、供電、舵機與 IMU 檢查,再使用既有模型。更換硬體或開發新步態時,才進一步評估訓練需求。
這次教學到底需要幾顆舵機?
完整機械配置可裝 15 顆,目前行走程式使用其中 14 顆,雙腿 10 顆、頭頸 4 顆。嘴部 ID 15 為額外關節,採購前先決定是否安裝嘴部,並核對版本。
可以用較便宜的舵機替換 XL330 嗎?
可以研究替代方案,但需要確認結構尺寸、通訊、回授、速度與控制特性。差異可能需要改機構、驅動與模擬參數,甚至重新訓練,不是一定能直接替換。
手把連線後,SSH 斷線正常嗎?
本版本的無頭手把服務會暫時關閉 Wi-Fi,以改善藍牙穩定性。關閉手把後 Wi-Fi 應恢復,可再用 SSH 連線。若沒有恢復,再查看服務日誌。
標示 6V 的電池可以直接接上嗎?
不能只看標稱值。XL330 原廠輸入上限為 6.0V,必須確認充飽與負載變動時的實際電壓,並檢查電流、穩壓與配電能力。不要靠取消電壓保護來處理異常。
我的建議:先把一台做穩,再開始改造
Microduck 讓具身控制不再只是研究論文裡的概念,你可以看到一個姿態讀值如何影響關節命令,也能理解為什麼模擬成功不等於實機一定穩定。但這仍是需要調校的硬體專案,不是刷完映像就保證能走的家電。
先鎖定同一個版本,確認供電與關節,再跑通預建模型。等到站立、停止、行走與關機都能重複完成,再逐步嘗試外觀、動作或訓練上的改變。每次只改一個因素,保留原本能用的程式與模型,除錯會容易得多。
原始資料可從 AI-FanGe 建置教學與上游 Pollen Robotics Microduck繼續閱讀。此整理未經本文作者實機驗證,正式通電前仍須依零件原廠文件檢查。程式庫根目錄與部分子目錄、檔案採不同授權,若要修改散布或商用,應逐項核對,不宜把整個專案一概當成同一授權。
by Rain Chu | 9 月 15, 2026 | Apple, Mac
Mac 空間快滿時,我會先找出到底是哪些資料夾變大,再決定要清快取、移除軟體,還是整理下載過的 AI 模型。
Mole 把這些工作集中在終端機裡,輸入 mo 就能用方向鍵操作,涵蓋磁碟分析、清理、解除安裝、系統維護與即時監控。
對已經使用 Homebrew、Codex 或本地模型的 Mac 使用者,Mole 很適合當作日常維護工具,它能協助回收空間、找出資源占用,但清掉檔案並不代表 CPU 會自動變快。先知道瓶頸在哪裡,才不會刪了一堆快取,最後只是讓軟體重新下載相同資料。
Mole 免費嗎,終端機版和 DMG App 差在哪裡
目前的 Mole GitHub 專案 是免費開源 CLI,採 GPL-3.0 授權。
Mole for Mac 繁體中文官網 提供的是另外一款付費原生圖形介面 App。免費開源的說法應對應 CLI,不能套用到所有同名版本。
CLI 適合用鍵盤操作、希望檢查原始碼,或要把結果交給其他程式處理的人,原生 App 則提供視覺化磁碟樹狀圖、App 管理、選單列狀態等操作介面,對不想開終端機的人更直覺,官方目前標示 App 為一次購買、終身更新,一份授權可用於兩台 Mac,實際價格和條款以購買頁為準。本文以下以免費 CLI 為主。
安裝 Mole,先確認 Homebrew 能使用
按下 Command 加空白鍵,搜尋「終端機」。如果已安裝 Homebrew,先檢查版本,再安裝 Mole。
brew --version
brew install mole
mo --version
mo
還沒裝 Homebrew,可以到 Homebrew 官網取得安裝命令。安裝完成後,照終端機顯示的 Next steps 設定環境,再重新開啟終端機。Apple Silicon 和 Intel 的安裝位置可能不同,直接照自己電腦輸出的步驟最穩。
輸入管理員密碼時,終端機通常不會顯示字元或星號,輸入完按 Enter 即可。Mole 只有在操作需要較高權限時才會提出要求,不必把每一條命令都加上 sudo。
第一次使用,我會從 Analyze 開始
先執行磁碟分析,沿著最大的資料夾往下查看。比起直接啟動清理,這一步更容易理解自己的硬碟用在哪裡。
mo analyze
也可以指定範圍,縮小到下載資料夾或外接磁碟。外接磁碟不包含在預設總覽裡,要另外指定。
mo analyze ~/Downloads
mo analyze /Volumes
使用方向鍵瀏覽,需要判斷內容時在 Finder 開啟對應位置。Analyze 內的移除操作會在確認後將所選項目移到垃圾桶,這和部分清理命令的刪除行為不同。要立即回收實際空間,還要考慮垃圾桶是否已清空。操作快捷鍵以畫面下方提示為準。
AI 模型快取很大,但它不一定是垃圾
本地 AI 工作流常會保存多個模型版本、量化格式與下載快取,依照 Hugging Face 官方快取說明,Hub 檔案快取預設位於 ~/.cache/huggingface/hub,設定過 HF_HOME 或 HF_HUB_CACHE 時則可能在別處。可以先用 Mole 查看預設快取的上層資料夾。
mo analyze ~/.cache/huggingface
模型檔值得保留與否,取決於近期是否還會使用,以及重新下載的成本。你可以先列出每個模型的用途,保留常用版本,再逐一移除已淘汰的模型。不同快取版本可能共用檔案,適合搭配模型下載工具自身的管理功能,避免只刪掉某個片段後留下不完整模型。
如果你正在比較 llama.cpp、MLX 與 Ollama 的本地推理方式,要特別留意不同工具可能各自保存權重。整理時先確認模型屬於哪個工具,才知道之後要從哪裡重新取得。
做 ComfyUI 本地影音工作流 時也一樣,模型、輸入素材和生成成果應分開管理。尚未交付的成品有保留價值,不能只因為容量大就把整個輸出目錄視為可刪快取。
Clean 清快取,先看 dry-run 結果
準備清理時,先預覽會處理哪些路徑。需要保留的快取可以加入保護清單,再執行清理。
mo clean --dry-run
mo clean --whitelist
確認預覽內容後,以下命令會實際進行清理。
mo clean
清理範圍包括符合規則的快取、日誌、暫存與已移除 App 的殘留。清理後部分軟體第一次開啟可能要重建快取或重新下載資料,這是規劃清理時間時需要考慮的成本。Mole 的保護規則可以減少誤操作,但仍要自己確認預覽清單是否包含工作需要的資料。
瀏覽器也要分清楚快取和設定。Chrome 擴充功能的存放位置和一般網頁快取用途不同,不要自行把整個 Chrome 使用者資料夾都當成垃圾刪除。
需要追查剛才做了什麼,可以查看操作紀錄。
mo history
mo history --json
Uninstall 移除 App,也檢查相關殘留
不用的軟體可以交給 Uninstall,一起檢查能明確對應到該 App 的相關檔案。先做預覽,確認選取的是正確程式與版本。
mo uninstall --dry-run
確定要解除安裝後,再執行下方命令並選取 App。
mo uninstall
如果 App 本體早已刪除,改用 mo clean 檢查殘留比較合適。同一套軟體的不同版本可能共用資料,所以「完整移除」不能理解成所有相似名稱的資料夾都應一起消失,仍在使用的共用資料需要保留。
Optimize 與 Status,分別處理維護和觀察
遇到縮圖、搜尋或系統服務異常,可以先預覽 Optimize 的維護項目。它會依系統狀況略過不適用的工作,不能把它當成每台 Mac 都會得到相同效果的加速按鈕。
mo optimize --dry-run
確認項目後才執行實際維護,需要排除的工作可用保護設定管理。
mo optimize --whitelist
mo optimize
只想了解目前 CPU、記憶體、磁碟、網路與電力狀態時,用唯讀的 Status 儀表板即可。按 q 可以離開。
mo status
對跑本地模型的人來說,可以在載入模型前後觀察記憶體壓力,再在生成內容時看 CPU 和磁碟活動。如果空間回收了,運算仍然慢,就應繼續檢查模型大小、同時執行的工作與記憶體,而不是反覆清理相同快取。
開發者可以用 Purge 整理專案產物
許多舊專案占空間,是因為 node_modules、target、build 或 dist 長期保留。Purge 會以專案為單位整理候選項目,先設定要掃描的資料夾,再做預覽。
mo purge --paths
mo purge --dry-run
看清楚清單後,實際清理使用以下命令。
mo purge
Purge 會永久刪除你確認的項目。原則上這些產物能重新建立,但自己的專案可能把手工修改內容或唯一成品放進 build 或 dist,所以仍需先核對。清掉依賴後,下一次開發也要重新安裝,應保留套件清單與 lockfile。
下載資料夾裡的舊安裝包則交給 Installer。先確認是否還需要離線重裝,再決定移除。
mo installer --dry-run
以下會進入安裝包的實際移除流程。
mo installer
Mole 常用命令速查
| 工作 | 起手命令 | 使用重點 |
|---|
| 查看空間 | mo analyze | 先瀏覽,移除需確認 |
| 查看狀態 | mo status | 唯讀監控 |
| 清理快取 | mo clean –dry-run | 先預覽,再執行 clean |
| 移除 App | mo uninstall –dry-run | 先確認程式與殘留 |
| 系統維護 | mo optimize –dry-run | 先確認維護項目 |
| 專案產物 | mo purge –dry-run | 正式執行可能永久刪除 |
| 舊安裝包 | mo installer –dry-run | 先確認是否仍需保存 |
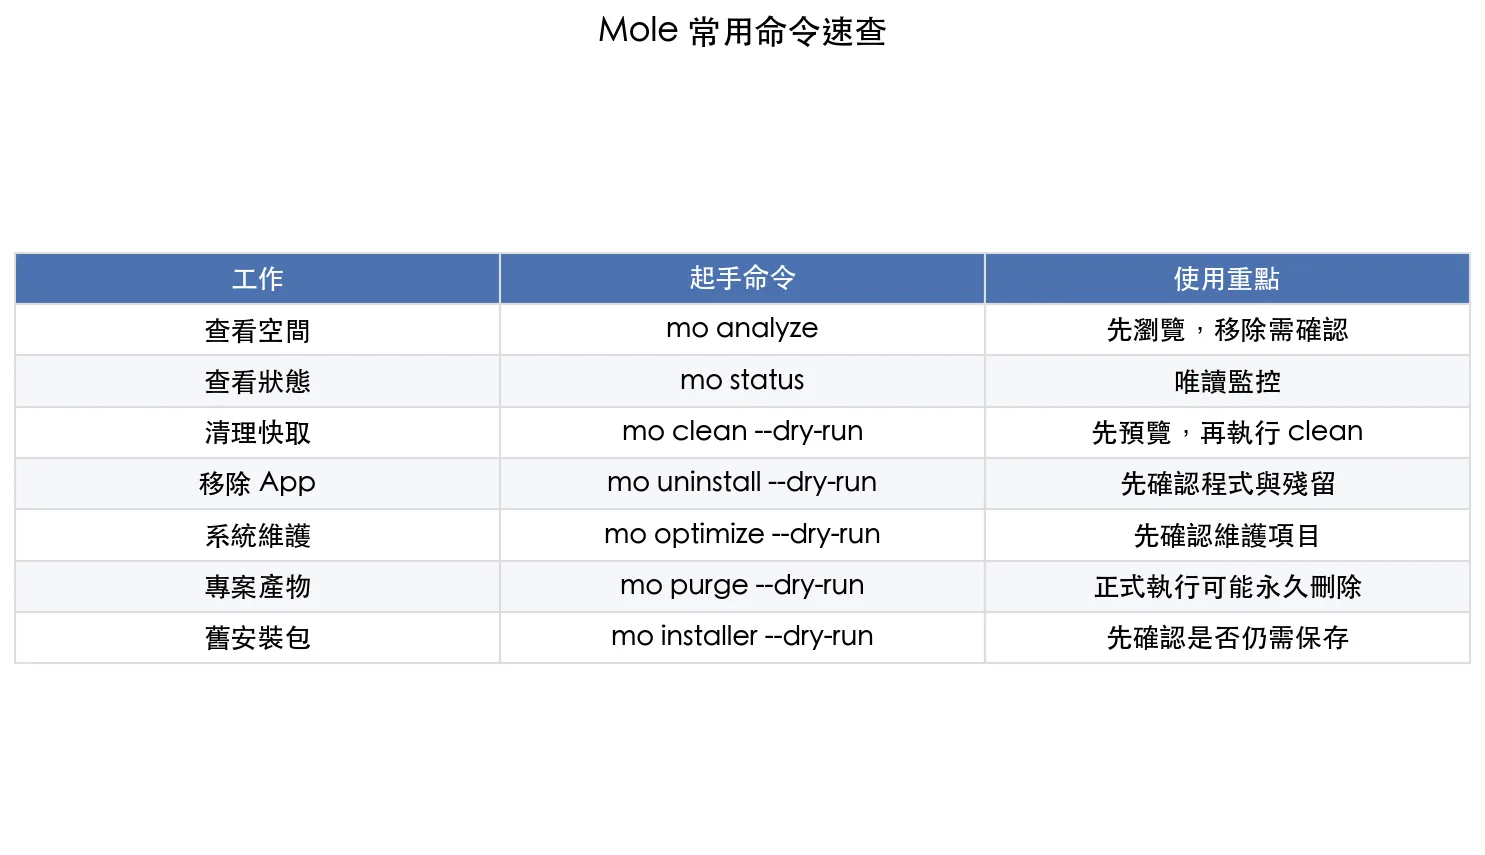 先從查看與預覽開始,再依需要執行對應操作
整合 Raycast,減少每天開終端機的步驟
Mole 官方提供快速啟動器腳本,可以加入 Clean、Uninstall、Optimize、Analyze 與 Status。以下命令請逐行操作,先下載官方腳本,用 less 閱讀內容,按 q 離開閱讀畫面,確認後才執行最後一行。
curl -fsSL https://raw.githubusercontent.com/tw93/Mole/main/scripts/setup-quick-launchers.sh -o setup-mole-launchers.sh
less setup-mole-launchers.sh
bash setup-mole-launchers.sh
- 開啟 Raycast Settings,進入 Extensions 的 Script Commands
- 新增腳本目錄
~/Library/Application Support/Raycast/script-commands
- 執行 Reload Script Directories 重新載入
- 在 Raycast 搜尋 analyze 或 status,開啟相應功能
清理指令仍然會啟動 Mole 本身的操作流程。快速啟動器的價值在於少打字,並不代表能略過對清理範圍的判斷。官方腳本在找到 Alfred 設定時,也會建立對應 workflow。
讓 Codex 協助讀取磁碟報告
Mole 已有 JSON 輸出,適合把資料交給 Codex 整理。可以請 Codex 解釋哪些資料夾占空間,以及哪些是模型、快取、安裝包或專案產物,再由自己決定下一步。
mo analyze --json ~/Documents
mo status --json
mo history --json
可以這樣下提示詞。以下是整理報告的範例,並不會自動開始刪除。
請使用 Mole 的唯讀分析與 JSON 輸出,整理我指定資料夾的空間占用。按模型檔、專案依賴、生成成果與安裝包分類,列出路徑、容量與可能用途。請保留正在使用的模型和唯一成品,先提供清理建議,等我指定項目後再執行刪除。
JSON 報告可能包含使用者名稱與專案路徑。把它交給雲端服務時,就和 Mole 本身在本機掃描是兩個不同的資料處理步驟,可以先限制分析範圍。
更新、移除與常見錯誤
用 Homebrew 安裝的版本,更新時指定 Mole 即可。
brew update
brew upgrade mole
不再需要這個工具時,用原本的套件管理方式解除安裝。
brew uninstall mole
如果用官方安裝腳本安裝,則使用 mo update 更新與 mo remove 移除工具本身。不要把 mo uninstall 和 mo remove 混在一起,前者是管理其他 App,後者是移除 Mole。
遇到 Bundled status binary not found,先確認版本與命令位置。如果原本是 Homebrew 安裝,可用以下方式重新安裝套件,恢復遺失的執行檔。
command -v mo
mo --version
brew reinstall mole
原本使用官方腳本安裝時,依錯誤訊息執行 mo update,或重新執行官方安裝流程。若電腦同時裝了兩個版本,先整理命令搜尋路徑,避免更新了一份,實際卻執行另一份。
FAQ
Mole 可以完全免費使用嗎
CLI 版可以,GitHub 專案採 GPL-3.0 開源授權。原生 Mole for Mac App 是另外的付費產品,兩者的授權和介面不同。
Mole 清理後一定會讓 Mac 變快嗎
不一定。它可以協助回收空間與處理部分維護工作,效能是否改善仍取決於磁碟剩餘空間、記憶體壓力、背景程序和實際工作負載。
Mole 有 Windows 版嗎
主要產品針對 macOS,官方 GitHub 目前另有實驗性的 windows 分支。不要把 Mac 的 Homebrew 命令與清理規則直接套到 Windows,也不要假設兩邊功能完全相同。
Analyze 和 Clean 都會刪除檔案嗎
Analyze 主要供瀏覽分析,選取移除後會確認並移到垃圾桶。Clean 會按清理規則實際刪除資料,第一次操作先使用 dry-run 預覽。
我會怎麼把 Mole 放進日常工作
第一次先跑 Analyze 和 Status,弄清楚容量與資源占用。空間不足時再預覽 Clean,需要移除 App 時用 Uninstall,舊專案交給 Purge。這樣比較容易把每次清理和實際問題對上,也能保留常用模型與工作成果。
我很喜歡 Mole 把路徑、大小與操作結果攤開的方式。對經常下載模型、建立測試專案與輸出影音素材的人,能知道硬碟裡放了什麼,比每次容量不足才四處翻資料夾方便得多。
功能與命令依 Mole 官方文件核對,原生 App 資訊可看 繁體中文官網,清理行為的保護範圍可參考 官方安全說明。
近期留言