by Rain Chu 7 月 28, 2026 | AI , 語音合成
VibeVoice 現在不能只理解成一個文字轉語音模型,它已經變成 Microsoft 的開源語音模型家族,包含長音訊語音辨識、即時串流 TTS、長篇多人 TTS,以及最新的 CPU 量化辨識版本,值得注意的地方,不只是能把文字念出來,而是它開始把「聽懂一小時內容」與「收到文字後立刻開口」做成兩條可以獨立部署的路線。
先講我的結論。如果要做會議轉錄、訪談整理或字幕,先看 VibeVoice-ASR。如果只有一般電腦,優先測試 VibeVoice-ASR-BitNet。如果要讓 Agent 邊產生答案邊說話,選 VibeVoice-Realtime-0.5B,至於能合成 90 分鐘、最多四人對話的 VibeVoice-TTS-1.5B,目前官方快速體驗仍標示為停用,不能把社群整合包的功能直接當成官方現況。
VibeVoice 四個版本怎麼選
模型 主要工作 適合場景 部署重點 VibeVoice-ASR-7B 長音訊轉文字 會議、訪談、字幕、多人對話 可一次處理最長 60 分鐘,完整模型需要較多 GPU 記憶體 VibeVoice-ASR-BitNet CPU 語音辨識 桌機、Mac、邊緣設備、離線轉錄 模型約 1.58 GB,不需要 GPU VibeVoice-Realtime-0.5B 即時文字轉語音 語音 Agent、即時旁白、串流回應 單一說話人,英文為主要目標,其他語言仍屬實驗 VibeVoice-TTS-1.5B 長篇多人語音合成 Podcast、有聲內容、多人對話 原始能力可達 90 分鐘與四位說話人,但官方程式與快速體驗目前停用
VibeVoice 的核心不是單純縮小模型
VibeVoice 使用聲學與語意連續語音 tokenizer,運作頻率只有 7.5 Hz,這代表模型不需要把長音訊展開成極密集的離散 token,處理長序列時比較節省,生成端再用 next-token diffusion,把語言模型負責的文字脈絡與對話流程,交給 diffusion head 補上聲學細節。
這個架構帶來兩個很實際的能力。ASR 可以在 64K token 長度內一次接收最長 60 分鐘音訊,輸出誰在什麼時間說了什麼。
Realtime TTS 則採用交錯的視窗設計,一邊接收新增文字,一邊延續前文產生聲音,讓 LLM 不必等完整答案寫完才開始說話。
如果正在組本地語音 Agent,可以把它放進 speech-to-speech 的 VAD、STT、LLM、TTS 管線 。VibeVoice-ASR 負責聽,Realtime 負責說,中間的 LLM 可以換成本地模型。這比把整套功能綁死在單一 App 裡更容易維護。
ASR 不只是逐字稿,還會分辨說話人
一般 Whisper 工作流常要再接一套 speaker diarization,才能把不同說話人分開。VibeVoice-ASR 把語音辨識、說話人分離與時間戳放進同一個輸出,直接得到 Who、When、What 的結構。對會議記錄、Podcast 整理、客服通話和長篇訪談,這比單純吐出一整段文字更有用。
它也支援自訂 hotwords,可以先提供人名、產品名、技術術語與背景資料,減少專有名詞被聽錯的機率。官方 Transformers 版本支援超過 50 種語言,也能處理語句內與語句間的語言切換。這讓 Python 整合不必依賴特定 WebUI。
VibeVoice 真的比 Whisper 快又準嗎
答案不是單純的「是」,Microsoft 公布的 CPU BitNet 測試中,在 AMD EPYC 7V13 上使用三條 CPU 執行緒時,RTF 為 0.77,已經快於即時播放速度,四條執行緒降到 0.63。Apple M4 使用四條執行緒的 RTF 為 0.43。這些結果證明 CPU 即時辨識成立,但不同處理器、音訊長度與編譯方式都會影響速度。
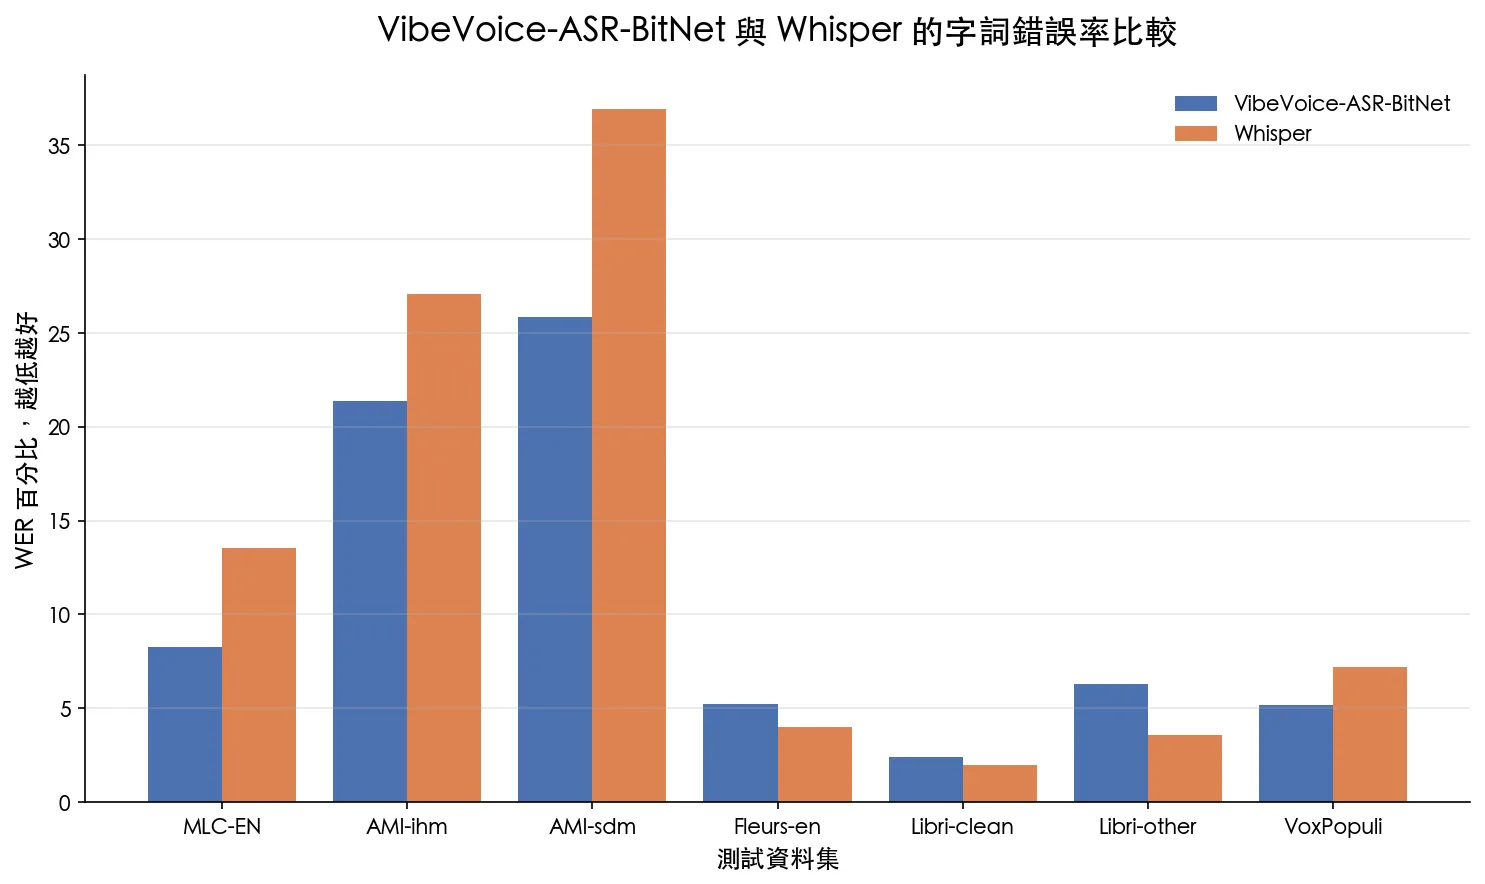
官方 WER 測試顯示兩個模型各有優勢,數值越低越好 準確率也要分資料集看。BitNet 在 MLC-EN、AMI-ihm、AMI-sdm 與 VoxPopuli 的 WER 低於 Whisper,但在 Fleurs-en、Libri-clean 與 Libri-other 則是 Whisper 較低。所以比較正確的說法是,VibeVoice-ASR-BitNet 在多說話人與部分長音訊測試很有競爭力,不能直接延伸成所有語言、所有錄音條件都勝過 Whisper。
如果目前的工作流已經大量使用 Whisper,可以先看我整理的 Whisper 本地語音辨識 ,再拿自己的中文會議、多人訪談與背景噪音資料做同一套測試。真正有意義的是自己的素材,不是只看單一排行榜。
最省硬體的做法,用 VibeASR.cpp 跑 BitNet
只想在 CPU 上完成轉錄,官方的 VibeASR.cpp 是目前最直接的路線。需要 Python 3.9 以上、CMake 3.14 以上,以及 GCC 或 Clang。Windows 需要 MinGW-w64,MSVC 目前不支援。
git clone --recursive https://github.com/microsoft/VibeASR.cpp.git
cd VibeASR.cpp
pip install -r requirements.txt
python setup_env.py
準備一個 WAV 音檔後,用四條 CPU 執行緒開始轉錄。
./build/bin/asr_infer \
  --vae-model models/vibeasr/vibeasr-vae-encoder-i8_s.gguf \
  --lm-model models/vibeasr/vibeasr-lm-i2_s-embed-q6_k.gguf \
  --audio input.wav -t 4
模型頁也提供 Ollama 的啟動方式。這條命令適合先快速取得模型,若要穩定處理音訊檔與調整執行緒,VibeASR.cpp 的 CLI 參數會更清楚。
ollama run hf.co/microsoft/VibeVoice-ASR-BitNet:Q6_K 用 Transformers 在 Python 呼叫 ASR
需要接進自己的 Python 程式時,使用 Transformers 5.3.0 以上的官方模型最乾淨。完整 ASR 權重較大,先確認顯卡記憶體與磁碟空間,不要把 Realtime 0.5B 的硬體需求套過來。
python -m venv .venv
source .venv/bin/activate
pip install transformers==5.3.0 accelerate soundfile
from transformers import AutoProcessor, VibeVoiceAsrForConditionalGeneration
model_id = "microsoft/VibeVoice-ASR-HF"
processor = AutoProcessor.from_pretrained(model_id)
model = VibeVoiceAsrForConditionalGeneration.from_pretrained(
model_id,
device_map="auto"
)
inputs = processor.apply_transcription_request(
audio="input.wav"
).to(model.device, model.dtype)
output_ids = model.generate(**inputs)
generated_ids = output_ids[:, inputs["input_ids"].shape[1]:]
result = processor.decode(generated_ids, return_format="parsed")[0]
for item in result:
print(item)
如果要讓多人共用,官方還提供 vLLM 外掛,對外開出 OpenAI 相容的 /v1/chat/completions 端點,並支援串流、長音訊、hotwords、資料平行與張量平行。這條路比較適合公司內部的集中式轉錄服務。
啟動 Realtime 0.5B 即時 TTS
Realtime 版本的價值是讓 LLM 還在產生文字時就開始發聲。官方資料寫的是約 200 毫秒產生第一段聲音,但實際聽到的時間還會加上網路與播放緩衝。官方測試中 NVIDIA T4 與 Mac M4 Pro 可以達到即時速度,這不代表每一台 Mac 或每張 6GB 顯卡都一定相同。
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
python -m venv .venv
source .venv/bin/activate
pip install -e ".[streamingtts]"
python demo/vibevoice_realtime_demo.py \
  --model_path microsoft/VibeVoice-Realtime-0.5B
Realtime 0.5B 目前只支援單一說話人,英文仍是主要目標。德文、法文、義大利文、日文、韓文、荷蘭文、波蘭文、葡萄牙文與西班牙文屬於實驗音色。中文長篇多人合成若來自社群分支或整合包,應分開標示版本與來源。想比較更偏聲音克隆的方案,可以延伸看 dots.tts 的 3 秒聲音復刻架構 ,若重點是音色設計,則可以看 Qwen3-TTS 的音色控制 。
文字正規化是長篇 TTS 的必做前處理
長篇語音最常見的問題不是音色,而是日期、金額、百分比、網址與特殊符號被念錯。輸入「2026/7/28」與輸入「二零二六年七月二十八日」,模型收到的任務並不相同。正式生成前應先清理 Markdown、程式碼、罕見符號與過度複雜的標點,再把數字轉成預期的口語形式。
from wetext import Normalizer

normalizer = Normalizer(lang="zh", operator="tn")
text = normalizer.normalize("2026年7月28日,版本 1.0")
print(text)
WeText 可以做中文、英文與日文的 TN 和 ITN。它不是萬能修正器,品牌名、縮寫與人名仍要自行建立字典。這一步也適合放在 Voicebox 本地 AI 語音工作室 這類批次工作流前面,避免同一個錯誤被大量生成。
安裝時最容易卡住的地方
PyTorch 裝成 CPU 版 :先用 python -c "print(__import__('torch').cuda.is_available())" 檢查,再依自己的 CUDA 版本重裝官方 PyTorch 套件。把所有版本當成同一套需求 :ASR-7B、Realtime-0.5B 與 BitNet 的模型大小和執行後端完全不同。把社群功能當成官方保證 :自訂音色、中文多人 TTS 與一鍵整合包要確認來源、commit 與安全性。忽略 FFmpeg :Gradio 與長音訊服務通常需要 FFmpeg 解碼,先確認 ffmpeg -version 能正常執行。直接丟進正式產品 :Microsoft 明確把目前版本定位在研究與開發用途,正式商用前要自行測試準確率、延遲、授權與風險。
我會怎麼選
VibeVoice 最有價值的不是某一個模型贏過所有對手,而是它把語音工作拆成幾個明確層級。只有 CPU 就用 BitNet。需要長音訊、說話人與時間戳,就用完整 ASR。需要 Agent 邊想邊說,就用 Realtime。需要中文音色克隆與更強的角色控制,則把 dots.tts、Qwen3-TTS 或其他本地 TTS 放進比較名單。
我特別喜歡 BitNet 這次的方向。它不是叫使用者為了語音辨識再買一張顯卡,而是透過量化與專用 CPU runtime,把模型帶回一般電腦。這種改進比單純把參數做大更接近真正能落地的本地 AI。
官方資源
FAQ
VibeVoice 可以完全離線使用嗎
可以。模型與依賴下載完成後,VibeASR.cpp、Transformers ASR 與 Realtime TTS 都可以在本地執行。第一次安裝與下載權重仍需要網路。
6GB 顯存可以跑所有 VibeVoice 模型嗎
不可以。6GB 是特定 TTS 或 Realtime 組合的實測條件,完整 ASR 權重需要更多資源。只有一般電腦時,CPU 版 BitNet 是更合理的起點。
VibeVoice-Realtime 支援中文嗎
官方目前仍把英文列為主要目標,另提供九種實驗語言,名單不含中文。社群版本可能加入中文或自訂音色,但要分開看待。
by Rain Chu 7 月 28, 2026 | AI , skills , Tool , 圖型處理
AI Agent 很會理解「月份、營收、百分比變化」代表什麼,卻不一定能穩定處理座標軸、刻度、色階、標籤間距與版面配置,直接要求模型輸出完整 Vega-Lite 或 ECharts 規格,常見結果不是設定冗長,就是參數彼此衝突,甚至渲染後只得到空白畫布。
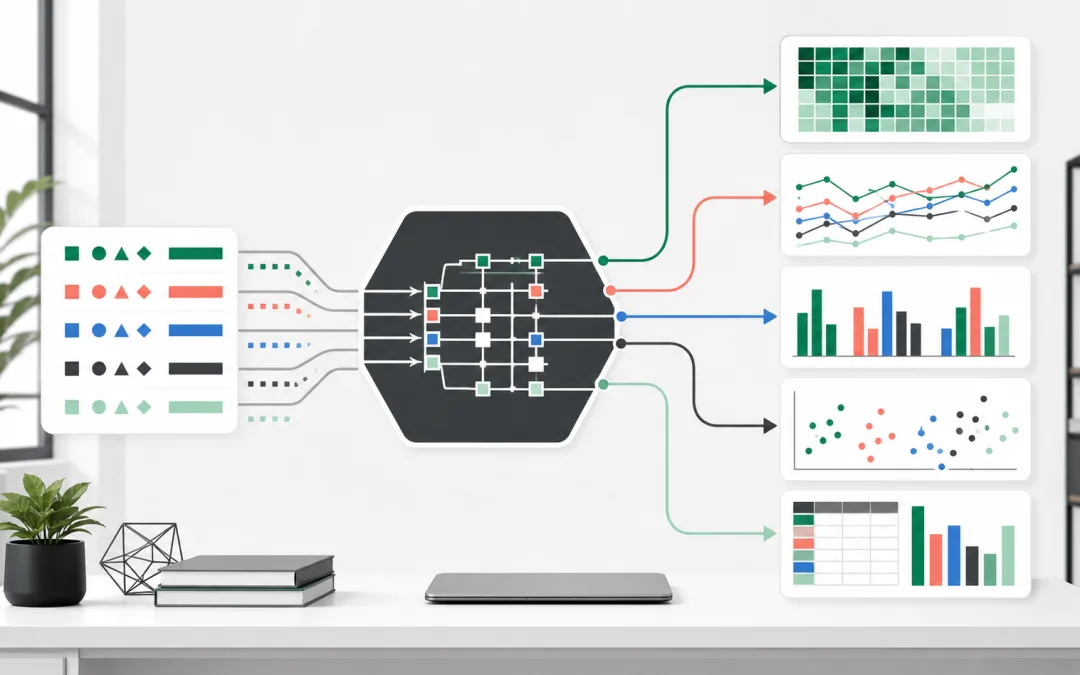
Flint Chart 的做法,是讓 AI 只負責描述資料的意義與圖表意圖,再由確定性的編譯器完成幾何與渲染細節 ,這不只是圖表工具的改良,也是一種值得用在 AI Agent 系統的架構。模型產生小型、可驗證的中介格式,程式再負責執行可重現的工作。
如果你正在用 Codex 製作視覺內容,可以先參考站內的Codex 動態圖表與短影音工作流程 ,Flint 則更專注在資料圖表的語意、驗證與多後端輸出。
Flint Chart 是什麼
Flint 是微軟研究院與中國人民大學 IDEAS Lab 合作開發的開源視覺化中介語言,它不是另一套直接把圖畫到畫布上的函式庫,而是位在 AI Agent 與 Vega-Lite、Apache ECharts、Chart.js、Plotly、Excel 之間的語意層。
AI Agent 判斷欄位代表月份、價格、利潤、國家、排名或百分比變化Flint 規格 保存資料、語意型別、圖表種類與欄位映射Flint 編譯器 推導日期解析、聚合、刻度、色彩、標籤與版面繪圖後端 接收原生規格並渲染互動圖表、PNG、SVG 或 Excel 原生圖表
截至 2026 年 7 月 28 日,官方 GitHub 顯示 JavaScript 與 TypeScript 函式庫已能輸出 Vega-Lite、ECharts、Chart.js、Plotly 與 Office.js 使用的 Excel 原生圖表。7 月 11 日的 iThome 報導只列出前三種,是因為後續 0.4.0 版才加入 38 種 Plotly 圖表與 18 種可編輯 Excel 範本。
為什麼 AI 直接產生圖表容易失敗
製作圖表其實包含兩種不同工作。第一種是理解語意,例如 revenue 是金額,month 是年月,growth 是百分比變化。第二種是安排幾何,例如軸的範圍、刻度密度、文字旋轉、圖例位置與色彩映射。
語言模型擅長第一種工作,第二種工作卻牽涉許多互相依賴的數值與規則。Flint 把兩者拆開後,AI 不必一次猜完所有低階設定。規格也從難以檢查的大段設定,縮成可閱讀、可修改、可在渲染前驗證的小型 JSON。
模型負責意義,編譯器負責數學。真正的價值不是少寫幾行,而是讓每一步都能被驗證與重現。
Flint 規格的三個核心部分
一份 Flint 輸入主要由資料、semantic_types 與 chart_spec 組成。下面用季度營收長條圖示範最小結構。
{
  "data": {
    "values": [
      { "quarter": "Q1", "revenue": 1200 },
      { "quarter": "Q2", "revenue": 1450 },
      { "quarter": "Q3", "revenue": 980 },
      { "quarter": "Q4", "revenue": 1800 }
    ]
  },
  "semantic_types": {
    "quarter": "Quarter",
    "revenue": "Price"
  },
  "chart_spec": {
    "chartType": "Bar Chart",
    "encodings": {
      "x": { "field": "quarter" },
      "y": { "field": "revenue" }
    },
    "baseSize": { "width": 480, "height": 320 }
  }
}
data 可以直接放入列資料,也能在本機 MCP 模式下引用 JSON、CSV 或 TSV 檔案。semantic_types 告訴編譯器每個欄位的實際意義。chart_spec 則決定圖表種類,以及欄位要放在 x、y、color、size、shape、column、row、group 或 detail 等通道。
語意型別可以重複使用。探索同一份資料時,多半只要更換 chart_spec。例如把 Quantity 改成 PercentageChange,編譯器就能改用適合正負變化的發散色階、百分比格式與對應的軸設定。這比每次都讓模型重新生成完整圖表設定更穩定。
在 Codex 安裝 Flint MCP
本機版本需要 Node.js 18 以上。Codex 可以用一行命令加入 stdio MCP 伺服器。
codex mcp add flint -- npx -y flint-chart-mcp接著確認伺服器是否已經出現在清單。
codex mcp list如果資料不需要從本機檔案讀取,可以關閉檔案引用。這個設定要求代理把資料列直接放進 data.values,能縮小不受信任工作流程的檔案存取範圍。
codex mcp add flint-safe -- npx -y flint-chart-mcp --disable-file-reference官方也提供遠端 MCP 端點,適合只能連接 HTTP MCP 的客戶端。處理私有資料時,仍建議優先選擇本機 stdio 版本。
codex mcp add flint-remote --url https://flint.data-formulator.ai/mcp第一次使用的提示詞
安裝後不要只下「幫我畫圖」。把資料來源、語意、圖表目的、驗證方式與輸出格式一起交代,結果會更可靠。
請載入 flint://agent-skill,並呼叫 list_chart_types 檢查 vegalite 後端是否可用。讀取目前資料夾的 sales.csv,把 month 判定為 YearMonth,revenue 判定為 Price,growth 判定為 PercentageChange。先用 validate_chart 驗證,再建立每月營收折線圖,並用顏色標示成長率。若支援 MCP Apps 就使用 create_chart_view,否則用 render_chart 輸出 SVG。最後列出所有警告與被截斷的資料。
Flint MCP 提供五個主要工具。create_chart_view 適合互動調整,validate_chart 用來檢查規格與警告,render_chart 產生 PNG 或 SVG,compile_chart 回傳後端原生 JSON,list_chart_types 則用來確認可用的圖表與通道。
這套做法和讓 Codex 用 Playwright CLI 操作瀏覽器 有相同精神。模型不必自己模擬每個底層步驟,而是呼叫邊界清楚、結果可檢查的工具。
在 JavaScript 與 TypeScript 專案使用
若你正在開發產品,而不是只在對話中產生圖表,可以直接安裝函式庫。
npm install flint-chartimport { assembleVegaLite } from "flint-chart"
const input = {
data: { values: myData },
semantic_types: {
weight: "Quantity",
mpg: "Quantity",
origin: "Country"
},
chart_spec: {
chartType: "Scatter Plot",
encodings: {
x: { field: "weight" },
y: { field: "mpg" },
color: { field: "origin" }
},
baseSize: { width: 400, height: 300 }
}
}
const spec = assembleVegaLite(input) 相同輸入可以交給 assembleECharts、assembleChartjs、assemblePlotly 或 assembleExcel。後端若不支援指定圖表,組裝器會在渲染前拋出錯誤,因此產品端應先查詢範本支援狀態,再把錯誤與警告顯示給使用者。
Excel 原生圖表特別適合需要後續人工編輯的報表工作。如果工作流程還包含 Word、PowerPoint 或試算表處理,可以延伸閱讀OfficeCLI 與 AI Agent 的 Office 自動化教學 。
Flint、Vega-Lite、Mermaid 與一般 Chart MCP 的差異
工具 主要用途 AI 要處理的細節 適合情境 Flint 語意中介格式與編譯 資料意義、圖表意圖與欄位映射 需要可靠生成、多後端與可驗證規格 Vega-Lite 統計視覺化文法 較完整的編碼、比例尺與版面設定 需要精細控制與成熟生態 Mermaid 流程圖與軟體圖解 節點、關係與圖形語法 架構圖、流程圖與文件 一般 Chart MCP 把特定繪圖服務包成工具 視工具設計而定 已有固定渲染服務或單一後端
Flint 並不是 Vega-Lite 的替代品,因為它可以直接編譯成 Vega-Lite 規格。它處理的是更前面的一層,讓模型先表達「這些資料是什麼」,再由編譯器決定「如何正確畫出來」。
目前限制與使用前要知道的事
仍是研究專案 官方論文尚未正式公開,產品決策不能只靠宣傳數字Python 套件尚未發布 目前只有原始碼預覽,正式套件仍以 JavaScript 與 TypeScript 為主後端支援並不完全相同 同一圖表不一定能在所有後端輸出,MCP 指南目前列出的編譯後端仍以 Vega-Lite、ECharts 與 Chart.js 為主Flint 不負責完整資料整理 聚合、過濾、關聯、樞紐與衍生欄位最好先在上游完成自動版面可能截斷資料 離散項目超過空間預算時會套用保留策略,整合端必須顯示 _warnings本機渲染仍要管理權限 預設會讀取代理指定的本機檔案,不受信任的環境應啟用 –disable-file-reference
iThome 整理的測試顯示,Flint 在 GPT-5.1、GPT-5-mini 與 GPT-4.1 三組 LLM 評分中,都優於直接產生完整 Vega-Lite 規格的 DirectVL。不過官方仍標示研究論文即將公開,因此比較結果適合視為早期證據,不能取代自己的資料集與視覺驗收。
真正值得帶走的是代理系統的分工方式
Flint 最值得學習的不只是圖表規格,而是代理系統的分工。讓模型輸出小型、結構化、可以先驗證的意圖,再讓確定性程式負責計算、渲染與錯誤處理。這個模式也能延伸到 UI 元件、文件排版、測試流程與自動化操作。
但「成功回傳 JSON」不等於任務完成。視覺工作必須真的渲染,再檢查畫布是否空白、文字是否重疊、顏色是否誤導、資料是否被截斷。AI Agent 的可靠性,來自可驗證的中介格式與最後一哩的實際驗收,而不是更長的提示詞。
常見問題
Flint 可以取代 ECharts 或 Vega-Lite 嗎
不會。Flint 是位在 AI 與繪圖函式庫之間的中介語言,最後仍會輸出 ECharts、Vega-Lite 等後端可使用的原生規格。
Flint MCP 會把資料上傳到外部服務嗎
本機 stdio 版本會在主機上執行,內嵌資料與本機檔案不會送到遠端渲染服務。若改用官方 HTTP 端點,資料會透過遠端連線處理,因此敏感資料仍應優先採用本機版本。
Codex 看不到互動圖表怎麼辦
create_chart_view 需要客戶端支援 MCP Apps。若目前介面不支援,可以要求 Flint 使用 render_chart 輸出 SVG 或 PNG,再直接檢查成品。
Flint 適合什麼工作
它適合需要大量產生資料圖表、希望規格可被人工修改、需要切換不同後端,或不能接受偶發空白與錯誤圖表的 Agent 工作流程。若只是一次性的簡單圖表,現有大型模型或熟悉的圖表函式庫可能已經足夠。
參考資料
by Rain Chu 7 月 23, 2026 | AI , 語音分離 , 語音合成 , 語音辨識
Voicebox 最吸引我的地方,是它不是只做 TTS,也不是只做 Whisper 聽寫,而是把語音輸入、語音輸出、聲音克隆、故事編輯器、REST API 和 MCP server 放在同一個本地優先的工具裡。這讓 AI Agent 不只會回文字,也能用你指定的音色說話。
如果說過去的語音工具常常分成兩邊,ElevenLabs 偏輸出,WisprFlow 偏輸入,那 Voicebox 想做的是完整 voice I/O stack。更重要的是,它預設把模型、聲音資料和錄音留在本機,這對語音克隆和工作資料來說很關鍵。
先講結論
Voicebox 是 Jamie Pine 開源的 AI voice studio,官方定位是 local-first。它可以做文字轉語音、聲音克隆、全域快捷鍵聽寫、Whisper 轉錄、故事多軌編輯,還能透過 REST API 和 MCP server 讓 Claude Code、Cursor、Cline 這類 MCP-aware agent 發聲。
我會把它放在「本地語音 AI 底座」這一類,之前整理過 audio.cpp 本地語音 AI WebUI 和 Hugging Face speech-to-speech 本地語音 Agent ,Voicebox 則更偏向桌面應用和創作者工具,並且把 Agent 整合做得很直接。
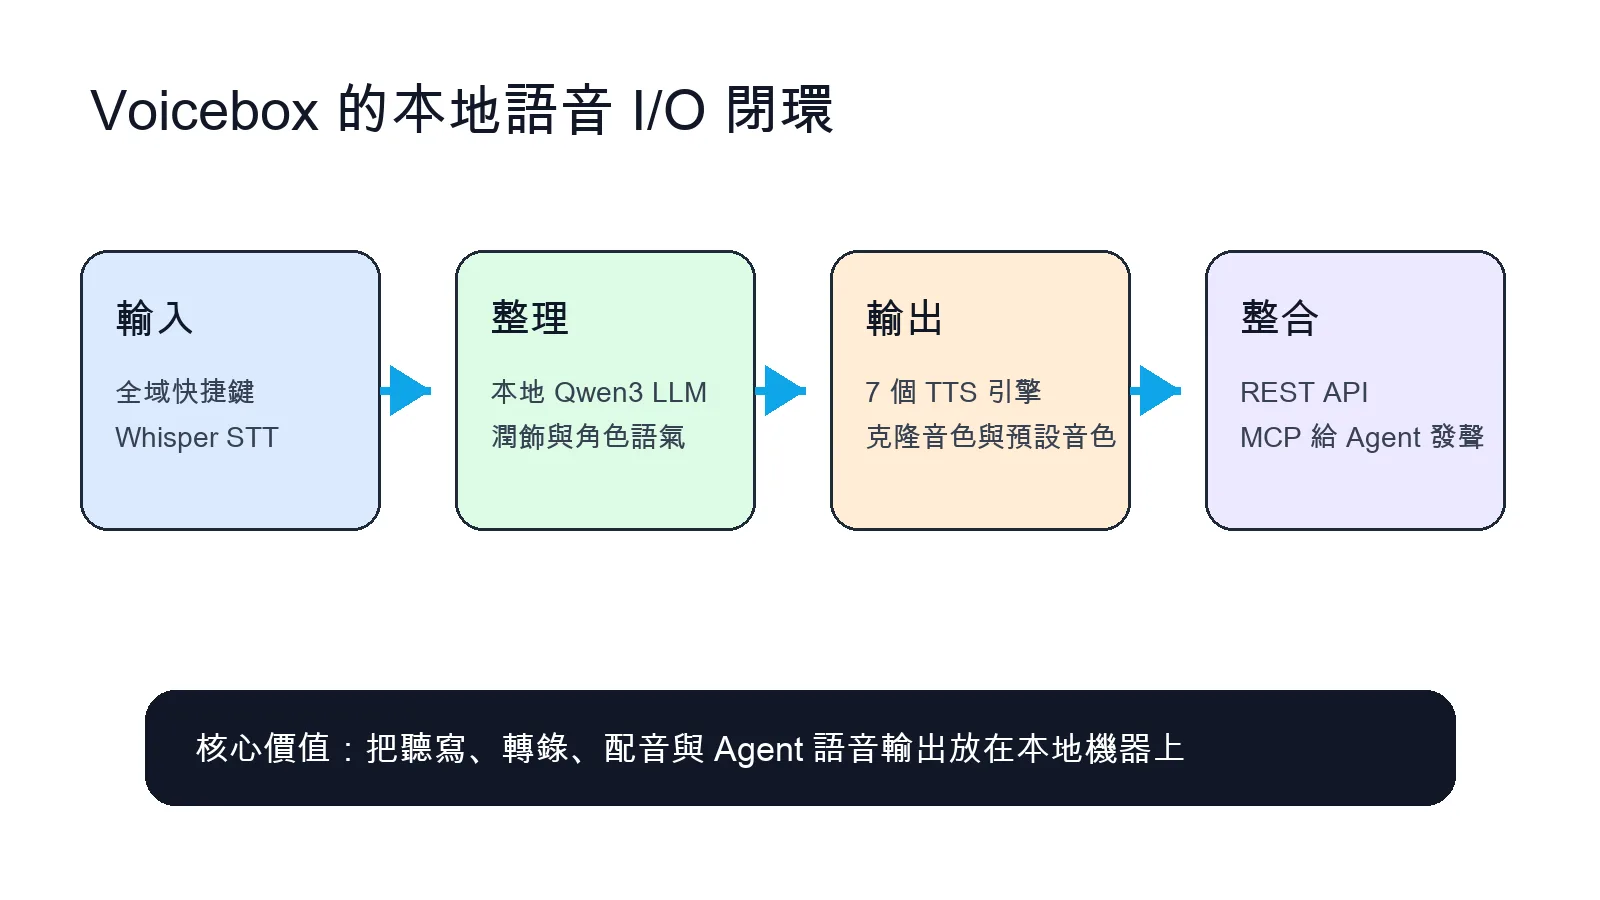
Voicebox 把聽寫、轉錄、配音和 Agent 語音輸出放在同一個本地工具裡。 Voicebox 在補語音 AI 的哪一塊
很多語音工具只有單點能力。TTS 工具能把文字變聲音,但不一定能做聽寫。STT 工具能轉錄,但不一定能配音。聲音克隆工具效果強,但常常依賴雲端 API。Voicebox 的取向比較完整:輸入端用 Whisper,輸出端有多個 TTS 引擎,中間還有本地 Qwen3 LLM 做潤飾、角色語氣和 persona。
這種整合方式很適合兩種人:
第一種是內容創作者,想做旁白、podcast、故事對話、角色音色。
第二種是 AI Agent 使用者,想讓 Claude Code、Cursor 或自己的工具在完成任務後,用指定聲音提醒你,而不是只丟一段文字。
7 個 TTS 引擎和 23 種語言
官方 README 列出 7 個 TTS 引擎:Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro。它們的定位不同,有的適合多語言克隆,有的適合 CPU 快速推理,有的適合加入情緒標籤和語氣控制。
能力 Voicebox 的做法 適合用途 高品質 TTS Qwen3-TTS、Chatterbox、HumeAI TADA 等引擎 旁白、教學、產品介紹 聲音克隆 用參考音訊做 zero-shot cloning 個人聲音、角色聲音、品牌聲線 快速預設音色 Kokoro 和 Qwen CustomVoice 提供 50+ 音色 快速試稿、多角色對話 語音輸入 全域快捷鍵加 Whisper STT 聽寫、轉錄、工作筆記
如果你對開源 TTS 的音色設計有興趣,可以搭配看 Qwen3-TTS 的音色設計整理 和 dots.tts 聲音復刻架構 。Voicebox 比較像把這些能力打包成桌面工作台,而不是單一模型 demo。
聲音克隆和預設音色的差別
聲音克隆適合你有一段參考音訊,想生成相似聲線。預設音色適合你只是要快速找一個可用聲音,不想準備樣本。Voicebox 同時支援兩種路線,這點很實用。創作者可以先用預設音色打草稿,確定文本節奏後,再換成克隆音色做正式版本。
但聲音克隆也有界線。它很適合克隆你自己擁有權利的聲音,或明確授權的角色聲音。不要拿來模仿名人、同事或客戶聲音做未授權內容。語音模型越容易使用,倫理和授權越要先想清楚。
Whisper 聽寫補上輸入端
Voicebox 的另一半是輸入。它用 OpenAI Whisper 做 speech-to-text,支援全域 dictation hotkey、push-to-talk 和 toggle mode。macOS 上可以把轉錄結果直接貼到目前焦點文字欄位,這會讓它接近一個本地版語音輸入法。
Whisper 對長音訊和技術內容一直很適合。如果你常做訪談、會議紀錄、口述筆記,Voicebox 把 captures、replay、re-transcribe、refine 放在同一個介面裡,會比單純命令列轉錄更順。這裡也可以延伸看之前整理的 Whisper 開源語音轉文字 。
MCP 讓 Agent 真的開口說話
Voicebox 最有意思的一點,是內建 MCP server,官方 README 寫到它提供 `voicebox.speak`、`voicebox.transcribe`、`voicebox.list_captures`、`voicebox.list_profiles` 四個工具,這代表 MCP-aware agent 可以呼叫 Voicebox,把文字變成指定音色播放出來,也可以讀取 captures 和 voice profiles。
這不只是好玩。Agent 的語音輸出可以拿來做任務完成提醒、錯誤警告、長任務回報、pair programming 對話。你甚至可以把不同 agent 綁定不同聲音,例如 Claude Code 用一個音色,Cursor 用另一個音色,聽聲音就知道是哪個工具在回報。
{
  "tool": "voicebox.speak",
  "arguments": {
    "text": "任務完成,測試已通過",
    "profile": "Morgan"
  }
}
如果你已經在玩 Playwright CLI 讓 Codex 操作瀏覽器 ,Voicebox 可以補上另一個感官通道。Agent 不只可以操作網頁,也能在完成後直接用語音提醒你。
Stories editor 適合做多角色內容
Voicebox 也有 Stories editor,可以做 conversation、podcast、narrative 這類多段落、多角色內容。這對部落格轉 podcast、教學腳本、角色對話、短劇旁白都很有用。比起一次產生一整段音訊,多軌 timeline 更適合慢慢調整角色、節奏和轉場。
如果你平常會把文章轉成短影片或語音內容,Voicebox 可以放在內容工作流後段。先由 Agent 整理稿件,再用 Voicebox 做角色分配和配音,最後再進剪輯工具。
安裝與使用入口
Voicebox 官方網站是 voicebox.sh ,GitHub repo 是 jamiepine/voicebox 。官方 README 提供 macOS Apple Silicon、macOS Intel 和 Windows 下載入口,也有開發者本地建置方式。
我會怎麼用
我不會只把 Voicebox 當成免費配音工具:
更有價值的用法,是把它接進 AI Agent 工作流,平常寫文章、整理筆記、跑 Codex、跑 Claude Code,最後都可以由 Voicebox 轉成語音摘要。長任務完成時不用一直盯螢幕,讓 Agent 開口提醒就好。
第二個用法是做內容實驗,先用預設音色快速產出版本,再用克隆音色做正式版。
第三個用法是本地聽寫,把口述想法直接丟進任何 app,再交給 Agent 整理。這會比只靠鍵盤更接近自然工作流。
我的判斷
Voicebox 不是單一模型展示,而是把語音 AI 變成桌面工作台。它的亮點不是某個 TTS 引擎本身,而是整合:本地隱私、TTS、STT、故事編輯、聲音 profile、REST API、MCP server。
如果你只需要偶爾產一段聲音,線上 TTS 服務可能更快。但如果你想要長期建立自己的聲音素材庫、做本地聽寫、讓 Agent 用聲音回報任務,Voicebox 會是值得試的工具。
延伸資源
FAQ
Voicebox 是什麼?
Voicebox 是開源的本地優先 AI 語音工作室,可以做 TTS、聲音克隆、Whisper 聽寫轉錄、故事編輯和 MCP Agent 語音輸出。
Voicebox 可以離線使用嗎?
官方定位是 local-first,模型、聲音資料和 captures 會留在本機。實際能否完全離線,取決於你是否已下載需要的模型和使用的引擎。
Voicebox 支援哪些 TTS 引擎?
官方列出 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro。
Voicebox 可以接 Claude Code 或 Cursor 嗎?
可以。Voicebox 內建 MCP server,MCP-aware agent 可以使用 `voicebox.speak`、`voicebox.transcribe`、`voicebox.list_captures` 和 `voicebox.list_profiles`。
by Rain Chu 7 月 20, 2026 | Agent , AI , API , Tool
Cloudflare Workers AI 拿來接 Claude Code 的做法很簡單:Cloudflare 跑模型,LiteLLM 在本機當轉接橋,Claude Code 只需要改 Anthropic 相關環境變數,就能把請求送到本機 proxy。
這篇整理的是一個比較務實的路線。它不是要你把所有模型成本都消失,而是讓你知道免費額度在哪裡、帳單風險在哪裡、命令怎麼下、哪些設定一定要看清楚。
先講結論
Cloudflare Workers AI 有免費額度,官方價格頁寫明 Free plan 每天有 10,000 Neurons,GLM 5.2 目前也在 Cloudflare Workers AI 模型列表裡,可以透過 Cloudflare API 呼叫。這代表你可以把 Claude Code 的模型入口改成本機 LiteLLM proxy,再由 LiteLLM 轉送到 Cloudflare 的 @cf/zai-org/glm-5.2。
但「免費」不是「無限」,Cloudflare 的計費單位是 Neurons,免費額度用完後會受到方案限制,更重要的是,Cloudflare AI Gateway 也能接外部模型,如果你把 OpenAI 或 Anthropic 這類外部模型接進去,那就不再是 Cloudflare Workers AI 的免費模型邏輯,帳單會回到外部供應商那邊。
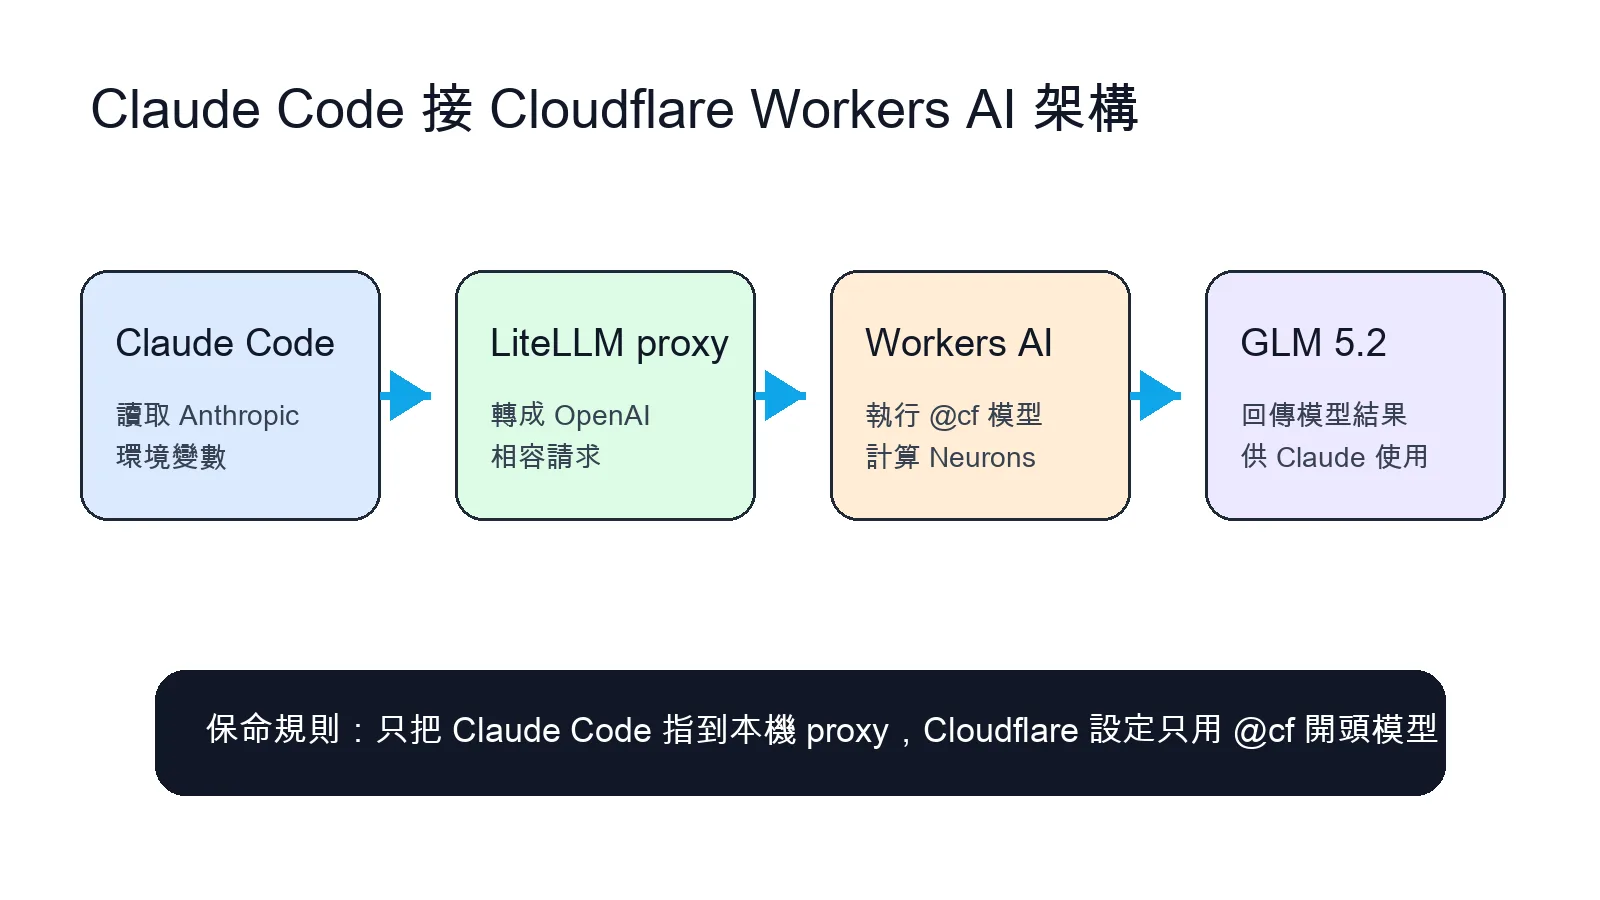
Claude Code 只改成本機 Anthropic 入口,真正的模型請求由 LiteLLM 轉到 Cloudflare Workers AI。 這個架構在解什麼問題
Claude Code 很好用,但長時間寫程式、重構、跑測試、修錯時,模型成本會變得很有感。若只是一些低風險任務,例如產生腳手架、改小工具、做簡單 demo、先跑一輪想法,Cloudflare Workers AI 的免費額度可以拿來當低成本緩衝層。
這和 用 Claude Code 搭配 LM Studio 與 Ollama 的思路很像,只是這次不是跑本地模型,而是把免費雲端額度接進本機開發流程。若你的工作流已經在用 Claude Code、Codex 和 skill 組合工作流 ,這種 proxy 入口會很有彈性。
完整操作命令
下面命令以 macOS 或 Linux 為主。你需要先有 Cloudflare 帳號,並在 Cloudflare dashboard 取得 Account ID 和 API Token。API Token 建議只給 Workers AI 需要的最小權限,不要用過度寬鬆的全域 token。
0. 安裝 Claude Code
npm install -g @anthropic-ai/claude-code 1. 用 curl 單測 GLM 5.2
先確認 Cloudflare 端可以呼叫模型。把 `你的ACCOUNT_ID` 和 `你的API_TOKEN` 換成自己的值。
curl https://api.cloudflare.com/client/v4/accounts/你的ACCOUNT_ID/ai/run/@cf/zai-org/glm-5.2 \
  -H "Authorization: Bearer 你的API_TOKEN" \
  -d '{"messages":[{"role":"user","content":"用一句話介紹你自己"}]}'
2. 安裝 uv
LiteLLM proxy 用 uvx 跑,可以固定 Python 3.12,避開較新 Python 版本造成的編譯問題。
curl -LsSf https://astral.sh/uv/install.sh | sh 3. 驗證 LiteLLM 能跑
uvx --python 3.12 --from 'litellm[proxy]' litellm --version 4. 建立 cf-config.yaml
建立 `cf-config.yaml`。`你的ACCOUNT_ID` 有兩處要換。`cf-glm-5.2` 給 Claude Code 主要模型用,`cf-small` 給較輕量任務用。
model_list:
  - model_name: cf-glm-5.2
    litellm_params:
      model: openai/@cf/zai-org/glm-5.2
      api_base: https://api.cloudflare.com/client/v4/accounts/你的ACCOUNT_ID/ai/v1
      api_key: os.environ/CLOUDFLARE_API_TOKEN
  - model_name: cf-small
    litellm_params:
      model: openai/@cf/meta/llama-3.1-8b-instruct-fp8
      api_base: https://api.cloudflare.com/client/v4/accounts/你的ACCOUNT_ID/ai/v1
      api_key: os.environ/CLOUDFLARE_API_TOKEN

litellm_settings:
  use_chat_completions_url_for_anthropic_messages: true
5. 啟動 LiteLLM 翻譯橋
這個終端視窗要保持開啟。Claude Code 之後會連到 `localhost:4000`。
export CLOUDFLARE_API_TOKEN=你的token
uvx --python 3.12 --from 'litellm[proxy]' litellm --config cf-config.yaml --port 4000
6. 新開視窗測 proxy
curl http://localhost:4000/v1/models -H 'Authorization: Bearer sk-1234' 7. 把 Claude Code 指到本機 proxy
export ANTHROPIC_BASE_URL=http://localhost:4000
export ANTHROPIC_AUTH_TOKEN=sk-1234
export ANTHROPIC_MODEL=cf-glm-5.2
export ANTHROPIC_DEFAULT_HAIKU_MODEL=cf-small
接著啟動 Claude Code,若跳出自訂 API 設定就選是。進入後用 `/status` 確認 Base URL 指向 `localhost:4000`。
8. 把設定寫進 shell profile
如果你確定要長期使用,可以把上面四行 `ANTHROPIC_` export 加到 `~/.zshrc` 或 `~/.bashrc`。我會建議先手動跑幾次確認沒有問題,再寫進 profile。
Windows PowerShell 寫法
PowerShell 不用 `export`,改用 `$env:`。
$env:ANTHROPIC_BASE_URL="http://localhost:4000"
$env:ANTHROPIC_AUTH_TOKEN="sk-1234"
$env:ANTHROPIC_MODEL="cf-glm-5.2"
$env:ANTHROPIC_DEFAULT_HAIKU_MODEL="cf-small"
若要永久保存,放進 PowerShell 的 `$PROFILE`。Windows 跑 AI Agent 時,環境隔離也很重要,可以延伸看 Windows 跑 AI Agent 為什麼要用 WSL 。
保命提醒:不要把外部模型當免費額度
最容易出事的地方,是把 Cloudflare Workers AI、Cloudflare AI Gateway、OpenAI、Anthropic 混在一起。這篇的低成本前提,是 Cloudflare config 裡的模型走 `@cf/` 開頭,例如 `@cf/zai-org/glm-5.2`。這類模型用的是 Cloudflare Workers AI 額度。
如果你把 Gateway 接到 GPT 或 Claude,那些請求可能會回到 OpenAI 或 Anthropic 的帳單。Cloudflare 只是通道,不代表外部模型突然免費。真正要保命,就是把模型名稱、api_base、API key 來源逐一檢查,並在 Cloudflare 後台看用量。
官方價格頁目前寫得很明確:Free plan 每天 10,000 Neurons,Paid plan 也有每天 10,000 Neurons 免費額度,超出後依 Neurons 計費。免費方案超出額度通常是操作失敗,不是自動無限跑。這點比「無限免費」四個字重要太多。
省額度的三個做法
第一,任務分層。小任務用 `cf-small`,複雜推理再用 `cf-glm-5.2`。第二,讓 Agent 先輸出計畫再執行,避免一次丟太長上下文。第三,把重複流程寫成腳本或 skill,減少模型反覆讀同一批資料。
這也是我一直看好的方向:不要只追求模型本身,而是把模型接到穩定工具鏈。像 Playwright CLI 讓 Codex 操作瀏覽器 ,或 讓 Agent 自己搜尋和使用 skills ,本質上都是把昂貴推理留給真正需要判斷的地方。
我會怎麼用
我不會把這套當成主力模型的完全替代品,而是當成低成本實驗層。適合拿來跑 demo、試 prompt、生成小工具、做簡單 code review、補文件、處理一次性腳本。真正重要的架構決策、複雜除錯、長上下文專案,還是要保留更強模型或本地大模型選項。
如果你已經在用 Codex 和 ChatGPT Work 這類 AI 代理工作流 ,這套 Cloudflare Workers AI + LiteLLM 的做法可以當成另一個模型入口。它的價值不是讓你省到零,而是讓你有更多成本可控的實驗空間。
延伸資源
FAQ
Cloudflare Workers AI 接 Claude Code 真的免費嗎?
不是無限免費。Cloudflare Workers AI 有每日免費 Neurons 額度,超出後會依方案限制或計費。要把它當成低成本額度,不要當成沒有上限的模型。
為什麼需要 LiteLLM?
LiteLLM 在本機當 proxy,把 Claude Code 發出的 Anthropic 入口請求轉成 Cloudflare Workers AI 可接受的 OpenAI 相容請求。
最容易踩到哪個帳單風險?
最容易把 Cloudflare AI Gateway 接到外部 GPT 或 Claude,卻以為仍在用 Cloudflare 免費 @cf 模型。設定時要確認模型名稱是 `@cf/` 開頭,並檢查 API key 來源。
這套適合取代主力 Claude 嗎?
不建議直接取代。它比較適合低成本實驗、簡單任務、小工具和批次工作。複雜架構、長上下文和高風險任務,仍應保留更強模型。
by Rain Chu 7 月 20, 2026 | AI , skills , Tool
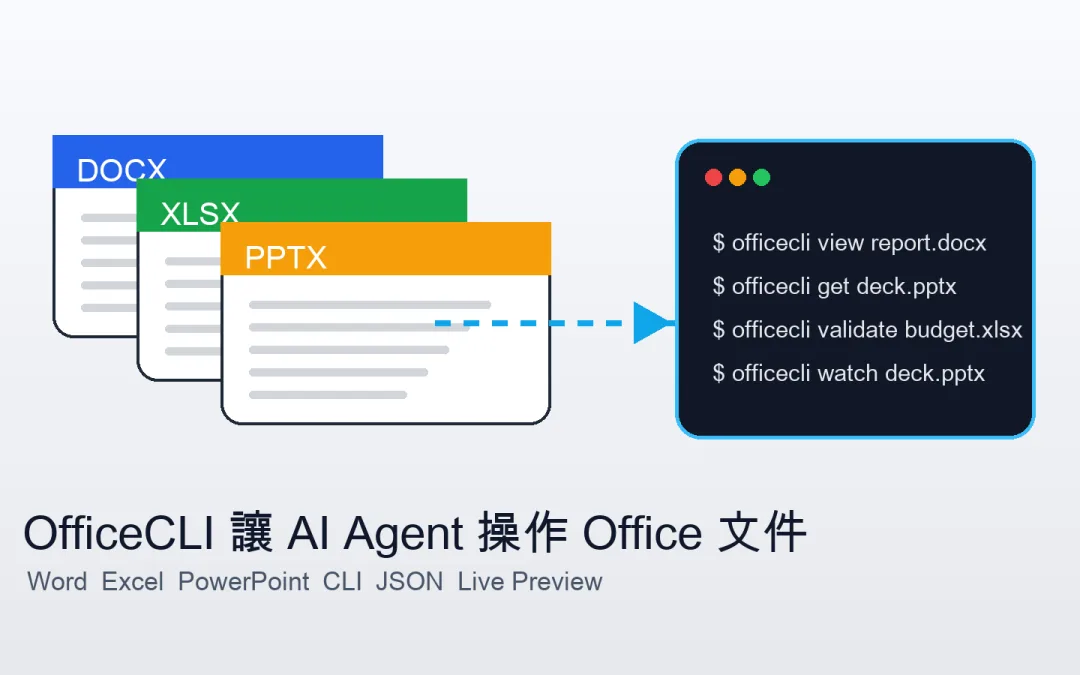
OfficeCLI 把 Word、Excel、PowerPoint 這三種常見文件,變成 AI Agent 可以穩定讀取、修改、驗證和預覽的工程接口。
以前要讓 AI 幫你處理 Office 文件,常見做法是丟給 Python 套件,例如 python-docx、openpyxl、python-pptx。這些工具很有用,但每種格式各自一套 API,版面問題也很難用純文字確認。OfficeCLI 的方向則比較像給 Agent 一支專門的文件手臂,用 CLI 和 JSON 把文件操作標準化。
先講結論
OfficeCLI 是 iOfficeAI 開源的 Office 文件命令列工具,主打給 AI Agent 使用。它可以建立、讀取、修改和驗證 docx、xlsx、pptx,不需要安裝 Microsoft Office,也不需要額外 runtime,官方定位是 single binary。
我會把它放在 Playwright CLI 同一類思路裡,Playwright CLI 是讓 Agent 操作瀏覽器,OfficeCLI 則是讓 Agent 操作文件,兩者共同點都是把原本依賴 GUI 或複雜 library 的任務,改成可重複、可檢查、可寫進 skill 的 CLI 工作流。
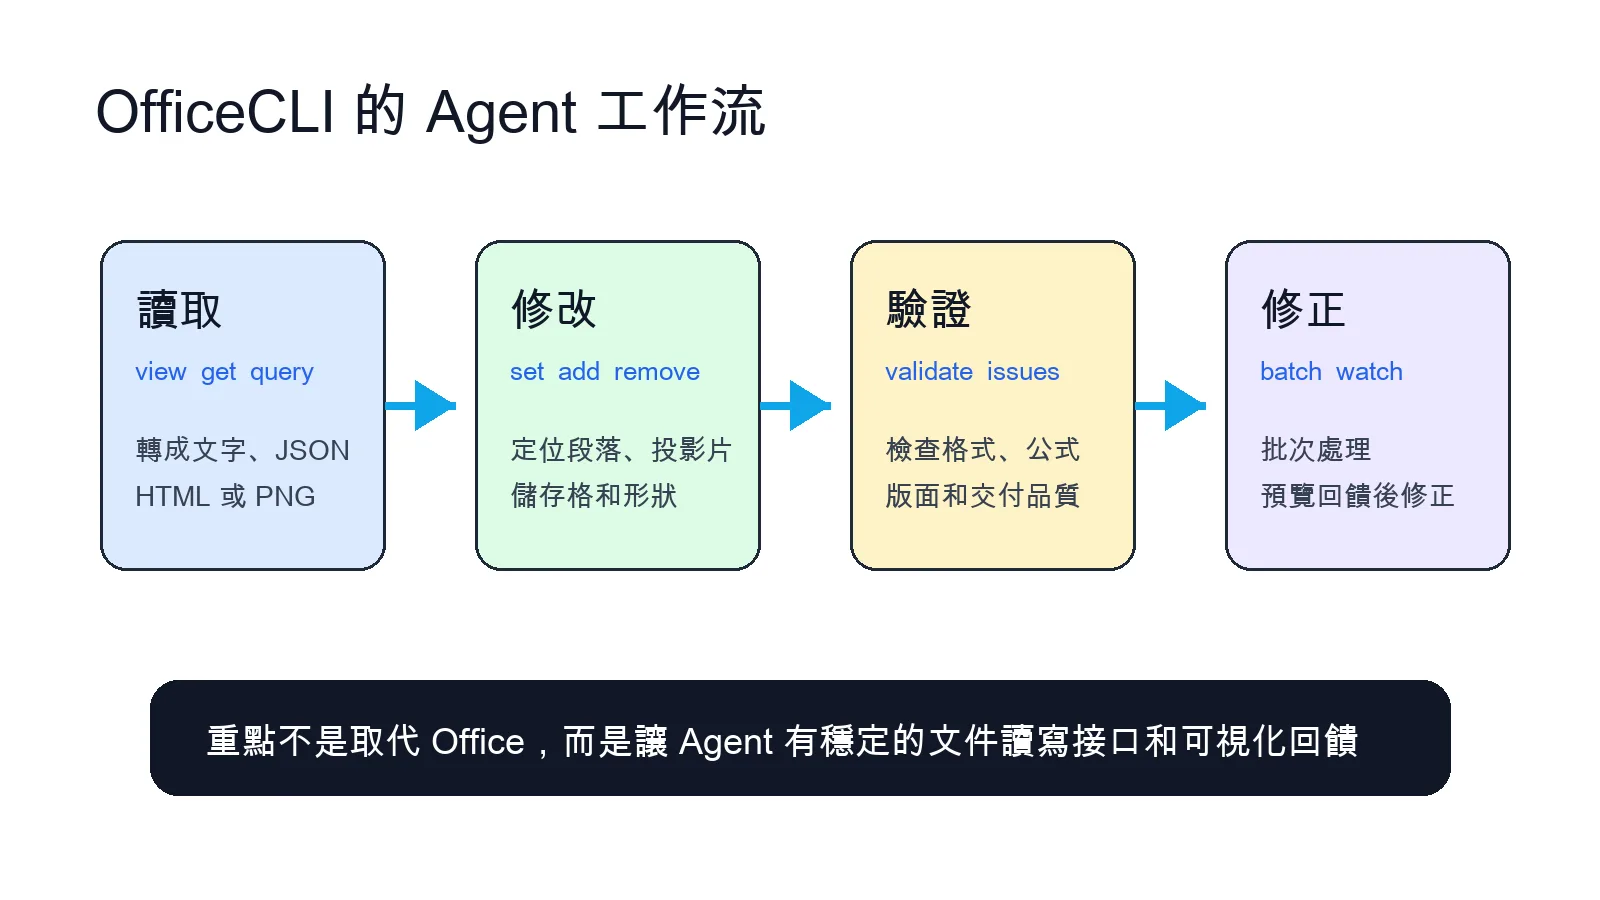
OfficeCLI 的價值在於讓 Agent 形成讀取、修改、驗證、修正的文件處理閉環。 為什麼 Agent 需要 OfficeCLI
文件不是只有文字,Word 有段落、樣式、頁首頁尾、註腳、目錄和追蹤修訂。
Excel 有公式、表格、樞紐分析、條件格式和資料驗證。P
owerPoint 有投影片、形狀、圖表、圖片、動畫和轉場。這些東西如果只轉成純文字,Agent 很容易看漏版面和結構。
OfficeCLI 的關鍵設計,是把文件轉成 Agent 能理解的結構化輸出,也能渲染成 HTML 或 PNG,這讓 Agent 不只知道文件裡有什麼文字,也能檢查排版結果。對需要交付正式報告、簡報、表格的人來說,這個 render → look → fix 的迴圈非常重要。
一行指令取代很多樣板程式碼
傳統 Python 套件通常要先 import library、建立物件、找到段落或投影片、設定屬性,最後再存檔,OfficeCLI 把這些操作變成像 shell command 一樣的命令。例如建立簡報、加入投影片、設定文字、讀取 outline、輸出 JSON,都可以用命令完成。
officecli create deck.pptx
officecli add deck.pptx / --type slide --prop title="Q4 Report"
officecli view deck.pptx outline
officecli get deck.pptx /slide[1] --json
這種形式對 Codex、Claude Code、Cursor、GitHub Copilot 這類 coding agent 很友善。Agent 不需要在不同文件格式之間背很多 Python API,只要知道 OfficeCLI 的命令和路徑規則,就能用一致方式操作三種 Office 文件。
OfficeCLI 能做哪些事
OfficeCLI 的命令不只 create 和 view。官方文件列出的核心能力包含 get、query、set、add、remove、move、swap、validate、batch、dump、merge、watch、mcp、raw 和 raw-set。這代表它不只是產生文件,也能讀取現有文件、定位元素、修改內容、驗證問題、批次處理和啟動 MCP server。
格式 可做的事 適合場景 Word 段落、樣式、表格、圖片、註腳、目錄、追蹤修訂 報告、自動合約、專案文件、審稿流程 Excel 儲存格、公式、表格、排序、條件格式、圖表、樞紐分析 月報、資料清理、預算表、營運儀表板 PowerPoint 投影片、形狀、圖片、表格、圖表、動畫、轉場 簡報初稿、銷售 deck、課程投影片、專案提案
如果你的工作已經在用 MarkItDown 把 Office 文件轉成 AI 可讀 Markdown ,OfficeCLI 可以補上另一半。MarkItDown 偏向讀取和轉換,OfficeCLI 更偏向讀寫修改和驗證。
最重要的是可視化回饋
Agent 產生文件最常見的問題,是內容看起來對,但交付檔打開後版面歪掉。OfficeCLI 的 built-in rendering engine 可以把 docx、xlsx、pptx 渲染成 HTML 或 PNG,再讓 Agent 檢查畫面。這對簡報和報告特別有用,因為很多錯誤不是純文字能看出來的。
例如 Agent 做完簡報後,可以先用 `officecli view deck.pptx html` 或 `officecli watch deck.pptx` 看預覽,再用 `officecli view deck.pptx issues –json` 找問題。這會讓文件生成變成工程流程,而不是一次性產出後靠人工開檔檢查。
安裝方式
OfficeCLI 官方提供多種安裝路線。AI Agent 可以先讀 skill file,讓 Agent 自己理解如何安裝和使用。一般開發者也可以直接跑安裝腳本,或透過 npm 安裝。
curl -fsSL https://officecli.ai/SKILL.md
curl -fsSL https://raw.githubusercontent.com/iOfficeAI/OfficeCLI/main/install.sh | bash
npm install -g @officecli/officecli
Windows 則可以用 PowerShell 安裝。它的核心好處是 single binary,文件處理不必依賴本機有沒有安裝 Office。這對伺服器、CI、Docker 或 Agent 執行環境很重要。
跟 Python 套件和 LibreOffice 怎麼選
python-docx、openpyxl、python-pptx 還是很實用,尤其是你已經有固定資料結構和成熟程式碼時,LibreOffice headless 也適合某些批次轉檔需求,OfficeCLI 的優勢,是它把三種 Office 文件收斂成同一套 CLI、JSON 和路徑模型,對 Agent 來說比較容易自我修正。
我會這樣選。如果只是固定模板套資料,Python 套件仍然簡單。如果要讓 Agent 自己讀一份未知文件、理解結構、修改局部、檢查品質,再回頭修正,OfficeCLI 會更接近 AI-native 的工作方式。如果團隊正在做 Codex 與 AI 代理工作流 ,這種工具就很值得放進標準工具箱。
可以怎麼接到 Codex
最務實的做法,是先把 OfficeCLI 當成專案工具使用。讓 Codex 讀文件、產生命令、執行修改,再用 validate 和 issues 做回饋。等流程穩定後,再寫成 skill。這和 讓 Agent 自己發現和使用 skills 的方向很一致。
舉例來說,可以做一個「每週報告 skill」。輸入資料來源後,Agent 先產生 Excel 摘要,再把重點轉成 PowerPoint,最後輸出 Word 報告。OfficeCLI 負責文件讀寫與驗證,Codex 負責資料整理、判斷和修正。若還需要把團隊知識一起查進來,也可以搭配 OpenWiki 這類 Agent 共用知識庫 。
我的判斷
OfficeCLI 的真正價值,是把 Office 文件從「人打開 GUI 慢慢改」變成「Agent 可以讀、改、看、驗證、再修正」的循環。它不一定取代所有 Python library,但很適合補上 AI Agent 在文件處理裡最缺的一塊:穩定操作接口加可視化回饋。
如果你的工作常常要做報表、合約、簡報、月報、批次文件修改,這類工具會越來越重要。未來的文件自動化不只是產生文字,而是讓 Agent 能理解文件結構,知道自己改了哪裡,也能在交付前先檢查成果。
延伸資源
FAQ
OfficeCLI 是什麼?
OfficeCLI 是給 AI Agent 和開發者使用的 Office 文件 CLI,可以建立、讀取、修改和驗證 Word、Excel、PowerPoint 文件。
OfficeCLI 需要安裝 Microsoft Office 嗎?
不需要。官方主打 single binary,不依賴本機 Office 安裝,適合伺服器、CI 和 Agent 執行環境。
OfficeCLI 和 python-docx、openpyxl 差在哪裡?
Python 套件適合固定程式流程。OfficeCLI 更適合 AI Agent,因為它提供一致的 CLI、JSON 輸出、路徑式元素定位、文件驗證和 HTML 或 PNG 預覽。
Codex 可以用 OfficeCLI 嗎?
可以。Codex 可以透過終端執行 OfficeCLI 命令。若把常用流程寫成 skill,就能讓 Codex 更穩定地處理報告、簡報和表格。
by Rain Chu 7 月 20, 2026 | AI , Tool
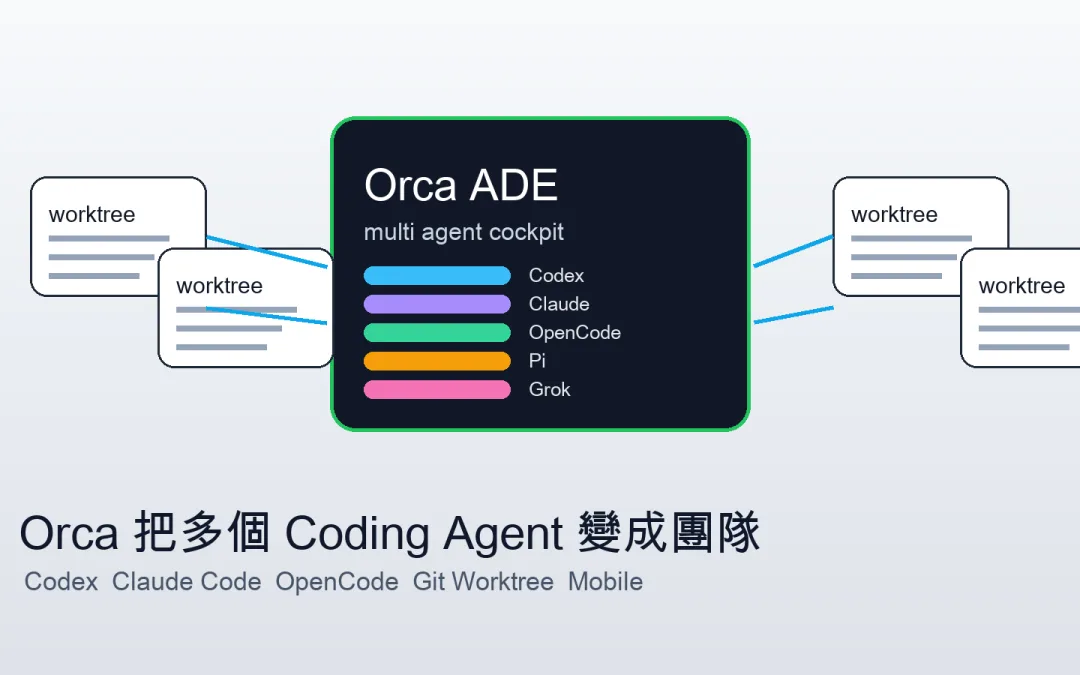
Orca 是 AI coding agent 的控制台,它把 Codex、Claude Code、OpenCode、Pi 這些 CLI agent 放進同一個開發環境,並且用 Git worktree 把每個任務隔離開來。這對已經開始同時使用多個 AI 編程工具的人很關鍵。
單一 Agent 的時代,問題通常是模型會不會寫,多 Agent 的時代,問題變成誰負責哪個分支、誰改了哪些檔案、怎麼比較成果、怎麼把最好的解法合回主線,Orca 想解的是後面這一段。
先講結論
Orca 是 stablyai 開源的 AI Development Environment,官方用法是把 Codex、Claude Code、OpenCode、Oh My Pi(OMP) 或其他 CLI agent 並排跑起來,每個 Agent 都在自己的 Git worktree 裡工作,最後由使用者比較差異、審查結果,再決定要合併哪一版。
我會把 Orca 看成 OpenWork 這類 OpenCode 工作台 的更完整版本,OpenWork 偏向把本地 Agent 工作桌面化,Orca 則更強調多 Agent orchestration、worktree 隔離、手機 companion、任務恢復和差異審查。
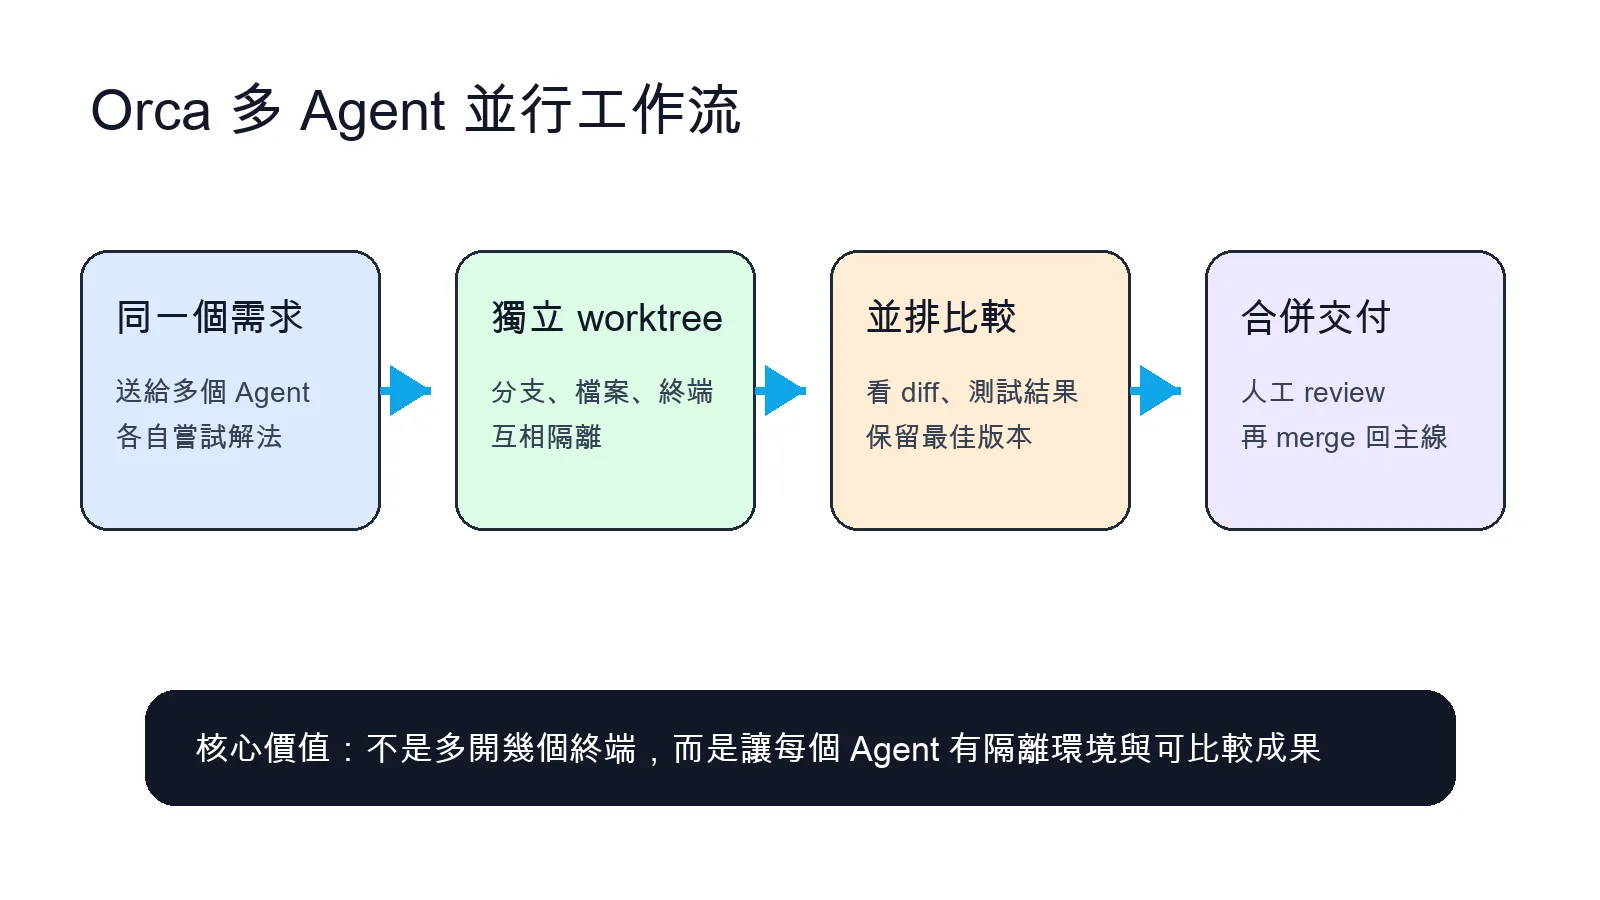
Orca 的核心不是多開終端,而是讓每個 Agent 有隔離環境,最後可以比較成果再合併。 Orca 解決的是多 Agent 失控問題
只跑一個 Codex 或 Claude Code 時,管理成本還可以接受,但當你同時讓三個 Agent 嘗試三種解法,麻煩就來了,檔案會互相覆蓋,終端輸出會混在一起,分支會弄亂,最後還要靠人回頭找哪一版比較好。
Orca 的做法是把每個 Agent 放進獨立 worktree。你可以把同一個 prompt 丟給多個 Agent,讓它們各自改一份程式碼,互不干擾。這很適合用在 bug 修復、重構、UI 改版、測試補齊和規格探索。
這和 用 Superpowers 建立 AI 開發紀律 的方向很接近。差別是 Superpowers 偏向規範和方法,Orca 偏向把這些工作流做進工具介面。
支援哪些 Agent
官方 README 的說法很直接:只要是能在 terminal 裡跑的 CLI agent,就可以放進 Orca。目前官方列出的包含 Claude Code、Codex、GitHub Copilot CLI、OpenCode、OpenClaude、OMP、Hermes Agent 等。這表示 Orca 不是綁定單一模型,而是把現有工具收進同一個 cockpit。
Agent Orca 裡的角色 適合任務 Codex 通用 coding agent 改程式、跑測試、整理專案 Claude Code 強推理與長任務 重構、架構判斷、需求拆解 OpenCode 本地或自訂模型入口 低成本實驗、本地 agent 工作流 OMP、Hermes 等 其他 CLI agent 特定工具或特定模型路線
如果你已經在用 Codex 與 ChatGPT Work 的 AI 代理工作流 ,Orca 的價值會更明顯。它不是要取代 Codex,而是讓 Codex 可以和其他 Agent 同場協作。
Parallel Worktrees 是核心
Orca 最重要的功能是 Parallel Worktrees。你可以把同一個需求發給多個 Agent,讓它們各自在不同 Git worktree 裡完成任務。完成後再比較 diff、測試結果和實作品質。這比在同一個 working tree 裡輪流叫不同 Agent 改檔安全很多。
我會把它想成「平行探索」。不是每個 Agent 都要成功,而是讓不同模型或不同 prompt 策略同時試錯。最後人做判斷,挑一個最好的版本進主線。這比盲信單一 Agent 更符合真實工程工作。
Terminal Splits 和任務恢復
Orca 也把多面板和多終端做進介面。Terminal Splits 讓你可以把多個 Agent、測試、伺服器和 logs 並排放著看。對前端專案、後端 API、資料庫 migration 這類需要同時觀察多個輸出的任務,這會比一直切 tab 順很多。
任務恢復也很重要。AI coding agent 常常不是一次跑完,尤其遇到長時間編譯、測試失敗、rate limit 或你臨時離開電腦。Orca 把任務狀態集中管理,讓你能回到原本的 Agent session,而不是重新猜它剛剛做到哪裡。
手機遠端和語音輸入不是噱頭
Mobile Companion 乍看像附加功能,但對長時間 Agent 任務其實很實用,你可以在手機上看 Agent 是否完成,收到通知後補一句 follow-up,或遠端啟動下一個任務。這讓 AI coding 從坐在電腦前等待,變成可以非同步監看。
語音輸入也類似,很多時候我們不是缺鍵盤,而是缺一個快速把想法丟給 Agent 的入口,若搭配清楚的任務模板,語音輸入可以用來快速交代需求、補充限制或要求重跑測試。
GitHub Issue 和定時審查
Orca 官方也強調 GitHub 和 Linear 的原生整合。你可以在 app 裡看 issue、PR、project board,並從任務直接開 worktree。這讓「看任務 → 啟動 Agent → 產生改動 → review diff」變成一條線,而不是在瀏覽器、終端、IDE、Git UI 之間來回切。
定時審查 repository 是另一個有意思的方向,它適合拿來做每日或每週檢查,例如 dependency 更新、測試覆蓋率、錯誤 logs、未完成 issue、重複程式碼。這類任務不一定需要最強模型,但需要穩定排程和可追蹤結果。
和 Playwright CLI、OpenWork 怎麼搭
Orca 管的是多 Agent 和 worktree。Playwright CLI 管的是瀏覽器自動化。OpenWork 管的是 OpenCode 和本地 Agent 桌面工作台。這些工具其實不是互斥,而是分別解決 AI 開發流程中的不同層級。
我的理想組合會是:Orca 負責多 Agent 任務隔離,Codex 或 Claude Code 負責實作,Playwright CLI 負責跑 UI 驗證,Graphify 或 OpenWiki 負責專案知識。這樣 Agent 就不是聊天框,而是完整開發系統的一部分。
安裝與使用入口
Orca 官方下載入口在 onOrca.dev,支援 macOS、Windows、Linux。Windows 使用者官方 README 也提醒可以抓較新的 RC 版本,因為有 Windows fixes。手機 companion 則提供 iOS App Store、TestFlight 和 Android APK。
桌面版:到 onOrca.dev/download 下載
原始碼:stablyai/orca GitHub
手機 companion:官方 README 提供 iOS、TestFlight 和 Android APK 連結
支援 Agent:Codex、Claude Code、OpenCode、GitHub Copilot CLI、Pi、Hermes Agent 和其他 CLI agent
我的判斷
Orca 的價值,不是讓你同時叫五個 Agent 然後期待奇蹟發生。真正有用的是隔離、比較、恢復、審查和合併,多 Agent 不是數量遊戲,而是工程流程問題。
如果你只是偶爾用 Codex 改一兩個檔案,Orca 可能有點重,但如果你已經常常同時開 Claude Code、Codex、OpenCode,或想把 issue 修復、UI 測試、code review 分配給不同 Agent,Orca 就值得試,它比較像從單兵作戰進入小隊協作。
延伸資源
FAQ
Orca ADE 是什麼?
Orca 是 AI Development Environment,可以把 Codex、Claude Code、OpenCode、Pi 等 CLI agent 放在同一個介面裡並行工作。
Orca 為什麼要用 Git worktree?
Git worktree 可以讓每個 Agent 在獨立工作區修改程式碼,避免互相覆蓋檔案,也方便最後比較 diff 和測試結果。
Orca 適合所有開發者嗎?
如果只是偶爾用一個 Agent 改小檔案,Orca 可能太重。若你常用多個 Agent、需要任務隔離、差異比較、手機遠端和任務恢復,Orca 就很適合。
近期留言