by Rain Chu 9 月 26, 2026 | AI , 圖型處理 , 影片製作
想讓電腦桌面多一個會揮手、坐下、開口說話的角色,可以先做一段 AI 影片,再把影片設為動態桌布,我們可以用 ComfyUI 負責串接生成流程,MiniMax H3 產生影像與聲音,桌布軟體負責播放,把這三件事分開理解,製作時就比較不會卡在錯的地方。
這篇教學的成品是預先生成、循環播放的桌面角色。 角色看似對著你說話,台詞其實已經寫在影片裡。
未來的目標是「我問一句,她能即時回答」,還需要另外建立對話系統。
先分清楚:會動的桌布,和能聊天的 AI 角色
動態桌布的核心是一個影片檔,角色何時眨眼、說哪一句話、什麼時候坐下,都在生成或剪輯時決定,播放時不會因為你突然發問,就改變下一句台詞,這種做法適合桌面裝飾、角色展示,以及固定內容的迎賓畫面。
即時互動則多了收音、語音辨識、語言模型、語音合成與嘴型同步。滑鼠互動或視線追蹤也要額外設計程式,不能只靠換一段提示詞。如果你要的是能接話的數位人,可以接著看本地 AI 數位人與語音互動流程 。
第一步:先準備乾淨的場景與人物素材
準備一張適合當桌布的背景,以及一張有使用權的人物圖片。
人物若有透明背景,合成時比較容易調整大小與位置。建議先使用單一成年角色、簡單服裝與固定場景,讓第一輪生成只處理一個動作。
背景可以是沙發、房間或書桌,人物要有足夠空間完成動作。
放在桌面上時,還要避開常用圖示的位置。不要把真實桌面圖示與工作列一起烙進背景影片 ,否則 Windows 原本的圖示疊上去,會出現兩層圖示,後續改位置也容易露餡。
接下來要決定素材怎麼送進模型,使用圖生影片的 I2V 工作流時,最好先做成一張完整首幀,讓人物真的站在房間裡。把人物圖與背景圖左右並排後直接丟進 I2V,模型可能把拼貼版面也當成場景的一部分。
若希望分別提供人物、場景等參考素材,應改用支援參考輸入的 R2V 工作流,按模板指定的位置連接素材。
I2V 與 R2V 的輸入用途不同,不能只換檔名就當作同一件事。需要整理多張素材時,可參考ComfyUI 多圖參考與圖片編輯 的處理思路。
第二步:從官方模板開始,模型檔案不要混用
先從ComfyUI 官方網站 取得軟體,更新到支援 MiniMax H3 的版本,再從模板庫的影片分類找到 MiniMax H3,也可以下載 Comfy-Org 的 I2V 範例工作流 ,依畫面上的缺少模型提示補齊檔案。
桌面角色從一張完成的場景圖出發,可先用 I2V。若要改用多素材參考,再看官方 R2V 模板 ,先把一套官方範例跑通,再接作者自訂節點,排錯會容易很多。
以下是本次核對的官方 I2V 模板所使用的檔案配置。檔名可能隨模板更新調整,實際下載時以當前模板與 Comfy-Org 模型頁 為準。
ComfyUI/models/
├── diffusion_models/
│   └── minimax_h3_fl2va_pruned_int8_convrot.safetensors
├── text_encoders/
│   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
├── loras/
│   └── minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors
└── vae/
    ├── minimax_h3_video_vae_fp16.safetensors
    └── minimax_h3_audio_vae_fp32.safetensors
主模型負責生成,文字編碼器處理提示內容,影片與音訊 VAE 則各有用途。不要只下載最大的模型檔,就以為其餘元件可以省略。官方模型頁也區分量化格式與執行環境,應照自己的環境選擇,不能把所有較小的檔案都視為可互換版本。
H3 的本地部署還牽涉系統記憶體與模型載入方式,不能只看顯卡名稱。進一步的環境整理可接著看MiniMax H3 本地部署與記憶體配置 ,再對照你實際載入的模型與模板版本。
第三步:先做一段短動作,不要一開始就塞滿劇情
第一輪可以用橫向構圖、固定鏡頭與較低的預覽解析度,先生成一段約 6 秒的動作。這裡的 6 秒是起步設定示例,並非效能保證。先確認角色外觀、動作與音訊都正常,再增加畫質與情節。
MiniMax H3 官方模型卡 標示的生成時長為 4~15 秒。想做 30 秒的完整演出,可以先拆成數段鏡頭再剪輯,或另外研究延伸工作流,不能把 30 秒當作標準模板必然支援的單段設定。
解析度也要跟著模板的選擇器走。ComfyUI 的 H3 教學 提醒,尺寸有對齊與像素量限制。初次嘗試不要任意輸入螢幕的完整高解析度,也不要把 API 提供的高解析度處理能力,直接套用到本地開放權重工作流。
提示詞示例:讓角色自然揮手,再回到休息姿勢
下面是為本文撰寫的起步提示詞,未經本機生成實測,重點是場景、動作與鏡頭都簡單,而且首尾姿勢接近,方便後續整理成循環影片。
固定鏡頭,橫向構圖,柔和的室內日光。
一名穿著藍綠色針織衫的成年女性坐在深灰色沙發上,人物外觀與參考圖一致。
她先自然地看向鏡頭,接著微笑並輕輕揮一次手,最後把手放回膝上,恢復安靜坐姿。
整段只有一位角色,背景保持穩定,動作平緩。
輕微室內環境聲,無對白、無背景音樂、無字幕。
先生成無對白版本,能比較容易看出畫面本身的問題。
等角色穩定後,再加一句短台詞,並參照官方提示詞指南 處理說話者、台詞與發聲時機。不要在第一輪同時要求換裝、走路、坐下、唱歌與密集字幕,否則很難判斷是哪一項條件讓結果失控。
若需要字幕,建議在影片確認後再用剪輯軟體加入,把字幕直接交給影片模型生成,仍可能出現字形錯誤或時間不準,後製文字也比較容易修改。
第四步:確認加速 LoRA 真的有進入生成路徑
下載加速 LoRA,只完成了準備工作。還要確認載入節點選到正確檔案、節點沒有被略過,並且輸出確實接到後面的模型與採樣流程。若節點被停用或旁路,硬碟裡有那個檔案也不會自動產生加速效果。
H3 的工作流與任務模式有對應關係,加速設定也有自己的採樣配置。
先依官方原生工作流文件 保留一整套相容設定,不要只因為想更快,就把不同任務的 LoRA、步數與模型任意混搭。加速後仍需重新檢查動作與聲音品質。
第五步:輸出影片,再用 Lively 設成動態桌布
生成完成後,先用一般播放器打開輸出的影片,檢查人物是否變形、背景有沒有漂移、聲音是否正常,以及片尾接回片頭時會不會突然跳動,如果首尾差異很大,可以縮短片段、重新安排動作,或在剪輯時做適度轉場。
Windows 使用者可以用免費開放原始碼的 Lively Wallpaper 播放影片桌布。
從官方專案提供的管道安裝後,開啟 Lively,把輸出的 MP4 拖進程式建立桌布,再套用到指定螢幕。多螢幕配置可依官方入門說明 調整。這是把成品落地到桌面的補充做法。
套用後,Windows 的圖示仍由作業系統顯示,影片只負責背景。
若桌布會反覆播放台詞,日常使用可能很干擾,建議先保留安靜版本,需要展示時再切換有聲版本。
跑不動、沒有聲音、下載要付費,怎麼判斷?
記憶體不足與藍畫面要分開處理
顯示記憶體不足時,先縮短影片、降低預覽解析度,並把批次數維持在 1。再確認是否載入了比預期更大的模型,以及系統記憶體是否也接近用滿。相同顯卡在不同模型格式、卸載策略與工作流下,結果可能差很多。
若整台電腦出現藍畫面,單憑這個現象無法判定就是顯示記憶體不足。先記錄錯誤代碼與當時設定,再檢查驅動、記憶體及系統穩定性。沒有完成實測之前,不應把某張 8GB 或 16GB 顯卡寫成一定可跑、一定不會當機的保證。
影片有畫面,卻沒有預期的聲音
先確認提示詞本來是否要求聲音,再檢查音訊 VAE、音訊相關節點及輸出是否接好。也要用播放器確認檔案音軌與靜音設定。最後才檢查桌布程式的音量,避免把生成端與播放端的問題混在一起。
先完成一段能穩定播放的短片
第一個里程碑可以很小:一張乾淨的場景圖、一個簡單動作、一段能順利輸出的影片。把它設成桌布後,再回頭調整畫質、循環接點與聲音。這樣每次只增加一個變因,比一開始追求長篇對話、換裝與高解析度更容易找到問題。
常見問題
桌面 AI 女友可以直接聽懂我說話嗎?
本文做法是播放預先生成的影片,不能即時接話。真正的語音互動還需要語音辨識、語言模型、語音合成與嘴型同步等元件。
MiniMax H3 可以用標準工作流一次生成 30 秒嗎?
官方模型卡標示的生成時長是 4~15 秒。30 秒成品可拆成多段再剪輯,額外的延伸工作流則要另外核對,不能視為標準模板的保證。
有 16GB 顯示記憶體就一定能跑嗎?
不能只憑顯示記憶體容量保證。模型格式、影片長度、解析度、系統記憶體與卸載方式都會影響結果,應先用短片及較低的預覽設定測試。
做好影片後,怎麼放到 Windows 桌面?
可以把輸出的 MP4 加入 Lively Wallpaper,再套用到指定螢幕。套用前先檢查首尾循環與音量,並避免把桌面圖示烙進影片背景。
by Rain Chu 9 月 11, 2026 | AI , skills
fal.ai 是一個生成式媒體 API 平台,它把多家圖片、影片、音訊與 3D 模型放在同一套介面下,開發者不必為每一家服務分別串接帳號與 SDK。再把操作規則包成 Codex Skill,就能讓 Codex 根據任務選模型、整理提示詞、上傳參考圖、送出工作、追蹤結果,最後把檔案下載到專案資料夾。
這套方式真正省下的是固定訂閱與切換工具的時間,不是讓付費模型突然變成免費。fal.ai 採預付點數與按量計費,圖片可能依張數或百萬像素計價,影片常依秒數、解析度或單次輸出計價。對偶爾生成、需要跨模型比較的人很有彈性,長期大量生成前則一定要先算成本。
先講結論,fal.ai 適合什麼人
做法 適合情況 優點 要注意什麼 fal.ai Playground 偶爾做一兩張圖或測模型 不用先寫程式,直接調參數 重複任務仍要手動操作 fal.ai 加 Codex Skill 固定工作流、批次產出、專案整合 能保存規則、命名、目錄與成本檢查 需要 API 點數與基本設定 單一平台訂閱 高度依賴固定工具與固定模型 介面完整,方案可能含較高用量 不用時仍可能支付月費 本地 ComfyUI 生成量大、重視隱私、已有顯卡 沒有每次 API 費用,控制度高 需要顯存、硬碟與維護經驗
如果每個月只做少量成品,又想在 Nano Banana、GPT Image、Seedance、Kling、MiniMax 等模型之間切換,按量付費通常比同時維持多個訂閱直覺。若每天大量產圖,或素材不能離開本機,則可以先看 Krea2 與 ComfyUI 圖像編輯工作流 ,影片生成也可參考 LTX 2.3 本地部署教學 。
Skill 的價值不是多一個聊天指令
Skill 可以把一套反覆使用的製作規則交給 Codex。它不只是記住「呼叫 fal.ai」,而是先判斷這次是文字生圖、圖片編輯、文字生影片或圖生影片,再選對端點與參數。不同操作通常有不同的模型 ID,文字生圖與圖片編輯即使使用同一模型,也不能假設共用同一個端點。
讀取 參考圖 資料夾,辨認可用素材與用途
先擴寫提示詞,再讓使用者確認內容與預估費用
依圖片、影片、編輯或動畫需求選擇端點
使用日期、模型與任務名稱建立可追蹤檔名
把結果下載到 完成檔,不要只留下暫時網址
保存請求 ID、模型 ID、主要參數與實際輸出
這和用 Codex 製作動畫的思路相同。工具負責執行,Skill 負責把規格、步驟與驗收條件固定下來。想再理解 Skill 如何控制視覺製作,可以延伸閱讀 7 個 AI 動畫 Skills 怎麼選 與 Codex 動態圖表和短影片工作流 。
建立專案與安裝 Python 套件
先在工作目錄建立 Skill、參考圖與完成檔資料夾,再建立獨立的 Python 環境。
mkdir -p .codex/skills/fal-media/scripts
mkdir -p 參考圖 完成檔
python3 -m venv .venv
source .venv/bin/activate
python -m pip install fal-client python-dotenv
到 fal.ai Dashboard 建立 API Key。只需要呼叫模型時先選 API 權限,不必一開始就給管理權限。金鑰只會完整顯示一次,取得後放進專案根目錄的 .env。
FAL_KEY=在這裡填入自己的金鑰接著把 .env 與輸出資料夾加入 .gitignore。不要把金鑰貼進聊天內容,也不要寫在 Skill、Python 程式或 Git 儲存庫裡。
.env
.venv/
完成檔/
先用圖片完成第一個測試
模型名稱與輸入欄位會隨模型不同而改變,送出前要先看該模型的 API 頁面。下面以 Nano Banana 2 的文字生圖端點示範。第一次先產一張低風險測試圖,確認金鑰、額度與輸出格式都正常。
from pathlib import Path
from urllib.request import urlretrieve

import fal_client
from dotenv import load_dotenv

load_dotenv()

result = fal_client.subscribe(
    "fal-ai/nano-banana-2",
    arguments={
        "prompt": "明亮自然光下的現代木質工作桌,畫面乾淨,寫實產品攝影",
        "num_images": 1,
    },
)

output = Path("完成檔/fal-nano-banana-2.png")
output.parent.mkdir(parents=True, exist_ok=True)
urlretrieve(result["images"][0]["url"], output)
print(output)
subscribe() 會自動進入佇列並等待結果,適合圖片與短時間測試。若要做圖片編輯,先用 fal_client.upload_file() 上傳本地參考圖,再依模型文件切換到編輯端點,例如 fal-ai/nano-banana-2/edit。輸入欄位可能是單一圖片或圖片陣列,不能直接把另一個模型的參數名稱搬過來。
影片任務改用佇列
影片生成時間較長,正式流程應使用 submit() 先取得請求 ID,再查狀態或接 webhook。這樣即使終端關閉,仍能用請求 ID 找回工作。下面使用 Seedance 2.0 文字生影片端點 ,參數依目前官方文件填寫。
from pathlib import Path
from urllib.request import urlretrieve

import fal_client
from dotenv import load_dotenv

load_dotenv()

handler = fal_client.submit(
    "bytedance/seedance-2.0/text-to-video",
    arguments={
        "prompt": "清晨的城市屋頂,一架小型無人機緩慢掠過,電影感廣角鏡頭,自然環境聲",
        "resolution": "720p",
        "duration": "5",
        "aspect_ratio": "16:9",
        "generate_audio": True,
        "bitrate_mode": "standard",
    },
)

print(f"request_id: {handler.request_id}")
result = handler.get()

output = Path("完成檔/fal-seedance-2.mp4")
output.parent.mkdir(parents=True, exist_ok=True)
urlretrieve(result["video"]["url"], output)
print(output)
這個範例最後仍用 handler.get() 等待完成,目的是讓第一次測試保持簡單。大量任務應保存請求 ID,定期查詢狀態,或把 webhook URL 傳給 submit()。新的 fal.ai 帳號通常從較低的同時執行數開始,超出的工作會留在佇列,不需要自己不斷重送。
可以直接交給 Codex 的 Skill 提示詞
先讓 Codex 建立 .codex/skills/fal-media/SKILL.md 與必要腳本。下面這段不是一次性的生圖提示詞,而是用來定義整套工作方式。
請在目前專案建立一個 fal-media Codex Skill,使用 Python fal-client。

工作規則
1. API 金鑰只從環境變數 FAL_KEY 讀取,不得顯示、記錄或寫入程式碼
2. 先判斷任務屬於文字生圖、圖片編輯、文字生影片或圖生影片
3. 呼叫前先讀取對應模型的官方 API 文件,確認端點 ID、必要欄位、輸出格式與目前價格
4. 讀取參考圖資料夾中的素材,列出準備使用的檔名與用途
5. 先把我的簡短需求整理成完整提示詞,但在產生前必須讓我確認提示詞、模型、解析度、時長、數量與預估費用
6. 圖片測試可使用 subscribe,影片與長時間任務使用 submit 並保存 request_id
7. 生成完成後立刻下載到完成檔資料夾
8. 檔名格式為日期時間、模型短名、任務短名
9. 同時保存一份 JSON 紀錄,包含端點 ID、參數、request_id、輸出路徑與執行時間
10. 失敗時先回報錯誤與可能費用,不要自動無限重試

請先建立檔案與顯示差異,不要實際呼叫付費 API。
Skill 建好後,日常任務可以簡化成一段明確需求。
請使用 fal-media Skill,把參考圖中的咖啡機做成 5 秒 16:9 產品影片。
鏡頭從正面特寫緩慢拉遠,保留機身外型與顏色,加入清晨窗光和少量蒸氣。
先比較兩個適合的圖生影片模型,列出各自預估費用、速度與限制。
等我確認模型與完整提示詞後才開始生成。
提示詞要固定哪些資訊
目的與輸出類型,例如商品首圖、社群短片或角色動作測試
主體、場景、動作與必須保留的特徵
構圖、鏡頭、光線、材質與色彩
尺寸、比例、時長、解析度與輸出數量
參考圖的用途,例如保留人物、只取服裝或只參考構圖
避免事項,例如不要改 Logo、不要增加文字、不要改變產品比例
成本上限與開始前是否需要人工確認
擴寫提示詞不是把形容詞堆得越多越好。對圖片而言,主體、構圖、光線與限制比華麗文字重要。對影片而言,還要明確交代起始狀態、動作順序、鏡頭移動、時間長度與聲音。一次只測一個主要變因,才能知道品質改變來自模型、提示詞還是參數。
不是免費,只是把固定月費改成按量計費
fal.ai 使用預付點數。依官方說明,成功輸出才會依模型單位計費,排隊時間與伺服器錯誤通常不計費,但若使用者端錯誤發生前已經啟動 GPU 工作,仍可能產生費用。已購買點數目前有期限,模型價格也可能調整,所以文章裡的舊價格不能代替每次執行前的模型頁面。
圖片先用一張與較低解析度測試
影片先做 4 到 5 秒,再決定是否延長
送出前顯示模型單價、數量、秒數與預估總額
設定單次成本上限,超過就停止並要求確認
不要在失敗後自動切換更貴模型
保存 request_id,避免誤以為失敗而重複送出
對只想偶爾試一張圖的人,直接使用 Playground 會更省事。對已經每天用 Codex 管專案的人,Skill 的價值才會明顯,因為相同的命名、資料夾、模型選擇與確認規則都能重複使用。至於高頻生成,應把 fal.ai、固定訂閱與本地工作流的實際月成本放在一起比較。
API 金鑰、參考圖與成品都要保護
前端網頁或桌面 App 不能把 FAL_KEY 直接打包進程式。瀏覽器程式碼可被查看,應由自己的後端代理請求,再由伺服器附加金鑰。桌面工具也應使用系統安全儲存區或後端,而不是把金鑰放在可讀取的設定檔。
資料保留同樣不能忽略。fal.ai 文件目前指出,JSON 請求與回應預設可能保留一段時間,可透過 X-Fal-Store-IO 控制平台不要保存這部分內容。但生成的媒體網址屬於另一件事,拿到網址的人可能可以存取,且 CDN 檔案不是永久保存。敏感素材應先確認模型與平台政策,完成後立刻下載,並依需求設定媒體生命週期。
我的建議工作流
先在 fal.ai Playground 用同一段需求比較兩個模型
確認畫質、速度、授權、輸入格式與目前單價
把選定端點寫進 Skill 的模型對照表
讓 Codex 擴寫提示詞並列出預估成本
人工確認後只做一張圖或 5 秒影片
檢查主體一致性、文字、構圖、聲音與瑕疵
通過後才增加解析度、時長或數量
下載成品並保存參數與 request_id
如果最後還要把多段素材組成完整內容,可以把生成素材交給 OpenMontage 本地影片工作流 或 HyperFrames。
fal.ai 比較像生成引擎與模型入口,Skill 負責製作規則,剪輯與編排工具則負責把素材變成能交付的作品。
FAQ
fal.ai 是免費的嗎
不是。它主要採預付點數與按量計費,不同模型、解析度、秒數與輸出數量會影響費用。少量使用可能比維持多個月費訂閱划算,但不代表零成本。
一定要建立 Codex Skill 嗎
不一定。只測一次模型,直接用 Playground 最快。需要反覆處理參考圖、提示詞、模型選擇、成本確認、下載與命名時,Skill 才能省下大量重複操作。
可以把 API Key 貼給 Codex 嗎
不要。把金鑰存成 FAL_KEY 環境變數,並讓程式直接讀取。對瀏覽器與公開 App,必須透過後端代理,不能把金鑰放在前端。
生成完成後可以只保存網址嗎
不建議。CDN 有保留期限,且媒體網址可能被持有網址的人存取。完成後應立即下載到自己的儲存空間,並保存請求 ID 與模型參數。
官方資源
by Rain Chu 8 月 28, 2026 | AI , GGUF , Stable Diffusion , 圖型處理 , 影片製作 , 繪圖
LTX 2.3 把畫面、聲音、人物動作與鏡頭運動放進同一套生成流程,還能透過 ComfyUI 在本機執行,對只有 8GB 顯存的使用者來說,社群 GGUF 量化工作流確實打開了一扇門,但「能跑」不等於完整模型全放進顯存,也不代表每台電腦都能在不到一分鐘內完成。
我會把 LTX 2.3 定位成一個適合實驗同步影音、角色短片與圖生影片的本地模型,它可以成為 OpenMontage 本地 AI 影片工作流 裡的生成引擎,也可以獨立放在 ComfyUI 裡反覆調整。真正要先弄清楚的,是權重版本、顯存、系統記憶體與工作流之間的關係。
LTX 2.3 改進了什麼
LTX 2.3 官方頁面 把這次更新整理成幾個核心方向。新的 VAE 改善髮絲、材質與邊緣細節,較大的文字連接器能理解多主體、空間關係、動作與鏡頭指令,圖生影片減少了畫面凍結與只做平移縮放的情況,音訊也換上新的 vocoder,降低雜音、靜音缺口與突然中斷。
支援文生影片與圖生影片
能在同一個流程生成畫面與同步音訊
改善人物微表情、動作與鏡頭運動
原生支援最高 1080×1920 的直式影片
提供完整權重、Distilled、FP8 與社群量化方案
官方也提醒,LTX 2.3 採用新的 latent space,舊版 LoRA 不能直接當成完全相容的資產,通常需要重新訓練。這點比單純更新模型檔更重要,已經累積大量 LTX 2 工作流的人要先做相容性測試。
8GB 顯卡能跑,但要先拆掉一句話裡的誤會
官方 ComfyUI 文件 把標準本地工作流的前置條件列為 32GB 以上顯存與 100GB 以上可用磁碟空間。8GB 顯卡路線使用的是社群 GGUF 量化權重、模型卸載與系統記憶體,不是把 BF16 完整權重硬塞進 8GB 顯存。
版本 適合用途 主要取捨 BF16 Dev 品質驗證與正式輸出 硬體需求最高 Distilled 快速迭代與工作流測試 速度優先 FP8 較低顯存的官方量化路線 品質與資源需求折衷 GGUF Q4 或 Q5 8GB 到 16GB 顯存的社群工作流 依賴 CPU offload、系統記憶體與相容節點
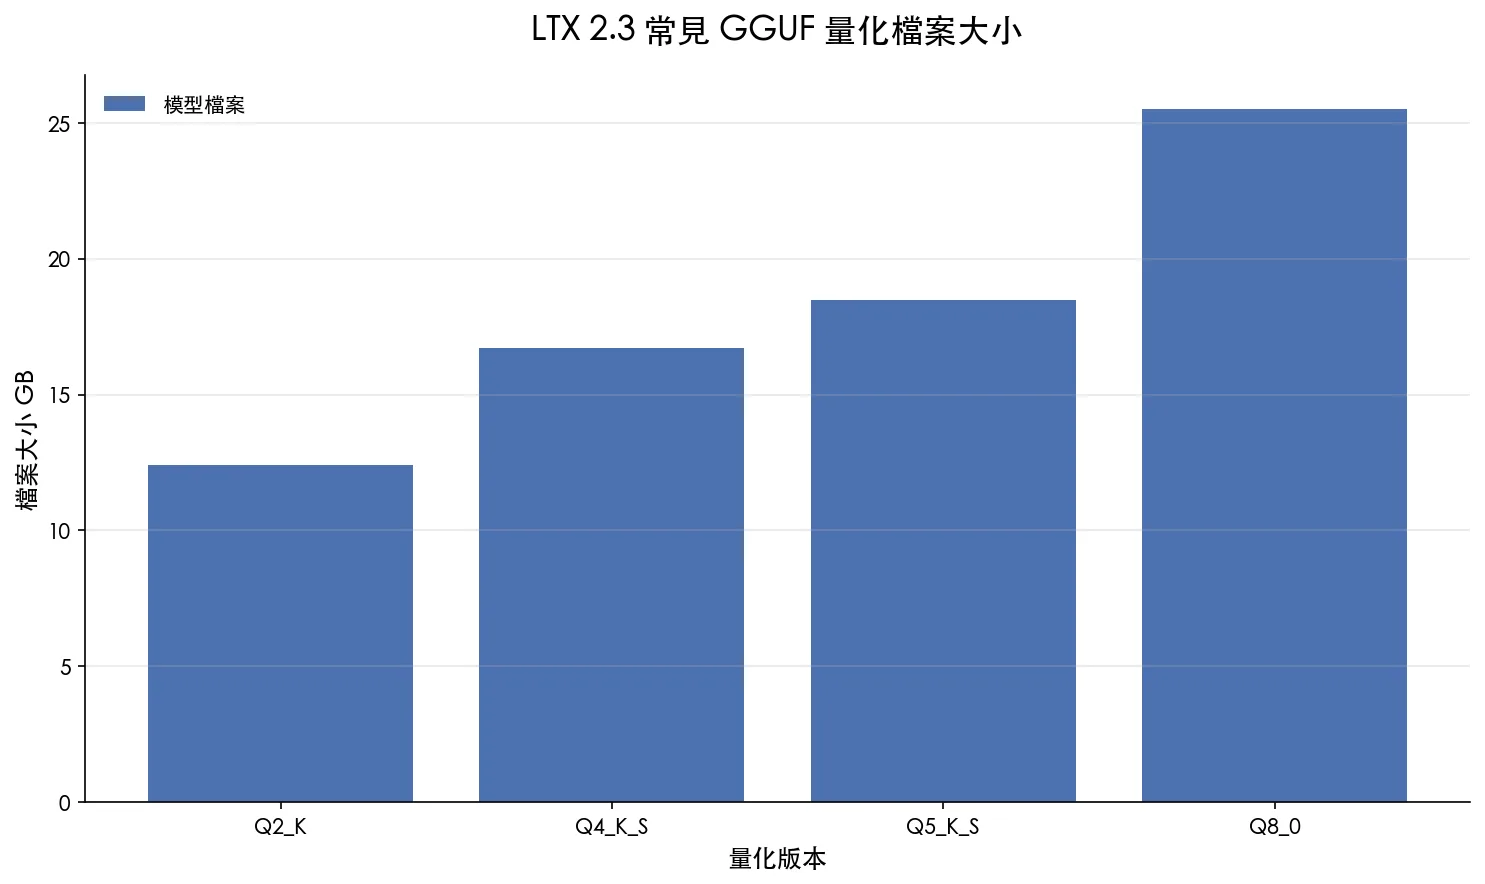
以 QuantStack 的 LTX 2.3 GGUF 為例,Q5_K_S 檔案約 18.5GB,已經大於 8GB 顯存。能在 8GB 顯卡執行的關鍵,是工作流不要求所有資料同時留在 GPU。代價是更吃系統記憶體與資料搬移時間。想進一步理解 GGUF 與量化的角色,也可以對照站內的本地模型推理框架比較 。
GGUF 檔案大小不等於最低顯存需求,但能直接看出為什麼 8GB 路線必須依賴卸載與系統記憶體 我的硬體建議很簡單。,GB 顯存可以從 Q4 或經驗證的低顯存工作流開始,系統記憶體最好準備 32GB 以上,12GB 到 16GB 顯存會比較有調整空間。若要使用 BF16、較高解析度、長片段或多階段放大,32GB 以上顯存才接近官方設定,實際速度還會受 GPU 架構、RAM、磁碟、解析度、影格數與節點版本影響。
最省事的安裝方法是官方模板
第一次安裝不要急著手動搬十幾個檔案,先把 ComfyUI 更新到支援 LTX 2.3 的版本,再用模板庫建立一條能正常執行的基準工作流,這和我整理 Ideogram 4 的 ComfyUI 本機部署 時採用的思路一樣,先跑通官方基線,再加入量化與自訂節點。
開啟 ComfyUI Desktop 或現有 ComfyUI
完成程式與前端更新後重新啟動
進入 Templates 並切換到 Video
搜尋 LTX-2.3
先安裝 Image to Video 與 Text to Video 模板
按下 Download all 取得必要模型
重新啟動後先用低解析度與少量影格測試
官方建議先用 480×720 與 41 到 81 個影格確認流程,工作流穩定後,再提高解析度、片長與品質。這一步看起來保守,卻能很快分辨問題來自模型、節點、顯存,還是提示詞。
手動安裝時,模型應該放在哪裡
ComfyUI Desktop、Portable 與自行安裝版的根目錄可能不同,最穩的方法是從 ComfyUI 介面打開模型資料夾,再依下面的相對路徑放置。不要直接照抄別人的 Windows 使用者名稱。
檔案類型 建議路徑 用途 官方主模型 models/checkpoints/LTX-Video BF16、Distilled 或官方檢查點 社群 GGUF models/unet 交給 GGUF Loader 載入 文字編碼器 models/text_encoders Gemma 3 與 LTX 文字投影 視訊與音訊 VAE models/vae 解碼影像、聲音與預覽 LTX 2.3 LoRA models/loras/LTX-2.3 Distilled、風格或控制能力
原始權重可從 LTX 2.3 Hugging Face 取得。官方推理程式與訓練工具位於 Lightricks LTX-2 GitHub ,ComfyUI 節點與範例工作流則在 ComfyUI-LTXVideo 。
匯入工作流後出現紅色節點怎麼辦
紅色節點通常不是模型壞掉,而是工作流引用了本機尚未安裝的自訂節點。先在錯誤視窗選擇 Install Missing Custom Nodes,完成後按 Apply Changes 並重新啟動,若仍缺少 Fast Groups Bypasser 類節點,可在 Manager 搜尋並安裝 rgthree-comfy 。
GGUF 權重還需要 ComfyUI-GGUF 。安裝後重新啟動,在畫布空白處搜尋 GGUF Loader,把原本模型載入器的輸出改接到工作流的 model 輸入,再重新整理節點並選擇 Q4 或 Q5 檔案。
一個可以直接改寫的繁中提示詞
LTX 2.3 的提示詞不要只寫「讓照片動起來」。把人物動作、對白、聲音、鏡頭、畫質與禁止項目分開,模型比較容易理解時間順序與同步關係。
場景與動作
一名年輕女子站在安靜的室內,先看向鏡頭,再輕輕吸一口氣,以略帶緊張但自然的神情說話。嘴唇清楚說出指定的中文台詞,嘴型與發音準確同步。

聲音
自然的年輕華語女聲,語氣柔和、真實、略帶緊張,像日常交談,不要誇張。保留輕微呼吸聲與安靜室內環境音,不要配樂。

鏡頭
鏡頭緩慢推近臉部,只有很輕微的手持感。淺景深,焦點穩定,自然室內光線。

畫面品質
寫實電影感,皮膚紋理自然,眼神與微表情細膩,髮絲運動合理,動作流暢,人物身份保持一致。

避免項目
不要字幕,不要畫面文字,不要額外人物,不要旁白,不要機械聲,不要誇張表情,不要臉部變形,不要嘴唇變形,不要突然移動鏡頭。
實際使用時,把第一段換成你的角色、場景、動作與台詞即可。先固定一個鏡頭與一個主要動作,再逐步增加人物、轉場與複雜聲場。一次要求太多事件,往往比模型能力不足更容易造成身份漂移。
中文對白可用,但字幕最好留給後製
實測裡最值得記下來的缺點,是中文畫面文字仍可能出現亂碼,即使官方表示文字渲染已改善,這不代表長句中文字幕已經可靠,若提示詞要求中文對白,模型有時還會自行生成錯誤字幕。
提示詞明確加入「不要字幕、不要畫面文字」
先生成乾淨畫面與聲音
輸出後再用剪輯軟體或字幕工具加入繁中字幕
若聲音品質不穩,可把畫面生成與語音生成拆成兩條工作流
需要更細的角色音色控制時,可以搭配Qwen3-TTS 音色設計工作流 ,讓 LTX 2.3 專注畫面,再由語音模型與後製負責台詞品質,這通常比強迫單一模型同時把中文聲音與中文字都做到完美更務實。
本地還是雲端,差別不只在費用
本地工作流的優點是素材不必上傳第三方、模型與節點可自行調整,而且安裝完成後沒有逐秒 API 費用,缺點是模型檔很大,節點版本容易衝突,還要自己處理顯存與輸出速度。若你比較在意快速試模板與交付,也可以對照RunningHub 的雲端 ComfyUI 工作流 ,再決定控制權與便利性哪個重要。
解除限制版本不是品質保證
社群常用「無審查」或「解除限制」描述修改版權重。這只代表輸入限制可能不同,不代表畫質、授權、安全性或商用條件比官方版本更好。下載前要確認模型來源、授權條款與檔案雜湊,人物照片與聲音也必須取得同意。
尤其是換臉、移除人物、替換台詞與生成擬真人物時,更要避免冒用身份、未經同意的私密內容與誤導性成品。LTX 官方也有商業授權條件,企業使用前應直接閱讀最新授權,而不是只看模型能不能下載。
下載與參考資源
我的結論
如果目標是直式角色短片、圖生影片、帶環境音的短場景,LTX 2.3 很值得測,若目標是穩定中文字、長篇敘事或大量商業輸出,仍要把字幕、語音、剪輯與品質檢查拆成獨立步驟。模型負責生成,工作流負責把結果變成可以交付的作品。
FAQ
LTX 2.3 真的能在 8GB 顯卡執行嗎
可以,但通常要使用 GGUF 量化權重、CPU offload 與足夠的系統記憶體。8GB 指的是可嘗試的顯存門檻,不代表完整模型全放在 GPU,也不保證固定生成速度。
新手應該選 BF16、FP8 還是 GGUF
先用官方 Distilled 或 FP8 模板確認工作流。顯存不足再改用 GGUF。BF16 適合硬體充足並且重視品質的人,GGUF 適合願意接受卸載、速度與相容性取捨的低顯存使用者。
為什麼匯入工作流後有紅色節點
多半是缺少自訂節點或節點版本太舊。先執行 Install Missing Custom Nodes,再更新 ComfyUI、ComfyUI-LTXVideo、rgthree-comfy 與 ComfyUI-GGUF,完成後重新啟動。
中文對白為什麼會出現亂碼字幕
模型可能把對白理解成需要同步生成的畫面文字,而中文長句仍不穩定。提示詞加入不要字幕與不要畫面文字,先生成乾淨影音,再於後製加入繁中字幕最可靠。
LTX 2.3 可以離線使用嗎
模型、節點與依賴下載完成後可以在本機執行。首次安裝、更新模型或補齊節點仍需要網路,並且要預留足夠磁碟空間。
by Rain Chu 8 月 6, 2026 | AI , 影片製作 , 繪圖
MiniMax H3 把文字、圖片、影片和音訊放進同一套生成系統,可以一次產生含有人聲、環境音與音樂的影片,它不只支援文生影片和圖生影片,也能指定首尾幀,或用多張圖片、參考影片與聲音控制角色、運鏡和音色。對本地 AI 影片工作流來說,這比單純追求畫質更重要。
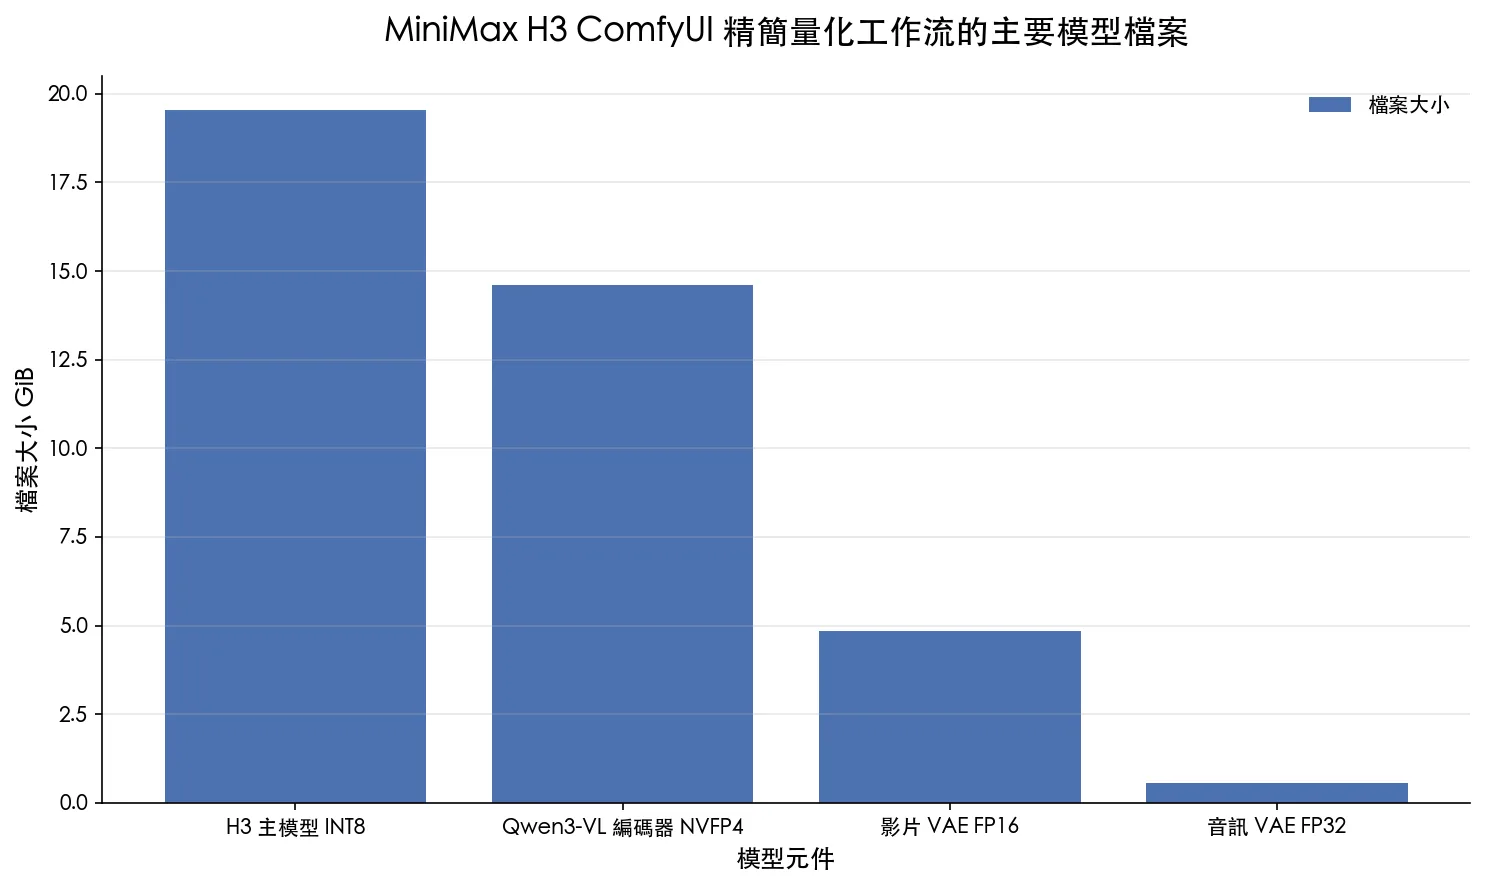
先講結論。MiniMax H3 已經提供可下載權重,也有 ComfyUI 原生模板,但它不是一個只需要 8GB 的小模型。官方精簡量化工作流的主要檔案合計約 39.55GiB。8GB 顯存要依靠模型卸載、系統記憶體和虛擬記憶體,生成速度與穩定度都會受到影響。
MiniMax H3 是什麼
MiniMax H3 是通用型全模態生成系統。它可以理解由文字、圖片、影片和音訊組成的上下文,再共同預測影片與立體聲音訊,官方規格支援 4 到 15 秒、24 FPS、最高 2K 的輸出,並能處理中文、英文、日文、韓文等 11 種較穩定的對話語言。
項目 官方規格 實際意義 輸入 文字、圖片、影片、音訊 可混合角色、場景、動作、運鏡與聲音參考 輸出長度 4 到 15 秒 適合廣告鏡頭、短片段與分鏡 幀率 24 FPS 以電影常用幀率直接產生 本地基礎解析度 短邊 768px 16 比 9 約為 1344 乘 768 2K 透過 H3-Regenerate-2K 目前需要官方服務,完整模組尚未釋出 音訊 32kHz 立體聲 人聲、音效與音樂和畫面共同生成
Reference-to-Video 模式最多可接 9 張圖片、3 段參考影片與 3 段音訊。每段影片或音訊需要介於 2 到 15 秒,所有參考影片的總長度不超過 15 秒,混合輸入最多 12 個檔案。音訊不能單獨作為唯一參考,必須搭配圖片或影片。
Open weights 不等於完整開源
MiniMax H3 比較準確的稱呼是「開放權重」,完整系統由 H3-Context-IR、H3-Base 和 H3-Regenerate-2K 組成,目前可在本地執行的是 H3-Base。負責理解複雜多模態素材的 H3-Context-IR,以及把 768p 重新生成為 2K 的 H3-Regenerate-2K 都尚未釋出,只能透過官方 API 使用。
官方也說明,初始版本只提供 full attention 推理,用來降低長序列運算量的 sparse attention 會在後續更新,因此,本地工作流和官方線上 2K 成果不一定完全相同,提示詞越簡略,缺少 Context-IR 的差異越明顯。
H3 的架構為什麼這麼大
H3-Omni-Transformer 是 33B dense 單流 Transformer,其中約 13B 參數位於 AdaLN 相關分支,推理時可以預先計算並快取這些 AdaLN 調制結果,所以 ComfyUI 提供 pruned 版本,把不需要每次載入的權重移除,這就是 pruned INT8 主模型能從完整 BF16 的 61.73GiB 降到約 19.53GiB 的原因。
文字和多模態條件則由 Qwen3-VL 32B 編碼器處理。最後還要載入影片 VAE 與音訊 VAE。因此,H3 不是只下載一個 safetensors 就能運作,而是一組彼此配合的模型元件。
官方精簡量化工作流的四個主要檔案合計約 39.55GiB。檔案可以在運作時分批卸載,但磁碟與系統記憶體仍要保留足夠空間。 元件 建議量化檔 大小 放置目錄 H3 FL2VA 主模型 pruned INT8 ConvRot 19.53GiB models/diffusion_models Qwen3-VL 編碼器 NVFP4 AWQ 14.61GiB models/text_encoders 影片 VAE FP16 4.85GiB models/vae 音訊 VAE FP32 0.56GiB models/vae
如果要使用多參考素材的 R2V 模式,主模型要改成 ref2va 版本,FL2VA 適合文生影片、圖生影片與首尾幀,Ref2VA 才是用角色、動作、運鏡和聲音參考生成新片段的版本,兩套主模型不能混用。
Arena 成績怎麼看
2026 年 8 月初的 Arena 快照中,MiniMax H3 在圖生影片約為 1476 分,在文生影片約為 1455 分,圖生影片和 Seedance 2.0 的差距只有約 2 分,文生影片也進入前段班,由於 Arena 會持續加入新模型與新投票,排名與分數會變動,這組數字只能當作發表初期的參考。
實際價值不只在單張畫面。武俠對話、角色特寫、太空飛行、動態 MV 與商品廣告等案例,最明顯的提升是鏡頭、口型、音效和場景能放在同一條時間軸裡。這和先產生無聲畫面,再交給另一個模型補音效的流程不同。想比較其他本地影片工具,可以延伸閱讀 OpenMontage 本地 AI 影片工作流 。
用 ComfyUI Desktop 安裝 MiniMax H3
最簡單的方法是安裝最新版 ComfyUI Desktop 。官方要求 ComfyUI 0.30.0 或更新版本,啟動後進入 Template Library,選擇 Video,再搜尋 MiniMax H3。可以先從 T2V 或 I2V 模板開始,缺少的官方模型會顯示下載提示。
更新 ComfyUI 到 0.30.0 或更新版本
開啟 Template Library
進入 Video 類別並選擇 MiniMax H3 T2V、I2V 或 R2V
依模板提示下載模型
先將 duration 設為 4 到 6 秒
將 megapixels 設為 0.2 到 0.4 進行預覽
確認人物、動作和聲音正確後,再提高解析度與長度
完整檔案結構如下。實際安裝根目錄會因 Windows、macOS、Linux 和 Desktop 版本而不同,建議從 ComfyUI 選單開啟模型目錄,不要直接照抄別人的 AppData 絕對路徑。
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── minimax_h3_fl2va_pruned_int8_convrot.safetensors
│   ├── text_encoders/
│   │   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
│   └── vae/
│       ├── minimax_h3_video_vae_fp16.safetensors
│       └── minimax_h3_audio_vae_fp32.safetensors
└── custom_nodes/
如果你已經在使用 ComfyUI,可以參考 Krea2 的 ComfyUI 多圖工作流 理解模型目錄與節點連線,想把工作流放到雲端管理,也可以看 RunningHub 與 ComfyUI 工作流平台 。
8GB 顯存真的能跑嗎
有機會啟動,不代表適合長時間使用,8GB 顯存需要把大量權重卸載到系統記憶體,Windows 可能還會進一步使用虛擬記憶體。這會讓 GPU 在運算與資料搬移之間等待,也會增加 SSD 讀寫。解析度、影片長度、參考素材數量和 VAE 解碼都可能造成記憶體尖峰。
8GB 顯存 :從 0.2MP、4 秒和單一參考圖開始,準備充足系統記憶體與 NVMe 空間12GB 顯存 :較適合 480p 附近的短片預覽,仍需模型卸載16GB 顯存 :可以嘗試 0.2MP 到 0.4MP,再用影片放大工具處理24GB 以上 :工作流更實用,但完整 768p 與多參考素材仍要監看記憶體
比較務實的做法是先用 864 乘 480 或更低解析度確認運鏡和角色一致性,再進行高解析重繪或 2K 放大,Sage Attention 也能改善速度,ComfyUI 官方文件表示,在相容硬體與正確 CUDA 環境下,速度可能接近兩倍,但部分層仍會回退到標準 attention。
Qwen3-VL Ultra Heretic H3 不是影片主模型
使用者提供的 Qwen3-VL-32B Ultra Heretic H3 ComfyUI 是 H3 的條件編碼器與提示詞 generation tail,不是 MiniMax H3 的影片生成主模型。它建立在經過 Heretic 修改的 Qwen3-VL 32B 上,主要作用是減少拒答,並在 ComfyUI 裡產生或強化 H3 提示詞。
檔案 用途 大小 Heretic BF16 encoder Qwen3-VL 第 0 到 49 層與完整 vision tower 47.97GiB Heretic INT8 ConvRot encoder 較省記憶體的條件編碼器 24.55GiB INT8 generation tail 第 50 到 63 層、final norm 與 LM head 7.09GiB
只想使用官方 H3,不需要下載這套 Heretic 檔案。要使用提示詞增強器,通常下載 INT8 encoder 與相符的 generation tail,兩個檔案都放到下面的目錄。
ComfyUI/models/text_encoders/H3/如果還想把這組 encoder 與 tail 當成獨立的本地 Qwen3-VL 文字或視覺模型,需要額外安裝 TextGen 節點。
cd ComfyUI/custom_nodes
git clone https://github.com/ethanfel/ComfyUI-H3-Qwen3VL-TextGen.git
cd ComfyUI-H3-Qwen3VL-TextGen
pip install -r requirements.txt
重新啟動 ComfyUI 後,使用 H3 Qwen VL Generation Tail Loader 和 H3 Qwen VL Generate Text 節點。如果出現 Missing Node Packs,先確認 ComfyUI 已更新,再確認自訂節點資料夾沒有多包一層 ZIP 目錄,最後使用 ComfyUI 自己的 Python 環境安裝 requirements。
Heretic 與解除限制模型的風險
Heretic 類模型會修改拒答行為,但不保證完全移除安全限制,也不保證品質不受影響,模型卡的測試是在 RTX 5090 32GB、特定 ComfyUI commit、PyTorch 2.8 與 CUDA 12.8 環境完成。不同顯示卡與套件版本可能出現完全不同的結果。
把拒答變少不代表產出的內容合法。人物肖像、聲音複製、品牌素材、成人內容和受版權保護的角色都有額外風險。建立公開或商業服務時,應保留內容審查、權限控制與人工確認,不要把解除限制當成跳過責任的工具。
MiniMax H3 提示詞怎麼寫
H3 的提示詞不是堆疊形容詞,而是建立一條可播放的時間軸,先交代整體風格與初始構圖,再依時間描述鏡頭、動作、對話、環境音與配樂,官方建議至少保留三個欄位。
integrated_multimodal_description:
[Shot 1] 真人電影風格,中景。雨夜的老街上,一名穿深色風衣的女子站在霓虹招牌下。攝影機以緩慢的小幅度向前推進。她抬頭看向街口,雨水沿著臉頰滑下。
[Shot 2] At 00:04.000, the camera cuts to a close-up。女子壓低聲音說:<d>[Chinese] 他終於來了。</d> 遠方車燈穿過雨霧,她握緊手中的信封。

overall_soundscape:
持續的雨聲、遠方車流、鞋底踩過積水的聲音。對話清楚,口型與發聲時間同步。

non_diegetic_music:
低沉的大提琴與稀疏鋼琴,緩慢節奏,在第二個鏡頭逐漸提高張力。
第一個鏡頭不需要時間標記。
第二個鏡頭開始使用明確時間,例如 00:04.000。
運鏡最好同時寫出類型、幅度與速度,例如 slow small-amplitude push in。
對話放在 d 標籤裡,並保留語言標記。
環境中真正存在的聲音放在 overall_soundscape,只有觀眾能聽見的配樂放在 non_diegetic_music。
圖生影片要先固定首幀中的人物、服裝、構圖、色彩和空間關係,再描述後續動作。首尾幀模式則要把中間變化寫清楚,不要只寫「從第一張變成第二張」。多參考模式要為每個素材分工,例如 Picture 1 負責人物外觀,Video 1 負責運鏡,Audio 1 負責音色。這類結構化提示詞也可以搭配 Codex 動態圖表與短影片工作流 自動產生。
授權限制一定要先看
MiniMax H3 主模型不是 Apache 2.0,而是 MiniMax H3 Community License,授權適用範圍排除歐盟、英國、韓國與美國,在這些地區部署需要另外聯絡 MiniMax 取得授權,商業產品年營收超過 2,000 萬美元,也需要事先取得書面授權。
商業產品介面還必須清楚顯示 MiniMax H3。授權也禁止用 H3 或其輸出改善其他非 H3 衍生模型。正式上線前應閱讀最新授權全文並取得法律意見,Qwen3-VL encoder 採 Apache 2.0,不代表整套 H3 工作流會自動變成 Apache 2.0。
我的判斷
MiniMax H3 的真正突破不是某一張畫面更漂亮,而是把角色、場景、鏡頭、對話、音效和音樂放進同一個生成過程,這讓本地 AI 影片從「抽一次卡看看」往可規劃的內容製作靠近。
它仍然是一套非常吃資源的系統。8GB 顯存只是能否啟動的最低挑戰,不是舒適規格,想先體驗的人,應從官方 ComfyUI 模板、4 秒、0.2MP 和單一參考圖開始。確認工作流有價值後,再投資記憶體、儲存空間與高解析度後製,Heretic 版本則只適合明白模型用途、授權與安全風險的人使用。
參考資料
FAQ
MiniMax H3 可以用 8GB 顯存執行嗎?
可以嘗試量化模型與 CPU offload,但要準備足夠的系統記憶體、虛擬記憶體和 NVMe 空間。建議從 0.2MP、4 秒短片開始,8GB 並不是官方保證的舒適規格。
MiniMax H3 本地可以直接產生 2K 嗎?
目前完整的 H3-Regenerate-2K 尚未開放。本地 H3-Base 主要輸出短邊 768px,官方 2K 品質仍需要搭配 API,或使用第三方放大與重繪工具。
Qwen3-VL Ultra Heretic H3 是 MiniMax H3 主模型嗎?
不是。它是 H3 使用的 Qwen3-VL 條件編碼器與 generation tail,負責提示詞理解和生成。真正產生影片的是 FL2VA 或 Ref2VA diffusion model。
MiniMax H3 可以商用嗎?
可以在授權適用地區依社群授權使用,但歐盟、英國、韓國與美國被排除。年營收超過 2,000 萬美元的商業產品需要事先取得書面授權,產品介面也要顯示 MiniMax H3。
ComfyUI 顯示 Missing Node Packs 怎麼辦?
先更新 ComfyUI,再確認自訂節點放在 custom_nodes 的第一層,並用 ComfyUI 自己的 Python 安裝 requirements。重新啟動後仍缺節點,再依節點名稱安裝對應的 node pack。
by Rain Chu 7 月 11, 2026 | AI , 圖型處理 , 影片製作
RunningHub 最值得看的地方,不是它又做了一個線上 AI 繪圖平台,而是它把 ComfyUI 工作流、AI 應用、模型 API、工作流 API 和內容模板包成一個可營運的創作平台。對內容團隊來說,這比較像是把原本散在本機、模型網站、工作流社群和 API 文件裡的能力,整理成同一個生產入口。
如果你之前已經在玩 本機 ComfyUI 與開源繪圖模型 ,RunningHub 可以看成另一條路。它不是要求每個人都先理解節點、環境、顯卡和模型路徑,而是把工作流託管在雲端,讓創作、分享、調用和商業化更接近一般工具的使用方式。
RunningHub 是什麼
RunningHub 官方把自己定位成原生 AI 智能體驅動的全能內容創作平台,支援 ComfyUI 工作流、無限畫布、AI 應用和模型 API 調用。這句話拆開看,其實代表三層產品。
第一層是創作入口,包含快捷創作、無限畫布、rhTV、RHSTORY、VibeX 和各種模板。
第二層是工作流市場,讓創作者基於 ComfyUI 做出可複用的流程,並提供給其他人直接使用。
第三層是 API 與開發者工具,把模型、AI 應用和工作流變成可以被產品或內部系統調用的服務。
這三層合在一起,RunningHub 的野心就比較清楚了,它不是只想做一個 ComfyUI 雲端版,而是想做 AI 內容生產的基礎平台。創作者可以在上面做模板,團隊可以用模板產出素材,開發者可以透過 API 把同一套能力接到自己的產品裡。
和本機 ComfyUI 最大差別
本機 ComfyUI 的好處是自由度高,模型和節點都能自己控制,缺點也很明顯,安裝、模型管理、節點衝突、顯卡限制和工作流維護都會吃掉大量時間。RunningHub 則把這些麻煩轉成雲端服務與平台規則。
面向 本機 ComfyUI RunningHub 環境管理 自己安裝 Python、節點、模型和驅動 平台託管工作流與模型能力 硬體成本 需要自己的 GPU 或雲端機器 按平台資源與調用方式使用 分享方式 通常分享 JSON、模型清單與安裝說明 可直接變成模板、AI 應用或 API 適合對象 技術玩家、研究者、重度創作者 內容團隊、電商、短劇、行銷、開發者 商業化路徑 需要自己包服務或教學 平台內有模板、應用與創作者激勵
這和 Liblib 這類中國 AI 創作平台 很像,都是把模型能力、創作者生態與素材生產流程放進平台。差別在於 RunningHub 特別強調 ComfyUI 工作流、AI 應用和 API 的連動,對想把流程產品化的人更有吸引力。
工作流才是核心資產
RunningHub 的 ComfyUI 頁面不是只展示模型,而是展示大量工作流。像商品圖、角色設計、短劇分鏡、動作模仿、去水印、高清修復、影片超分、圖生影片等,都不是單一模型能解決的問題,而是由多個節點和步驟組成的流程。
這一點很重要。AI 內容創作正在從 prompt 時代走向 workflow 時代。單次生成可以靠運氣,多次穩定產出就需要流程。誰能把流程沉澱成模板、應用和 API,誰就更接近可複製的生產力。
這也能和 OpenMontage 本地影片工作流 放在一起看。一邊是本地自架、可控性更高,另一邊是平台化、上手更快。真正要選哪一邊,不是看哪個比較酷,而是看團隊需要的是控制權,還是交付速度。
API 讓 RunningHub 不只是一個網站
RunningHub 的 API 頁面有一個關鍵說法,單一接口可以直連 400 多個主流大模型。它也把能力拆成模型 API、AI 應用 API 和工作流 API。這代表開發者不一定要讓使用者進 RunningHub 網站操作,也可以把平台能力接進自己的產品。
官方列出的生產環境重點包括全模態聚合、工作流託管、彈性按需計費與企業級安全。這幾個詞不是行銷話術而已。對公司來說,真正麻煩的往往不是模型能不能跑,而是能不能穩定調用、能不能控權限、能不能算成本、能不能把工作流變成內部服務。
RunningHub 也提供 RH_CLI、RH_Skills、ComfyUI 插件與 AI Developer Kit。這些工具的意義是降低接入門檻。創作者可以從平台模板開始,工程團隊則可以把流程變成自動化服務。這和 AI 代理走向工作平台 是同一個方向,重點不只是模型,而是把模型放進可用的工作系統。
哪些人最適合用 RunningHub
我會把 RunningHub 的使用者分成四類。
電商與品牌團隊,需要大量商品圖、短影片、模特圖、場景圖和廣告素材。
短劇與內容團隊,需要分鏡、角色、場景、動作模仿和影像增強。
ComfyUI 創作者,想把自己的工作流變成模板、應用或可被調用的服務。
開發者與企業團隊,想用 API 把模型和工作流接進既有系統。
如果只是偶爾玩圖,本機工具或單一模型網站就夠了。如果是每天要產內容、測素材、上架商品、做短劇或替客戶交付,RunningHub 這種平台化工具才會開始有價值。因為它解決的不是單張圖,而是內容生產流程。
我會怎麼開始測
第一步不要先研究所有功能,而是挑一個真實任務。例如電商商品圖、短劇分鏡、社群廣告短片或角色一致性測試。用官方模板跑出第一版,記錄效果、成本和可修改程度。
第二步才是比較工作流。看同一個任務能不能換模型、改節點、調提示詞、保留角色一致性,或直接變成 AI 應用。這一步能判斷 RunningHub 是臨時工具,還是能進入你的固定流程。
第三步看 API。如果你要把內容生產接到網站、內部後台、自動化任務或客戶服務流程,工作流 API 才是長期價值。這時候就要評估調用成本、回傳格式、權限控管和失敗重試。
我的結論
RunningHub 的定位很清楚,它想把 ComfyUI 從高手工具變成內容生產平台,這件事不只是降低門檻,也是在改變 AI 創作的價值重心。過去大家比的是誰會寫 prompt,現在會慢慢變成誰能設計穩定工作流,誰能把工作流包成應用,誰能把應用接成 API。
如果你只想偶爾生成圖片,RunningHub 可能會顯得太大。如果你在做短劇、電商、廣告素材、品牌內容或 AI 工具產品,它就很值得看。因為它賣的不是單次生成,而是從創作、模板、工作流到 API 的整套生產鏈。
延伸資源
FAQ
RunningHub 是什麼?
RunningHub 是一個 AI 內容創作平台,整合 ComfyUI 工作流、AI 應用、無限畫布、模型 API 和工作流 API,適合把圖像、影片和內容流程平台化。
RunningHub 和本機 ComfyUI 有什麼差別?
本機 ComfyUI 自由度高,但需要自己管理環境、模型和顯卡。RunningHub 把工作流和模型能力雲端化,適合需要快速創作、分享模板、建立 AI 應用或調用 API 的團隊。
RunningHub 適合哪些場景?
它適合電商商品圖、短劇分鏡、品牌素材、影片生成、角色一致性、高清修復,以及把 ComfyUI 工作流變成可重複調用的內部工具或 API 服務。

近期留言