by Rain Chu 7 月 11, 2026 | AI
AI 設計工具正在從「幫你生一張圖」走向「幫你拆一整套設計任務」,堆友這類 AI 設計 Agent 最值得注意的地方,不是單次出圖速度,而是把品牌全案、IP 延展、海報、Logo、字體、修圖與素材整理,包裝成可以一鍵調用的設計 skills。對設計師、行銷人與內容團隊來說,這代表 AI 不只是靈感工具,而是可以進入日常製作流程的設計協作台。
圖:AI 設計 Agent 將品牌、IP、海報、Logo 與字體任務串成工作流 堆友的核心:用 Skills 組出 AI 設計部
堆友的操作邏輯很接近「設計專家集合」。使用者不是只輸入一句提示詞等結果,而是先選擇適合的 skill,例如品牌全案設計專家、IP 設計專家、海報設計專家、Logo 設計或字體設計,再把品牌類型、視覺風格、需要的素材項目與輸出格式寫清楚。
這種設計方式很適合現在的 AI 工作流:先把任務交給特定能力的 Agent,再透過對話、局部修改、圖層編輯與文字編輯逐步收斂,若你熟悉我之前整理的 find-skills 安裝與使用教學 ,就會很容易理解這個方向:skill 不是花俏名詞,而是把一套專業流程封裝成可重複調用的能力。
玩法一:品牌全案不只生 Logo,而是一次產出視覺系統
品牌全案是最能看出 AI 設計 Agent 價值的場景。好的提示詞不能只寫「幫我做一個潮流品牌」,而要交代品牌類型、目標受眾、風格方向、視覺情緒,以及需要哪些素材。比較完整的輸出可以包含 Logo、主視覺、產品周邊、包裝、店鋪氛圍、社群海報與物料延展。
這對早期品牌、活動企劃或內容創作者特別有用,因為很多時候真正耗時的不是單張主視覺,而是「能不能快速湊出一組看起來一致的品牌材料」。如果你的需求偏向 WordPress 商品圖或內容配圖,也可以參考 如何用 baoyu-skills 在 WordPress 批次產生高質感產品圖 ,概念很接近:把零散的圖片需求整理成可批次執行的生產流程。
玩法二:IP 延展適合做角色設定、穿搭與周邊
IP 延展是另一個很適合 AI 的任務。傳統上,一個角色要延伸出正側背三視圖、表情、動作、穿搭、周邊商品與應用場景,需要大量手工拆解,堆友這類工具的優勢,是可以把「角色設計」直接推進到「角色應用系統」。
比較實用的做法,是在提示詞裡明確列出要生成的內容:角色三視圖、六套穿搭、常用表情、動作姿勢、帆布袋、鑰匙圈、貼紙、社群頭像、海報版面。若希望方便檢查,也可以要求系統把成品排在同一張長圖裡,這會比一張一張散著看更容易判斷風格是否一致。
玩法三:海報設計從素材整理開始
海報設計不是只靠一句標語。實務上通常需要先準備文字、主圖、產品圖、活動資訊、品牌色、尺寸比例與風格方向,堆友的海報設計 skill 可以吃文字、圖片與多媒體素材,再產出不同風格的版面方向,讓使用者從候選稿裡挑選最接近需求的一張繼續修。
這裡最有用的是後續編輯能力。生成結果可以再進畫布,透過「編輯元素」拆分圖層,或用「編輯文字」調整海報文案。這讓 AI 海報不只是一次性產物,而是更接近可改稿的設計檔。想看更多海報與行銷視覺的 AI 應用,可以延伸讀 Gemini Nano Banana Pro 超強 15 大應用整理 和 Nano Banana Pro 海報與邀請卡實戰技巧 。
玩法四:Logo 與字體更適合拿來探索方向
Logo 和字體生成很吸引人,但也最需要冷靜看待。AI 可以快速產生大量方向,例如毛絨玩偶風、復古潮玩風、霓虹招牌風、英文 Logo、立體字體等;也可以進一步做去背、輸出 PNG、批量摳圖。這對提案前期很好用,因為它能迅速讓抽象風格變成可討論的視覺草案。
但如果要正式商用,Logo 仍然需要設計師做最後整理,包括字距、識別性、縮放可讀性、黑白版、反白版、註冊風險與商標檢索。AI 生成可以縮短發想時間,但不能取代品牌識別的最後把關。
一個好用的提示詞框架
使用這類 AI 設計 Agent 時,提示詞可以用下面這個結構:
品牌背景:品牌名稱、品類、受眾、價格帶、情緒定位。
風格方向:復古、潮玩、極簡、科技、可愛、精品、街頭等。
輸出清單:Logo、主視覺、角色、包裝、海報、周邊、社群圖。
版面格式:9:16、1:1、橫版海報、同一張長圖整理、透明背景。
修改規則:哪些地方不能變、哪些地方可以重設、要保留什麼元素。
重點是不要只讓 AI 猜。你提供的設計約束越清楚,Agent 產出的素材就越接近可用稿;後續再用局部修改、圖層拆分、文字編輯、去背與高清化去收斂細節。
堆友適合誰?
角色 適合用途 要注意的事 設計師 快速發想方向、整理 moodboard、做提案初稿 最後仍要人工修版與統一規範 行銷人 活動海報、社群圖、產品視覺、品牌提案 要先準備清楚文案與活動資訊 創作者 IP 角色、周邊、頻道視覺、內容封面 角色一致性需要反覆迭代 小品牌 低成本探索品牌視覺與商品包裝方向 正式商用前要檢查版權與商標風險
導入前要先想清楚的限制
第一,AI 產出的 IP 形象不等於天然可商用。角色是否撞型、Logo 是否有商標風險、素材授權是否符合平台規範,都要另外確認。第二,會員或付費方案通常會影響可用模型、生成次數、高清輸出、去背與進階編輯能力,團隊導入前最好先估算每月使用量。
第三,AI 很會產生「看起來像一套」的素材,但品牌一致性仍然需要規範。比較成熟的做法,是先用 Agent 做 3 到 5 組方向,再由設計師定稿品牌色、字體、Logo 規格與使用禁例。若你的下一步是把設計延伸到網站或前端 UI,可以搭配 Google Stitch 教學 ,把視覺概念往 UI 生成方向推進。
AI 設計 Agent 的價值在於把零散任務變成流程
堆友這類 AI 設計 Agent 的真正亮點,是把「品牌、IP、海報、Logo、字體、修圖」這些原本分散的任務,整合成一個可反覆調用的設計流程。它不會讓每個人一夜之間變成資深設計師,但能讓非設計團隊更快做出可討論的視覺方向,也能讓設計師把更多時間留給判斷、修正與品牌策略。
如果要追蹤阿里系產品與設計生態,可以從 阿里巴巴集團官網 了解相關背景;工具本身的使用入口與功能可用性,仍以實際帳號頁面顯示為準。
推友AI
FAQ
堆友可以直接做完整品牌全案嗎?
可以用來快速產出品牌全案的初步方向,例如 Logo、主視覺、包裝、海報與周邊素材。但正式交付前,仍建議由設計師整理品牌規範、檢查可讀性與商用風險。
AI 生成的 IP 形象可以商用嗎?
要看平台授權、素材來源與生成結果是否涉及相似角色或商標風險。AI 可以協助快速探索角色方向,但商用前應做授權、商標與相似性檢查。
堆友適合完全沒有設計經驗的人嗎?
適合拿來做初稿、提案方向與素材延展,但提示詞仍要寫清楚品牌背景、風格、輸出項目與限制。越能說清楚需求,結果越容易接近可用稿。
by Rain Chu 7 月 7, 2026 | AI , 影片製作
AI 影片工具正在從「生成一段漂亮畫面」往「協助完成一套可控工作流」移動。OiiOii 主打的不是單純丟一句提示詞生成影片,而是協助創作者把故事拆成分鏡,再銜接 AI 動畫生成工具,讓短影音、廣告概念片或角色動態 demo 更快進入可測試階段。
圖:AI 動畫分鏡與多 Agent 工作流示意 OiiOii 真正吸引人的地方:先做分鏡,再做動畫
多數 AI 影片工具最大的痛點,不是「能不能生成」,而是「能不能穩定重複出接近導演想法的畫面」。一支看起來完整的動畫,通常需要角色設定、場景氣氛、鏡頭運動、景別切換、節奏、轉場與連續性。如果每一幕都靠手動提示詞硬拚,創作者很快就會被版本管理與反覆修稿拖住。這也是為什麼單看 AI 影片生成工具 的畫質還不夠,前期分鏡與流程設計會直接影響成片穩定度。
OiiOii 這類工具的價值,正在於把「動畫生成」前面那一段拆解工作流程化:先把概念拆成可執行的分鏡,再把每個鏡頭轉成更具體的生成指令。對短影片創作者來說,這可以降低起步門檻;對已經熟悉剪輯與分鏡的人來說,它則像是一個快速前期製作助手。
OiiOii 的核心功能亮點
OiiOii 的核心不是把一句提示詞變成一段漂亮畫面,而是把 AI 動畫創作中最難控的「分鏡」拉到流程中心。真正讓一支動畫短片成立的,通常不是單張畫面多精緻,而是鏡頭如何切換、情緒如何遞進、角色與場景如何在不同畫面之間保持連續。
在實際創作流程上,OiiOii 先讓創作者選擇視覺方向,再把故事概念拆成可操作的生成任務。它的風格庫涵蓋 AI 真人、上海美術電影、Kpop 女團 CG 風等方向,也包含真人、3D、2D 等不同類型。對創作者來說,這代表一開始就能先確定影像語氣,而不是等生成失敗後才回頭修正風格。
比較值得注意的是它的多 Agent 流程。OiiOii 把前期製作拆給不同角色處理,像是藝術總監、編劇、設計師等;流程會先確認片長與情緒關鍵字,再進到劇本轉寫、人物場景生成與分鏡設計。這讓它更像是一套「陪你完成前期製作」的協作系統,而不是只把提示詞丟給影片模型。若把它放到更大的 AI 工作流 脈絡來看,它處理的是創意落地前最容易失控的拆解階段。
分鏡編輯是另一個關鍵亮點。創作者可以用多圖參考模式先生成分鏡圖,再針對單一格子修改;例如角色朝向不對時,不必整張重做,而是選中那一格、輸入提示詞修正。更關鍵的是,分鏡提示詞可以細到秒,包含角色聲音、每一秒音效與情緒設計;這正是它和傳統「一次生成一段影片」工具的差別。
它比較適合誰?
想快速測試 AI 動畫概念,但還沒有成熟分鏡能力的創作者。
需要把腳本拆成多個鏡頭,再交給 Seedance、即夢或其他 AI 影片模型生成的人。
正在製作短影音、MV 概念片、產品廣告草案、角色展示片的人。
想把「一句提示詞」升級成「可反覆修改的工作流」的人。
但如果你的需求是完全精準的商業級動畫,或每一個鏡頭都要有高度可控的表演、構圖與轉場,這類工具目前更像是加速器,不是全自動替代品。
使用前要注意的成本與限制
這類工具最容易被行銷成「一鍵爆款」,但實際導入前更應該先評估成本、穩定性與售後支援。需要注意的問題包括:流程中仍可能遇到 bug,補償與客服體驗不一定成熟;費用也未必會比即夢等工具低,而且生成、修改、重跑每一步都可能產生成本。這代表它並不是免費魔法,而是一套需要評估投入產出的製作流程。
另一個關鍵提醒是:即使工具能把流程模組化,最後仍然需要創作者自己把提示詞、鏡頭語言與修改方向寫清楚。分鏡工具可以幫你建立骨架,但骨架能不能長出好看的影片,仍取決於題材設定、審美判斷與反覆調整。
和即夢、Seedance 這類工具的關係
OiiOii 更適合被理解成創作流程中的「前期規劃與工作流層」,而不是單一底層影片模型。你可以把它理解成:OiiOii 協助你想清楚鏡頭與分鏡,Seedance 或其他影片模型負責生成具體影像。
這種分工會越來越常見。AI 影片模型越強,越需要上層工具幫創作者管理腳本、鏡頭、角色一致性與生成參數。真正的競爭點不只是哪個模型畫面最漂亮,而是誰能讓創作者用更少試錯完成更穩定的作品。像 AI Agent 自動剪輯 這類工具,也是在把影片創作從單點生成推向可編排、可重複的流程。
使用前可以先問自己的 5 個問題
我需要的是靈感 demo,還是可交付的商業成片?
每個鏡頭反覆生成的費用,是否在可接受範圍內?
我是否有能力判斷分鏡、轉場與節奏好壞?
如果工具產生 bug 或結果不穩,是否有備用流程?
我是否已準備好角色設定、故事大綱與視覺參考?
如果這五題都答得出來,OiiOii 這類工具就值得測試;如果還答不出來,建議先用一個短腳本做小規模實驗,不要一開始就把完整專案押上去。
爆款不是按鈕,分鏡才是槓桿
OiiOii 值得注意的地方,不是它承諾「一鍵爆款」,而是它碰到 AI 影片創作真正的瓶頸:如何把創意拆成可執行、可修改、可重複的鏡頭流程。對創作者來說,這比單次生成一段炫技畫面更重要。
目前更務實的看法是:把 OiiOii 當成 AI 動畫前期製作助手,而不是全自動導演。它能幫你縮短分鏡與試片時間,但成本、bug、提示詞品質與剪輯判斷仍然需要人來掌控。真正能產出好作品的,不會只是會按生成鍵的人,而是能把故事、鏡頭與工具串成完整工作流的人。
FAQ
OiiOii 是 AI 影片模型嗎?
OiiOii 更像是協助 AI 動畫分鏡與工作流規劃的工具,不一定等同於底層影片生成模型。
OiiOii 適合新手嗎?
適合用來快速理解分鏡流程與測試短片概念,但新手仍需要學會提示詞、鏡頭語言與基本剪輯判斷。
使用 OiiOii 會不會很貴?
使用這類工具時,每一步生成、修改與重跑都可能產生成本,費用也未必會比即夢等工具低。建議先用短腳本測試,再決定是否投入完整專案。
by Rain Chu 6 月 6, 2026 | AI , 圖型處理
2026 年最受矚目的 AI 繪圖模型之一,莫過於 Ideogram 團隊正式釋出的:
Ideogram 4
這是 Ideogram 首次公開模型權重(Open Weight),也是目前開源陣營中,在:
文字生成(Text Rendering)
海報設計
品牌廣告
排版控制
JSON 結構化提示詞
官方 資料顯示,Ideogram 4 採用 9.3B 參數的單流 Diffusion Transformer(DiT)架構,並支援原生 2K 圖像生成。
本篇將帶你使用 ComfyUI,在本機部署 Ideogram 4。
系統需求
官方模型共有兩個版本:
版本 量化 Ideogram 4 FP8 品質最佳 Ideogram 4 NF4 VRAM需求較低
目前 ComfyUI 官方整合版本主要使用:
其中 FP8 畫質最佳。
第一步:下載模型
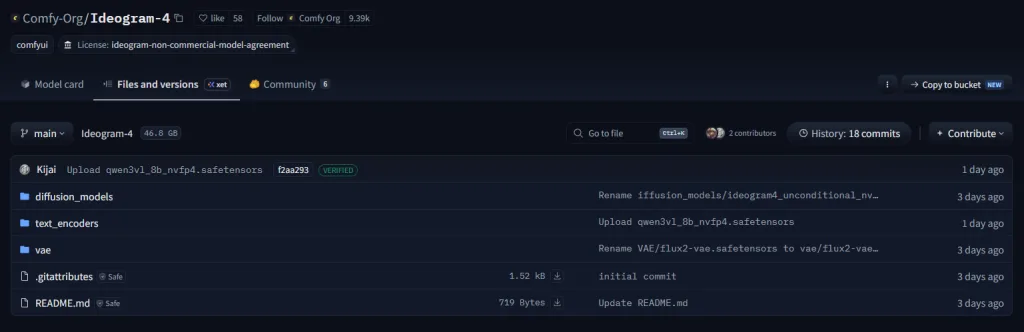
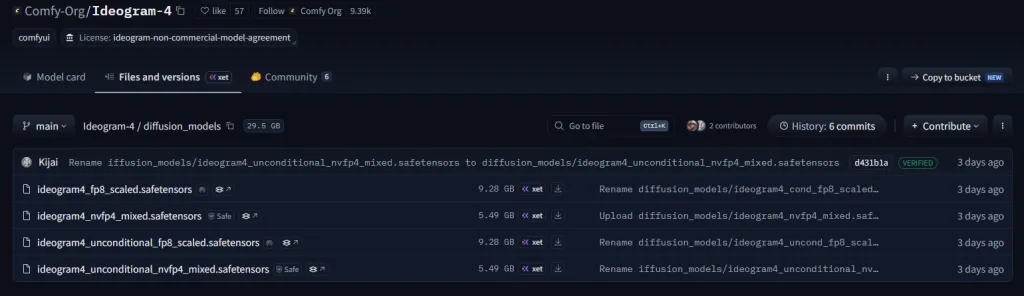
ComfyUI 專用模型
官方:
Comfy-Org Ideogram-4
原始模型:
Ideogram 4 FP8 官方 模型
第二步:放置模型檔案
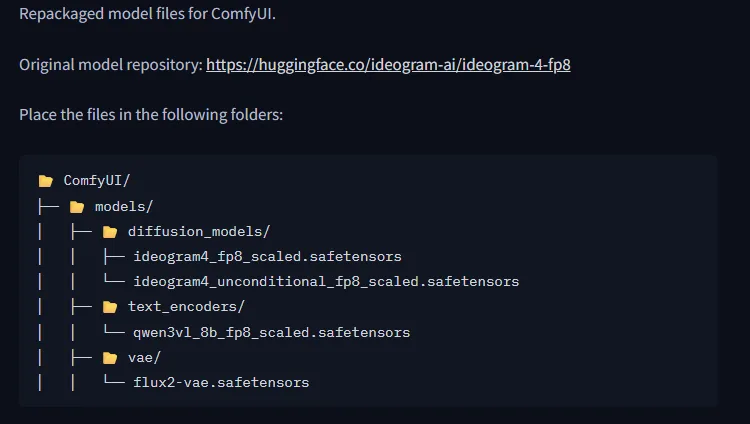
依照官方說明建立目錄。
ComfyUI
│
├─ models
│  ├─ diffusion_models
│  │  ├─ ideogram4_fp8_scaled.safetensors
│  │  └─ ideogram4_unconditional_fp8_scaled.safetensors
│  │
│  ├─ text_encoders
│  │  └─ qwen3vl_8b_fp8_scaled.safetensors
│  │
│  └─ vae
│      └─ flux2-vae.safetensors
第三步:了解每個模型用途
ideogram4_fp8_scaled
主模型
負責:
ideogram4_unconditional_fp8_scaled
CFG 引導模型
負責:
提升細節
強化 Prompt Follow
改善品質
官方建議兩個模型一起使用。若只載入主模型雖可運作,但畫質會下降。
qwen3vl_8b_fp8_scaled
文字編碼器
負責:
Prompt 理解
JSON 理解
空間推理
海報版面配置
flux2-vae
VAE 解碼器
負責將 Latent 轉換成圖片。
第四步:更新 ComfyUI
Ideogram 4 需要最新版本的 ComfyUI。
更新方式:
或:
官方於 Day-0 即已原生支援 Ideogram 4。
第五步:載入官方 Workflow
ComfyUI 官方已提供範例工作流。
建議直接從:
Comfy Blog
下載 Workflow 。
基礎工作流架構
Prompt
    ↓

Qwen3-VL Encoder
    ↓

Ideogram 4
    ↓

Sampler
    ↓

Flux VAE Decode
    ↓

Save Image
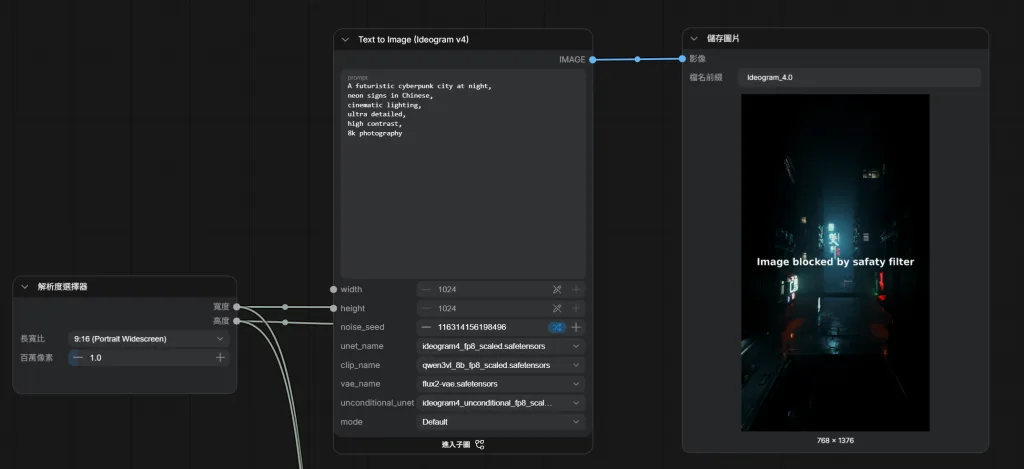
第六步:第一張圖片
測試 Prompt:
A futuristic cyberpunk city at night,
neon signs in Chinese,
cinematic lighting,
ultra detailed,
high contrast,
8k photography
生成尺寸:
推理模式:
第七步:體驗 JSON Prompt
Ideogram 4 最大特色就是:
Structured JSON Prompt
官方模型訓練時即使用 JSON Caption。
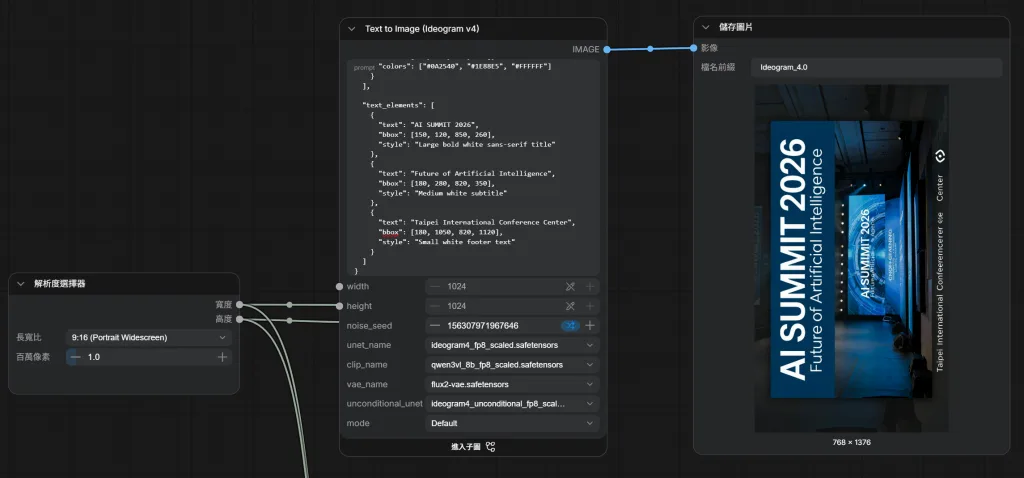
範例:海報設計
{
  "scene_summary": "Professional technology conference poster",

  "background": {
    "description": "Modern convention center stage with blue ambient lighting, large LED screen, clean professional environment"
  },

  "style": {
    "description": "Corporate marketing design, professional conference poster, clean typography, premium branding, modern layout"
  },

  "objects": [
    {
      "description": "Conference stage",
      "bbox": [100, 150, 900, 850],
      "colors": ["#0A2540", "#1E88E5", "#FFFFFF"]
    }
  ],

  "text_elements": [
    {
      "text": "AI SUMMIT 2026",
      "bbox": [150, 120, 850, 260],
      "style": "Large bold white sans-serif title"
    },
    {
      "text": "Future of Artificial Intelligence",
      "bbox": [180, 280, 820, 350],
      "style": "Medium white subtitle"
    },
    {
      "text": "Taipei International Conference Center",
      "bbox": [180, 1050, 820, 1120],
      "style": "Small white footer text"
    }
  ]
}
Bounding Box 控制
可直接指定位置。
{
  "text_elements":[
    {
      "text":"SALE 50%",
      "bbox":[100,100,500,300]
    }
  ]
}
座標範圍:
原點:
這是目前 FLUX 與 Stable Diffusion 所不具備的能力。
色彩盤控制
品牌設計超級好用。
{
  "color_palette":[
    "#FF6600",
    "#FFFFFF",
    "#000000"
  ]
}
官方支援:
與 FLUX 比較
FLUX 強項
Ideogram 4 強項
Logo
海報
Banner
電商素材
排版設計
中文文字生成
若你是:
Ideogram 4 很可能比 FLUX 更適合。
結論
Ideogram 4 不只是另一個 AI 繪圖模型。
它最大的創新在於:
把 Prompt 從自然語言升級為結構化設計規格。
透過:
Qwen3-VL
Diffusion Transformer
JSON Prompt
Bounding Box
Color Palette
使用者終於可以像操作 Figma 一樣控制 AI 生成內容。
對於需要:
海報設計
品牌素材
Banner 製作
AI Agent 自動產圖
的開發者來說,Ideogram 4 是目前最值得研究與部署的開源模型之一。
by Rain Chu 6 月 6, 2026 | AI , 繪圖
AI 圖像生成正式進入「設計級控制」時代
近兩年 AI 繪圖領域競爭激烈,從 Midjourney、Stable Diffusion、FLUX,到 Google Imagen,各家模型都在追求更好的畫質與更精準的提示詞理解能力。
真正困擾設計師與企業用戶的問題其實不是畫質,而是以下的問題:
文字總是生成錯誤
排版無法控制
Logo 與標題位置不準確
無法符合品牌色彩規範
每次生成結果都像在「抽卡」
2026 年 6 月,Ideogram 正式推出最新開源模型:
Ideogram 4.0
這不僅是 Ideogram 首次公開權重(Open Weight)模型,更被許多開發者視為目前最接近商業設計工作流程的 AI 圖像生成系統。
什麼是 Ideogram 4.0?
Ideogram 4.0 是一款從零開始訓練的 AI 圖像生成模型,採用最新的:
Diffusion Transformer(DiT)架構
與傳統 Stable Diffusion 不同,Ideogram 4.0 使用:
34 層 Transformer
93 億參數(9.3B)
單流(Single Stream)設計
文字 Token 與影像 Token 共用同一套注意力機制
官方稱其為:
Single-Stream Diffusion Transformer(DiT)
這種架構讓模型能更深入理解文字與影像之間的關聯,提高提示詞遵循能力(Prompt Adherence)與版面控制能力。
核心架構解析
1. 文字編碼器(Text Encoder)
Ideogram 4.0 並未使用傳統的 CLIP 或 T5 「文字編碼器(Text Encoder)」。
而是採用了:
Qwen3-VL-8B-Instruct
作為文字理解引擎。
其特色包括:
視覺語言模型(Vision Language Model)
僅使用文字模式
提取 13 個中間層隱藏狀態
將多層特徵串接後輸入 DiT
這種設計能同時保留:
讓模型對複雜提示詞有更深層的理解能力。
2. DiT 主幹網路
Ideogram 4.0 採用:
34 Layers
Embedding Dimension:4608
18 Attention Heads
SwiGLU Feed Forward
總參數量達:
9.3 Billion Parameters
目前已是開源 AI 繪圖模型中最頂尖的規模之一。
3. VAE 解碼器
使用凍結(Frozen)的:
KL VAE
特性:
8× 空間壓縮
128 Latent Channels
負責將潛在空間(Latent Space)轉換為最終圖像。
4. Flow Matching 取樣器
不同於傳統 DDPM。
Ideogram 4.0 採用:
Euler Flow Matching
搭配:
Asymmetric CFG
特色:
提升生成效率
改善細節品質
更穩定的提示詞遵循能力
官方提供三種推理模式:
模式 Steps V4_TURBO 12 V4_DEFAULT 20 V4_QUALITY 48
品質模式會在最後階段降低引導強度,進一步提升真實感。
最大突破:JSON 結構化提示詞
這是 Ideogram 4.0 最具革命性的地方。
過去 AI 繪圖都依賴自然語言:
A beautiful girl standing beside a lake... Ideogram 4.0 則改為:
{ "background": "...", "objects": [...], "texts": [...], "style": {...}} 模型訓練時完全使用 JSON 描述,因此天生理解結構化資訊。
Bounding Box 精準版面控制
支援 Bounding Box:
{ "bbox": [100,100,400,400]} 採用:
可直接指定:
這是過去 Midjourney、Stable Diffusion 很難做到的功能。
色彩盤控制(Color Palette)
可直接指定品牌色:
{ "colour_palette": [ "#FF6600", "#FFFFFF", "#000000" ]} 限制:
非常適合:
多語言文字生成能力大幅提升
Ideogram 一直以來最強的能力就是:
Text Rendering
也就是圖片內文字生成。
例如:
以往 AI 經常出現亂碼。
但 Ideogram 4.0 已能大幅提升:
等多語系文字品質。
原生支援 2K 輸出
解析度支援:
最小:256 × 256
最大:2048 × 2048
且:
例如:
YouTube Banner
網站橫幅
電商主圖
手機桌布
皆可直接生成。
設計工作流功能全面升級
除了模型本身之外,Ideogram 平台也同步推出多項設計工具:
Prompt Edit
直接修改既有圖片中的特定區域。
Magic Fill
局部重繪。
Remix
基於現有圖片重新生成。
Extend / Reframe
擴展畫布與調整比例。
Upscale
提高解析度。
Transparent Background
直接輸出透明背景 PNG。
MCP 整合
可接入 AI Agent 工作流程。
Editable Text Layers
未來將支援真正可編輯的文字圖層功能。
Ideogram 4.0 與 Google Imagen 誰更強?
若比較:
Google Imagen
FLUX
Stable Diffusion
Ideogram 4.0
目前 Ideogram 最大優勢在於:
✅ 文字生成能力
✅ 排版控制能力
✅ JSON 結構化設計流程
✅ 開源權重
✅ 可自行部署
而 Google Imagen 仍在:
方面維持優勢。
若是企業設計工作流,Ideogram 4.0 已經是極具競爭力的選擇。
官方資源
官方網站
Ideogram 官方網站
模型介紹
Ideogram 4.0 Model Page
技術部落格
Ideogram 4.0 Technical Details
API 文件
Ideogram Developer API
GitHub
Ideogram 4 GitHub Repository
Hugging Face
Ideogram 4 Hugging Face Collection
Ideogram 4.0 不只是另一個 AI 繪圖模型。
它最大的突破在於:
把 AI 繪圖從「描述圖片」提升到「設計圖片」。
透過:
Diffusion Transformer(DiT)
Qwen3-VL 編碼器
JSON Prompt
Bounding Box 控制
色彩盤控制
可編輯文字圖層
Ideogram 4.0 正逐步接近 Photoshop、Illustrator 與 Figma 所代表的專業設計工作流程。
對於品牌設計、電商素材、廣告製作與 AI Agent 自動化內容生成來說,Ideogram 4.0 很可能會成為 2026 年最值得關注的開源 AI 圖像生成模型之一
by Rain Chu 4 月 24, 2026 | AI , 影片製作
🎬 前言:影音生成進入新紀元
在 AI 生成技術快速進化的浪潮中,影音生成(Video Generation)一直是最具挑戰的領域之一,近期阿里巴巴推出全新開源模型 Happy Horse 1.0
這不只是一次模型更新,而是一場技術架構的全面升級。
🧠 技術突破:原生音視訊同步與統一架構
過去的影音生成模型,多數採用「先產畫面、再加聲音」的分離式流程,導致以下問題:
聲音與畫面不同步
情緒與語境不一致
動作與語音對不上(例如嘴型錯誤)
而 Happy Horse 1.0 的最大突破在於:
✅ 原生音視訊同步(Native Audio-Visual Generation)
模型在同一個架構中,同步生成:
👉 這代表:
嘴型、語氣、動作可以完全對齊
情境更自然、沉浸感更強
✅ 統一生成架構(Unified Architecture)
傳統模型:
Text → Image → Video → Audio
Happy Horse:
Text → Audio + Video(同步生成)
👉 好處:
🌍 開源策略:直接撼動產業格局
這次阿里的另一個關鍵策略是——全面開源 。
在目前市場上,多數高品質影音模型(如某些閉源模型)仍然:
而 Happy Horse 1.0:
🔓 開源帶來的優勢
可自行部署(企業私有化)
可進行 fine-tune
可整合到自家 SaaS / Agent 系統
大幅降低成本
👉 對你這種正在做:
AI Agent
SaaS 平台(像 OpenClaw / Hermes)
影音生成服務
這其實是「直接可商用的關鍵拼圖」。
🧪 實測對比:各有所長,但方向已定
從目前社群與測試結果來看,Happy Horse 1.0 與其他主流模型相比:
🎥 優勢
音畫同步表現極佳(領先)
人物口型與語音一致性高
長影片穩定性提升
⚖️ 相對限制
某些細節畫質仍有進步空間
複雜場景(多人物)仍需優化
訓練與硬體需求較高
👉 結論不是「全面碾壓」,而是:
在「影音同步」這個核心維度上,已經領先一個世代。
🧩 對開發者的實際影響(重點)
如果你是開發者或創業者,這代表什麼?
💡 你現在可以做:
AI 影片生成 SaaS(類似 Runway / Pika)
AI 虛擬人(帶語音與表情同步)
自動短影音生成(TikTok / 房仲 / 行銷)
AI 教學影片生成
👉 Happy Horse 可以直接變成:
Agent → 呼叫影音生成 API → 自動產影片
甚至可以做到:
「用一句話生成完整短影音廣告」
「AI 自動生成房仲介紹影片」
🏗️ 未來趨勢:影音生成將取代文字生成?
目前 AI 發展路線:
文字生成(GPT)
圖像生成(Stable Diffusion)
影音生成(下一戰場)
而 Happy Horse 代表:
🔥「影音生成正式進入可商用時代」
未來很可能出現:
AI 直接生成 YouTube 影片
無人製作的短影音工廠
AI 自動做內容變現
📦 官方資源


近期留言