Kimi K3 怎麼用?百萬上下文、API 價格與部署門檻整理
Kimi K3 適合處理需要反覆讀資料、寫程式、測試與修正的長任務,它把上下文拉到百萬 token 級,也開放模型權重。不過,對多數開發者而言,最實際的入口仍是 Chat、Kimi Code 或 API。開放權重,並不代表一張桌上型顯卡就能運行完整模型。
如果你想把 Kimi K3 接進既有專案,先確認三件事:推理強度怎麼設、完整對話訊息有沒有保留,以及每次成功完成任務花多少錢。
Kimi K3 的重點:大模型、長上下文與稀疏運算
官方模型卡列出約 2.8 兆總參數、104B 啟用參數,以及 1,048,576 token 上下文。MoE 每個 token 選取 896 個路由專家中的 16 個,另外還有共享專家。因此,不能直接用 16 ÷ 896 乘上總參數,推算真正的啟用參數量。
MoE 可以想成大型團隊,每個問題只找部分成員處理。這能降低每次運算涉及的工作量,但其他專家的權重仍需要儲存,並依部署方式供系統存取。若想先理解較小型模型的總參數與啟用參數差異,可延伸看Ornith 1.5 的 MoE 與部署解析。
KDA 與 Attention Residuals 分別改善什麼?
Kimi K3 專案的架構結合 Kimi Delta Attention 與 Gated MLA。
KDA 處理長序列的資訊流,Attention Residuals 則讓模型跨深度選取需要的表示,不只是把所有層的結果一律累加。官方公布的整體擴展效率改善約為 K2 的 2.5 倍,包含架構、訓練及資料配方的共同作用。
閱讀這類效率數字時,要先辨認測量對象。訓練效率、單一核心速度、長上下文解碼速度,以及使用者從送出問題到看到答案的等待時間,是不同指標。不能把某項加速倍率直接當成所有 API 請求都會變快的保證。
先看目前狀態:推理檔位與開放權重都已更新
截至 2026 年 9 月 18 日,推理強度文件已列出 low、high、max,預設為 max。
K3 仍會進行推理,選 low 並不等於關閉思考。只有 max 可選的發布初期說明,已不適合作為目前的接入規則。
完整權重已能在Moonshot AI 的 Hugging Face 模型頁取得。評估下載與部署時,應從官方模型卡連往推理引擎的部署文件,並核對 Kimi K3 License。不要再把 7 月的權重發布預告寫成尚未發生的事。
Kimi K3 API 接入:先跑通一個小任務
先到Kimi K3 Quickstart與 Playground 測試自己的題目。使用 API 前,需要準備 Kimi 平台的金鑰與可用額度。下例使用 Python OpenAI SDK,金鑰放在環境變數 MOONSHOT_API_KEY,不寫進程式。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)

messages = [{
    "role": "user",
    "content": "請為一個待辦清單 API 列出三項最重要的驗收測試。"
}]

response = client.chat.completions.create(
    model="kimi-k3",
    reasoning_effort="high",
    messages=messages,
)
print(response.choices[0].message.content)
這是依官方介面整理的最小示例,本文未進行付費 API 實測。先用短輸入確認金鑰、額度與模型名稱正確,再逐步加入長文件與工具。不要第一次就塞滿整個程式庫,否則很難判斷錯誤來自資料、費用、相容性還是模型本身。
多輪聊天要保留完整 assistant 訊息
官方推理文件要求下一輪原樣帶回完整 assistant 訊息,包括 reasoning_content 與 tool_calls,不能只留下畫面顯示的 content。檢查你使用的框架,是否會自動刪除額外欄位。
messages.append(response.choices[0].message.model_dump(exclude_none=True))
messages.append({"role": "user", "content": "請把第一項改寫成具體測試步驟。"})
將更新後的 messages 傳入下一次呼叫,就能延續對話。涉及工具呼叫時,還需要依 tool_call_id 加回對應結果,不能只追加下一句問題。
圖片、工具與舊參數,逐項確認
依目前K3 API 限制,temperature、top_p 等採樣參數固定,接入時直接省略較清楚。
官方 API 的視覺輸入不接受公開圖片網址,要使用 base64 或 ms:// 檔案參照,content 必須是物件陣列。這些是官方服務的介面規則,不能從第三方範例推論完全相同。
K3 支援工具呼叫、JSON 結構化輸出與動態載入工具,但「模型要求呼叫工具」仍需要你的應用程式執行。系統提示可以定義任務邊界,程式也應限制可用操作,尤其是寫入資料、對外送出內容或執行命令。官方文件目前仍提醒聯網搜尋在更新中,正式應用應先驗證所用版本。
Kimi K3 價格怎麼算?輸出與快取都要計入
官方平台目前公布的美元牌價如下,單位為每 100 萬 token。計價說明與帳戶結帳頁應一起核對,稅費、額外工具及實際帳單不一定包含在這張模型推理單價表內。
| 計費項目 | 每 100 萬 token |
|---|---|
| 輸入,命中快取 | US$0.30 |
| 輸入,未命中快取 | US$3.00 |
| 輸出 | US$15.00 |
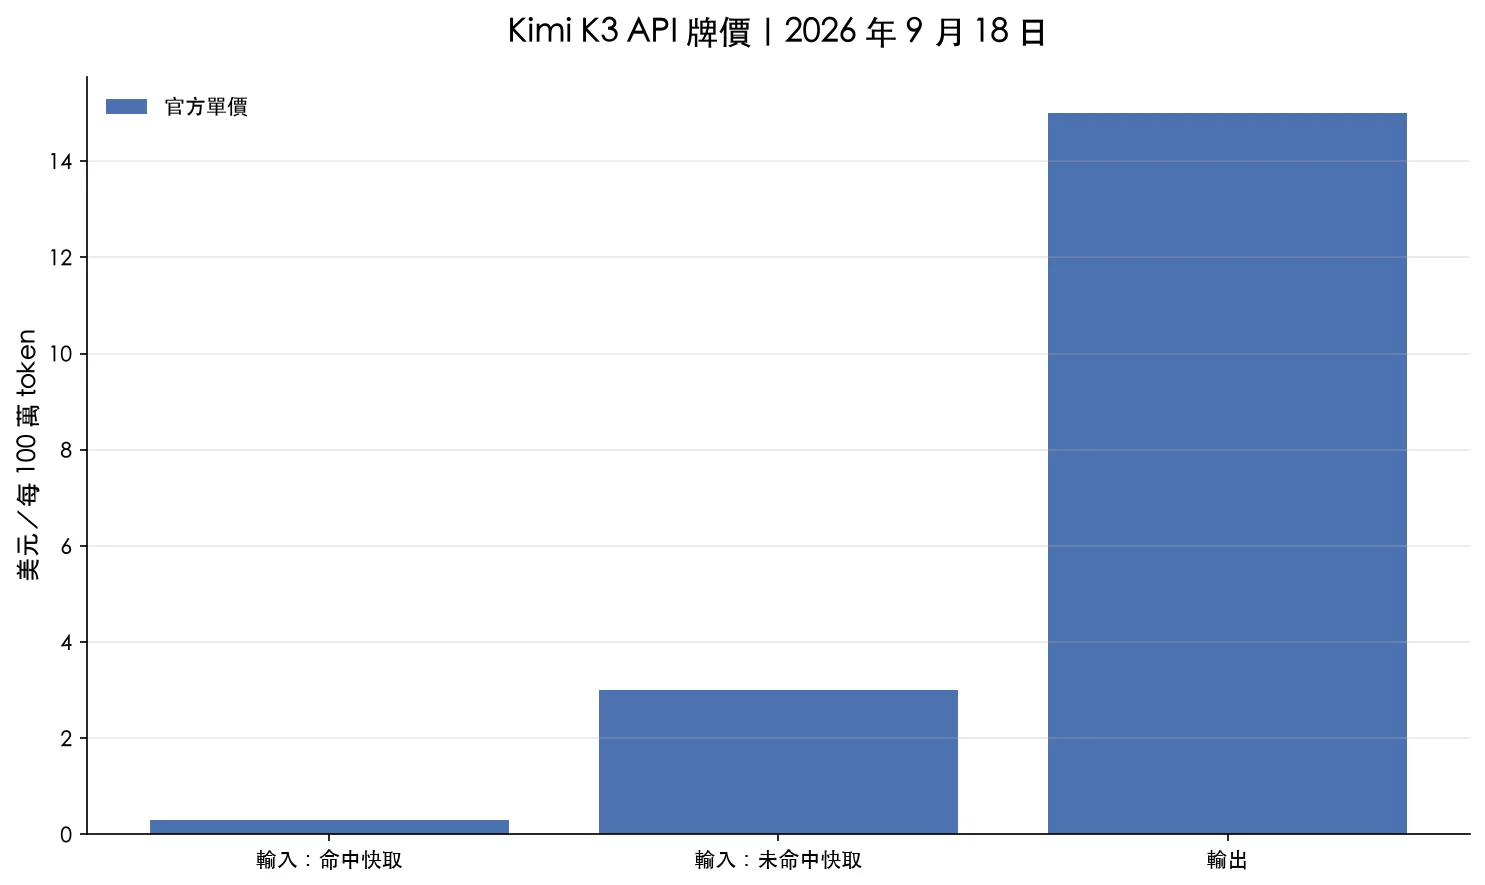
用一個自行設定的預算例子來看:若送入 10 萬個未命中快取的 token,並產生 1 萬個計費輸出 token,模型推理費估算為 0.1 × 3 + 0.01 × 15,也就是 US$0.45。若相同數量的輸入全部命中快取,則為 US$0.18。這只是算式示範,實際以 usage 與帳單為準,推理消耗也不能只靠最終答案長度估計。
發布期的充值返券活動已超過當時公告期間。原促銷連結目前導向帳戶與付款說明,本文不把舊返券比例列為現行優惠。
百萬上下文怎麼用,才不會一直付重複讀取費?
Kimi 的上下文快取會自動處理重複前綴,不需要手動建立快取 ID。固定的文件、規則與工具定義盡量放在穩定位置,變動的問題往後追加。文件列出的必要條件之一,是前一請求的 prompt 超過 256 token,但這不代表每次都保證命中。
例如同一份規格書反覆被問到時,保留規格書的文字與排列,通常比每次重寫前綴更適合快取。若資料持續變動、問題只涉及少部分內容,則應比較檢索後再送入模型的做法。多 Agent 與 RAG 的分工可以協助釐清哪些資料要取回、哪些工作要拆開。上下文大,仍不等於文件中的每個細節都會被正確運用。
跑分怎麼讀?看單項優勢,也看比較條件
以下從官方公開結果摘錄三項工程任務,保留表格與圖方便比較。這是 Moonshot 發布的模型與 Agent 組合結果,並非本文獨立重測。
| 評測 | Kimi K3 | Claude Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE | 67.5 | 70.0 | 73.0 |
| ProgramBench | 77.8 | 76.8 | 77.6 |
| Terminal-Bench 2.1 | 88.3 | 88.0 | 88.8 |
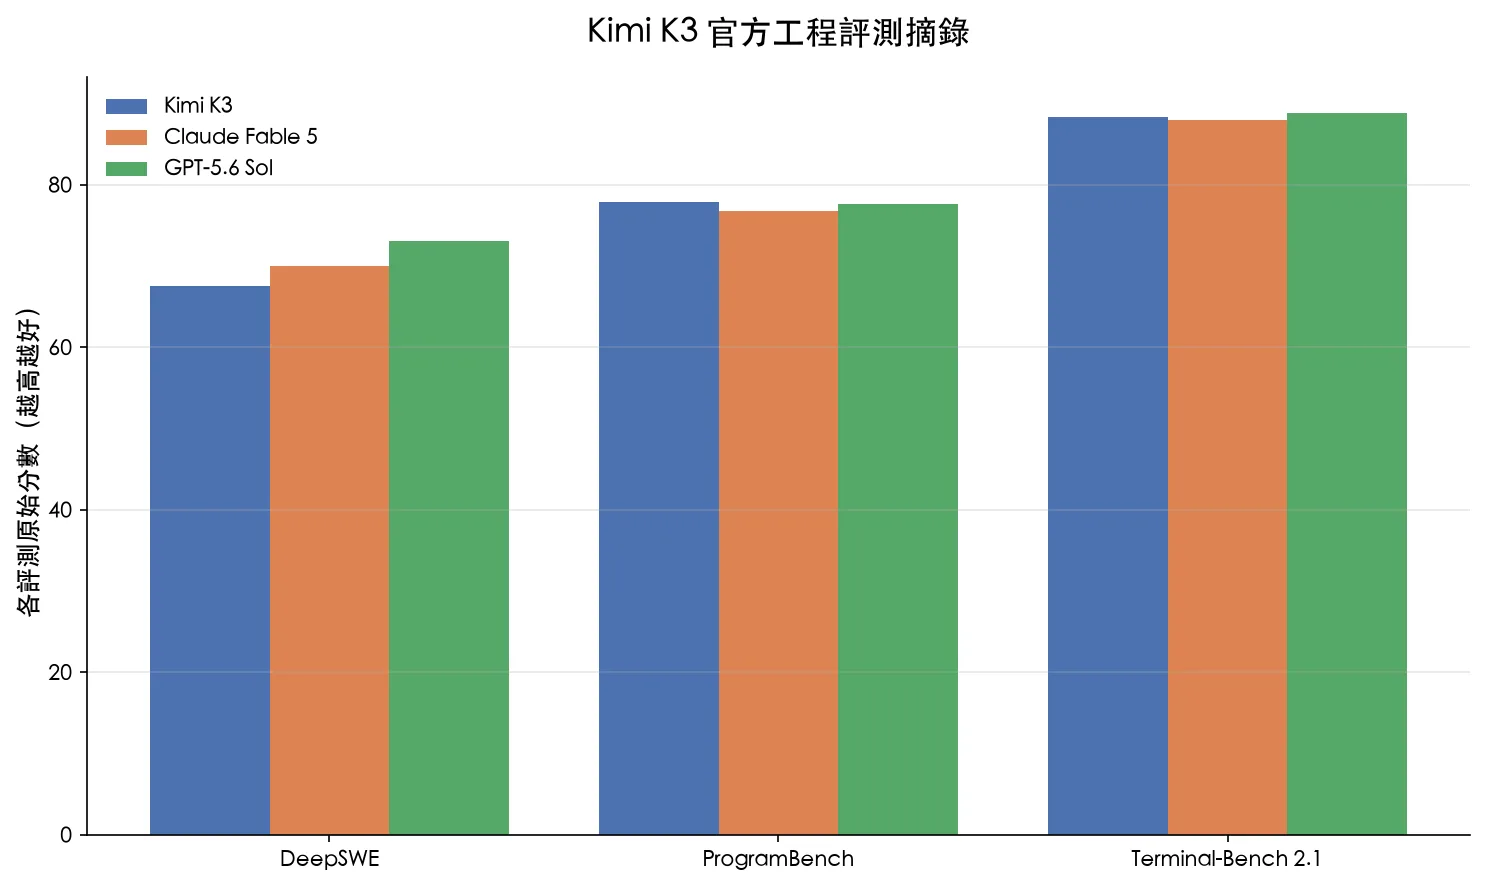
這組數字呈現的訊息很清楚:K3 在 ProgramBench 略高,但 DeepSWE 仍低於另外兩款,Terminal-Bench 2.1 則接近。選模型應從自己的任務開始,觀察完成率、需要人工修正的次數,以及總 token 消耗。
比較表的註腳也很重要。官方部分測試使用不同 Agent 框架,部分競品結果含回退行為。SWE-Marathon 還有硬體校準設定,BrowseComp 也使用上下文壓縮策略。因此,某項分數高,不能直接推出它在任何工具、任何長度的上下文下都更強。
兩種值得測的工作:核心最佳化與看畫面改程式
GPU 核心最佳化:迭代必須跟著量測走
官方工程案例展示 K3 反覆分析、改寫與測量 GPU 核心。這類任務的價值,在於模型能否沿著實際瓶頸持續改善,而不是只產生一段看起來更複雜的程式。對自己的專案,應保留相同測試資料、硬體及數值誤差標準,再比較修改前後。
互動場景與前端:讓截圖成為下一輪回饋
另一類案例是把概念、圖片或影片轉成可互動場景,透過「寫程式、執行、查看截圖、再修改」來收斂成果。這是視覺參與工程迭代的用途。實際驗收時,除了畫面是否接近需求,也要操作按鈕、縮放視窗並測試不同資料,因為靜態截圖看不出所有問題。
K3 集群與 Batch API,不是同一項服務
Chat 產品中的集群模式,處理的是多任務協作體驗。開發者的 Batch API 則是非同步提交請求的介面。這兩個名稱不能互相替代,也不能因為 Chat 有集群,就推論 K3 API 能使用批次折扣。
目前Batch API 文件明列支援 kimi-k2.7-code 與 kimi-k2.6,不支援 kimi-k3。若你要批次處理 K3 任務,應先確認最新支援清單、併發限制與費用,不要把其他模型的 Batch 條件直接套用。
Kimi K3 可以本地跑嗎?先分清容量與速度
完整模型的瓶頸不只是啟用參數。以官方約 2.8 兆總參數粗估,若每個參數只占 4 bit,純權重的理論資料量就是 2.8 × 10¹² × 4 ÷ 8,約 1.4 TB。這個十進位算式沒有包含量化中繼資料、混合精度層、執行時狀態與通訊緩衝,也不是實際下載大小。
官方基礎設施說明建議以 64 個以上加速器的超節點配置部署,目的是發揮通訊與推理效率,不能把它誤讀成所有情境的最低卡數。只算幾張卡的容量加總,也無法保證頻寬、互連、推理引擎與延遲達標。
如果你正在評估自己的電腦,先看本地 AI 的記憶體與頻寬差異,會比單看參數大小更有幫助。對 K3 這個規模,多數個人開發者可以先以 API 驗證任務價值,確定有持續使用的需求後,再評估團隊部署。
開始之前,設一個可以驗收的小任務
挑一項你本來就做得出來、也知道如何判斷對錯的工作,例如修復一個可重現的錯誤,或從固定文件回答五個問題。使用相同輸入比較 low、high、max,記錄通過驗收的比例、耗時與費用。模型的「主動」也需要邊界,先說清楚允許修改的範圍,保留測試結果與變更紀錄。
長上下文與強推理提供更多空間,最後仍要回到成品是否符合需求。把測試、回饋與成本追蹤接好,才比較容易看出 Kimi K3 對你的工作究竟有沒有幫助。
常見問題
Kimi K3 現在只有 max 推理模式嗎?
不是。目前官方 API 支援 low、high、max,預設 max。K3 始終啟用推理,low 不等於完全關閉思考。
Kimi K3 的權重已經開放了嗎?
已開放,可從 Moonshot AI 官方 Hugging Face 模型頁取得。部署前應核對模型卡、推理引擎配方與 Kimi K3 License。
Kimi K3 API 每百萬 token 多少錢?
截至 2026 年 9 月 18 日,官方美元牌價為快取命中輸入 0.30、未命中輸入 3、輸出 15。實際費用另依計費用量、稅費及相關服務計算。
K3 集群代表 Kimi K3 支援 Batch API 嗎?
不代表。Chat 集群是產品功能,目前官方 Batch API 文件仍將 kimi-k3 列為不支援,應以最新模型支援清單為準。
資料核對日期:2026 年 9 月 18 日。本文依指定影片字幕與官方資料整理,已更新推理檔位、權重狀態與 Batch 支援名單。跑分採官方發布結果,未進行獨立模型、付費 API 或大型叢集實測。封面為 AI 生成的概念插畫。
近期留言