by Rain Chu | 9 月 22, 2026 | AI
每天有一千封信、一堆客服單,或幾十個可用工具等著分類,真正耗時間的常常不是寫出漂亮答案,而是先決定「這件事交給誰」「接下來做什麼」,Jev 就是為這類判斷設計的模型,把狀態與問題送進去,拿回程式可以直接使用的選項、分數與機率。
Jev 最適合放在 AI 工作流的分類、路由與檢查關卡,先由它整理判斷,再由程式控制流程,需要寫信、寫程式或解釋事情時,才交給生成模型,這樣的分工,比把所有步驟都寫成一大段提示詞更容易調整與驗證。
Jev 是什麼?先理解 System One 的用途
TypeSafe AI 在 2026 年 9 月 15 日的發布文章中,把 Jev 稱為 System One Model。它接收一份狀態與一組有明確型別的問題,平行評估後回傳結構化結果,不提供一般聊天模型那種自由文字回答。
System One 是借用快速判斷的概念來命名,不能直接拿來斷言模型擁有人類直覺。
可以把工作拆成三層:程式處理查資料、計算與執行動作,Jev 處理模糊語意的判斷,生成模型處理開放式產出。
例如帳單是否超過期限,已有日期就直接計算,客人的文字是在催款、抱怨,還是要求退款,才需要模型理解,這也呼應 CrewAI 工作流裡的角色與流程分工,框架負責安排工作,模型只是其中一個元件。
Choice、Score、Noul:三種問題怎麼選
| 題型 | 要解決的問題 | 怎麼理解答案 |
|---|
| Choice | 客服單要交給帳務、技術還是業務 | 從預先列出的選項選一個,並附各選項機率與 confidence |
| Score | 故障有多嚴重、客人的情緒有多強烈 | 依具體描述的有序等級評分,可落在兩級之間 |
| Noul | 客人有沒有明確要求退款 | 回傳「是」的機率,介於 0 與 1 |
Choice 適合互斥分類,選項要寫出差異,也要替不符合任何分類的輸入保留「其他」或「資訊不足」。若一封信能同時是發票與合作邀約,就拆成兩個是非問題,不要強迫它只能選一個身分。
Score 的重點是描述等級。例如從「外觀問題,不影響操作」「功能受影響,但有替代方式」到「主要流程無法使用」。目前官方文件寫明接受 2 至 10 個等級,從 0 開始編號。回傳 1.4 代表分數落在等級 1 與 2 之間,不能解讀成「有 140% 的把握」,也不代表 40% 的客人受影響。
Noul 則用來判斷一個命題是否成立。接近 1 是偏向肯定,接近 0 是偏向否定,接近 0.5 是肯定與否定的機率相近。若想問「情緒有多憤怒」,應該使用 Score,不能把 Noul 的 0.5 當成「中等憤怒」。
五個 Jev 實作場景,逐一拆開看
範例一:辨認退款是否已完成
給模型一段客服紀錄,問題只問「退款是否已執行」,紀錄寫著「已全額退款,案件結案」,與「我們會在三個工作天內審核退款申請」,是兩種完全不同的狀態,前者描述完成,後者描述等待處理。
這個場景適合用 Noul 讀出語意,但金流狀態仍應以交易系統為準,如果後台已經有明確的退款完成欄位,就直接查欄位。模型讀到一封寫著「已退款」的信,不代表它驗證了銀行入帳,更不代表它取得再次退款的權限。
範例二:客服單一次判斷五件事
假設客人寫「我被重複扣款,今天一定要處理」,後台也提供方案與帳戶年資,一次請求可以同時判斷分類、嚴重程度、是否要求退款、是否提供重現步驟,以及情緒強度,分類用 Choice,嚴重程度與情緒用 Score,另外兩題用 Noul。
接著由程式決定分派規則,例如帳務問題交給帳務組,明確的付款異常加上強烈急迫性才提高優先順序,「被重複扣款」也不必然等於「明確要求退款」,問題文字要區分推測需求與直接表達,遇到前後矛盾的描述,就標記待確認。
官方的 多題評估說明指出,同一個請求裡的問題各自依據原始狀態作答,某一題的答案不會自動變成下一題的輸入,只有需要先取得答案、再查新資料或建立新選項時,才拆成第二次請求。
範例三:便宜模型與強模型之間的路由
同樣是使用 AI,「修正幾個錯字」與「設計含過期機制、測試與並行控制的快取系統」,需要的能力不同。可以讓 Jev 依任務條件選擇處理路徑,再交給對應模型完成工作。
路由選項要描述適用條件,而不是只有模型名稱。簡單改寫走快速路徑,涉及跨檔案修改、複雜除錯或需要更多上下文的工作走較強路徑,無法確定時保留升級處理。是否真的省錢,要把路由費、生成費、重試與分錯之後的修正成本一起計算。
選模型與接外部工具是不同層次。像 AISA 這類 Agent 能力與 API 整合層處理的是資源入口,Jev 處理的是在既定選項裡做判斷,兩者可以互相配合。
範例四:內容審核先拆問題,再決定處置
輸入留言文字、必要的討論上下文與檢舉資訊,分別判斷是否為垃圾訊息、是否含人身攻擊,以及是否需要人工檢查。不要把所有不喜歡的內容統稱為「有害」,否則模型再快,也只是在加速模糊的標準。
較穩妥的導入方式,是先讓系統提出允許、待審或限制顯示的建議,由既有政策決定動作。低把握的案例進待審區,並保存原文與判斷依據,方便回頭找出錯誤分類。先跑一段時間的影子模式,再決定哪些判斷可以自動執行。
範例五:替生成模型的回覆做最後檢查
生成模型寫好客服回覆後,把客人問題、回覆草稿與相關規範放在一起,再問幾個獨立問題:是否回答到問題、語氣是否適當、是否洩漏不該對外的內部規則。只要任一重要項目不合格,就退回重寫或交給人員確認。
這能增加一道檢查,但不能保證攔下所有幻覺。涉及訂單金額、退款狀態、方案權益等事實,還是要對照可靠資料。輸出能被程式讀懂,也不等於內容可信,這與 用結構化規格控制 AI 圖表產出的道理相通,格式驗證與內容驗證都要做。
把五個範例串成一條可用的客服工作流
客服單進站 → 取得必要的帳戶與交易資料 → Jev 分類與評估 → 程式分派 → 生成模型撰寫草稿 → Jev 與確定性規則檢查 → 通過後依既有權限送出,否則人工處理。
這條流程的價值在於責任清楚。模型不需要自己猜去哪裡查帳,也不負責決定誰有退款權限。每次判斷都能記錄輸入、題目版本、模型版本與結果,錯了之後才知道應該補資料、改分類標準,還是更換模型。
郵件、遊戲與瀏覽器:延伸案例應該看什麼
大量郵件分類很適合檢查這種分工。先區分發票、合作邀約、需要親自回覆與垃圾信件,再讓程式標籤或排入待辦。可以從 大量郵件分類示範與 Ryan Vogel 的信箱整理案例觀察流程,費用與耗時則要依自己的信件長度、併發量與錯誤率重測。
遊戲展示最有意思的地方,是把世界狀態轉成可判斷的選項。例如 官方 DOOM 示範使用結構化遊戲狀態選動作,不能據此推論模型直接看懂每個畫面。像 TypeSafe Mario同樣從模擬器狀態選擇操作。虛擬小鎮 NPC、棋局或 駕駛模擬示範也應視為特定環境的展示,不能延伸成一般推理、棋力或真實道路安全的證明。
browser-use/jev-ultrafast把網頁整理成可操作元素,讓 Jev 選動作與目標,需要輸入文字時再搭配生成模型。它展示的是整套瀏覽器流程的改善,模型延遲、頁面載入與瀏覽器操作次數都會影響最後耗時。
Unclutter則讓 Jev 分類頁面上不必要的區塊,再保存可重用的隱藏規則。專案提供手動分析與造訪頁面時分析兩種模式,預設是手動。擴充功能程式碼公開,不代表推論永遠免費,仍需要對應服務的 API Key 與使用額度。
如果 Agent 手上有大量技能,還可以參考 官方 Skill suggestion 範例,先篩選候選技能,再讀取完整說明重新判斷。這是特定模型與測試集下的流程實驗,不能把其改善幅度直接當成所有 Agent 的保證。
Jev 真的快 200 倍、便宜 400 倍嗎?
這類數字要連同比較條件一起讀。官方發布文章展示特定工作流中接近兩百倍的加速與數百倍的成本差距,並不代表任何輸入、任何地區或任何替代模型都會得到同樣結果。一般聊天 API 逐步生成答案,與專門評估固定選項的 API,本來就在做不同形狀的工作。
官方評測網站採用固定工作流比較不同模型,參考答案來自指定大型模型的評估。這衡量的是與參考答案的一致程度,不能直接當成人工確認的真實正確率。比較時還要看重試、提示格式、輸入長度與是否要求其他模型回傳機率,避免只挑最大倍率下結論。
截至 2026 年 9 月 22 日,TypeSafe 發布頁列出的價格為每百萬輸入 token 0.042 美元,輸出不收費。這裡的輸出是決策結果,不能理解成可以免費生成無限文章。以下只按公布的輸入單價試算,不含前處理、其他模型、重試與周邊服務。
| 累計輸入量 | Jev 輸入費用試算(美元) |
|---|
| 10 萬 token | 0.0042 |
| 100 萬 token | 0.0420 |
| 1,000 萬 token | 0.4200 |
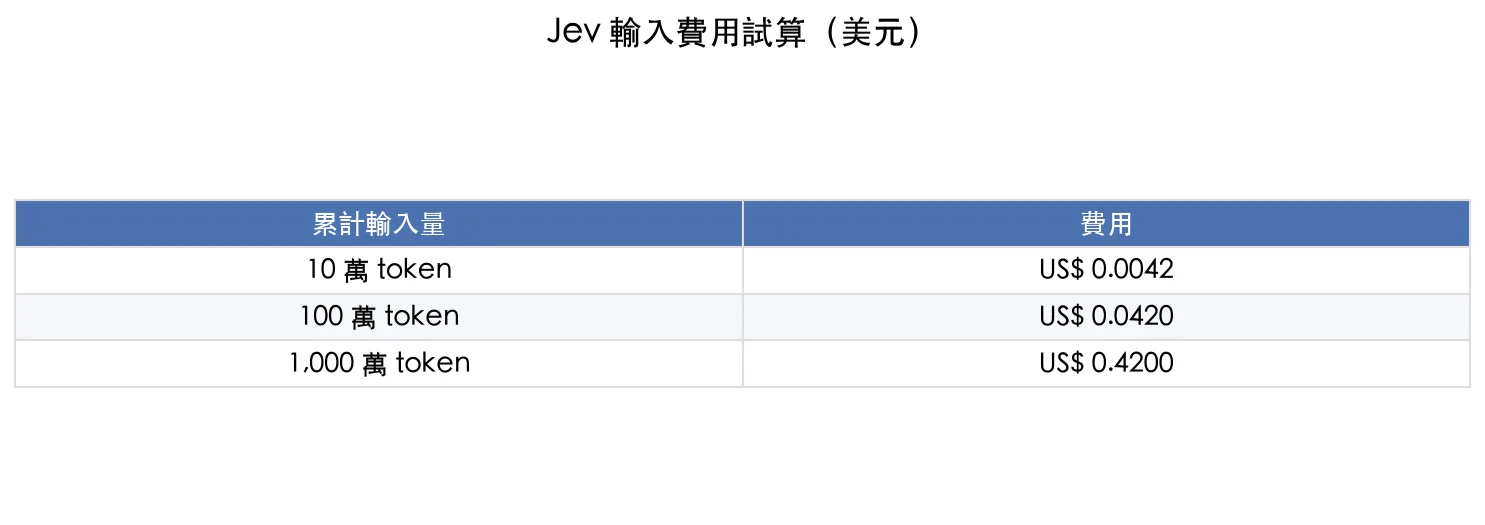 依每百萬輸入 token 0.042 美元計算,這是費率換算,並非實測帳單,未計其他服務成本
另外,Vercel 的接入公告寫有截至 2026 年 9 月 25 日的 AI Gateway 免費活動。它是有期限的平台活動,與模型的常態定價分開看,實際使用前仍要確認帳戶當下適用條件。
怎麼開始用?先選官方介面,再做小規模驗證
想直接試題目,可以從 官方 Quick start 與 Playground開始。API 使用 state、model 與 questions 三個主要欄位。
直連 TypeSafe 的模型名稱是 jev-latest,端點為 https://api.typesafe.ai/v1/systemone。帳戶是否已取得權限,以控制台顯示為準。
若透過 Vercel AI Gateway,官方公告的方式是 AI SDK 7.0.105 以上搭配 experimental_evaluate,模型識別字為 typesafe-ai/jev。
兩條接入路徑的欄位與回傳格式不要混用,AI SDK 範例中的 boolean 與 TypeSafe 原生 Noul 也不是可以直接替換名稱就完成的同一份請求。
想交給 Coding Agent 實作,可先讀 TypeSafe 官方技能專案,再讓它依工作流挑出適合做語意判斷的步驟。這套技能與部分示範程式公開,不代表 Jev 模型權重已開放下載。本次整理依據公開文件與示範,未另行呼叫付費 API 做效能實測。
上線前,比速度更重要的三件事
- 準備真實且有標註的測試資料。除了一般案例,也放入模糊、互相矛盾、繁體中文、混合語言與不屬於任何分類的輸入。先建立既有規則或既有模型的基準,才知道更換後有沒有改善。
- 把 confidence 當成分流訊號。依 官方 confidence 說明,它反映 Choice 與 Score 機率分布的集中程度。高 confidence 仍可能判斷錯誤,門檻要用自己的驗證資料設定,不能一律套用同一個數字。
- 量完整工作流。除了平均耗時,也記錄較慢案例、錯誤分流、人工接手比例與重試成本。分類容易自動化,不代表寄信、刪除資料或退款也應一起放行。
我會先從信件標籤或客服單分派做起,保留人工對照。只有當錯誤率、延遲與維護成本都符合需求,才逐步接到更重要的流程。Jev 值得研究的地方,是讓 AI 判斷變成可以組合與檢查的小步驟,而不是用一個誇張倍率取代驗證。
常見問題
Jev 的型別安全代表不會判斷錯嗎?
不代表。輸出符合指定型別,與語意判斷正確是兩件事。仍應提供資訊不足的處理方式,並以真實資料驗證錯誤率。
Jev 的 Score 與 Noul 有什麼不同?
Score 衡量有序等級上的程度,Noul 衡量是非命題成立的機率。Noul 接近 0.5 表示肯定與否定的機率相近,不是程度中等。
多個問題一定要分成多次 API 呼叫嗎?
不需要。能依據同一份狀態獨立判斷的問題,可以放在同一個請求。若後一步必須先取得前一步答案,再查新資料或建立選項,才分開呼叫。
Jev 現在完全免費,而且可以本機部署嗎?
官方發布頁提供按輸入 token 計費的方案,Vercel 的免費活動有期限
by Rain Chu | 9 月 21, 2026 | AI, TTS, 圖型處理, 影片製作, 模型, 虛擬人, 語音合成, 語音辨識
AI 女友本地部署,可以做成真正接得上話的語音數位人:當麥克風收音後,由語音辨識轉成文字,Qwen3 產生回答,Qwen3-TTS 合成聲音,再交給 LiveTalking 生成嘴型畫面。角色的回答隨當下對話產生,不只是播放固定台詞。
最實用的起步方式,是先把「聽得懂、答得出、播得出聲音」跑通,再加入人物形象。
這套系統有好幾個服務,任何一層沒啟動,都可能看起來像整個網頁壞掉。
先看懂整套流程:聊天模型只是其中一站
語音互動可拆成五個環節:VAD 判斷你是否正在說話,faster-whisper 辨識語音,Qwen3 組織回覆,Qwen3-TTS 產生音訊,LiveTalking 把音訊轉成嘴型並傳回瀏覽器,畫面與對話分工之後,才有辦法逐層測試。
Hugging Face speech-to-speech採用可替換元件的語音流程,語言模型可以接自己的 llama.cpp 服務,初次接觸這類架構,可以先看本地即時語音 Agent 的元件分工,再加上數位人畫面。
「免 API 費」比較精確的意思,是不必向雲端模型服務支付推理費,程式之間仍可能透過本機 API 溝通,電腦硬體、用電與安裝時間也不會因此消失。
8GB 顯卡能跑嗎?先算所有常駐元件
只看 Qwen3 能不能載入,會低估整套系統的需求。語音辨識、語音合成、嘴型模型、上下文快取與桌面顯示,都可能一起使用顯示記憶體。素材生成階段的 ComfyUI 也有自己的負載,完成底片後應釋放它的資源,再測常駐對話服務。
下表採用作者教學頁列出的 RTX 4090 配置估算,方便理解資源分配。這些近似值不是本文實測,也不是官方最低需求。
| 元件 | 範例配置 | 約用顯示記憶體 |
|---|
| 語言模型 | Qwen3-14B Q4_K_M | 9GB |
| 語音辨識 | faster-whisper large-v3 | 3GB |
| 語音合成 | Qwen3-TTS 1.7B | 4GB |
| 嘴型同步 | wav2lip256 | 1.3GB |
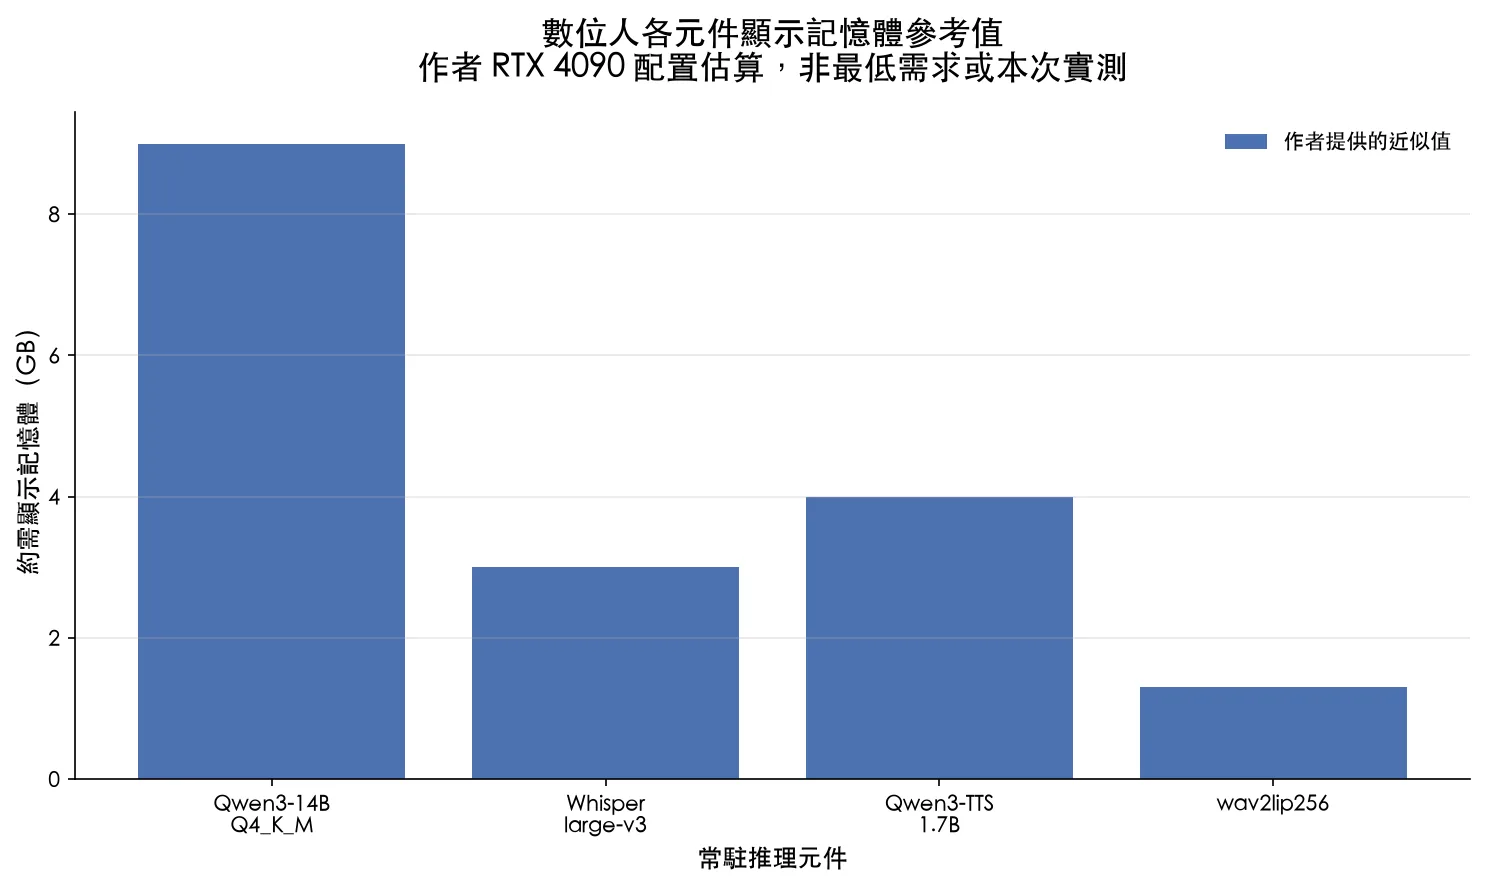 作者配置的近似值,僅供理解各元件負載,不能視為最低硬體門檻。
因此,不能把這份完整配置原封不動套到 8GB 顯卡,容量有限時,先選較小的量化 Qwen3、縮短上下文,再評估語音辨識模型與運算位置,faster-whisper 官方效能資料也顯示,精度與批次設定都會改變記憶體需求,光是模型名稱一樣,佔用量仍可能不同。
步驟一:準備 WSL,先確認 GPU 與資料夾
以下以 Windows 搭配 NVIDIA 顯卡及 WSL 2 為主。先安裝 Windows 端的 NVIDIA 驅動,再安裝、更新 WSL,NVIDIA 官方文件明確說明,WSL 使用 Windows 驅動映射的 CUDA 支援,不要在 WSL 裡另外安裝 Linux 顯示驅動。
Windows PowerShell 的起步指令如下,若已有 Ubuntu,不必重複安裝。
依畫面要求完成重啟與帳號設定後,在 Ubuntu 執行 nvidia-smi 確認顯卡可見。
wsl --update
wsl --install -d Ubuntu-24.04
Python 環境、模型處理與執行檔案,建議放在 WSL 的 Linux 家目錄下,Microsoft 的檔案系統建議是讓 Linux 工具優先使用 Linux 檔案系統,可減少跨系統讀寫負擔,環境基礎可參考Windows 與 WSL 的 AI 開發環境整理。
WSL 網路設定不是一個開關解決全部問題
Windows 11 22H2 以上可在使用者目錄的 .wslconfig 啟用 mirrored 網路,Microsoft 說明指出,這種模式支援 Windows 與 WSL 透過 127.0.0.1 互連。記憶體上限則應按實際機器調整,不要照抄別人的容量。
[wsl2]
networkingMode=mirrored
hostAddressLoopback=true 是額外允許透過主機其他 IPv4 位址互連的設定,只在 mirrored 模式下適用,官方設定文件並未說所有 WebRTC 失敗都必須靠它修復。改完設定後,可在保存其他 WSL 工作後執行 wsl --shutdown,再重新啟動環境。
步驟二:先讓 Qwen3 單獨回答文字
從 llama.cpp 官方專案選擇適合 Windows 與顯卡的版本,下載對應的 GGUF 模型,容量有限時,可先研究 Qwen3-4B 官方 GGUF,而不是直接載入較大的模型。檔名應以實際下載結果為準。
下面是啟動本機文字服務的設定範例,請把模型路徑換成自己的檔案。這組命令只用來說明參數,未在本文中進行 GPU 實測。
llama-server -m "C:\AI\models\your-qwen3-model.gguf" -ngl 99 -np 1 -c 4096 --host 127.0.0.1 --port 8090
先開啟 http://127.0.0.1:8090 測試文字回覆,再把語音服務的模型端點指向同一個位址與連接埠,llama-server 文件列有模型路徑、上下文與監聽位址參數,若使用 NAT 網路跨 Windows 與 WSL 連線,位址安排會不同,應按前一節的網路模式處理。
連接埠不是非 8090 不可。若無法綁定,先看錯誤與 Windows 保留區間,再選可用的埠,也不必為了單機測試直接監聽全部網卡,只有確實需要其他位址連入時,才調整監聽範圍與防火牆。
步驟三:接上語音辨識與 Qwen3-TTS
先用一句短句測試語音辨識,再讓 TTS 單獨唸出固定文字,兩者各自正常後,才把它們接到文字模型,這樣能分辨「沒聽見」「辨識錯」「模型沒回覆」與「音訊沒播出」是哪一段出問題。
若使用作者整合包,install-voice.sh、start-voice.sh 與後續的橋接檔案應維持同一版本,這些是教學包的客製腳本,並不是所有官方專案都有的通用指令,下載入口可由原作者部署教學取得,本文未執行或驗證該整合包。
自行安裝目前官方 speech-to-speech 時,要明確選定本機 LLM 端點與本地語音元件,單獨執行預設服務命令,不代表一定選到全本地配置,首次啟動還需要下載模型與完成載入,前端頁面能打開,不代表語音後端已準備好。
聲音復刻要選 Base,固定音色則看 CustomVoice
Qwen3-TTS 官方說明區分 Base、CustomVoice 與 VoiceDesign,想根據參考錄音復刻聲音,應使用支援 voice clone 的 Base 路徑,CustomVoice 提供預設說話者,不能把兩者的參數直接互換。
參考音訊使用自己錄製或有授權的聲音,保持單人、背景乾淨,並準備正確的逐字內容,
不要只把 MP3 副檔名改成 WAV,也不要假設所有模組都用同一取樣率,應在需要的交接點真正轉換格式。更多音色選擇可參考Qwen3-TTS 音色設計與聲音復刻。
步驟四:用 LiveTalking 驗證聲音與嘴型
LiveTalking 官方專案支援 Wav2Lip 等嘴型模型,並提供 WebRTC 輸出,先依目前 README 安裝相容環境與權重,使用官方範例形象測試。舊教學的 Python、PyTorch 版本可能和目前文件不同,不要任意混裝兩套依賴。
完成官方安裝與模型放置後,範例啟動命令如下。開啟 http://localhost:8010/index.html,建立連線後先測畫面,再測文字或音訊驅動。官方文件要求把對應權重放到指定目錄,檔名也要相符。
python app.py --transport webrtc --model wav2lip --avatar_id wav2lip256_avatar1
這一步的目標是確認嘴型服務本身能工作,範例能出聲音,不足以證明聲音是本地生成的。仍要核對選用的 TTS 後端,確保正式串接時收到的是前一層本地 TTS 的音訊。
步驟五:準備自己的形象,最後才做整合
人物底片使用嘴部清楚、沒有手遮擋、動作平穩的素材。可以自己錄製,也可先用 Wan2.2 等圖生影片工具製作一小段待機畫面。鏡頭固定、人物稍微呼吸或眨眼即可,避免原片持續大幅說話,讓後續嘴型替換更容易處理。
底片長度、解析度與幀率要配合生成模型及後續預處理,不能把某份模板的幀數與匯出設定,說成整個 Wan2.2 系列只能產生固定秒數,若模板有提示詞擴寫功能,先確認它是否改寫了你要保留的場景。
LiveTalking 提供 /avatar.html 形象建立頁面,可上傳影片並產生角色資料,完成後,用新形象的 ID 啟動服務,再確認嘴部邊緣、遮擋與音畫同步。底片是角色外觀素材,實際回話的嘴型仍依當下音訊產生。
完整整合需要橋接語音輸出與人物服務。作者教學包中的 avatar-sync.js 承擔這部分工作,因此不能只安裝兩個官方專案,就假設它們會自動連接。建議依序啟動文字模型、嘴型服務、語音服務,再開前端檢查每一層日誌。
讓對話更自然:回覆長度比華麗人設更有用
語音回答先控制在一兩個重點,避免長篇條列與會被唸出來的格式符號。以下是可自行調整的原創人設示例,重點是語氣與回覆形式,不需要要求角色否認自己是 AI。
你是一位名叫小晴的虛擬聊天夥伴。
使用自然的臺灣繁體中文口語,回覆以兩三句為主。
先回應對方剛說的內容,再視情況提出一個簡單問題。
不要使用 Markdown、編號或表情符號。
不知道的事情直接說不知道,不要虛構共同經歷。
支援思考切換的 Qwen3 模型可以用 /no_think 控制模式,但仍要依模型與聊天模板確認,若換成不同的 Instruct 版本,不能假設同一控制文字都有相同效果。
聲音很自然,回答就一定聽懂了嗎?
聊天時最容易混淆的是語氣與理解能力。角色能用自然音色談論喝奶茶、工作很累等日常話題,並不代表它穩定追蹤了誰在說話、誰與誰是什麼關係。多人輪流發言或連續追問身分時,回覆可能仍然流暢,內容卻已經接錯人或繞回固定話題。
驗收時應把「聲音像不像真人」與「答案有沒有回應問題」分開。用幾句意思相近但主詞不同的問題測試,再核對辨識文字。如果前一層把話聽錯,先修收音與轉錄。如果轉錄正確而回覆混亂,再調整對話歷史、角色規則或模型,不能只因為聲音很順就判定整套系統成功。
搶話、沒反應、WebSocket 失敗,分層排查
一直顯示「等待語音後端就緒」
先查看後端是否正在下載模型,或已經因套件、CUDA、磁碟空間而退出。檢查真正的錯誤訊息與下載進度,再決定是否重啟。只重整前端頁面,無法修復後端缺少權重的問題。
網頁打得開,但 WebSocket 連不上
官方瀏覽器示範文件區分前端頁面與語音後端。例如頁面可位於 7860,而語音連線使用另一個埠與 /v1/realtime 路徑。依實際版本核對位址、連接埠、路徑及協定,不能把前端網址直接當成 WebSocket 端點。
WebRTC 失敗則要看服務端、ICE 候選、網路模式與防火牆。
前端出現 JSON 解析錯誤,可能只是收到錯誤回應,不能僅憑這句話認定是某個 WSL 開關沒開。
麥克風有權限,卻完全沒有辨識結果
先確認選到正確輸入裝置與收音電平,再調整 noise gate 與 VAD 門檻。
門檻過高可能把正常說話擋掉,降得太低也可能讓環境聲觸發回應,瀏覽器麥克風規則要求安全環境,本機可用 localhost,其他裝置連入通常應使用 HTTPS。
還沒說完就被搶答,或聽起來像在等很久
先調整結束發言的靜音等待,再測辨識與合成速度。等待較長,較能容忍句中停頓,但回答也會更晚開始。這是輪流說話的取捨,不能單靠加大模型解決。使用耳機也能避免喇叭聲再次進入麥克風,造成誤觸發。
衡量延遲時,要從你停止說話算到真正聽見第一個字,包含等待、辨識、文字生成、音訊生成與播放緩衝。嘴型影片播放流暢,只代表畫面跟得上,不等於對話回覆沒有延遲。
離線與免費,最後要驗收哪些條件?
首次安裝與模型下載通常需要網路。若要斷網使用,先讓選定的全本地配置完整啟動一次,再檢查模型快取、前端資源、語音後端,以及是否仍依賴外部 STUN 或其他服務。外網通道與雲端語音服務也不能算成純離線方案。
原始 Wav2Lip 專案對其開源模型的商用有明確限制,不能因整合框架使用 Apache 授權,就推論整套權重都可任意商用。對外使用前,應核對實際下載模型的來源與授權。
第一個完成標準可以很簡單:連續問幾個新問題,辨識內容正確、回答有關聯、聲音完整、嘴型能跟上。這些都穩定後,再增加個性設定、外觀與更長的對話記憶。
常見問題
要復刻聲音,Qwen3-TTS 該用哪一版?
應使用支援參考音訊復刻的 Base 路徑。CustomVoice 提供預設音色,與聲音復刻的輸入方式不同。
為什麼 localhost 頁面能開,語音卻連不上?
前端頁面與語音後端可能使用不同連接埠。應先確認後端啟動完成,再核對 WebSocket 位址、路徑、協定與網路設定。
AI 女友本地部署後可以斷網聊天嗎?
選定的模型、依賴與前端資源都已備妥,而且語音、對話與串接服務不依賴雲端時,才可能離線使用。應先跑通完整配置,再做斷網測試。
by Rain Chu | 9 月 20, 2026 | Agent, AI
當工作需要反覆讀取私人文件、呼叫工具,或同時執行多個任務,模型之外的資料流向、硬體安排與執行框架,也會影響實際成果。
DSH Privacy Router、NVIDIA PAIR、EXO 與 Perplexity Portable Computer,分別處理隱私分流、區網排程、模型分散運算與完整 Agent 工作流程。
本機 AI 先看三件事:資料、容量與工作流程
第一件事是資料能不能外傳。即使雲端模型能力更強,有些內容仍應留在自己的設備或信任的內部網路。
第二件事是硬體能不能容納模型,以及能否在可接受的時間內完成工作。
第三件事是模型以外的操作,像讀檔、搜尋、驗證與產出文件,有沒有完整流程。
這些問題需要分別處理。推論引擎負責執行模型,Agent 框架負責組織工具與任務,路由器則決定請求送到哪裡。
還不熟悉這些層次,可以先看 本地大模型推論框架比較,再判斷自己缺的是哪一層。
DSH Privacy Router:先判斷哪些內容能送雲端
DSH Privacy Router 是 DeepSeek Harness 的 Host 端插件。
它先用本機規則與模型檢查文字,分類為 public、sensitive 或 unknown。
只有通過公開分類的請求才送雲端,敏感或不確定的內容留在本機。
這是隱私導向的分流,不是單純把困難問題全部轉給大模型。
預設雲端上下文只包含本輪通過檢查的純文字、固定系統提示與空工具清單。
專案文件說明,私有對話與本機工具結果不會直接附帶過去,雲端回答則直接串流回目前對話,不由本機模型再次改寫,開啟特定相容事件功能後,才可納入先前已核准的雲端對話。
公開程式可看到兩個關鍵控制:雲端分支只在分類結果為 public 時啟用,真正送出時會重新組合訊息,並把工具列表設為空。這比只在提示詞寫「不要洩漏資料」多了程式層的限制。不過,這仍不代表整個應用的所有網路流量都受到同一個插件管理。核對版本見 DSH 路由程式。
導入前要知道,這個公開儲存庫不包含展示用 Web UI 或 DSH 原始碼補丁。
README 的介面展示屬於構想,不能把安裝插件理解成會立即得到完整視覺介面。
先依文件設定可信任的本機 Provider,再確認實際連到的服務確實位於可信任環境。
自動發現本機算力,不等於自動信任任何設備
配套的 Local AI Discovery Server 用 mDNS/DNS-SD 宣告區域網路中的 OpenAI 相容 API,提供主機、連接埠、模型清單位置與認證需求等資訊。
它負責讓服務被找到,本身不執行模型,也不是 API 代理。DSH 端仍需要對應的發現整合。
發現服務與信任服務是不同步驟,在家中看得到的端點,不代表公司文件就適合送過去,更不用說共享空間的陌生設備。
評估時應確認設備由誰管理、是否使用認證,以及請求最後送往哪個端點。服務名稱帶有「local」,不能取代這些確認。
NVIDIA PAIR:把獨立請求分配給區網內的電腦
NVIDIA Personal AI Router,也就是 PAIR 目前以測試版提供本機推論路由,支援相容的 Windows、Linux、macOS 系統,搭配 Ollama 與 LM Studio。它的目標是讓應用使用單一入口,把多個推論請求分配給可用設備。
PAIR 不會把多台電腦的顯示記憶體合成一個大空間,也不會把同一個推論請求拆到多台執行。每個請求會交給一個符合條件的節點,該節點負責執行到結束。
當多個 Agent 同時提出獨立請求時,其他設備才有機會分擔排隊壓力。
官方技術文件說明,排程會考慮節點是否在線、推論引擎是否可用、是否有指定模型,以及目前負載。節點經過配對後,通訊使用相互 TLS 驗證與加密。
這解決的是信任節點之間的推論傳輸,不能延伸成 Agent 使用任何搜尋或外部工具都不會外傳資料。詳見 NVIDIA PAIR 技術說明。
若工作主要是一個接著一個的長推論,或只有一台設備裝了需要的模型,多加節點的效益可能有限。評估時要看整個任務完成時間,以及 Jobs 紀錄是否真的顯示不同節點處理請求,而不只看畫面上出現幾個 Agent。
EXO:把模型拆到多台設備,與 PAIR 的用途不同
EXO 的核心包含模型分片與分散推論,會考慮裝置資源及網路拓樸,讓單一設備放不下的模型有機會跨設備執行。README 介紹了 MLX、張量平行與 Thunderbolt RDMA 等能力,這和 PAIR 分派完整請求的做法不同。
分散推論需要設備交換資料,速度取決於模型、切分方式與實際互連。
能容納更大模型,不代表每次回答一定更快,也不能直接把各台硬體的標示效能相加,想理解雙機部署的取捨,可延伸閱讀 雙機本地模型部署與實測整理,並分開看容量與速度。
截至 2026 年 9 月 14 日核對,EXO 的 平台支援文件 把 Apple Silicon macOS 列為已測試與維護的主要平台,Linux CUDA 與 DGX Spark 則仍列在規劃區。
Portable Computer:把本機模型接成完整 Agent
Perplexity Portable Computer 的定位是本機優先的 Agent 軟體,不是一款 Perplexity 品牌硬體。
官方發表資料以 DGX Spark 為首波設備,將模型、執行框架與工作紀錄放在本機,必要時再經授權使用搜尋、連接器或雲端模型。
平台支援與訂閱資格會更新,安裝前應重新確認產品入口。
比起單純啟動模型,它更重視框架如何配合本機模型的能力:
縮小核心工具集合、按需載入 Skills、整理過長上下文,以及加入結果驗證。官方研究也說明,工具執行受作業系統層的沙箱限制,沙箱不可用時不退回無隔離執行。參考 Perplexity 的本機優先 Agent 研究。
雲端顧問只接收核准的上下文並回傳文字建議,沒有直接操作本機檔案與工具的權限。是否開啟顧問,以及採手動或自動核准,由使用者設定,「本機優先」仍須搭配實際的連外與核准政策來理解。
中文導讀也可參考 AI 郵報 Portable Computer 整理。其中的硬體需求、測試分數與上市資訊,應回到對應官方文件與測試條件核對,不宜直接推論成所有任務的表現。
四個方案怎麼分?先對照自己要解的問題
| 方案 | 主要處理的問題 | 不能直接推論的能力 |
|---|
| DSH Privacy Router | 判斷文字是否可送雲端並限制上下文 | 不能保證分類永遠正確或涵蓋所有資料出口 |
| NVIDIA PAIR | 把獨立推論請求分配到可用的區網節點 | 不合併顯示記憶體,也不切分單一推論請求 |
| EXO | 跨設備切分模型與分散推論 | 不代表任意平台組合都已支援或一定加速 |
| Portable Computer | 整合本機模型、工具、沙箱與授權連外 | 本機優先不代表開啟外部服務後仍完全離線 |
這張表依前述官方文件整理的是功能範圍,不是效能排名。若想組合使用,還要核對 API、模型格式、端點與執行框架是否相容,不能假設名稱都和本機 AI 有關就能直接串接。
隱私真正難的地方,是內容看起來不敏感
沒有姓名、電話或金鑰,不代表內容可以公開。
例如尚未發表的產品構想、內部定價方法或獨特研究策略,就算去掉身分資訊,仍可能包含不應外傳的價值,這是自動隱私分類需要面對的限制,不能只用是否偵測到個資判斷。
DSH 用規則加模型檢查,Portable Computer 也描述了分類器與核准機制,但分類器仍可能漏判。
對不可外傳的工作,應有明確的本機限定設定,以及實際阻止連外的權限或網路政策。對允許求助雲端的工作,則要看清楚送出的片段、歷史上下文與工具結果。
驗收可以從幾種情境開始:一般公開問題、含機密的文件、依賴前文的「繼續」、分類失敗,以及雲端要求呼叫工具。
確認它們分別送去哪裡、留下什麼紀錄,並能追查答案由哪個模型產生。不要為了觀察系統又把完整機密複製進不受控的日誌。
開始之前,先用現有設備跑完一個真實任務
先挑一個可驗證的小工作,例如整理不含機密的測試文件,用現有設備與合適模型完成一次。若問題是模型服務與應用怎麼接,可以先參考 LibreChat 與 Ollama 的串接方式,等單機流程穩定,再處理分流與多機。
接著辨認瓶頸。獨立請求很多、都擠在同一台,才評估 PAIR。模型放不下,才研究 EXO 等分散推論路線。
需要選擇哪些內容送雲端,再檢查 DSH 的分流設計。想降低工具、沙箱與任務流程的整合工作,則可評估 Portable Computer。
本機推論能減少按量 API 費用,但仍有硬體、電力、維護與等待時間。選擇性使用雲端,也可能產生額外用量。
先量出自己的任務品質與完成時間,再決定是否擴充設備,會比從硬體規格開始更容易做出合適選擇。
本機 AI 路由常見問題
DSH Privacy Router 會把困難問題自動交給雲端嗎?
它主要依隱私分類分流,只有判定為 public 的請求才走雲端。敏感、不確定或無法分類的內容留在本機,不能視為單純依難度切換模型。
NVIDIA PAIR 能把多台電腦合成一張大顯卡嗎?
不能。PAIR 將獨立推論請求分派給符合條件的單一節點,不合併顯示記憶體,也不把一個請求切到多台電腦執行。
EXO 和 PAIR 差在哪裡?
EXO 包含跨設備模型分片與分散推論能力,PAIR 則分派完整的獨立請求。選擇前要先分清楚瓶頸是模型容量,還是同時有太多請求排隊。
Portable Computer 等於完全離線嗎?
不一定。核心工作預設在本機,搜尋、連接器與雲端顧問則可能連外。是否外傳資料,取決於開啟的功能、授權設定與實際送出的上下文。
by Rain Chu | 9 月 19, 2026 | AI, 程式開發
用 AI 做網站或小工具,最讓人緊張的時刻,往往是原本正常的功能突然壞掉,請它修一下,又改出更多問題,最後連哪個版本能用都說不清楚。
Vibe Coding 想要改得放心,先要有能確認的版本紀錄,Git 負責保存程式變更,GitHub 提供遠端儲存庫與協作流程。你不必先背熟指令,但要能回答改動存在哪裡、是否進入主分支,以及復原會影響哪些內容。
這篇 GitHub 入門指南以能讀寫專案檔案的 AI 開發工具為情境,若使用 Lovable 這類 AI App Builder,也要先確認平台的版本紀錄、GitHub 同步與部署各由誰管理,避免把不同系統的「已儲存」當成同一件事。
Git 和 GitHub 差在哪?先分清楚存檔與提交
Git 是版本控制工具,可以在自己的電腦上運作,GitHub 則是託管 Git 儲存庫的平台,讓程式可以放到遠端、比較修改內容,再透過 Pull Request 討論與合併,使用 Git 不一定要使用 GitHub,也可以搭配其他託管平台。
按下編輯器的儲存,只代表檔案寫入磁碟,commit 才是建立一筆 Git 提交紀錄,通常記錄的是放入暫存區的內容,也就是這次選定要提交的變更,尚未加入版本控制、被忽略,或還沒選入暫存區的修改,不會因為做了一次 commit 就全部被保存,細節可參考 Git 官方的變更記錄說明。
因此,第一次請 AI 接手專案,可以先讓它檢查是否已有 Git 紀錄、目前在哪個分支,以及有哪些未提交的檔案,接著在功能確認正常後建立一筆容易辨識的提交,例如「完成登入表單驗證」,再開始下一輪修改。
先檢查這個專案的 Git 狀態,列出目前分支、最新提交,以及已修改和未追蹤的檔案。說明這次應保存哪些內容,排除密碼與無關檔案,再建立一筆清楚描述功能狀態的提交。
Commit、push、PR、merge,是不同的完成狀態
commit 留在本機,不代表遠端已有相同內容,push 把提交送到指定的遠端分支,也不代表改動已進入主分支,PR 是提出合併變更的請求,merge 才會把變更整合到目標分支。
採用 PR 流程時,要檢查 PR 指向哪個目標分支、狀態是 Open、Closed 還是 Merged,Closed 只表示請求關閉,不能直接理解成已合併,部分專案允許直接推送主分支,因此 PR 是一種協作與審查流程,不是所有 Git 專案的必經步驟,可參考 GitHub 的 Pull Request 說明。
還有一個容易漏掉的狀況:PR 已合併後,又把新提交推到原來的功能分支,push 可能成功,但後來的提交不會自動補進那次已完成的合併,要另外確認是否需要新 PR,或依專案流程再次整合。
儲存庫更新與網站上線也要分開驗收,GitHub 上看得到程式,不代表正式網站正在執行那一版,部署平台可能使用另一個分支,也可能建置失敗。像 用 Claude Code 製作網站的完整工作流,最後仍要回到實際網址確認功能與畫面。
上傳前檢查機密,補上 .gitignore 不會抹掉歷史
API 金鑰、資料庫密碼、含憑證的設定檔,不應直接放進提交,請 AI 同時檢查檔案清單與即將提交的內容,並依專案需要設定 .gitignore。私有儲存庫也應避免存放這些機密。
.gitignore 主要處理尚未追蹤的檔案,已經被 Git 追蹤的檔案,不會因為新增忽略規則就自動停止追蹤,既有提交中的內容也仍然存在,這是 Git 官方文件 明確區分的行為。
如果金鑰已經外洩,第一步是到服務提供者那裡撤銷或更換金鑰,再處理儲存庫內容與歷史,只把目前檔案刪掉,不能讓舊金鑰失效。歷史清理還可能影響協作者,應依 GitHub 的機密資料處理指引 安排。
換電腦與同步協作,clone 和 pull 各做什麼?
從 GitHub 下載 ZIP,取得的是某個版本的檔案快照,要延續既有 Git 開發流程,通常會用 clone 取得儲存庫與版本歷史,讓本機能追蹤遠端。只拿到 ZIP,不能直接假設原來的 Git 設定和提交紀錄也都在。
已有本機儲存庫後,pull 會抓取遠端變更,再依設定整合到目前分支,例如使用 merge 或 rebase,它不只是把遠端檔案下載覆蓋過來,同步前先確認分支、遠端,以及本機尚未提交的內容是否妥善保存,操作語意可查 git pull 官方文件。
發生衝突時,讓 AI 說明兩邊原本要保留的行為,再決定如何整合,即使沒有出現文字衝突,也可能發生功能上的衝突。例如一邊調整登入流程,另一邊改了權限判斷,合併成功後仍要把兩個情境都測過。
兩個 AI 同時改專案,先分開實際工作目錄
同時開兩個 AI 視窗,不等於它們各有一份檔案。如果都在同一個工作目錄,一方存檔、切換分支或整理暫存內容,仍可能干擾另一方。只有不同任務名稱或分支名稱,也不足以證明工作檔案已隔離。
Git worktree 可以讓同一個儲存庫擁有多個工作目錄,分別檢出不同分支。
例如一份處理登入,一份調整版面,完成後再逐一審查與合併。它們有各自的工作檔案與部分狀態,但仍共享儲存庫資料及部分參照,不能把它當成完全獨立的安全沙箱。詳見 Git worktree 官方文件。
要確認的,是每個 AI 實際使用的 worktree 根目錄與分支,若測試會共用資料庫、輸出位置或服務連接埠,也要另外安排。想把這套分工放進操作介面,可以延伸閱讀 Orca ADE 的多 Agent 與 worktree 工作方式。
開始平行開發前,請列出每個任務的實際 worktree 根目錄、分支及修改範圍,確認彼此不會寫入同一份工作檔案,並檢查測試資料庫、輸出資料夾與連接埠是否共用。完成後逐一提交、驗證與合併。
AI 改壞了怎麼復原?先辨認改動在哪個階段
先暫停繼續修改,保留目前差異,再確認錯誤改動是否已提交、推送或合併。直接對 AI 說「全部還原」,容易連原本想保留的工作也一起丟掉。
restore 用來恢復指定檔案的內容,但來源要說清楚,未指定來源時,一般工作目錄還原預設取自暫存區,不一定是最後一次提交,使用 --staged 則是調整暫存區,預設來源為 HEAD,並不等於刪除工作檔案,會覆蓋工作目錄的還原操作可能丟失未提交修改,執行前要確認路徑、來源與備份。參考 git restore 官方文件。
revert 則是用新的提交,抵銷指定舊提交帶來的變更,它保留既有歷史,常用在已分享的提交,但可能遇到衝突,也不代表整個專案必然回到某個舊時間點,若要修正遠端主分支,新的復原提交仍需依流程推送、合併與部署。參考 git revert 官方文件。
檔案突然不見,也不能立刻認定永久刪除,可以先查是否切到別的分支、內容是否被放進 stash,或是否有提交紀錄與編輯器備份,不過,從未提交也沒有其他備份的內容,Git 並不保證能救回。
先不要執行會丟棄修改的操作,請查明問題改動是否已提交、推送與合併,保留目前差異,列出建議復原的檔案、來源版本及會失去的內容,再說明應使用檔案還原、復原提交或其他方法,並列出復原後的驗證項目。
Diff 要看什麼?先問比較的是哪兩個版本
看到大量新增或刪除行數,先確認比較範圍,GitHub PR 採用三點差異比較,從共同祖先到功能分支目前版本,重點是這個分支引入了什麼,直接比較兩個分支的最新狀態,得到的內容可能不同,尤其主分支已經往前更新時,參考 GitHub 的分支差異說明。
行數只是定位問題的線索,格式調整、自動產生的檔案或重新命名,都可能讓變動看起來很大。
更實際的檢查是:改動是否符合這次需求、是否碰到無關檔案,以及重要功能有沒有測過。
把「完成了嗎」改成一份可查證的交付回報
對非工程背景的人來說,最有用的習慣,是要求 AI 在每次交付時附上可以追查的狀態。下
面這段可以直接加入日常任務:
請用非工程師看得懂的方式回報這次交付,列出本機分支與最新提交、遠端分支是否已包含這次變更、PR 連結與合併狀態.若有多個 AI,列出各自的實際工作目錄。說明差異比較的基準、改了哪些檔案,以及哪些測試或操作情境已通過。若涉及網站上線,另附部署結果與實際驗證網址。沒有完成的步驟請明確標出。
從下一次小修改開始,先保存已確認正常的狀態,再讓 AI 動手。完成後看差異、驗證功能,最後確認遠端與部署狀態。這套習慣建立起來,才能在出錯時知道從哪裡查,而不必每次都靠重做。
GitHub 與 Vibe Coding 常見問題
不會寫程式,也需要學 Git 嗎?
使用 AI 修改專案時,至少應理解提交、分支、遠端與復原的差別,指令可以交給工具執行,但仍要能確認保存了什麼,以及哪些步驟尚未完成。
Commit 成功就代表已上傳 GitHub 嗎?
不代表。commit 建立本機提交,push 才會把提交送到指定遠端分支,是否合併到主分支,以及是否部署成功,都要另外確認。
PR 已合併後,再 push 就會更新主分支嗎?
不會自動更新。推到原功能分支的新提交,不會追加到先前已完成的合併,應依專案流程建立新 PR 或再次整合,確認新變更已進入目標分支。
Restore 和 revert 有什麼不同?
restore 恢復指定位置的檔案內容,必須確認來源與是否覆蓋未提交修改。revert 以新提交抵銷舊提交的變更,保留歷史,但可能需要處理衝突。
Worktree 可以完全避免兩個 AI 互相干擾嗎?
不能保證。不同 worktree 可分開工作檔案,但仍共享部分 Git 資料,外部資料庫、服務與輸出位置也可能共用,應確認目錄、分支與執行環境的分工。
by Rain Chu | 9 月 18, 2026 | AI, 模型
模型蒸餾,是用教師模型提供的學習訊號訓練學生模型,讓學生在指定任務上學會更好的判斷與回應。常見目標是把能力轉移到較容易部署的小模型,降低使用時的資源需求。它需要新的訓練過程,效果取決於教師、學生本身的能力,以及準備了什麼資料。
理解這件事,最有用的起點是分清楚兩種做法:讓學生學教師的機率分布,以及讓學生學教師產生的完整答案。這也能解釋為什麼同樣叫蒸餾,有的需要取得模型內部輸出,有的只靠生成文字就能進行。
模型蒸餾是什麼?教師提供訊號,學生更新參數
Hinton、Vinyals 與 Dean 的知識蒸餾論文提出用大型模型或模型集成的預測分布,訓練另一個容易部署的模型。學生學習的是教師在不同輸入下的行為,不必照抄教師的架構,也不是把教師權重直接截取一部分。
一般離線蒸餾會先準備好教師,再固定教師的參數,由學生反覆預測、計算差距、更新自己的參數。完成訓練後,學生可以獨立推論。若產品另外設計了雲端備援,那是部署流程的選擇,並非蒸餾必然要求。
軟標籤:除了正確答案,還學選項之間的關係
以辨識貓、狗與汽車為例,人工標籤可能只寫「貓」。教師除了選出貓,還會對其他類別給出機率。狗的可能性高於汽車,透露出這張照片在模型眼中更接近哪類事物。這種帶有相對關係的訊號,就是軟標籤的價值。這裡是概念示例,並非實測數據。
經典做法會調整 softmax 的溫度,讓機率分布更平滑,使原本很小的機率差異更容易參與學習。溫度過高也會讓分布過於平均,因此仍需驗證。它不是「溫度越高,學生就越聰明」的設定。
PyTorch 官方教學示範把兩種訓練目標加權:一種要求學生接近教師分布,另一種要求學生符合真實標籤。分布差距可透過 KL divergence 等目標衡量。訓練時仍應保留正確答案的約束,教師的自信不等於答案一定正確。
實作時,直接比對逐 Token 分布通常還需要處理詞彙表、Tokenizer 與序列位置的對齊。光是教師和學生都能生成中文,並不足以保證它們的機率陣列可以直接相減。
回答蒸餾:把教師輸出變成學生的訓練資料
另一條路徑是先讓教師回答問題,整理成「輸入與目標回答」的資料集,再用監督式微調訓練學生。學生逐步學習如何產生這些答案,不需要拿到教師的全部權重。若服務只提供文字輸出,也可能採用這種方式,前提是取得與使用資料的條件允許。
Sequence-Level Knowledge Distillation在機器翻譯研究中,探討把整段生成序列作為蒸餾訊號。放到語言模型的應用裡,資料可以包含回答格式、分類結果、解題步驟與工具使用範例,但具體要教什麼,仍由資料與訓練目標決定。
例如,希望學生整理客服工單,就應準備真實會遇到的問法,要求教師產生正確分類、摘要與缺漏欄位,再經規則或人工檢查。只收集漂亮、流暢的回答,未必能教會學生處理錯字、矛盾敘述與資訊不足。這是本文用來說明資料設計的應用示例。
DeepSeek-R1 的蒸餾模型,為什麼會叫 Qwen 或 Llama?
DeepSeek-R1 官方模型卡說明,Distill 系列以 Qwen 與 Llama 的既有模型為基礎,使用 DeepSeek-R1 生成的樣本進行微調。名稱同時反映了提供訓練訊號的來源,以及學生採用的基礎模型。
因此,DeepSeek-R1-Distill-Qwen 不是把完整 R1 的參數切小,也不能直接當成 R1 的量化版。挑選時應確認學生模型、適用任務、Tokenizer 設定與部署需求。官方基準測試能提供參考,但不能推論小模型在所有領域都等同教師。
蒸餾、微調、量化與剪枝,各自在改什麼?
微調著重於用資料更新既有模型。蒸餾著重於知識訊號來自教師,兩者可以同時成立。用教師生成的答案微調學生,就是常見的交集。LoRA則是透過低秩更新降低需要訓練的參數量,是微調方法之一,本身不代表模型已完成蒸餾,也不等於把基礎模型縮成更少參數。
量化著重於數值表示的精度。Hugging Face 量化文件說明,較低精度的權重表示能降低記憶體需求,並盡量保留準確度。參數量可以不變,但每個權重佔用的空間減少。量化後是否更快,還要看硬體、運算支援與實際負載。
剪枝著重於移除或遮蔽部分權重與結構。PyTorch 剪枝教學展示了不同剪枝方式。權重變成零,不保證一般推論程式就會自動跳過運算。要換成實際加速,仍需相應的結構或稀疏運算支援。
這些方法可以組合,例如先訓練出合用的學生,再評估量化部署。想把概念接到本機環境,可延伸閱讀Qwen 本地部署與 GGUF 設定,但不同模型與硬體的需求要分別核對。
API 已經夠方便,什麼情況還值得蒸餾?
判斷方式是先看工作量與限制。若需求經常改變、使用量不大,直接使用現成模型可能更省事。若每天反覆處理相近任務,而且對回應時間、併發量、離線使用有明確要求,才值得把學生模型列入比較。這是部署規劃上的判斷,並非固定的成本結論。
比較時要把整段使用週期算進去,包括教師生成資料、資料審查、訓練、評估、硬體、維運,以及學生失敗後的重試或轉接。單次推論便宜,不能代表整個專案一定便宜。反過來,網路速度很好,也不會消除資料處理範圍與服務可用性的需求。
開始訓練前,先測未蒸餾的小模型是否已經夠用。如果簡單提示詞或現成模型就能完成工作,便沒有必要為了使用蒸餾而建立訓練管線。需要測試不同本地與雲端模型時,可參考LibreChat 與 Ollama 的整合方式,用同一批任務比較實際結果。
本地蒸餾模型的隱私,要沿著資料流檢查
學生在本機推論,確實可以減少把使用者輸入送往外部服務的需要。不過,隱私取決於整個系統如何傳遞與保存資料,不能只看模型檔案放在哪裡。
先看訓練前的資料準備。如果把內部文件送給雲端教師生成範例,資料在這一步就已經離開本機。再看實際使用時,是否另有雲端搜尋、遠端 Embedding、外部工具、遙測或日誌服務。最後看備援路徑,學生答不好時若自動轉給雲端大模型,轉交的問題、文件與歷史對話仍可能外傳。
有資料不外傳的要求時,應設計為本地處理、明確拒答或交由內部人員處理。允許混合部署時,則應先定義可外傳的資料範圍,並告知使用者何時轉交。把「本地模型」當作隱私保證,容易漏掉真正的資料出口。
實作蒸餾,先定義任務,再決定要不要訓練
以下是依前述方法整理的實務流程,適合用來規劃第一個小型試驗,不代表所有專案都需要同一套訓練參數。
先建立基準與驗收題目
選一個邊界清楚的任務,例如工單分類或固定欄位擷取。先測現成學生模型和教師各自的表現,定義正確率、格式完整性、回應時間與可接受的失敗方式。測試題目應與訓練資料分開,也要包含少見與資訊不足的情況。
生成範例後,先檢查品質
教師輸出需要去重、檢查事實、移除敏感內容,並確認符合任務規格。對答案可直接驗證的題目,優先使用程式規則或單元檢查。若蒸餾的是解題步驟,也不能只檢查最後答案正確,就認定中間推導全部可靠。
選擇訓練訊號,保留比較組
只有教師文字輸出時,可從回答資料微調開始。能取得分布且處理好對齊時,再評估軟標籤蒸餾。進一步的GKD 方法會讓學生在自己生成的序列上取得教師回饋,處理訓練資料與學生實際生成行為之間的差異。方法更複雜,並不代表每個任務都需要採用。
驗證泛化能力,再測實際部署
The False Promise of Imitating Proprietary LLMs在其研究設定下發現,模仿模型可以學到很像教師的回答風格,卻未必同步取得相同的事實能力。這項結果提醒我們,應檢查資料覆蓋之外的任務,不能只以流暢程度驗收,也不宜把該研究解讀成所有蒸餾都無效。
完成離線評估後,還要用目標硬體測記憶體、延遲與同時請求的表現。如果任務需要查詢經常更新的內部資料,可考慮讓模型搭配檢索,而非每次更新文件都重新蒸餾。站內的CrewAI 與 RAG 概念整理可作為理解工具與檢索分工的延伸閱讀。
模型蒸餾常見問題
模型蒸餾就是把大模型壓縮成小檔案嗎?
蒸餾是用教師訊號訓練學生,模型檔案大小取決於學生架構與數值精度。若只改變權重精度以縮小檔案,通常是在做量化。
只有教師模型的 API,也能做蒸餾嗎?
若 API 提供的輸出及使用條件允許,可以收集教師回答來微調學生。這與取得完整機率分布後進行的軟標籤蒸餾不同。
蒸餾後的小模型一定和大模型一樣強嗎?
不一定。效果受學生原本能力、資料覆蓋與任務影響,必須使用獨立題目評估,不能只看回答是否流暢。
Token 成本低,還需要自己蒸餾嗎?
未必。先比較現成模型是否夠用,再看使用量、延遲與離線需求。成本需要包含資料準備、訓練和維運,不能只看單次推論。
把小模型用在能驗收的任務上
蒸餾最值得關注的成果,是學生能否在你的任務上穩定達到要求,同時讓部署更容易。先建立現成模型的基準,找出缺口,再決定要準備什麼教師資料。當品質、速度與整體成本都有實際驗證,才能判斷這次訓練是否值得。
近期留言