by Rain Chu 7 月 11, 2026 | OCR , 圖型處理
InternVL3 值得注意的地方,不只是又一個開源多模態模型,而是它把本地 VLM 的使用場景推得更實際,OCR、掃描文件、模糊表格、手寫字、截圖理解,這些都不是聊天模型的展示題,而是每天真的會卡住工作的資料入口。
如果之前已經在玩 本地多模態分析 ,InternVL3 可以看成下一個很適合放進實驗清單的模型。它不只是看圖說話,而是更接近能處理文件、表格與複雜畫面的視覺語言模型。
InternVL3 的重點是文件理解,而不是炫技
AIVI 的整理把 InternVL3 放在企業級 OCR 和多模態理解的脈絡裡看。這個定位很合理。現在很多人把 VLM 拿來做圖片描述,但真正有價值的地方,往往是把原本不適合丟給文字模型的資料變成可處理的結構。
例如模糊 PDF 掃描件、手寫備註、拍歪的表格、截圖裡的 UI 狀態,這些資料以前要靠人工整理,或用傳統 OCR 加一堆後處理。InternVL3 這類模型讓流程變成另一種樣子。先讓 VLM 看懂畫面,再把結果交給下游的 RAG、資料庫、工作流或 Agent。
這也能和 MarkItDown 這類文件轉換工具 互補。文字型文件可以先轉 Markdown,掃描影像、複雜表格和視覺內容則交給 VLM 補上理解能力。
InternVL3 有哪些技術方向值得看
AIVI 筆記提到三個重點。第一個是原生多模態預訓練。它不是先訓練純文字模型,再把視覺模組接上去,而是在同一個訓練階段同時學文字和多模態資料。這個方向的好處,是減少後期對齊的落差,讓模型在文字能力與視覺理解之間更一致。
第二個是可變視覺位置編碼。這類設計的核心,是讓視覺 token 的位置表示更彈性,支援更長的多模態上下文。對文件理解很重要,因為真實文件常常不是單張乾淨圖片,而是多頁、表格、註記、圖文混排。
第三個是偏好優化與測試時擴展。簡單說,就是讓模型不只會回答,也能在推理過程中更穩定地挑出比較好的答案。這對 OCR 類任務尤其重要,因為一個字看錯、欄位對錯、單位錯置,都可能讓後面的分析整個歪掉。
為什麼要用 lmdeploy
InternVL3 本身是模型,真正要落到日常使用,還需要部署層,這就是 InternLM 的 lmdeploy 進場的地方。它的定位是壓縮、部署和服務化 LLM 與 VLM,官方 README 強調高效推理、量化、多機多卡服務和相容性。
用比較白話的方式說,lmdeploy 是把模型從「可以下載」變成「可以被應用呼叫」。當它用 OpenAI 相容 API 跑起來後,Open WebUI、自寫腳本、內部工具或 Agent 流程都可以用同一套 API 方式接進來。
這一點對本地部署很重要,單次 demo 可以直接跑 notebook,但長期使用要考慮服務常駐、併發、顯存、量化、監控和前端介面。這也是為什麼本地 AI 不該只停在安裝成功,而要慢慢走向像 OpenMontage 本地部署 那樣,把模型、服務和工作流串起來。
建議部署流程
AIVI 的流程可以整理成四段。第一段是準備 Linux 或 WSL 環境,第二段是建立 conda 環境,第三段是安裝 lmdeploy 與必要套件,第四段是啟動 API server 並接到 Open WebUI。
conda create -n lmdeploy python=3.11 -y
conda activate lmdeploy
pip install lmdeploy partial_json_parser timm
模型服務可以先用 14B 版本做測試。AIVI 範例使用 TurboMind backend,port 設在 23333,並指定 InternVL 相關 chat template。
lmdeploy serve api_server OpenGVLab/InternVL3-14B-Instruct --backend turbomind --server-port 23333 --tp 2 --chat-template internvl2_5 啟動後,OpenAI 相容呼叫大致長這樣。重點不是 API key 本身,而是 base_url 指向本機服務。
from openai import OpenAI

client = OpenAI(
    api_key="local-key",
    base_url="http://127.0.0.1:23333/v1"
)

model_name = client.models.list().data[0].id
如果要給一般使用者操作,可以再裝 Open WebUI。
pip install open-webui
open-webui serve
Open WebUI 的價值不是漂亮而已,而是讓 VLM 從工程實驗變成日常工具。你可以把它當成公司內部的視覺文件入口,讓同事不用碰 Python,也能上傳圖片、掃描件或表格截圖測試效果,這個方向也和 AI Agent 進入可視化操作介面 的趨勢一致。
部署前要先想清楚硬體與模型大小
InternVL3 有不同參數規模。不要一開始就衝最大模型,除非你已經有足夠顯存和多卡環境,比較務實的做法,是先用 14B 或更小版本建立流程,確認 API、Open WebUI、圖片上傳、OCR 品質和下游應用都通,再決定是否升級。
lmdeploy 官方支援量化與多種推理引擎,這表示部署時可以在速度、顯存、品質之間取平衡。若是個人工作站,應該先關心能不能穩定跑起來。若是團隊服務,才進一步考慮併發、多卡與監控。
如果已經在比較本地模型格式與顯卡路線,可以順手參考 Ollama 與 Qwen 量化選擇 這類文章。雖然工具不同,但同樣是在處理顯存、速度和品質的取捨。
適合拿來做什麼
把掃描 PDF 或圖片文件轉成可分析的文字與表格。
判讀手寫註記、發票、表單、截圖與複雜版面。
為內部知識庫補上圖片與文件理解能力。
替 GUI Agent 提供畫面理解與狀態判斷。
建立不依賴雲端 API 的企業內部 VLM 服務。
我會特別看好文件處理和內部工具場景。因為這些工作通常資料敏感,而且每家公司文件格式不同,雲端通用 OCR 未必能直接解決。能本地跑,代表可以把資料留在自己的機器或內網裡,再慢慢針對真實樣本調整流程。
我的結論
InternVL3 加 lmdeploy 的組合,真正值得看的不是安裝命令,而是它讓本地 VLM 服務變得更像一個可長期使用的基礎設施。模型負責看懂圖片與文件,lmdeploy 負責把模型服務化,Open WebUI 或其他前端負責降低使用門檻。
如果你的工作裡有大量掃描件、圖片表格、手寫內容、UI 截圖或需要保密的文件,這條路線很值得測。它不一定會取代所有 OCR 工具,但會讓 OCR 從單純辨識文字,升級成理解畫面裡的結構與意圖。
延伸資源
FAQ
InternVL3 適合做什麼?
InternVL3 適合處理 OCR、掃描件、手寫字、表格截圖、圖文混排文件和 GUI 畫面理解。它的價值不只是描述圖片,而是把視覺資料轉成可被後續流程使用的資訊。
lmdeploy 在這裡扮演什麼角色?
lmdeploy 是部署與服務化工具。它可以把 InternVL3 這類模型包成 API server,讓 Open WebUI、Python 腳本或內部工具用 OpenAI 相容方式呼叫。
一定要用最大版本的 InternVL3 嗎?
建議先用較小版本把流程跑通,確認 OCR 品質、顯存占用、API 和前端整合都穩定,再依需求升級到更大的模型。
by Rain Chu 7 月 11, 2026 | AI , 圖型處理 , 影片製作
RunningHub 最值得看的地方,不是它又做了一個線上 AI 繪圖平台,而是它把 ComfyUI 工作流、AI 應用、模型 API、工作流 API 和內容模板包成一個可營運的創作平台。對內容團隊來說,這比較像是把原本散在本機、模型網站、工作流社群和 API 文件裡的能力,整理成同一個生產入口。
如果你之前已經在玩 本機 ComfyUI 與開源繪圖模型 ,RunningHub 可以看成另一條路。它不是要求每個人都先理解節點、環境、顯卡和模型路徑,而是把工作流託管在雲端,讓創作、分享、調用和商業化更接近一般工具的使用方式。
RunningHub 是什麼
RunningHub 官方把自己定位成原生 AI 智能體驅動的全能內容創作平台,支援 ComfyUI 工作流、無限畫布、AI 應用和模型 API 調用。這句話拆開看,其實代表三層產品。
第一層是創作入口,包含快捷創作、無限畫布、rhTV、RHSTORY、VibeX 和各種模板。
第二層是工作流市場,讓創作者基於 ComfyUI 做出可複用的流程,並提供給其他人直接使用。
第三層是 API 與開發者工具,把模型、AI 應用和工作流變成可以被產品或內部系統調用的服務。
這三層合在一起,RunningHub 的野心就比較清楚了,它不是只想做一個 ComfyUI 雲端版,而是想做 AI 內容生產的基礎平台。創作者可以在上面做模板,團隊可以用模板產出素材,開發者可以透過 API 把同一套能力接到自己的產品裡。
和本機 ComfyUI 最大差別
本機 ComfyUI 的好處是自由度高,模型和節點都能自己控制,缺點也很明顯,安裝、模型管理、節點衝突、顯卡限制和工作流維護都會吃掉大量時間。RunningHub 則把這些麻煩轉成雲端服務與平台規則。
面向 本機 ComfyUI RunningHub 環境管理 自己安裝 Python、節點、模型和驅動 平台託管工作流與模型能力 硬體成本 需要自己的 GPU 或雲端機器 按平台資源與調用方式使用 分享方式 通常分享 JSON、模型清單與安裝說明 可直接變成模板、AI 應用或 API 適合對象 技術玩家、研究者、重度創作者 內容團隊、電商、短劇、行銷、開發者 商業化路徑 需要自己包服務或教學 平台內有模板、應用與創作者激勵
這和 Liblib 這類中國 AI 創作平台 很像,都是把模型能力、創作者生態與素材生產流程放進平台。差別在於 RunningHub 特別強調 ComfyUI 工作流、AI 應用和 API 的連動,對想把流程產品化的人更有吸引力。
工作流才是核心資產
RunningHub 的 ComfyUI 頁面不是只展示模型,而是展示大量工作流。像商品圖、角色設計、短劇分鏡、動作模仿、去水印、高清修復、影片超分、圖生影片等,都不是單一模型能解決的問題,而是由多個節點和步驟組成的流程。
這一點很重要。AI 內容創作正在從 prompt 時代走向 workflow 時代。單次生成可以靠運氣,多次穩定產出就需要流程。誰能把流程沉澱成模板、應用和 API,誰就更接近可複製的生產力。
這也能和 OpenMontage 本地影片工作流 放在一起看。一邊是本地自架、可控性更高,另一邊是平台化、上手更快。真正要選哪一邊,不是看哪個比較酷,而是看團隊需要的是控制權,還是交付速度。
API 讓 RunningHub 不只是一個網站
RunningHub 的 API 頁面有一個關鍵說法,單一接口可以直連 400 多個主流大模型。它也把能力拆成模型 API、AI 應用 API 和工作流 API。這代表開發者不一定要讓使用者進 RunningHub 網站操作,也可以把平台能力接進自己的產品。
官方列出的生產環境重點包括全模態聚合、工作流託管、彈性按需計費與企業級安全。這幾個詞不是行銷話術而已。對公司來說,真正麻煩的往往不是模型能不能跑,而是能不能穩定調用、能不能控權限、能不能算成本、能不能把工作流變成內部服務。
RunningHub 也提供 RH_CLI、RH_Skills、ComfyUI 插件與 AI Developer Kit。這些工具的意義是降低接入門檻。創作者可以從平台模板開始,工程團隊則可以把流程變成自動化服務。這和 AI 代理走向工作平台 是同一個方向,重點不只是模型,而是把模型放進可用的工作系統。
哪些人最適合用 RunningHub
我會把 RunningHub 的使用者分成四類。
電商與品牌團隊,需要大量商品圖、短影片、模特圖、場景圖和廣告素材。
短劇與內容團隊,需要分鏡、角色、場景、動作模仿和影像增強。
ComfyUI 創作者,想把自己的工作流變成模板、應用或可被調用的服務。
開發者與企業團隊,想用 API 把模型和工作流接進既有系統。
如果只是偶爾玩圖,本機工具或單一模型網站就夠了。如果是每天要產內容、測素材、上架商品、做短劇或替客戶交付,RunningHub 這種平台化工具才會開始有價值。因為它解決的不是單張圖,而是內容生產流程。
我會怎麼開始測
第一步不要先研究所有功能,而是挑一個真實任務。例如電商商品圖、短劇分鏡、社群廣告短片或角色一致性測試。用官方模板跑出第一版,記錄效果、成本和可修改程度。
第二步才是比較工作流。看同一個任務能不能換模型、改節點、調提示詞、保留角色一致性,或直接變成 AI 應用。這一步能判斷 RunningHub 是臨時工具,還是能進入你的固定流程。
第三步看 API。如果你要把內容生產接到網站、內部後台、自動化任務或客戶服務流程,工作流 API 才是長期價值。這時候就要評估調用成本、回傳格式、權限控管和失敗重試。
我的結論
RunningHub 的定位很清楚,它想把 ComfyUI 從高手工具變成內容生產平台,這件事不只是降低門檻,也是在改變 AI 創作的價值重心。過去大家比的是誰會寫 prompt,現在會慢慢變成誰能設計穩定工作流,誰能把工作流包成應用,誰能把應用接成 API。
如果你只想偶爾生成圖片,RunningHub 可能會顯得太大。如果你在做短劇、電商、廣告素材、品牌內容或 AI 工具產品,它就很值得看。因為它賣的不是單次生成,而是從創作、模板、工作流到 API 的整套生產鏈。
延伸資源
FAQ
RunningHub 是什麼?
RunningHub 是一個 AI 內容創作平台,整合 ComfyUI 工作流、AI 應用、無限畫布、模型 API 和工作流 API,適合把圖像、影片和內容流程平台化。
RunningHub 和本機 ComfyUI 有什麼差別?
本機 ComfyUI 自由度高,但需要自己管理環境、模型和顯卡。RunningHub 把工作流和模型能力雲端化,適合需要快速創作、分享模板、建立 AI 應用或調用 API 的團隊。
RunningHub 適合哪些場景?
它適合電商商品圖、短劇分鏡、品牌素材、影片生成、角色一致性、高清修復,以及把 ComfyUI 工作流變成可重複調用的內部工具或 API 服務。
by Rain Chu 7 月 11, 2026 | AI
AI 設計工具正在從「幫你生一張圖」走向「幫你拆一整套設計任務」,堆友這類 AI 設計 Agent 最值得注意的地方,不是單次出圖速度,而是把品牌全案、IP 延展、海報、Logo、字體、修圖與素材整理,包裝成可以一鍵調用的設計 skills。對設計師、行銷人與內容團隊來說,這代表 AI 不只是靈感工具,而是可以進入日常製作流程的設計協作台。
圖:AI 設計 Agent 將品牌、IP、海報、Logo 與字體任務串成工作流 堆友的核心:用 Skills 組出 AI 設計部
堆友的操作邏輯很接近「設計專家集合」。使用者不是只輸入一句提示詞等結果,而是先選擇適合的 skill,例如品牌全案設計專家、IP 設計專家、海報設計專家、Logo 設計或字體設計,再把品牌類型、視覺風格、需要的素材項目與輸出格式寫清楚。
這種設計方式很適合現在的 AI 工作流:先把任務交給特定能力的 Agent,再透過對話、局部修改、圖層編輯與文字編輯逐步收斂,若你熟悉我之前整理的 find-skills 安裝與使用教學 ,就會很容易理解這個方向:skill 不是花俏名詞,而是把一套專業流程封裝成可重複調用的能力。
玩法一:品牌全案不只生 Logo,而是一次產出視覺系統
品牌全案是最能看出 AI 設計 Agent 價值的場景。好的提示詞不能只寫「幫我做一個潮流品牌」,而要交代品牌類型、目標受眾、風格方向、視覺情緒,以及需要哪些素材。比較完整的輸出可以包含 Logo、主視覺、產品周邊、包裝、店鋪氛圍、社群海報與物料延展。
這對早期品牌、活動企劃或內容創作者特別有用,因為很多時候真正耗時的不是單張主視覺,而是「能不能快速湊出一組看起來一致的品牌材料」。如果你的需求偏向 WordPress 商品圖或內容配圖,也可以參考 如何用 baoyu-skills 在 WordPress 批次產生高質感產品圖 ,概念很接近:把零散的圖片需求整理成可批次執行的生產流程。
玩法二:IP 延展適合做角色設定、穿搭與周邊
IP 延展是另一個很適合 AI 的任務。傳統上,一個角色要延伸出正側背三視圖、表情、動作、穿搭、周邊商品與應用場景,需要大量手工拆解,堆友這類工具的優勢,是可以把「角色設計」直接推進到「角色應用系統」。
比較實用的做法,是在提示詞裡明確列出要生成的內容:角色三視圖、六套穿搭、常用表情、動作姿勢、帆布袋、鑰匙圈、貼紙、社群頭像、海報版面。若希望方便檢查,也可以要求系統把成品排在同一張長圖裡,這會比一張一張散著看更容易判斷風格是否一致。
玩法三:海報設計從素材整理開始
海報設計不是只靠一句標語。實務上通常需要先準備文字、主圖、產品圖、活動資訊、品牌色、尺寸比例與風格方向,堆友的海報設計 skill 可以吃文字、圖片與多媒體素材,再產出不同風格的版面方向,讓使用者從候選稿裡挑選最接近需求的一張繼續修。
這裡最有用的是後續編輯能力。生成結果可以再進畫布,透過「編輯元素」拆分圖層,或用「編輯文字」調整海報文案。這讓 AI 海報不只是一次性產物,而是更接近可改稿的設計檔。想看更多海報與行銷視覺的 AI 應用,可以延伸讀 Gemini Nano Banana Pro 超強 15 大應用整理 和 Nano Banana Pro 海報與邀請卡實戰技巧 。
玩法四:Logo 與字體更適合拿來探索方向
Logo 和字體生成很吸引人,但也最需要冷靜看待。AI 可以快速產生大量方向,例如毛絨玩偶風、復古潮玩風、霓虹招牌風、英文 Logo、立體字體等;也可以進一步做去背、輸出 PNG、批量摳圖。這對提案前期很好用,因為它能迅速讓抽象風格變成可討論的視覺草案。
但如果要正式商用,Logo 仍然需要設計師做最後整理,包括字距、識別性、縮放可讀性、黑白版、反白版、註冊風險與商標檢索。AI 生成可以縮短發想時間,但不能取代品牌識別的最後把關。
一個好用的提示詞框架
使用這類 AI 設計 Agent 時,提示詞可以用下面這個結構:
品牌背景:品牌名稱、品類、受眾、價格帶、情緒定位。
風格方向:復古、潮玩、極簡、科技、可愛、精品、街頭等。
輸出清單:Logo、主視覺、角色、包裝、海報、周邊、社群圖。
版面格式:9:16、1:1、橫版海報、同一張長圖整理、透明背景。
修改規則:哪些地方不能變、哪些地方可以重設、要保留什麼元素。
重點是不要只讓 AI 猜。你提供的設計約束越清楚,Agent 產出的素材就越接近可用稿;後續再用局部修改、圖層拆分、文字編輯、去背與高清化去收斂細節。
堆友適合誰?
角色 適合用途 要注意的事 設計師 快速發想方向、整理 moodboard、做提案初稿 最後仍要人工修版與統一規範 行銷人 活動海報、社群圖、產品視覺、品牌提案 要先準備清楚文案與活動資訊 創作者 IP 角色、周邊、頻道視覺、內容封面 角色一致性需要反覆迭代 小品牌 低成本探索品牌視覺與商品包裝方向 正式商用前要檢查版權與商標風險
導入前要先想清楚的限制
第一,AI 產出的 IP 形象不等於天然可商用。角色是否撞型、Logo 是否有商標風險、素材授權是否符合平台規範,都要另外確認。第二,會員或付費方案通常會影響可用模型、生成次數、高清輸出、去背與進階編輯能力,團隊導入前最好先估算每月使用量。
第三,AI 很會產生「看起來像一套」的素材,但品牌一致性仍然需要規範。比較成熟的做法,是先用 Agent 做 3 到 5 組方向,再由設計師定稿品牌色、字體、Logo 規格與使用禁例。若你的下一步是把設計延伸到網站或前端 UI,可以搭配 Google Stitch 教學 ,把視覺概念往 UI 生成方向推進。
AI 設計 Agent 的價值在於把零散任務變成流程
堆友這類 AI 設計 Agent 的真正亮點,是把「品牌、IP、海報、Logo、字體、修圖」這些原本分散的任務,整合成一個可反覆調用的設計流程。它不會讓每個人一夜之間變成資深設計師,但能讓非設計團隊更快做出可討論的視覺方向,也能讓設計師把更多時間留給判斷、修正與品牌策略。
如果要追蹤阿里系產品與設計生態,可以從 阿里巴巴集團官網 了解相關背景;工具本身的使用入口與功能可用性,仍以實際帳號頁面顯示為準。
推友AI
FAQ
堆友可以直接做完整品牌全案嗎?
可以用來快速產出品牌全案的初步方向,例如 Logo、主視覺、包裝、海報與周邊素材。但正式交付前,仍建議由設計師整理品牌規範、檢查可讀性與商用風險。
AI 生成的 IP 形象可以商用嗎?
要看平台授權、素材來源與生成結果是否涉及相似角色或商標風險。AI 可以協助快速探索角色方向,但商用前應做授權、商標與相似性檢查。
堆友適合完全沒有設計經驗的人嗎?
適合拿來做初稿、提案方向與素材延展,但提示詞仍要寫清楚品牌背景、風格、輸出項目與限制。越能說清楚需求,結果越容易接近可用稿。
by Rain Chu 7 月 11, 2026 | Tool
企業知識庫和 AI Agent 最麻煩的地方,常常不是模型不夠聰明,而是資料進不來。PDF、掃描合約、研究報告、表格、圖片型文件,看起來都只是文件,但對 RAG 或 Agent 來說,它們必須先被轉成穩定、乾淨、可引用的結構化內容。
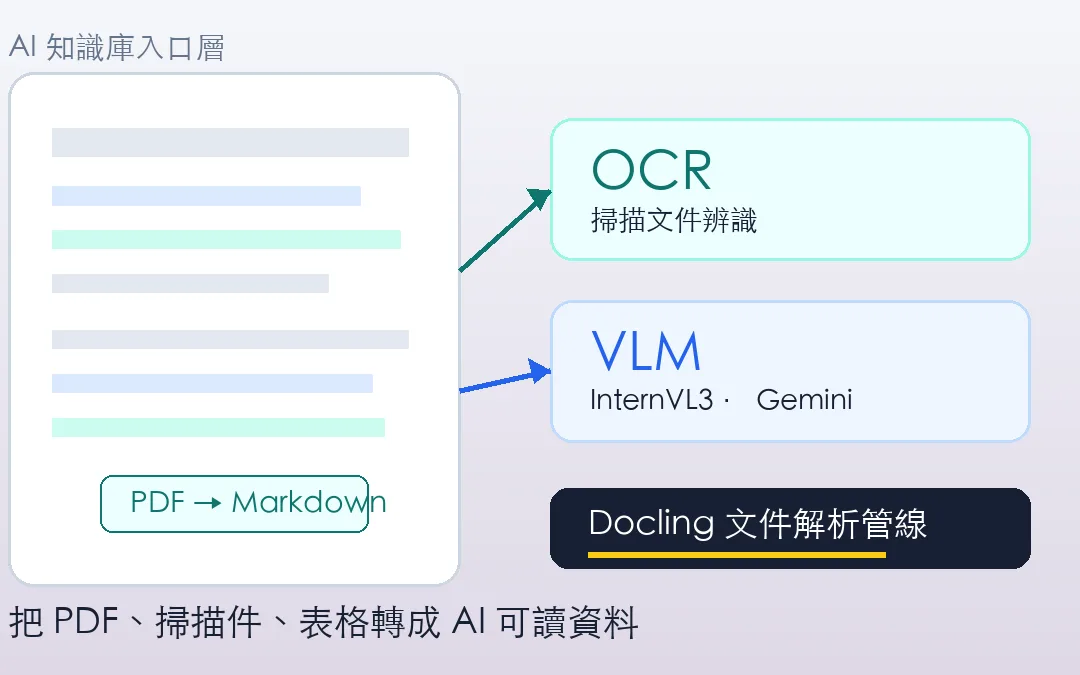
Docling 就是在解這個入口問題。它不是只把 PDF 拆成純文字,而是把文件版面、閱讀順序、表格、公式、圖片、OCR 結果整理成 AI 更容易消化的格式,例如 Markdown、HTML、JSON。對要做企業知識庫的人來說,這一層通常比後面換哪一個聊天模型更關鍵。
Docling 適合解決什麼問題
Docling 是 IBM Research Zurich 發起的開源專案,採用 MIT License。它支援 PDF、DOCX、PPTX、XLSX、HTML、EPUB、圖片與音訊等格式,官方也強調它能和 LangChain、LlamaIndex、CrewAI、Haystack 這類生成式 AI 工具鏈整合。
如果只是把少量文件轉成 Markdown,微軟的 MarkItDown 會很輕巧,之前我也整理過 MarkItDown 教學 ,但 Docling 的定位更偏向文件理解管線,尤其是 PDF 版面、表格、掃描文件、VLM 輔助解析這些較複雜的場景。
最基本的使用方式
Docling 的入門方式很直接,Python 環境建好後先安裝依賴:
pip install litellm google-generativeai docling 最小 Python 範例可以用 DocumentConverter 讀取 PDF,再輸出 Markdown:
from docling.document_converter import DocumentConverter

source = "https://arxiv.org/pdf/2408.09869"
converter = DocumentConverter()
result = converter.convert(source)

markdown_text = result.document.export_to_markdown()
print(markdown_text)
也可以用命令列直接轉檔:
docling https://arxiv.org/pdf/2408.09869 這種方式很適合處理數位原生 PDF,例如論文、報告、產品文件。它能保留標題層級、段落、表格與部分版面資訊,後續要切 chunk、做向量化、放進 RAG 都比較順。
掃描 PDF 要接 VLM 才會真正好用
企業場景裡最痛的通常是掃描件。掃描合約、舊報紙、模糊文件、影印後再掃描的 PDF,傳統 OCR 很容易漏字、錯行、表格亂掉,Docling 的強項之一,是可以把解析流程接到視覺語言模型,讓 VLM 協助理解頁面。
本地部署路線可以用 LM Studio 載入 InternVL3-9B,讓 Docling 透過 OpenAI 相容 API 呼叫本機模型,這個做法的優點是資料不必送到外部雲端,適合公司內部文件、客戶資料、合約與敏感文件。缺點是需要顯卡資源,也要接受本地模型在模糊文字上的上限。
如果追求辨識品質,Gemini 2.5 Pro 這類雲端 VLM 的效果通常會更穩,尤其是模糊掃描、複雜版面、引用格式、符號與表情符號。代價就是 API 成本、資料外送與權限控管,真正落地時,我會把它分成兩條管線:一般文件走本地模型,低信心或高價值文件再送雲端模型複核。
一個實用的企業知識庫流程
先把 PDF、Word、Excel、HTML、圖片掃描件集中到同一個資料夾或物件儲存。
用 Docling 轉成 Markdown 或 JSON,保留頁碼、標題、表格與圖片資訊。
針對掃描件啟用 OCR 或 VLM 管線,低品質文件可以標記信心分數。
清理內容,移除頁首頁尾、重複頁碼、錯誤斷行,再依標題與段落切 chunk。
把 chunk 放入向量資料庫,同時保存原始頁面來源,方便回答時回溯引用。
接到 RAG、Agent 或 Notebook 型工具,讓使用者可以查詢、摘要、比對文件。
之前整理過 GraphRAG 使用本地端的 Ollama ,或是 Open Notebook 這類私有研究工作流,前面都需要穩定的文件解析層。Docling 可以放在最前端,負責把混亂文件變成 AI 能讀的乾淨材料。
LM Studio、InternVL3、Gemini 怎麼選
如果資料敏感,先選 LM Studio 加 InternVL3。這種配置比較像私有 OCR 與文件理解服務,可以在內網跑,也能和既有 Python 管線整合。若你已經在評估 Qwen 或其他本地模型,也可以參考 Ollama Qwen 3.6 怎麼選 和 本地端多模態分析實戰 的思路。
如果文件很雜、品質很差、需要快速拿到高準確度結果,Gemini 2.5 Pro 會比較省心。尤其是頁面裡有表格、引用、符號、圖片文字混在一起時,雲端 VLM 的容錯能力會更好。我的建議不是二選一,而是分層使用:本地模型做第一輪,難件再升級到雲端模型。
導入前要注意的坑
第一,Python 版本要注意,Docling 近期版本已經不支援 Python 3.9,建議直接用 Python 3.10 以上,專案環境也要隔離,避免和舊套件衝突。
第二,不要只看 Markdown 有沒有產生,真正要檢查的是段落順序、表格欄位、頁碼引用、公式、圖片說明、錯字率。只要這些地方亂掉,後面的 RAG 回答就會變得不可信。
第三,VLM 不是魔法,模糊掃描、歪斜頁面、低解析度照片仍然會出錯。比較穩的做法是保存原始頁面圖、解析後文字、模型信心與人工校對狀態,讓知識庫能追蹤每一段內容從哪裡來。
結論
Docling 值得放進 AI 知識庫工具箱,原因不是它可以把 PDF 轉 Markdown 這麼簡單,而是它把文件解析變成一條可組合的管線。一般文件用基礎轉換,掃描件加 OCR,高難度文件再接 VLM,最後輸出成 RAG 可以使用的 Markdown 或 JSON。
如果你的資料來源大多是網頁和乾淨文字,Docling 不一定是第一個要上的工具。但只要公司文件裡有大量 PDF、掃描件、表格、舊報告,它就是很值得測的入口層。AI 系統的回答品質,很多時候從文件被讀進來的那一刻就決定了。
FAQ
Docling 和 MarkItDown 差在哪裡?
MarkItDown 很適合快速把常見文件轉成 Markdown。Docling 更偏向完整文件理解,強調 PDF 版面、表格結構、OCR、VLM 和 AI 工具鏈整合。
一定要用 Gemini 才能處理掃描 PDF 嗎?
不一定。本地可以用 LM Studio 搭配 InternVL3 這類視覺模型。Gemini 的優勢是複雜文件辨識品質通常更好,但需要考慮 API 成本和資料外送。
Docling 適合企業內部知識庫嗎?
很適合,特別是資料來源包含 PDF、掃描件、簡報、表格和舊文件時。它可以把文件轉成 AI 較容易處理的格式,再交給 RAG 或 Agent 使用。
by Rain Chu 7 月 11, 2026 | 未分類
本地部署大模型到了 2026 年,問題已經不只是「模型要選哪一個」。同一張顯卡、同一台 Mac、同一個模型,只要推理框架選錯,吞吐量、延遲、顯存使用率和維運成本都會差很多。
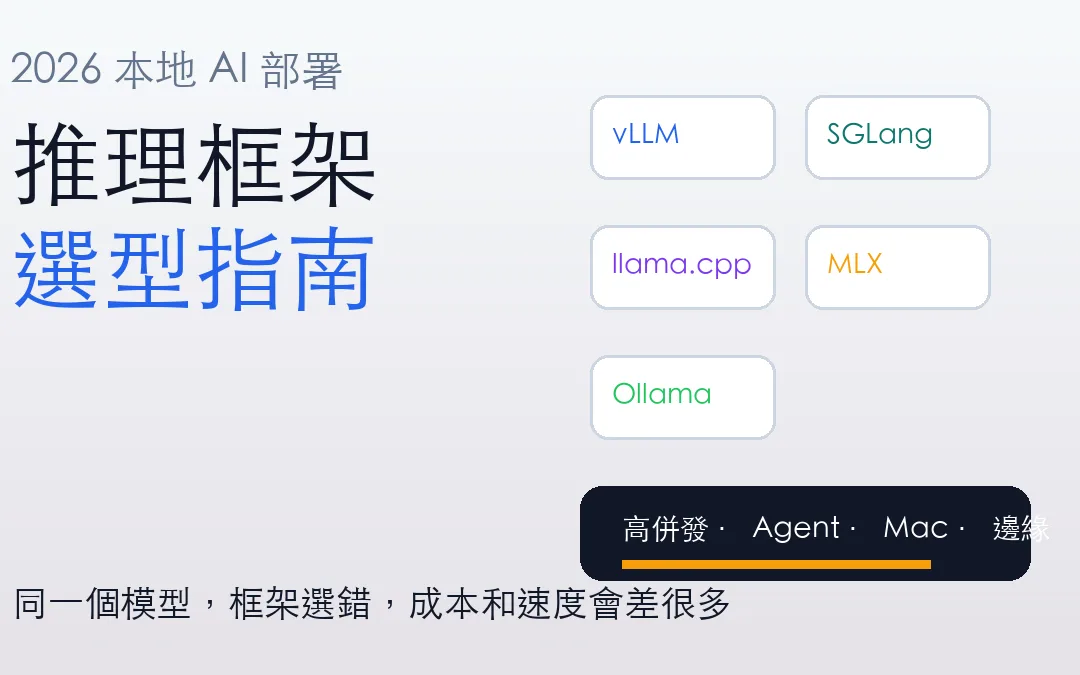
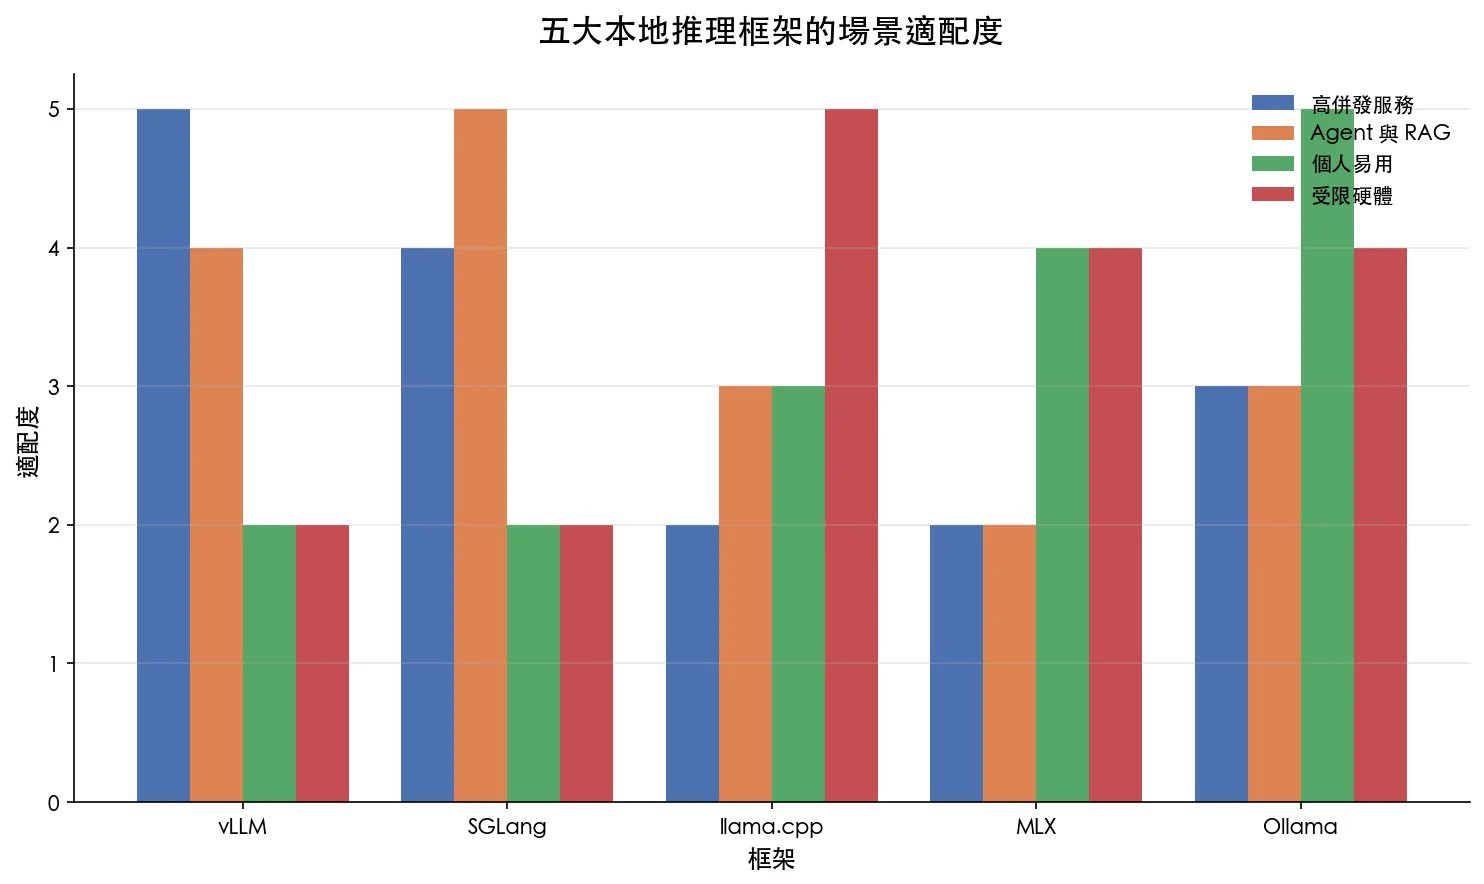
這也是為什麼 vLLM、SGLang、llama.cpp、MLX、Ollama 這五個工具會被放在一起比較。它們不是同一類產品的不同包裝,而是對應不同部署場景的五種答案。選對框架,比盲目追更大參數更實際。
先講結論
如果你要做高併發 API 服務,先看 vLLM。如果你在做 AI Agent、RAG、多輪工具呼叫,SGLang 很值得研究。如果你要跨平台、邊緣設備、低資源環境,llama.cpp 仍然是最靈活的選擇,如果你主要用 Apple Silicon,MLX 是最貼近硬體的路線。如果你只是想快速讓團隊或個人跑起來,Ollama 依然是最省心的入口。
五個框架的定位差異
框架 核心強項 適合場景 不適合情況 vLLM PagedAttention、Continuous Batching、高吞吐 生產 API、多使用者併發、GPU 服務 個人桌機快速試模型 SGLang RadixAttention、KV Cache 重用、結構化輸出 Agent、RAG、多輪對話、JSON 輸出 只想一鍵跑模型 llama.cpp GGUF、生態成熟、跨平台 CPU、邊緣設備、Mac、Windows、Linux、嵌入式 大規模高併發服務 MLX Apple Silicon 統一記憶體最佳化 M 系列 Mac、本地研究、Mac 開發者 NVIDIA GPU 伺服器 Ollama 安裝簡單、模型管理方便、API 友善 個人使用、團隊內部工具、快速 Demo 需要極致吞吐與深度客製
vLLM:高併發服務優先
vLLM 的代表性技術是 PagedAttention,可以把它理解成用作業系統管理記憶體的思路來管理 KV Cache,讓不同長度的請求不會浪費大量顯存,再加上 Continuous Batching,當某個請求完成後,新請求可以馬上進入批次,不必等整批全部結束。
所以 vLLM 最適合放在需要吞吐量的地方,例如公司內部模型 API、客服系統、多人同時使用的知識庫、需要穩定服務層的產品,你如果正在評估顯卡工作站,也可以對照我之前整理的 RTX PRO 6000 Blackwell 選購分析 ,因為推理框架和硬體規格要一起看才有意義。
SGLang:Agent 和 RAG 的效率選擇
SGLang 的重點不只是跑得快,而是能把複雜互動流程裡重複的上下文計算省下來,它的 RadixAttention 對多輪對話、RAG、知識庫查詢、Agent 工具呼叫很有價值,因為這些場景常常有大量共用前綴和重複上下文。
如果你的應用是「使用者問一句,模型答一句」,SGLang 的優勢不一定完全發揮。但如果你要處理多步驟推理、固定系統提示、文件檢索、JSON 格式化輸出,它會比一般推理框架更貼近 Agent 工程需求。
llama.cpp:跨平台與低資源環境的底座
llama.cpp 最大的價值是能跑在很多地方,從 Mac、Windows、Linux,到 CPU-only、小型邊緣設備、GGUF 量化模型,它提供的是一種很穩的本地推理底座,你不一定拿它做高併發生產 API,但它很適合實驗、嵌入式、離線環境、低成本部署。
如果你關心本地離線模型,之前整理過 gpt-oss 本地離線運行 ,那篇的思路也可以放到 llama.cpp 生態來看。
MLX:Apple Silicon 使用者要特別看
MLX 是 Apple Silicon 上很有意思的選擇。M 系列晶片的統一記憶體架構,讓 CPU、GPU 可以更有效率地共享資料,MLX 的價值就在於它不是把 Mac 當成一般電腦硬跑,而是更貼近 Apple 自家的硬體特性。
如果你手上是 Mac Studio、MacBook Pro 或其他 M 系列設備,MLX 適合拿來做本地研究、模型微調實驗、小型推理服務。它不是 NVIDIA 伺服器的替代品,但在 Mac 生態裡,這條路線會越來越重要。
Ollama:最容易讓人開始用
Ollama 的優勢不是極致效能,而是降低使用門檻。安裝、拉模型、切模型、提供本地 API,整個體驗很適合個人、教學、內部工具和快速 Demo。對很多團隊來說,先用 Ollama 把流程跑通,比一開始就追求 vLLM 的生產級架構更務實。
如果你要把 Ollama 放到內網或 AI Server 上,可以看 Ollama 遠端連線教學 。如果你想把開發環境成本壓低,也可以參考 LM Studio 與 Ollama 的零 API 成本開發環境 。
不要只選一個,混合部署更實際
真正成熟的部署,不一定是一個框架包打天下。比較實際的做法是分層:個人和內部 Demo 用 Ollama,Mac 研究環境用 MLX,跨平台和邊緣設備用 llama.cpp,RAG 和 Agent 後端看 SGLang,高併發正式服務再交給 vLLM。
如果你的硬體是 DGX Spark 或其他 AI Server,也可以把 DGX Spark GB10 Ollama 最佳設定 當作入口,再逐步把高併發服務拆到更專業的推理框架。
我的選型建議
個人開發者:先用 Ollama,真的需要跨平台或量化控制,再補 llama.cpp。
Mac 使用者:Ollama 做入口,MLX 做進階研究和 Apple Silicon 最佳化。
企業內部知識庫:先確認 RAG 架構和上下文重用需求,再評估 SGLang。
正式 API 服務:vLLM 是第一優先,特別是多使用者併發和 GPU 成本敏感時。
邊緣設備或離線場景:llama.cpp 的彈性仍然很難取代。
2026 年的本地 AI 部署,重點會從「能不能跑」走向「跑得是否有效率」。模型能力很重要,但推理框架決定了你花出去的硬體成本能不能真正轉成服務能力。選型時不要只看 benchmark,要看你的流量模式、硬體環境、維運能力和未來要不要接 Agent 工作流。
FAQ
本地大模型推理框架要先學哪一個?
一般使用者先學 Ollama,工程師再補 llama.cpp。需要生產服務時,再研究 vLLM 或 SGLang。
vLLM 和 SGLang 差在哪裡?
vLLM 強在高併發吞吐和生產服務,SGLang 更適合多輪對話、RAG、Agent 和重複上下文很多的流程。
Mac 使用者該選 MLX 還是 Ollama?
想快速跑模型先用 Ollama,想深入 Apple Silicon 最佳化和研究實驗,再看 MLX。
llama.cpp 還值得學嗎?
值得。它在 GGUF、量化、跨平台、CPU 和邊緣設備上仍然非常重要,是本地模型生態的底層工具之一。




近期留言